13년차의 서버실

서버, 인프라, 홈랩 기술 블로그

[카테고리:] openstack

  • [인프라] OpenStack Ceph 연동 실패 사례와 스토리지 성능 최적화 교훈

    [인프라] OpenStack Ceph 연동 실패 사례와 스토리지 성능 최적화 교훈

    [인프라] OpenStack Ceph 연동 실패 사례와 스토리지 성능 최적화 교훈

    OpenStack Ceph 연동은 프라이빗 클라우드를 운영할 때 한 번쯤 꼭 마주치는 주제입니다. 저도 홈랩과 실무 환경에서 OpenStack 스토리지 구성을 여러 번 만졌는데요, 처음엔 단순히 연결만 되면 끝일 줄 알았습니다. 그런데 실제로 써보니까 연동 성공과 제대로 빠르게 동작하는 상태는 완전히 다른 이야기더라고요. 특히 볼륨 생성은 되는데 체감이 느리거나, 가상머신 부팅이 들쭉날쭉하거나, 특정 시간대에 I/O가 몰리면 급격히 지연이 커지는 문제를 겪으면 그때부터 삽질이 시작됩니다. 혹시 지금 OpenStack Ceph 연동 이후 성능이 이상하게 답답하다고 느끼고 계신가요?

    여기서 중요한 포인트는, 원인이 Ceph 자체인지 OpenStack 설정인지, 아니면 둘 사이의 연결 방식인지 분리해서 봐야 한다는 점입니다. 이 글에서는 제가 직접 겪었던 OpenStack Ceph 연동 실패 패턴과 해결 방법을 정리했으니, 비슷한 상황이라면 참고하시길 바랍니다.
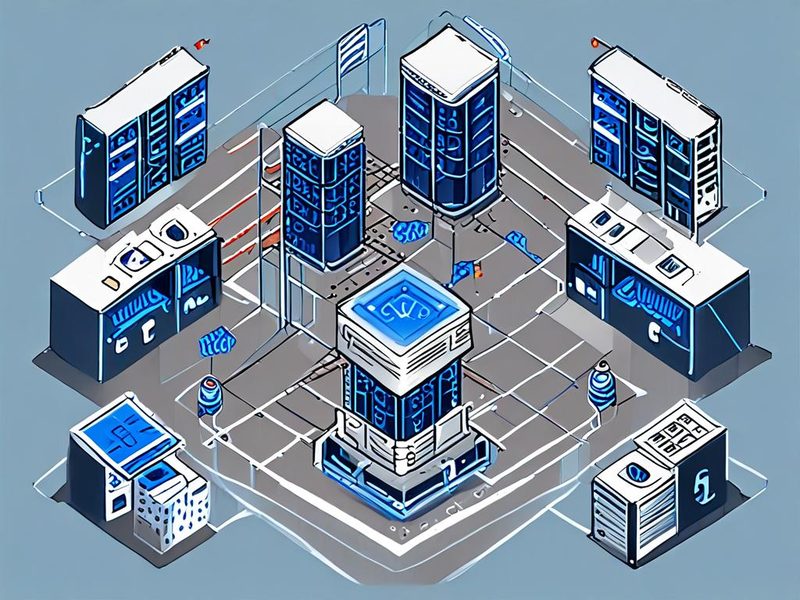
    OpenStack Ceph 연동 전체 아키텍처 다이어그램

    OpenStack 컴퓨트, 이미지, 블록 스토리지 서비스와 Ceph 클러스터 간 연결 구조를 한눈에 보여주는 아키텍처 이미지입니다.

    왜 OpenStack Ceph 연동에서 성능 문제가 자주 생길까

    쉽게 말해 OpenStack는 서비스를 제공하는 제어 평면(control plane)이고, Ceph는 실제 데이터를 저장하는 분산 스토리지(distributed storage) 역할을 합니다. 많이들 Cinder(신더, 블록 스토리지), Glance(글랜스, 이미지 서비스), Nova(노바, 컴퓨트)가 Ceph의 RBD(RADOS Block Device, 블록 디바이스 인터페이스)를 함께 쓰도록 구성하죠. 구조만 보면 깔끔합니다. 근데 여기서 병목이 생기는 지점이 꽤 많습니다.

    • 인증 설정은 맞는데 풀(pool) 권한이 어긋난 경우
    • 네트워크 분리가 부족해서 클라이언트 트래픽과 복제 트래픽이 섞이는 경우
    • 풀 설계가 서비스 특성과 맞지 않는 경우
    • 하이퍼바이저(hypervisor) 캐시 정책이 애매해서 지연이 커지는 경우
    • 작은 I/O가 많이 발생하는 워크로드를 고려하지 않은 경우

    저도 처음엔 Ceph 최적화라고 하면 OSD(Object Storage Daemon, 오브젝트 스토리지 데몬) 쪽만 보면 된다고 생각했었는데요, 막상 들여다보니 OpenStack 스토리지 설정에서 생기는 비효율이 꽤 컸습니다. 특히 이미지 업로드는 괜찮은데 볼륨 기반 부팅이 유독 느린 경우, 그 원인이 하나가 아니라 여러 레이어에 걸쳐 있는 경우가 많았습니다.

    구성 개념 먼저 정리해보겠습니다

    OpenStack Ceph 연동을 이해할 때는 각 서비스가 어느 풀을 쓰는지부터 정리하면 훨씬 덜 헷갈립니다.

    구성 요소 역할 Ceph 연동 포인트 체크 포인트
    Glance 이미지 저장 RBD 이미지 풀 이미지 업로드/변환 지연
    Cinder 볼륨 제공 RBD 볼륨 풀 볼륨 생성 속도, attach 지연
    Nova 가상머신 부팅 Ceph 백엔드 부트 부팅 시간, I/O 패턴
    Ceph MON/OSD 클러스터 관리/데이터 저장 스토리지 코어 복제 상태, 지연, 균형

    핵심은 이겁니다. OpenStack 스토리지 성능은 단순히 디스크가 빠르냐 느리냐로 끝나지 않습니다. 인증, 네트워크, 풀 설계, 복제 정책(replication policy), 클라이언트 설정이 다 같이 맞물립니다. 그래서 문제를 볼 때도 한 군데만 보면 안 되죠.

    제가 실제로 점검했던 사전 체크리스트

    본격적으로 손대기 전에 저는 항상 아래 순서대로 확인합니다. 이 순서를 안 지키면 괜히 OSD 튜닝만 하다가 시간을 많이 쓰게 되더라고요.

    1. Ceph 클러스터 상태가 HEALTH_OK 또는 경미한 경고 수준인지 확인합니다.
    2. Glance, Cinder, Nova가 각각 어떤 Ceph 사용자와 풀을 쓰는지 정리합니다.
    3. 스토리지 네트워크와 서비스 네트워크가 분리되어 있는지 확인합니다.
    4. 볼륨 생성, 이미지 업로드, 부팅 중 어디가 가장 느린지 구분합니다.
    5. 가상머신 내부 체감 속도와 백엔드 I/O 지표를 따로 봅니다.

    여기서 중요한 포인트! 사용자는 보통 “Ceph가 느리다”라고 말하지만, 실제로는 이미지 복사 경로가 비효율적이거나 캐시 정책이 안 맞아서 그렇게 느끼는 경우도 많습니다. 저도 예전에 이걸 구분 못 해서 하루를 날린 적이 있습니다. OpenStack Ceph 연동에서는 정말 이런 실수가 흔하거든요.

    실전 구현: OpenStack Ceph 연동 기본 점검과 설정

    아래 예시는 개념을 설명하기 위한 일반적인 형태입니다. 배포판이나 자동화 도구에 따라 파일 위치와 세부 항목은 조금 다를 수 있습니다. 그래도 큰 흐름은 비슷합니다.

    1. Ceph 클러스터 상태 확인

    ceph -s
    ceph health detail
    ceph osd tree
    ceph osd df
    rbd pool ls

    이 단계에서 저는 먼저 복제 지연이나 OSD 불균형부터 봅니다. 연동 전에 백엔드가 불안정하면 OpenStack 쪽에서 아무리 손봐도 체감이 안 좋아집니다.

    2. Ceph 사용자 권한 확인

    ceph auth list
    ceph auth get client.glance
    ceph auth get client.cinder
    ceph auth get client.nova

    권한이 과하게 넓은 것도 문제지만, 더 자주 보는 건 풀 권한이 어설프게 빠져 있는 경우입니다. 그러면 기능은 되는 것처럼 보여도 특정 작업에서만 실패하거나 지연이 생깁니다.

    3. Cinder 백엔드 확인

    [ceph]
    volume_driver = cinder.volume.drivers.rbd.RBDDriver
    volume_backend_name = ceph
    rbd_pool = volumes
    rbd_user = cinder
    rbd_ceph_conf = /etc/ceph/ceph.conf
    rbd_secret_uuid = YOUR_SECRET_UUID
    rbd_flatten_volume_from_snapshot = false
    rbd_max_clone_depth = 5
    rbd_store_chunk_size = 8

    rbd_max_clone_depth 같은 항목은 운영 방식에 따라 영향을 줄 수 있습니다. 저는 예전에 스냅샷 기반 복제가 누적된 상태를 방치했다가, 특정 볼륨 체인에서 응답이 들쭉날쭉해지는 걸 본 적이 있습니다.

    4. Glance 백엔드 확인

    [glance_store]
    default_backend = rbd
    stores = rbd
    rbd_store_pool = images
    rbd_store_user = glance
    rbd_store_ceph_conf = /etc/ceph/ceph.conf

    Glance(글랜스, 이미지 서비스)가 Ceph를 바로 쓰도록 해두면 이미지 관리가 단순해집니다. 다만 이미지 업로드와 변환 작업이 많은 환경이라면 여기서도 풀 설계와 I/O 패턴을 꼭 같이 봐야 합니다.
    OpenStack Ceph 연동 설정 흐름과 RBD 풀 구성 이미지

    OpenStack 서비스별로 어떤 Ceph 사용자와 풀을 사용하는지 보여주는 구성 다이어그램입니다.

    실패 사례: OpenStack Ceph 연동은 됐는데 성능이 안 나온 이유

    이제 제가 실제로 겪었던 전형적인 실패 패턴을 말씀드려볼게요. 처음엔 볼륨 생성도 되고 인스턴스도 뜨니까 성공한 줄 알았습니다. 그런데 실제로 써보니까 VM 부팅 시간이 일정하지 않았고, 동시에 여러 작업이 걸리면 체감 지연이 확 올라가더라고요. 여기서부터가 진짜 OpenStack Ceph 연동의 시작이었습니다.

    문제 1. 네트워크를 논리적으로만 나눠놓고 물리적으로는 섞어 썼던 경우

    Ceph는 복제와 복구 트래픽이 발생합니다. 그런데 클라이언트 액세스와 같은 대역을 공유하면 피크 시간에 지연이 커질 수 있습니다. 저도 홈랩에서 처음엔 VLAN만 나누면 충분하겠지 했었는데, 실제로는 업링크 혼잡이 생기면서 체감 성능이 꽤 흔들렸습니다.

    • 증상: 특정 시간대에 볼륨 attach와 부팅 지연 증가
    • 원인: 스토리지 트래픽과 일반 서비스 트래픽 경합
    • 대응: 스토리지 네트워크 경로를 분리하고 혼잡 구간을 줄임

    문제 2. 풀을 나누지 않고 한 곳에 몰아넣은 경우

    이미지, 볼륨, 테스트용 작업이 한 풀에 몰려 있으면 관찰도 어렵고 튜닝 포인트도 흐려집니다. Ceph 최적화는 결국 워크로드 분리가 기본이더라고요.

    • 증상: 어떤 작업이 느린지 구분이 잘 안 됨
    • 원인: 서비스별 I/O 특성 혼재
    • 대응: images, volumes 등 역할 단위로 풀을 분리해 관찰성 확보

    문제 3. 클론과 스냅샷 체인을 너무 방치한 경우

    처음엔 공간 절약 측면에서 좋아 보이는데, 운영 기간이 길어지면 관리 포인트가 늘어납니다. 특히 오래된 이미지 기반으로 파생된 체인이 많아지면, 성능과 운영 복잡도가 같이 올라갈 수 있습니다. OpenStack Ceph 연동 운영에서는 정말 흔한 문제입니다.

    문제 4. 성능 문제를 전부 Ceph 탓으로만 본 경우

    이거 정말 많이 봅니다. 근데 실제로는 하이퍼바이저 캐시 설정, 인스턴스 유형별 디스크 패턴, 백그라운드 작업 영향도 같이 봐야 하거든요. 저도 처음엔 Ceph OSD만 의심했었는데, 나중에 보니 OpenStack 스토리지 경로에서 이미지 변환과 attach 흐름이 더 큰 영향을 준 케이스가 있었습니다.

    ⚠️ 트러블슈팅: 제가 효과를 봤던 점검 순서

    문제가 생기면 아래 순서로 좁혀가면 좋습니다. 무작정 튜닝부터 하지 마세요. 저도 예전엔 그랬다가 더 꼬였습니다.

    1. Ceph 상태 확인
      클러스터 경고, 리밸런싱(rebalancing), 복구 상태를 먼저 확인합니다.
    2. 풀 단위 관찰
      어느 풀이 바쁜지, 이미지와 볼륨 중 어디서 병목이 생기는지 봅니다.
    3. OpenStack 작업별 분리
      이미지 업로드, 볼륨 생성, 인스턴스 부팅을 따로 테스트합니다.
    4. 동시 작업 테스트
      단건 테스트는 괜찮은데 동시성에서 무너지는 경우가 많습니다.
    5. 체인 정리 여부 검토
      오래된 스냅샷/클론 구조가 쌓였는지 확인합니다.
    openstack volume create --size 10 test-volume
    openstack server create --flavor m1.small --image test-image --network private test-vm
    rbd ls -p volumes
    rbd info volumes/test-volume
    ceph osd perf

    여기서 ceph osd perf 같은 기본 지표와 OpenStack 작업 시간을 같이 비교해보면 감이 옵니다. 절대적인 숫자보다 언제 느려지는지, 어떤 작업에서 흔들리는지를 보는 게 더 중요합니다.
    OpenStack Ceph 연동 장애 분석용 스토리지 성능 대시보드 이미지

    볼륨 생성과 가상머신 부팅 과정에서 지연이 발생하는 구간을 시각적으로 보여주는 대시보드 이미지입니다.

    Ceph 최적화 관점에서 배운 점

    이번 경험에서 가장 크게 느낀 건, Ceph 최적화는 단일 옵션 몇 개로 끝나는 작업이 아니라는 점이었습니다. 결국 아래 네 가지가 같이 맞아야 하더라고요.

    • 네트워크 분리: 복제와 클라이언트 경로를 명확히 구분
    • 풀 설계: 워크로드 성격에 맞춰 역할 분리
    • 운영 습관: 오래된 스냅샷/클론 체인 방치 금지
    • 관찰성: OpenStack 로그와 Ceph 상태를 함께 확인

    스토리지 성능은 숫자 하나로 판단하기 어렵습니다. 어떤 환경에서는 작은 랜덤 I/O가 문제고, 또 어떤 환경에서는 이미지 배포 흐름이 더 큰 병목이 됩니다. 그래서 저는 요즘은 성능 문제가 나오면 먼저 “이게 Ceph 문제인가, OpenStack 스토리지 경로 문제인가, 아니면 둘 다인가?”부터 구분합니다.

    검증 방법: 무엇을 확인해야 실제로 좋아졌다고 볼 수 있을까

    개선 후에는 꼭 검증이 필요합니다. 그냥 느낌상 빨라진 것 같다고 넘어가면 다음 장애 때 다시 원점으로 돌아갑니다.

    1. 동일한 이미지로 인스턴스 부팅 시간을 여러 번 비교합니다.
    2. 동시에 여러 볼륨을 생성해 지연 패턴이 안정적인지 봅니다.
    3. 이미지 업로드와 볼륨 생성이 겹칠 때도 성능 저하가 과도하지 않은지 확인합니다.
    4. Ceph 클러스터 상태가 테스트 중에도 안정적인지 체크합니다.

    제가 직접 해보니, 단건 테스트보다 동시성 테스트가 훨씬 유의미했습니다. 평소엔 괜찮다가도 작업이 몰리면 바로 티가 나거든요. 드디어 됐다! 싶은 순간도 보통 이 구간을 통과했을 때였습니다.

    openstack server list
    openstack volume list
    ceph -s
    ceph df
    rbd du -p volumes

    검증할 때는 결과만 보지 말고, 테스트 중간에 경고가 발생하지 않는지도 꼭 보세요. 여기서 안정적이면 그제야 실제 운영에 올릴 만한 상태라고 판단합니다.
    OpenStack Ceph 연동 최적화 전후 비교 요약 이미지

    최적화 이전과 이후의 지연 안정성 차이를 비교하고, 운영자가 점검해야 할 항목을 요약한 이미지입니다.

    실무적으로 정리하는 OpenStack 스토리지 운영 팁

    항목 권장 접근 피해야 할 패턴
    네트워크 스토리지 경로 분리 복제/서비스 트래픽 혼재
    풀 설계 서비스별 역할 분리 모든 워크로드를 단일 풀에 집중
    운영 관리 스냅샷/클론 주기적 점검 장기간 체인 방치
    검증 방식 동시성 포함 반복 테스트 단건 테스트만으로 판단

    이 표는 제가 나중에 운영 문서로도 정리해둔 기준입니다. 사실 OpenStack Ceph 연동은 한 번 붙이고 끝나는 프로젝트가 아니라, 붙인 뒤부터 운영 품질이 갈리는 영역입니다. 이전 글에서 다뤘던 기본 네트워크 설계와도 연결되는 부분이고, 다음 글에서는 Ceph 모니터링 포인트를 조금 더 깊게 다뤄볼 예정입니다.

    마무리: 연동 성공보다 중요한 건 안정적인 성능입니다

    오늘 정리한 실패 사례의 핵심은 단순합니다. OpenStack Ceph 연동이 되었더라도, 그 상태가 곧 최적 상태는 아니라는 점입니다. 저도 처음엔 연결만 되면 다 끝난 줄 알았는데, 실제 운영에서는 네트워크, 풀 설계, 스냅샷 체인, 작업 동시성까지 다 영향을 주더라고요. 삽질 좀 했습니다. 그래도 이런 과정을 겪고 나니 이제는 문제를 훨씬 빨리 좁힐 수 있게 됐습니다.

    혹시 지금 OpenStack 스토리지 성능 때문에 답답하셨다면, 오늘 내용처럼 어디서 느려지는지 분리해서 보는 것부터 시작해보세요. 그게 가장 현실적인 첫걸음입니다. 그리고 Ceph 최적화는 무조건 큰 튜닝보다, 구조를 바르게 잡는 쪽이 효과가 더 컸습니다. 이 부분은 정말 경험상 그렇습니다.

    연동 성공, 병목 원인 분리, 검증 절차, 운영 팁을 한 장으로 요약한 마무리 인포그래픽입니다.

    정리 FAQ

    Q. OpenStack Ceph 연동 후 가장 먼저 볼 것은 무엇인가요?

    A. Ceph 클러스터 상태와 OpenStack 서비스별 풀/사용자 매핑입니다. 이 두 가지가 기본입니다.

    Q. 스토리지 성능이 느리면 무조건 Ceph 튜닝부터 해야 하나요?

    A. 아닙니다. 네트워크 경합, 풀 분리 부족, 스냅샷 체인 누적, OpenStack 작업 흐름까지 같이 봐야 합니다.

    Q. OpenStack 스토리지 운영에서 가장 실수하기 쉬운 부분은 뭔가요?

    A. 연동 성공을 성능 검증 완료로 착각하는 부분입니다. 꼭 동시성 테스트까지 해보셔야 합니다.
  • [OpenStack] OpenStack Barbican 보안: 민감 데이터 관리 체크리스트

    [OpenStack] OpenStack Barbican 보안: 민감 데이터 관리 체크리스트

    OpenStack Barbican 보안: 민감 데이터 관리 체크리스트

    OpenStack Barbican 보안은 생각보다 뒤로 밀리기 쉽더라고요. 처음에는 VM, 네트워크, 스토리지부터 안정화하느라 바쁘고, 비밀번호나 인증서 같은 민감 데이터는 환경 변수나 설정 파일로 잠깐 버티는 경우가 많습니다. 그런데 운영 기간이 길어질수록 이런 방식은 거의 반드시 문제를 만듭니다. 누가 어떤 Secret(시크릿, 민감 정보)을 만들었는지 추적이 안 되고, 권한이 넓게 퍼지고, 백업 파일이나 로그에 값이 섞여 들어가기도 하거든요. 그래서 핵심은 민감 데이터를 서비스 밖으로 분리하고 중앙에서 통제하는 것입니다. 이번 글에서는 실제 운영 전에 꼭 점검할 체크리스트를 중심으로 정리해보겠습니다.

    특히 OpenStack 키 관리가 필요한 환경, 인증서와 API 키를 여러 서비스가 나눠 쓰는 환경, 그리고 감사 로그까지 챙겨야 하는 팀이라면 이 체크리스트가 꽤 실용적입니다. 실제로 해보면 Barbican 자체를 띄우는 것보다 주변 권한 설계, 네트워크 경계, 백엔드 보안 구성이 더 중요하더라고요.

    Barbican이 Keystone(키스톤, 인증), API, Secret Store(시크릿 저장소), 데이터베이스, 백엔드 키 관리 계층과 어떻게 연결되는지 한눈에 보여주는 개요 이미지가 들어갈 자리입니다.

    1. 왜 OpenStack Barbican 보안이 중요한가

    Barbican은 단순한 비밀번호 보관함이 아닙니다. OpenStack 환경 전반에서 비밀번호, TLS 인증서, 대칭키, 개인키 같은 비밀 정보의 저장과 접근 제어를 담당하는 키 관리 서비스에 가깝습니다. OpenStack 공식 문서에서도 Barbican은 기본 시크릿 저장 서비스로 설명되고, Keystone 토큰과 정책 기반 접근 제어를 함께 사용합니다.

    중요한 점은 Barbican을 도입했다고 바로 안전해지지는 않는다는 겁니다. 중앙 집중형 서비스라서 설정이 느슨하면 위험도 같이 중앙 집중화됩니다. 그래서 클라우드 보안 체크리스트 관점으로 접근해야 합니다. 저장소 암호화, API 접근 통제, 전송 구간 TLS, 감사 로그, 키 순환(rotation)을 같이 봐야 운영에서 덜 흔들립니다.

    2. Barbican 핵심 개념, 쉽게 정리해보면

    처음에는 용어가 많아 보여도 구조를 단순하게 보면 금방 감이 옵니다.

    • Secret(시크릿): 비밀번호, 토큰, 인증서 같은 민감 데이터 본문입니다.
    • Container(컨테이너): 여러 Secret을 묶는 논리적 그룹입니다. 인증서, 개인키, 체인 인증서를 한 세트로 관리할 때 특히 편합니다.
    • Consumer(컨슈머): 어떤 서비스가 해당 Secret을 사용하는지 연결 정보를 남기는 개념입니다.
    • Policy(정책): 누가 생성, 조회, 삭제할 수 있는지 정의하는 접근 제어 규칙입니다.
    • Backend(백엔드): 실제 키 관리 장치나 저장소 계층입니다. 소프트웨어 기반 저장소일 수도 있고, HSM(Hardware Security Module, 하드웨어 보안 모듈)이나 외부 연동형 키 관리 백엔드일 수도 있습니다.

    운영에서 자주 헷갈리는 부분은 이것입니다. Barbican은 보안 기능의 끝이 아니라 연결점이라는 점이죠. Keystone, TLS 인증서, 데이터베이스 보호, 백업 정책이 같이 맞물려야 진짜 효과가 납니다.

    3. OpenStack 키 관리 시작 전 체크리스트

    배포 전에 아래 항목만 제대로 확인해도 사고 확률이 꽤 줄어듭니다.

    1. API 엔드포인트를 TLS로 보호했는지 확인합니다.
    2. Keystone 프로젝트와 역할(Role)이 최소 권한으로 설계되었는지 점검합니다.
    3. 관리 네트워크와 사용자 접근 네트워크를 분리했는지 봅니다.
    4. 데이터베이스 접근 계정이 Barbican 전용인지 확인합니다.
    5. 백엔드 저장소 암호화가 활성화되어 있는지 확인합니다.
    6. 감사 로그와 API 로그가 중앙 수집되는지 점검합니다.
    7. Secret 수명주기, 즉 생성, 사용, 폐기, 순환 주기가 문서화되어 있는지 확인합니다.
    8. 백업본에 민감 데이터가 평문으로 남지 않는지 체크합니다.

    이 부분은 정말 많이 놓칩니다. Barbican 안쪽만 단단하게 만들고, 백업 스냅샷이나 운영 스크립트에 시크릿이 그대로 남아 있는 경우가 있거든요. 로그 확인하다가 테스트용 토큰이 남아 있는 걸 뒤늦게 발견하면 식은땀이 납니다.

    4. 실전 구현: Secret 저장과 접근 흐름 점검

    이제 실전 쪽으로 가보겠습니다. 아래 예시는 OpenStack CLI 기준의 기본 흐름입니다. 환경마다 옵션은 조금 다를 수 있지만, 점검 포인트는 거의 같습니다. 특히 예시에서는 실제 운영 비밀번호를 명령줄에 직접 넣지 않는 쪽으로 바꿨습니다. 터미널 히스토리와 운영 문서에 값이 남는 걸 줄이려면 이 습관이 꽤 중요합니다.

    4-1. OpenStack 인증 환경 준비

    export OS_AUTH_URL=https://keystone.example.com:5000/v3
    export OS_USERNAME=barbican-auditor
    export OS_PASSWORD='REPLACE_ME'
    export OS_PROJECT_NAME=security
    export OS_USER_DOMAIN_NAME=Default
    export OS_PROJECT_DOMAIN_NAME=Default
    export OS_IDENTITY_API_VERSION=3
    

    여기서 첫 번째 체크 포인트는 운영용 관리자 계정을 그대로 쓰지 않는 것입니다. 읽기 전용 점검 계정, 운영 계정, 자동화 계정을 나누는 게 좋습니다. 조금 번거로워도 나중에 감사 추적할 때 차이가 확실히 납니다.

    4-2. Secret 저장 테스트

    openstack secret store \
      --name db-password \
      --file ./db-password.txt \
      --payload-content-type text/plain
    

    테스트용 시크릿을 저장해봅니다. 공식 CLI 문서 기준으로 --payload를 쓸 때는 --payload-content-type가 필요하고, 운영에서는 평문 값을 명령줄에 직접 남기지 않는 편이 더 안전합니다. 이거 작은 습관 같아도 나중에 로그나 히스토리 정리할 때 꽤 편하더라고요.

    4-3. 저장 결과 확인

    openstack secret list --name db-password
    
    openstack secret get --payload https://barbican.example.com/v1/secrets/REPLACE_WITH_SECRET_HREF
    

    여기서 중요한 포인트가 하나 있습니다. openstack secret get은 이름이 아니라 Secret URI를 인자로 받습니다. 이 부분을 헷갈려서 db-password 같은 이름을 바로 넣는 경우가 있는데, 실제 점검에서는 목록에서 Secret href를 확인한 뒤 조회해야 합니다. 또, 의도하지 않은 프로젝트에서 동일 리소스가 보이지 않는지도 꼭 확인해야 합니다. OpenStack Barbican 보안에서 흔한 실수 중 하나가 프로젝트 경계를 느슨하게 가져가는 거거든요.

    OpenStack Barbican 보안에서 프로젝트 권한 분리를 설명하는 구성도

    시크릿 생성, 프로젝트별 권한 분리, 운영 계정과 감사 계정의 역할 차이를 설명하는 구성 이미지가 들어갈 자리입니다.

    4-4. 컨테이너와 인증서 묶음 관리 예시

    TLS 인증서 체인을 다룰 때는 Secret 하나로 끝나지 않는 경우가 많습니다. 인증서, 개인키, 체인 파일을 묶어서 관리하는 구조를 설계해야 하죠. 이럴 때 Container 개념이 꽤 유용합니다.

    대상 Barbican에 저장할 항목 운영 체크 포인트
    웹 API TLS 서버 인증서, 개인키, 체인 인증서 만료일 점검, 교체 절차 문서화
    애플리케이션 비밀번호 DB 계정 정보, API 토큰 순환 주기, 접근 계정 최소화
    서비스 간 암호화 대칭키 또는 참조 정보 배포 자동화와 연계 여부

    이런 식으로 민감 데이터 보호 범위를 유형별로 나눠서 관리하면 운영이 훨씬 깔끔해집니다.

    5. 보안 강화 체크리스트: 운영에서 꼭 봐야 할 항목

    이 섹션은 실제 점검표처럼 그대로 써도 될 만한 내용입니다. 새 환경을 열 때마다 거의 같은 항목을 다시 확인하게 되더라고요.

    5-1. 네트워크와 전송 구간

    • Public API를 외부에 직접 노출하지 않았는지 확인합니다.
    • TLS 인증서 체인이 올바르게 구성되었는지 점검합니다.
    • 로드밸런서와 프록시 뒤에 둘 경우 원본 클라이언트 추적 로그가 남는지 확인합니다.
    • 관리 네트워크 접근 제어를 보안 그룹과 방화벽 양쪽에서 점검합니다.

    5-2. 인증과 권한

    • Keystone 역할(Role)을 세분화합니다.
    • 서비스 계정과 사용자 계정을 분리합니다.
    • 공용 프로젝트에 시크릿을 몰아넣지 않습니다.
    • 삭제 권한과 조회 권한을 분리할 수 있으면 분리합니다.

    5-3. 저장소와 백엔드

    • 백엔드가 소프트웨어 저장소인지, 외부 연동형 KMS/HSM인지 명확히 구분합니다.
    • 데이터베이스 백업본이 암호화되는지 확인합니다.
    • 운영체제 디스크 암호화와 파일 권한을 같이 점검합니다.
    • 교체 주기(rotation)를 사람 기억에 맡기지 말고 일정화합니다.

    5-4. 로그와 감사 추적

    • 누가 Secret을 만들고 조회했는지 추적 가능한지 확인합니다.
    • 민감 값 자체가 로그에 남지 않도록 마스킹 정책을 점검합니다.
    • 실패한 인증 시도와 비정상 접근 패턴을 중앙 로그에서 볼 수 있어야 합니다.

    접근은 막았는데 로그에 payload가 찍혀서 의미가 없어지는 경우가 있습니다. 이거 진짜 허무합니다. OpenStack 키 관리는 저장만이 아니라 흔적 관리까지 포함이라고 봐야 합니다.

    6. 설정 예시: 운영 문서에 넣기 좋은 체크 항목

    아래처럼 운영 표준 문서에 넣을 수 있는 형태로 남겨두면 좋습니다.

    barbican_security_checklist:
      api_tls:
        enabled: true
        certificate_chain_verified: true
      identity:
        dedicated_service_accounts: true
        least_privilege_roles: true
      storage:
        encrypted_backup: true
        restricted_db_access: true
      audit:
        api_access_logging: true
        secret_payload_logging: false
      operations:
        rotation_policy_defined: true
        orphan_secret_review: monthly
    

    이 문서는 예쁘게 만드는 게 목적이 아닙니다. 누가 봐도 같은 기준으로 점검할 수 있게 만드는 것이 핵심이죠. 팀 문서 정리할 때 이런 형태가 가장 오래 살아남더라고요.

    OpenStack 키 관리 운영 체크리스트와 자동화 파이프라인 이미지

    YAML 기반 점검표, 배포 자동화, 감사 로그 수집이 어떻게 연결되는지 보여주는 이미지가 들어갈 자리입니다.

    7. 트러블슈팅: 운영에서 자주 겪는 문제

    Barbican은 올렸는데 기대한 만큼 바로 매끄럽게 굴러가지는 않을 때가 있습니다. 특히 권한과 복구 쪽에서 문제가 자주 나오더라고요.

    7-1. Secret은 저장되는데 서비스 연동이 안 되는 경우

    원인은 대개 권한 문제였습니다. 저장 자체는 되는데 실제 사용하는 서비스 계정이 읽지 못하는 거죠. 해결도 결국 권한 설계였습니다. 어떤 프로젝트에서 생성했고, 누가 읽어야 하는지를 다시 분리해서 맞추는 게 핵심입니다.

    7-2. 운영자는 보이는데 자동화 계정은 실패하는 경우

    이건 RC 파일이나 토큰 스코프(scope, 권한 범위) 문제가 많았습니다. 관리자 세션으로는 다 되니까 더 헷갈립니다. 실제 자동화 계정으로 같은 명령을 재현해보면 원인이 비교적 빨리 드러납니다.

    7-3. 백업은 멀쩡한데 복구 후 접근 오류가 나는 경우

    백엔드 키 관리 계층과 DB 상태가 같이 맞아야 하는데, 일부만 복구하면 접근 오류가 납니다. 그래서 복구 리허설이 정말 중요합니다. 백업 성공 메시지보다 복구 후 Secret을 실제로 조회할 수 있는지가 더 중요하거든요.

    7-4. 오래된 시크릿이 계속 남아 있는 경우

    운영하다 보면 애플리케이션은 교체됐는데 예전 Secret은 삭제되지 않는 경우가 많습니다. 이건 보안 문제이자 관리 비용 문제입니다. 월 1회라도 고아 시크릿(orphan secret) 점검을 권장합니다.

    openstack secret list --long
    

    이 명령으로 목록을 보면서 생성 시점, 상태, 설명 규칙이 일관적인지 같이 보시면 좋습니다. 이름 규칙이 없으면 나중에 진짜 힘들어집니다.

    8. 검증과 결과 확인: 무엇을 보면 잘 구성된 걸까

    단순히 시크릿 저장이 성공했다고 끝은 아닙니다. 운영 기준으로는 아래 조건이 맞아야 합격이라고 보는 편이 더 현실적입니다.

    1. 일반 사용자 계정은 다른 프로젝트의 시크릿을 볼 수 없습니다.
    2. 서비스 계정은 필요한 시크릿만 읽을 수 있습니다.
    3. API 호출이 TLS로 보호됩니다.
    4. 로그에는 접근 이벤트가 남지만 민감한 payload는 직접 남지 않습니다.
    5. 백업과 복구 테스트 후에도 시크릿 접근이 정상 동작합니다.
    6. 교체 대상 시크릿 목록과 일정이 문서화되어 있습니다.

    검증용으로는 기능 테스트와 권한 테스트를 분리해서 보는 게 좋습니다. 운영자 계정으로 성공하는지, 서비스 계정으로도 의도대로 되는지, 권한 없는 계정은 확실히 실패하는지를 각각 봐야 합니다. 이게 OpenStack Barbican 보안 점검의 핵심입니다.

    OpenStack Barbican 보안 검증 결과와 접근 로그 시각화

    정상 접근, 권한 거부, 감사 로그 기록 상태를 비교해서 보여주는 검증 결과 이미지가 들어갈 자리입니다.

    9. 정리: 민감 데이터 보호는 기능보다 운영이 더 중요합니다

    정리해보면, Barbican은 굉장히 유용한 서비스입니다. 다만 Barbican 활용의 포인트는 기능을 켜는 데 있지 않고 운영 기준을 만드는 데 있습니다. 누가 만들고, 누가 읽고, 언제 바꾸고, 어디에 기록되는지까지 정리돼 있어야 비로소 안전해집니다. 처음엔 설정 몇 줄이면 끝날 것 같아도, 실제로는 권한 설계와 검증 시나리오를 만드는 데 시간이 더 들더라고요. 그런데 그 시간을 아끼면 나중에 더 크게 돌아옵니다.

    다음 글에서는 Barbican을 다른 OpenStack 서비스와 연계할 때 무엇을 더 신경 써야 하는지 다뤄보겠습니다. 이전에 정리한 Keystone 권한 설계 글과 함께 보면 흐름을 잡는 데 더 도움이 됩니다.

    핵심 점검 항목, 우선순위, 다음 단계 작업을 요약한 인포그래픽 이미지가 들어갈 자리입니다.

    10. FAQ: 현장에서 자주 나오는 질문

    Q1. Barbican만 도입하면 민감 데이터 보호가 끝나나요?

    아닙니다. 민감 데이터 보호는 저장, 전송, 권한, 로그, 백업, 복구까지 같이 봐야 합니다.

    Q2. 소규모 환경에서도 꼭 필요할까요?

    네. 규모보다도 비밀번호와 인증서를 여러 시스템이 나눠 쓰는 순간 필요성이 커집니다. 홈랩에서도 한 번 구조를 잡아두면 훨씬 편합니다.

    Q3. 가장 먼저 점검할 한 가지를 꼽자면?

    우선순위 하나만 고르라면 최소 권한(least privilege, 최소 권한 원칙)입니다. 저장소가 안전해도 접근 권한이 넓으면 효과가 크게 줄어듭니다.

  • [OpenStack] RDO OpenStack 마이그레이션: DevStack에서 운영형 배포로 전환하기

    [OpenStack] RDO OpenStack 마이그레이션: DevStack에서 운영형 배포로 전환하기

    RDO OpenStack 마이그레이션: DevStack에서 운영형 배포로 전환하기

    RDO OpenStack 마이그레이션 이야기는 생각보다 많은 분들이 한 번쯤 부딪히는 주제입니다. 처음엔 DevStack(데브스택, OpenStack 개발·테스트용 빠른 배포 도구)으로 가볍게 올려 봤다가, 서비스가 붙고 VM이 늘고 네트워크가 꼬이기 시작하면 그때부터 고민이 깊어지거든요. 저도 홈랩에서 시작했다가 “이걸 계속 DevStack으로 끌고 가는 게 맞나?” 싶은 순간이 왔었습니다. 처음엔 이게 뭔가 싶었는데, 막상 하나씩 뜯어보니 핵심은 단순했습니다. 개발 편의 중심 환경을 운영형 구조로 바꾸는 일, 바로 그겁니다.

    특히 DevStack 프로덕션 전환을 고민하시는 분들이라면, 단순히 설치만 다시 하는 문제가 아니라 Nova(노바, 컴퓨트 서비스), Neutron(뉴트론, 네트워크 서비스), Glance(글랜스, 이미지 서비스), Cinder(신더, 블록 스토리지) 같은 구성요소를 어떻게 옮기고 검증할지까지 같이 봐야 합니다. 여기서 중요한 포인트! RDO는 Red Hat 계열 생태계에서 OpenStack 패키지를 다루기 편하게 제공하는 배포판 계열로 많이 이야기되기 때문에, DevStack 다음 단계의 후보로 자주 검토되더라고요.

    RDO OpenStack 마이그레이션 전체 아키텍처 개요 이미지

    DevStack 단일 또는 소규모 테스트 환경에서 RDO 기반 역할 분리 구조로 옮겨 가는 흐름을 한눈에 보여주는 이미지입니다.

    1. 왜 DevStack에서 RDO OpenStack으로 옮기게 되나

    쉽게 말해 DevStack은 빨리 띄워서 기능을 확인하는 데 최적화되어 있어요. 반대로 운영 관점에서는 아쉬운 부분이 꽤 보입니다. 서비스 재기동 순서, 설정 누적 관리, 패키지 일관성, 장기 운영 시 변경 추적 같은 부분에서요. 저도 처음엔 “테스트 잘 되는데 굳이?”라고 생각했는데, 장애를 두 번 겪고 생각이 바뀌었습니다 ㅎㅎ

    • DevStack: 빠른 실험, API 테스트, 기능 검증에 강점
    • RDO: 패키지 기반 운영, 구성 관리, 역할 분리 설계에 유리
    • 핵심 차이: 편의성 중심이냐, 운영 일관성 중심이냐죠

    특히 클라우드 환경 이전에서는 “서비스가 떠 있느냐”보다 “문제가 났을 때 추적 가능한가”가 더 중요합니다. 제가 직접 해보니, 이 시점부터는 설치 속도보다 운영 구조가 훨씬 중요해지더라고요.

    2. 개념부터 정리: DevStack과 RDO의 차이

    혹시 이런 경험 있으신가요? DevStack으로는 금방 Horizon(호라이즌, 웹 대시보드)까지 열리는데, 며칠 지나고 설정을 다시 손보려 하면 어디서 바꿨는지 기억이 안 나는 경우요. 저도 그랬거든요. 그래서 먼저 개념을 분리해서 봐야 합니다.

    항목 DevStack RDO OpenStack
    주된 목적 개발, 테스트, API 검증 운영형 배포와 패키지 기반 관리
    배포 방식 스크립트 중심 패키지 및 배포 도구 중심
    구성 관리 실험에 유리 역할 분리와 반복 배포에 유리
    추천 용도 랩, 학습, 기능 확인 장기 운영 검토, 표준화된 환경

    OpenStack 배포판 선택에서 중요한 건 “무엇이 더 고급이냐”가 아니에요. 내 환경에서 변경 관리와 장애 대응이 가능한가, 이 질문이 더 중요합니다. 쉽게 말해 DevStack은 ‘빨리 시작하는 도구’이고, RDO는 ‘운영 구조를 갖춰 가는 출발점’에 가깝습니다.

    3. 마이그레이션 전에 반드시 정리할 체크리스트

    여기서 바로 설치로 들어가면 삽질 확률이 꽤 높아요. 저는 이 단계를 가볍게 봤다가 네트워크 이름하고 브리지 매핑을 뒤엎는 바람에 시간을 좀 썼습니다. 드디어 됐다 싶었는데 인스턴스가 외부 통신이 안 되더라고요.

    1. 현재 리소스 인벤토리 작성: 인스턴스, 이미지, 볼륨, 플로팅 IP, 보안그룹 목록 정리
    2. 네트워크 설계 고정: Management(관리망), Provider(프로바이더망), Tenant(테넌트망) 구분
    3. 서비스 우선순위 지정: 어떤 워크로드를 먼저 옮길지 결정
    4. 다운타임 기준 수립: 이미지 기반 재배포인지, 데이터 복제인지 미리 확정
    5. 백업 확보: DB, 설정 파일, 이미지, 중요한 볼륨 스냅샷 확보

    아래처럼 최소한의 현황 수집 명령은 먼저 뽑아 두는 걸 권합니다.

    openstack service list
    openstack endpoint list
    openstack hypervisor list
    openstack server list --all-projects
    openstack image list
    openstack volume list --all-projects
    openstack network list
    openstack subnet list
    openstack router list
    openstack security group list

    이 출력 결과를 저장해 두면, 나중에 클라우드 환경 이전 검증할 때 비교 기준이 생깁니다. 이거 진짜 편하더라고요.

    4. 실전 구현 1: DevStack 환경 백업과 추출

    제가 실제로 먼저 했던 건 “새 환경 설치”가 아니라 “기존 환경을 최대한 읽을 수 있게 만드는 것”이었어요. 그래야 옮긴 뒤에 빠진 걸 찾을 수 있거든요.

    4-1. 설정 파일과 데이터 백업

    sudo mkdir -p /backup/devstack
    sudo cp -a /etc/nova /backup/devstack/
    sudo cp -a /etc/neutron /backup/devstack/
    sudo cp -a /etc/glance /backup/devstack/
    sudo cp -a /etc/cinder /backup/devstack/
    sudo mysqldump --all-databases > /backup/devstack/openstack-all.sql

    물론 실제 경로와 데이터베이스 접속 방식은 환경마다 다릅니다. 중요한 건 서비스 설정과 메타데이터를 같이 남겨 두는 것이에요.

    4-2. 이미지와 중요 리소스 추출

    mkdir -p ~/migration/images
    for id in $(openstack image list -f value -c ID); do
      name=$(openstack image show "$id" -f value -c name | tr ' ' '_')
      openstack image save --file ~/migration/images/${name}.qcow2 "$id"
    done

    볼륨 기반 워크로드는 더 신중해야 해요. 인스턴스 이미지로만 끝나는 게 아니라 애플리케이션 데이터 정합성까지 봐야 하니까요. 데이터베이스가 올라간 인스턴스라면 파일 복사 전에 서비스 정지나 스냅샷 정책을 꼭 정해 두셔야 합니다.

    RDO OpenStack 마이그레이션 준비 단계 백업 및 리소스 추출 이미지

    기존 DevStack에서 이미지, 설정, 데이터베이스 메타데이터를 백업하는 절차를 설명하는 이미지입니다.

    5. 실전 구현 2: RDO 설치와 운영형 구조 맞추기

    이제 RDO 설치 단계네요. 여기서는 “한 번에 완성”보다 “먼저 표준 구조를 세운다”가 중요합니다. 저는 처음에 all-in-one으로 빨리 띄우고 끝내려다가, 결국 역할 분리 구조를 다시 고민하게 됐어요. 그래서 테스트용과 운영형 설계를 분리해서 접근했습니다.

    5-1. 랩 검증용 배포 예시

    sudo dnf install -y openstack-packstack
    sudo packstack --allinone

    이 방식은 랩이나 기능 검증에는 편해요. 다만 운영형으로 가려면 Controller(컨트롤러), Compute(컴퓨트), Network(네트워크) 역할을 분리해서 보는 쪽이 낫습니다.

    5-2. 네트워크 설계 예시

    [network]
    management_interface=ens192
    provider_interface=ens224
    bridge_mappings=physnet1:br-ex
    external_network=public
    floating_ip_cidr=203.0.113.0/24

    위 예시는 개념 설명용이에요. 실제 인터페이스 이름과 대역은 환경에 맞게 바꾸셔야 합니다. 저도 처음엔 브리지 이름을 대충 맞췄다가 Neutron L3 에이전트가 제대로 붙지 않아서 한참 봤습니다.

    5-3. 기본 검증 명령

    openstack compute service list
    openstack network agent list
    openstack catalog list
    openstack hypervisor stats show

    이 단계에서 서비스 등록과 에이전트 상태가 깔끔하게 보이면 다음으로 넘어가도 돼요. 반대로 여기서 빨간불이 보이면, 워크로드부터 옮기지 마시고 구조부터 다시 점검하세요. 경험상 이 순서가 시간을 아낍니다.

    6. 주의사항과 트러블슈팅: 제가 실제로 막혔던 지점들

    RDO OpenStack 마이그레이션에서 제일 많이 막히는 건 화려한 기능이 아니라 기본값 차이에요. 진짜 별거 아닌 설정 하나 때문에 반나절이 날아가더라고요.

    6-1. ⚠️ Neutron 브리지 매핑 불일치

    DevStack에서는 자동으로 맞아 들어가던 부분이 RDO에서는 더 명시적으로 보여요. physnet 이름, OVS(오픈 브이스위치) 브리지, NIC 매핑이 안 맞으면 외부 통신이 바로 안 됩니다.

    • 증상: 플로팅 IP 연결은 되는데 외부 통신 실패
    • 확인 포인트: bridge_mappings, external bridge, provider network 설정
    • 해결: 물리 NIC와 브리지 연결을 다시 확인하고 에이전트 재기동

    6-2. ⚠️ 보안그룹과 메타데이터 접근 차이

    인스턴스는 떴는데 SSH가 안 붙는 경우, 의외로 보안그룹이 원인인 경우가 많아요. 메타데이터 서비스 경로도 같이 봐야 하고요.

    openstack security group rule list default
    openstack port list --server <SERVER_ID>
    ping -c 3 <FLOATING_IP>
    ssh -i ~/.ssh/id_rsa cloud-user@<FLOATING_IP>

    6-3. ⚠️ 이미지 포맷과 드라이버 기대값 차이

    Glance 이미지 자체는 옮겨졌는데 부팅이 실패하는 경우도 있었어요. 이럴 때는 이미지 속성, 디스크 포맷, 하이퍼바이저 기대값을 같이 확인해야 합니다.

    • qcow2인지 raw인지 확인
    • virtio 드라이버 지원 여부 확인
    • cloud-init(클라우드 이닛, 초기 설정 자동화) 동작 여부 확인

    저도 처음엔 “이미지만 있으면 끝 아닌가?” 했는데, 실제로 써보니까 인스턴스 부팅 옵션이 미묘하게 달라서 예상 외로 시간이 걸렸어요.

    RDO OpenStack 마이그레이션 후 네트워크와 서비스 점검 이미지

    RDO 환경에서 네트워크 브리지, 에이전트 상태, 서비스 정상 여부를 검증하는 장면을 보여주는 이미지입니다.

    7. 검증과 결과 확인: 옮긴 뒤 무엇을 봐야 하나

    운 좋게 인스턴스가 부팅됐다고 끝이 아니에요. 여기서부터가 진짜 검증입니다. 저는 아래 순서대로 확인했습니다.

    1. 서비스 상태 확인: API, 스케줄러, 네트워크 에이전트
    2. 테스트 인스턴스 생성: 신규 부팅이 되는지 확인
    3. 외부 통신 확인: 플로팅 IP, NAT, 보안그룹 확인
    4. 스토리지 검증: 볼륨 생성, 연결, 분리 테스트
    5. 이미지 재사용성 확인: 기존 백업 이미지로 재배포 테스트
    openstack server create \
      --flavor m1.small \
      --image test-image \
      --network private \
      --security-group default \
      test-vm
    
    openstack server list
    openstack console log show test-vm
    openstack floating ip create public

    검증이 끝나면 꼭 결과를 문서화해 두세요. 어떤 네트워크 이름을 썼는지, 어떤 보안그룹 규칙이 필요한지, 어떤 이미지가 정상 부팅되는지 남겨 두면 다음 노드 증설 때 훨씬 수월합니다. 이건 멘토링할 때도 늘 강조하는 부분이에요.

    🎉 개인적으로 가장 큰 성과는 “문제가 나도 어디를 봐야 하는지 감이 생겼다”는 점이었어요. DevStack에서는 빠르게 실험할 수 있었고, RDO 쪽으로 오면서 운영 기준선이 생겼습니다.

    RDO OpenStack 마이그레이션 완료 후 검증 결과 이미지

    인스턴스 생성, 네트워크 연결, 서비스 상태가 정상으로 확인된 결과 화면을 표현하는 이미지입니다.

    8. 정리와 FAQ: DevStack 프로덕션 전환 전에 꼭 생각할 점

    결론부터 말씀드리면, DevStack에서 RDO OpenStack으로 마이그레이션은 단순 재설치가 아니라 운영 철학을 바꾸는 작업에 가깝습니다. 빨리 띄우는 환경에서, 반복 가능하고 설명 가능한 환경으로 넘어가는 거죠. 저도 처음엔 헷갈렸는데, 기준을 딱 하나로 잡으니 훨씬 쉬웠어요. “이 구성이 다음 달에도 내가 설명할 수 있는가?” 바로 그 질문이에요.

    다음 글에서는 이미지 카탈로그 정리, 네트워크 설계 분리, 그리고 베어메탈 자원과 연동할 때 체크할 포인트도 다뤄볼 예정입니다. 이전 글에서 다뤘던 홈랩 네트워크 설계 글과 연결해서 보시면 더 이해가 잘 되실 겁니다.

    자주 묻는 질문

    • Q. DevStack을 그대로 운영에 써도 되나요?
      짧게 말씀드리면 권장하긴 어려워요. 테스트와 학습에는 정말 좋지만, 장기 운영과 변경 관리까지 생각하면 운영형 구조 검토가 필요하더라고요.
    • Q. RDO만이 정답인가요?
      아닙니다. 다만 Red Hat 계열 환경과 패키지 기반 운영을 선호한다면 좋은 후보가 됩니다. 결국 OpenStack 배포판 선택은 팀 역량과 운영 기준에 달렸어요.
    • Q. 다운타임 없이 이전할 수 있나요?
      워크로드 성격에 따라 다릅니다. 상태 저장 서비스는 별도 복제 전략이 필요하고, 무상태 워크로드는 이미지 기반 재배포가 비교적 수월해요.

    💡 마지막 팁 하나만 드리면, 처음부터 완벽하게 옮기려 하지 마세요. 제 경험상 제일 잘 되는 방법은 작은 서비스 하나를 끝까지 이전하고 검증한 뒤 패턴을 복제하는 방식이었어요.

    DevStack과 RDO의 차이, 이전 체크리스트, 검증 포인트를 한 장으로 정리한 요약 이미지입니다.

  • [OpenStack] OpenStack Magnum Kubernetes 운영: 6개월 회고와 교훈

    [OpenStack] OpenStack Magnum Kubernetes 운영: 6개월 회고와 교훈

    OpenStack Magnum Kubernetes 운영: 6개월 회고와 교훈

    OpenStack Magnum Kubernetes 조합으로 클러스터를 6개월 정도 운영해보면, 처음 기대했던 포인트와 실제 운영 포인트가 꽤 다르다는 걸 느끼게 됩니다. 저도 처음엔 'OpenStack 위에서 Kubernetes를 좀 더 쉽게 만들 수 있겠네?' 정도로 접근했는데, 막상 돌려보니 편한 부분은 분명했고 반대로 운영자가 꼭 알아야 하는 제약도 꽤 있더라고요. 특히 사내 프라이빗 클라우드나 홈랩처럼 OpenStack 자원이 이미 깔린 환경에서는 Magnum 사용 후기를 많이 찾게 되는데, 실제로는 설치보다 운영이 더 중요했습니다. 이번 글은 OpenStack Magnum Kubernetes 환경을 6개월 운용하면서 느낀 점, 부딪힌 문제, 그리고 어떤 팀에 잘 맞는지 차분하게 정리한 회고입니다.

    혹시 이런 경험 있으신가요? 클러스터는 금방 만들었는데 업그레이드, 노드 교체, 네트워크 연결, 외부 로드밸런서 연동에서 갑자기 난도가 확 올라가는 순간 말이죠. 저도 딱 그랬습니다. 생성이 끝났다고 안심했는데, 운영은 또 다른 문제더라고요.

    Magnum, OpenStack, Kubernetes 워커 노드와 로드밸런서 관계를 보여주는 전체 구성도입니다.

    OpenStack Magnum이 여전히 의미 있는 이유

    쉽게 말해 Magnum은 OpenStack에서 COE(Container Orchestration Engine) 클러스터를 프로비저닝하는 서비스입니다. 과거 문서에는 Mesos나 Swarm도 함께 언급됐지만, 최근 공식 문서 기준으로는 사실상 Kubernetes 중심으로 보는 편이 맞습니다. OpenStack을 이미 쓰고 있다면 가상머신 인프라를 따로 만들고 그 위에 수동으로 kubeadm을 올리는 대신, OpenStack API와 템플릿 기반으로 클러스터 생성 흐름을 어느 정도 표준화할 수 있다는 점이 장점이거든요.

    제가 직접 써보니 이 지점이 꽤 중요했습니다. 인프라 팀 입장에서는 Nova, Neutron, Cinder, Octavia 같은 OpenStack 리소스 운영 경험이 이미 있잖아요. Magnum은 그 위에서 Kubernetes 클러스터를 조금 더 OpenStack스럽게 관리하게 해줍니다. 다만 완전한 Managed Kubernetes처럼 기대하면 실망할 수 있습니다. 제 경험상 Magnum은 '운영을 없애주는 도구'라기보다 'OpenStack 친화적인 클러스터 생성 자동화 계층'으로 이해할 때 만족도가 높았습니다.

    OpenStack Magnum 핵심 개념: Magnum, Cluster Template, Heat

    처음엔 이 구조가 꽤 헷갈렸는데, 큰 그림을 이해하고 나면 훨씬 수월해집니다. 여기서 중요한 포인트는 Magnum이 혼자 모든 걸 하는 게 아니라는 점입니다.

    • Magnum: Kubernetes 같은 COE 클러스터를 생성하고 관리하는 OpenStack 서비스입니다.
    • Cluster Template: 어떤 이미지, 네트워크, 플러그인, 노드 사양으로 클러스터를 만들지 정의하는 청사진입니다.
    • Heat: 전통적인 Magnum 배포에서 실제 인프라 스택을 구성하는 오케스트레이션 계층입니다. 장애를 파고들다 보면 결국 Heat 이벤트를 보게 되더라고요.
    • BayModel: 과거 명칭입니다. 최신 문서와 운영 맥락에서는 보통 Cluster Template 기준으로 보면 됩니다.

    한 줄로 요약하면 이렇습니다. Magnum이 요청을 받고, Cluster Template을 참고해 OpenStack 자원을 만들고, 전통적인 드라이버 환경에서는 Heat가 실제 스택 생성을 수행하는 구조입니다. 참고로 최근 공식 문서에서는 Heat 기반 드라이버가 deprecated로 안내되고 있어서, 운영 중인 환경이 어떤 드라이버를 쓰는지도 꼭 확인해두는 게 좋습니다.

    구성 요소 역할 운영할 때 봐야 할 포인트
    Magnum 클러스터 생성/삭제 요청 처리 API 상태, 템플릿 파라미터, 사용 중인 드라이버
    Heat 스택 생성과 자원 오케스트레이션 이벤트 로그, 실패 리소스 추적
    Neutron/Octavia 네트워크와 로드밸런서 외부 연결, 서비스 노출, 포트/보안그룹
    Kubernetes 워크로드 스케줄링과 운영 노드 상태, CNI, Ingress, 스토리지

    시작 전에 체크했던 항목들

    Magnum 사용 후기에서 잘 안 보이는데, 실제로는 사전 점검이 절반입니다. 저도 처음엔 클러스터 생성 명령부터 쳤다가 네트워크랑 이미지 때문에 한참 돌아갔거든요.

    1. OpenStack 서비스 상태 확인
      Magnum만 살아 있어도 되는 게 아니라 Keystone, Nova, Neutron, Glance, Heat가 기본적으로 안정적이어야 합니다.
    2. Kubernetes용 이미지 준비
      이미지 이름보다 더 중요한 건 클러스터 드라이버 요구사항입니다. 최근 공식 문서 기준으로는 Kubernetes용 이미지의 os_distro 메타데이터가 드라이버와 맞아야 하고, 기본 예시는 Fedora CoreOS 계열을 전제로 설명합니다.
    3. 외부 네트워크와 DNS 설계
      API 접근, 노드 egress, 이미지 pull 경로를 미리 봐야 합니다.
    4. Load Balancer 정책 확인
      마스터 API 엔드포인트와 Service 노출 방식이 Octavia와 어떻게 연결되는지 미리 확인해야 합니다.
    5. 스토리지 전략 결정
      Cinder 연동 방식을 어떻게 가져갈지, 동적 볼륨 전략을 초반부터 쓸지 미리 정해두는 게 좋습니다.

    OpenStack Magnum으로 Kubernetes 클러스터 만들기

    이제 실전입니다. 아래 예시는 홈랩과 테스트 환경에서 자주 확인하던 흐름을 기준으로 정리했습니다. 다만 배포판, 드라이버, OpenStack 릴리스에 따라 옵션 이름이나 권장 이미지가 달라질 수 있습니다. 그래서 핵심은 명령어를 외우는 것보다 어떤 리소스를 먼저 확인해야 하는지를 잡는 데 있습니다.

    1. 기본 리소스 확인

    openstack coe service list
    openstack network list
    openstack subnet list
    openstack image list
    openstack flavor list
    openstack keypair list

    여기서 네트워크, 서브넷, 이미지, flavor, keypair가 실제로 준비되어 있는지 먼저 봅니다. 이거 안 보고 바로 템플릿 만들면 높은 확률로 다시 돌아오게 됩니다.

    2. Cluster Template 생성

    openstack coe cluster template create k8s-template \
      --coe kubernetes \
      --image fedora-coreos-k8s \
      --external-network public \
      --fixed-network private-net \
      --fixed-subnet private-subnet \
      --flavor m1.medium \
      --master-flavor m1.medium \
      --docker-storage-driver overlay2 \
      --network-driver flannel \
      --volume-driver cinder \
      --floating-ip-enabled \
      --master-lb-enabled

    여기서 실수가 가장 많이 나왔습니다. 특히 external-network, fixed-network, image 조합이 안 맞으면 생성이 중간에 터지더라고요. 처음엔 Magnum 문제인 줄 알았는데, 파고 들어가면 Neutron 설정이나 이미지 메타데이터 문제인 경우가 많았습니다. 이미지 이름은 예시일 뿐이고, 실제 환경에서는 해당 드라이버가 요구하는 이미지 속성을 꼭 확인하셔야 합니다.

    OpenStack Magnum Cluster Template과 Kubernetes 리소스 매핑 이미지

    Cluster Template이 네트워크, 이미지, 플레버, 로드밸런서와 연결되는 흐름을 설명하는 다이어그램입니다.

    3. 클러스터 생성

    openstack coe cluster create k8s-prod-like \
      --cluster-template k8s-template \
      --master-count 1 \
      --node-count 3 \
      --keypair mykey

    테스트 환경에서는 master-count와 node-count를 보수적으로 시작하는 게 좋습니다. 처음부터 크게 만들면 실패 원인도 커지고, 디버깅 비용도 같이 올라갑니다. 저는 1 control plane, 2~3 worker부터 시작해서 네트워크와 스토리지가 안정적인지 먼저 봤습니다.

    4. cluster config 가져와서 접속

    mkdir -p k8s-prod-like-config
    openstack coe cluster config k8s-prod-like --dir k8s-prod-like-config
    export KUBECONFIG=$(pwd)/k8s-prod-like-config/config
    kubectl get nodes
    kubectl get pods -A

    이 단계는 환경에 따라 조금 다릅니다. 어떤 환경에서는 eval $(openstack coe cluster config <cluster-name>) 형태로 바로 접속하기도 하고, 어떤 환경에서는 생성된 config 파일을 KUBECONFIG로 잡아 쓰는 식이 더 명확했습니다. 생성 직후에는 CNI가 아직 완전히 올라오지 않은 경우도 있으니 몇 분 정도 여유를 두고 확인하는 게 좋습니다.

    5. 간단한 워크로드 배포

    apiVersion: apps/v1
    kind: Deployment
    metadata:
      name: demo-nginx
    spec:
      replicas: 2
      selector:
        matchLabels:
          app: demo-nginx
      template:
        metadata:
          labels:
            app: demo-nginx
        spec:
          containers:
          - name: nginx
            image: nginx:stable
            ports:
            - containerPort: 80
    ---
    apiVersion: v1
    kind: Service
    metadata:
      name: demo-nginx
    spec:
      selector:
        app: demo-nginx
      ports:
      - port: 80
        targetPort: 80
      type: LoadBalancer
    kubectl apply -f demo-nginx.yaml
    kubectl get deploy,svc,pods

    이 단계에서 OpenStack Magnum Kubernetes 환경이 정말 내 환경에서 굴러가는지 감이 옵니다. Service가 외부 IP를 잘 받는지, Pod가 정상 스케줄링되는지, 노드 간 통신이 되는지까지 같이 볼 수 있거든요.

    6개월 운영하면서 좋았던 점

    장점은 분명합니다. 특히 인프라 팀이 OpenStack에 익숙할수록 체감이 큽니다.

    • 클러스터 생성 표준화: 템플릿 기반이라 환경 복제가 수월했습니다.
    • OpenStack 권한 체계와 잘 맞음: 프로젝트 단위 자원 분리가 익숙해서 운영 흐름이 덜 낯설었습니다.
    • 홈랩 실험에 좋음: kubeadm을 매번 손으로 치는 것보다 반복 실험이 편하더라고요.
    • 자원 가시성 확보: VM, 볼륨, 포트, 로드밸런서를 OpenStack 관점에서 같이 추적할 수 있었습니다.

    특히 여러 팀이 비슷한 Kubernetes 클러스터 운영 패턴을 가져가야 한다면 Cluster Template은 생각보다 강력합니다. 누가 만들어도 기본 뼈대가 크게 흔들리지 않거든요. 이건 실제로 꽤 편했습니다.

    운영하면서 부딪힌 문제와 트러블슈팅

    여기가 진짜 중요했습니다. OpenStack Magnum Kubernetes 글을 보면 설치 데모는 많아도, 운영 중 생기는 문제는 상대적으로 덜 보이더라고요. 그런데 결국 운영은 장애와 변경 관리 싸움이었습니다.

    1. 문제를 Kubernetes에서만 찾으면 늦습니다

    Pod가 안 뜨거나 Service 외부 노출이 안 되면 처음엔 kubectl만 보게 됩니다. 저도 그랬습니다. 그런데 실제 원인은 Heat 스택 실패, 보안그룹 규칙, Neutron 포트 상태, Octavia 리스너 문제인 경우가 적지 않았습니다.

    openstack stack list
    openstack stack resource list <stack-name>
    openstack stack event list <stack-name>

    여기서 중요한 포인트는 Magnum 장애 분석에는 Kubernetes와 OpenStack을 같이 보는 시야가 필요하다는 점입니다. 한쪽만 보면 원인을 놓치기 쉽습니다.

    2. 업그레이드 전략은 미리 정해야 합니다

    Kubernetes 클러스터 운영에서 가장 민감한 건 업그레이드입니다. Magnum이 있다고 해서 업그레이드가 마법처럼 쉬워지는 건 아니었습니다. 오히려 템플릿, 이미지, 애드온, CNI 버전 호환성을 같이 보게 되더라고요. 그래서 운영 중반부터는 '인플레이스 업그레이드에 집착하지 말고, 새 템플릿 기반 병행 클러스터를 검증한 뒤 전환하자' 쪽으로 사고를 바꿨습니다.

    조금 번거로워 보여도 결과적으로는 더 안전했습니다. 특히 사내 서비스나 장기 운영 워크로드가 얹힌 상태라면 더 그렇습니다.

    3. 네트워크 플러그인과 외부 노출은 가장 먼저 검증해야 합니다

    Ingress나 LoadBalancer 서비스가 기대대로 동작하지 않으면, 사용자 입장에서는 클러스터가 죽은 것처럼 보입니다. 실제로 써보니까 네트워크 드라이버와 OpenStack 네트워크 설계가 맞물리는 구간이 생각보다 까다로웠습니다.

    • Node 간 Pod 통신 확인
    • API 서버 접근 경로 확인
    • 외부 IP 할당 정책 확인
    • 보안그룹 인바운드/아웃바운드 확인

    처음엔 애플리케이션 문제인 줄 알았는데, 보안그룹 한 줄 빠진 거여서 허탈했던 적도 있습니다. 이런 삽질이 은근 많더라고요.

    4. 노드 장애 복구는 '재현 가능성'이 핵심입니다

    노드 하나가 망가졌을 때 수동 조치만으로 복구가 되면 당장은 편합니다. 그런데 그게 반복 가능하지 않으면 다음 장애 때 더 힘들어집니다. 저는 6개월 운영하면서 로그를 많이 남겼고, 결국에는 '노드 문제는 수동 응급조치보다 템플릿과 생성 절차 정비가 우선'이라는 결론을 내렸습니다.

    검증과 결과: 운영 기준으로 무엇을 확인했나

    클러스터가 떴다는 것과 운영 가능한 상태라는 것은 다릅니다. 저는 아래 순서로 검증했습니다.

    1. 노드 Ready 상태 확인
    2. CoreDNS, CNI, kube-proxy 같은 기본 시스템 Pod 확인
    3. LoadBalancer 서비스 외부 노출 확인
    4. Persistent Volume 동작 확인
    5. 재부팅 또는 노드 교체 후 상태 재확인
    kubectl get nodes
    kubectl get pods -A
    kubectl get svc -A
    kubectl get storageclass
    kubectl describe node <node-name>

    간단하지만 이 체크리스트가 꽤 유효했습니다. 6개월 동안 느낀 건, OpenStack Magnum Kubernetes 환경에서는 처음 생성 성공보다 반복 검증 성공이 훨씬 중요하다는 점입니다.

    OpenStack Magnum Kubernetes 클러스터 검증 결과 대시보드 이미지

    노드 Ready 상태, 시스템 Pod, 서비스 외부 IP 상태를 함께 보여주는 결과 확인 이미지입니다.

    운영 결과를 한 줄로 정리하면 이렇습니다. 소규모 프라이빗 클라우드나 내부 플랫폼 팀 환경에서는 충분히 의미가 있지만, 모든 운영 복잡도를 감춰주는 도구는 아니다. 이 기대치만 정확하면 꽤 만족스럽게 사용할 수 있습니다.

    어떤 환경에 잘 맞고, 어떤 경우엔 아쉬운가

    상황 Magnum 적합도 이유
    OpenStack 중심의 내부 인프라 팀 높음 기존 운영 지식과 연결되기 좋습니다.
    홈랩/검증 환경 높음 반복 생성과 실험에 유리합니다.
    완전관리형 서비스 기대 낮음 운영자가 알아야 할 영역이 여전히 넓습니다.
    빠른 버전 전환이 잦은 환경 중간 이미지, 템플릿, 네트워크 호환성 검증이 필요합니다.

    저도 처음엔 Magnum이 조금 더 많은 걸 알아서 해주길 기대했었습니다. 그런데 6개월 써보니 관점을 바꾸게 되더라고요. Magnum은 운영을 없애주는 도구가 아니라, OpenStack 안에서 Kubernetes 클러스터 운영의 출발점을 정리해주는 도구에 가깝습니다. 이 차이를 이해하면 만족도가 확 올라갑니다.

    OpenStack Magnum 도입 전후 Kubernetes 운영 방식 비교 이미지

    수동 kubeadm 방식과 Magnum 기반 운영 방식의 차이를 요약한 비교 인포그래픽입니다.

    정리와 다음 단계

    정리해보면, OpenStack Magnum으로 Kubernetes 클러스터 운영을 해보면서 얻은 교훈은 꽤 명확했습니다.

    • Magnum은 생성 자동화에 강점이 있습니다.
    • 운영 문제는 결국 OpenStack과 Kubernetes를 함께 봐야 풀립니다.
    • 업그레이드와 네트워크 검증은 초반 설계 단계에서 방향을 잡아야 덜 힘듭니다.
    • 작게 시작해서 반복 검증하는 방식이 가장 현실적이었습니다.

    지금 OpenStack 기반으로 클라우드 네이티브 환경을 고민하고 계시다면 Magnum은 충분히 검토할 만한 선택지입니다. 다만 Managed Kubernetes처럼 생각하면 실망할 수 있고, OpenStack 친화적인 클러스터 프로비저닝 계층으로 이해하면 훨씬 잘 맞습니다. 관련해서 이전에 정리한 OpenStack 네트워크 기본기 글이나 스토리지 구성 글도 함께 보면 이해가 훨씬 빨라집니다.

    다음 글에서는 이번 회고에서 살짝 언급했던 Ingress 구성, Cinder 기반 스토리지 연결, 그리고 운영 중 모니터링 포인트를 따로 묶어서 정리해보려 합니다. 이어서 보면 실제 운영 흐름이 더 선명하게 보이실 거예요.

    자주 묻는 질문 FAQ

    Magnum이 있으면 Kubernetes 운영이 쉬워지나요?

    일부는 맞고, 일부는 아닙니다. 클러스터 생성과 표준화는 확실히 편해집니다. 하지만 장애 분석, 네트워크, 업그레이드 전략은 여전히 운영자의 몫입니다.

    Magnum과 kubeadm 중 무엇이 더 낫나요?

    OpenStack 환경 표준화가 중요하면 Magnum이 편합니다. 반대로 세밀한 수동 제어가 더 중요하고 OpenStack 통합이 핵심이 아니라면 kubeadm 쪽이 더 단순하게 느껴질 수도 있습니다.

    6개월 운영 기준으로 가장 먼저 챙길 것은 무엇인가요?

    네트워크와 업그레이드 전략입니다. 이 두 가지를 초반에 대충 잡으면 나중에 운영 피로도가 크게 올라갑니다.

  • [OpenStack] DevStack 환경에서 OpenStack 서비스 간 연동 문제 해결 가이드

    [OpenStack] DevStack 환경에서 OpenStack 서비스 간 연동 문제 해결 가이드

    DevStack 환경에서 OpenStack 서비스 간 연동 문제 해결 가이드

    DevStack OpenStack 연동 문제는 생각보다 자주 만납니다. 설치는 얼추 끝난 것 같은데 인스턴스가 안 뜨고, 네트워크가 안 붙고, 이미지 조회는 되는데 부팅은 실패하고, 로그를 보면 Keystone(키스톤, 인증 서비스) 쪽 인증 에러가 한 줄씩 튀어나오거든요. 저도 홈랩에서 개발 환경을 구성하면서 이런 삽질을 꽤 했더라고요. 처음엔 서비스가 각각 살아 있으면 되는 줄 알았는데, 실제로는 서비스 간 엔드포인트(endpoint, 접속 지점), 메시지 큐(message queue), 데이터베이스(database), 서비스 사용자(service user) 권한이 한 군데만 어긋나도 전체 흐름이 무너집니다.

    이번 글은 제품 홍보나 이론 소개가 아니라, 제가 직접 DevStack 개발 환경에서 반복적으로 겪었던 OpenStack 서비스 연동 문제를 어떤 순서로 확인하고 풀었는지 정리한 실전형 트러블슈팅 가이드입니다. 혹시 DevStack 트러블슈팅 하다가 로그만 한참 보고 계셨다면, 이 순서대로 점검해 보시면 시간 꽤 아끼실 수 있을 겁니다.

    Keystone, Nova, Neutron, Glance, Cinder가 DevStack 환경에서 어떻게 연결되는지 한눈에 보여주는 개요 이미지입니다.

    1. 왜 DevStack 개발 환경에서 OpenStack 서비스 연동 문제가 자주 생길까

    쉽게 말해 DevStack은 빠르게 OpenStack을 올려서 개발과 검증을 하기 위한 환경입니다. 그래서 편한 점도 많지만, 반대로 서비스가 많고 연결 지점도 많습니다. 예를 들어 Nova(노바, 컴퓨트 서비스)가 인스턴스를 띄우려면 Keystone에서 토큰 인증을 받고, Glance(글랜스, 이미지 서비스)에서 이미지를 읽고, Neutron(뉴트론, 네트워크 서비스)에서 포트를 만들고, 필요하면 Cinder(신더, 블록 스토리지)까지 붙어야 하거든요.

    즉, 화면에서 보이는 실패 증상은 하나인데 원인은 여러 군데일 수 있습니다. 여기서 중요한 포인트! 증상 기준으로 보지 말고 요청 흐름 기준으로 봐야 빨리 잡힙니다. 저도 처음엔 Horizon(호라이즌, 대시보드)에서 에러만 보고 있었는데, 실제 원인은 RabbitMQ(래빗MQ, 메시지 브로커) 연결 문제였던 적도 있더라고요.

    2. OpenStack 서비스 연동을 흐름으로 이해하기

    OpenStack 서비스 연동을 너무 어렵게 볼 필요는 없습니다. 요청 하나가 아래처럼 지나간다고 생각하시면 됩니다.

    1. 사용자 또는 CLI가 Keystone에 인증 요청을 보냅니다.
    2. 인증이 끝나면 서비스 카탈로그(service catalog, 서비스 목록)와 토큰을 받습니다.
    3. Nova가 Glance, Neutron, Placement 같은 다른 서비스와 통신합니다.
    4. 백엔드에서는 메시지 큐와 데이터베이스가 중간 연결을 받쳐줍니다.
    5. 문제가 생기면 API 응답, 서비스 로그, 백엔드 연결 상태 중 하나가 어긋납니다.
    구성 요소 역할 연동 실패 시 흔한 증상
    Keystone 인증/권한/엔드포인트 관리 401 Unauthorized, endpoint not found
    Nova 가상머신 생성 및 제어 인스턴스 build 실패, scheduling 오류
    Neutron 네트워크/포트/IP 관리 포트 생성 실패, floating IP 연결 불가
    Glance 이미지 저장 및 조회 이미지 다운로드 실패, boot from image 오류
    Cinder 볼륨 제공 볼륨 attach 실패, device not found

    이 표만 머리에 넣어도 DevStack OpenStack 연동 문제를 볼 때 훨씬 덜 막막합니다. 사실 로그를 읽는 요령도 결국은 어느 서비스가 다음 서비스를 못 찾고 있는지를 보는 거거든요.

    3. DevStack 트러블슈팅 전에 먼저 확인할 기본 체크리스트

    본격적으로 로그 보기 전에, 저는 아래 항목부터 먼저 봅니다. 사소해 보여도 여기서 많이 걸립니다.

    • 호스트명과 IP: 서비스가 등록된 주소와 실제 바인딩 주소가 같은지
    • /etc/hosts: 로컬 이름 해석이 꼬이지 않았는지
    • 시스템 시간: 토큰 인증 문제를 만들 정도로 시간 차이가 없는지
    • 포트 리스닝 상태: 각 API 서비스가 실제로 떠 있는지
    • 환경 변수: admin-openrc 같은 OpenRC 파일을 제대로 불러왔는지

    제가 직접 해보니, OpenRC를 안 읽은 상태에서 CLI 테스트를 해서 Keystone 문제로 착각한 경우가 제일 허무했습니다. 드디어 원인 찾았다 싶었는데 그냥 환경 변수 누락이더라고요.

    cd ~/devstack
    source openrc admin admin
    openstack token issue
    openstack service list
    openstack endpoint list
    

    위 명령이 정상 동작하면 최소한 Keystone 인증과 서비스 카탈로그 조회는 된다는 뜻입니다. 여기서부터 하나씩 좁혀가면 됩니다.

    4. 실전 구현: DevStack 환경에서 서비스 연동 상태 점검 순서

    4-1. DevStack 설정 파일부터 다시 봅니다

    local.conf에 서비스 활성화가 빠져 있거나, 비밀번호 변수 구성이 엇갈리면 설치는 돼도 연동이 흔들립니다. 아래는 가장 기본적인 예시입니다.

    [[local|localrc]]
    ADMIN_PASSWORD=secret
    DATABASE_PASSWORD=$ADMIN_PASSWORD
    RABBIT_PASSWORD=$ADMIN_PASSWORD
    SERVICE_PASSWORD=$ADMIN_PASSWORD
    HOST_IP=192.168.56.10
    
    ENABLED_SERVICES=g-api,g-reg,key,n-api,n-cpu,n-cond,n-sch,n-novnc,q-svc,q-agt,q-dhcp,q-l3,q-meta,placement-api,c-api,c-bak,c-sch,horizon
    

    여기서 중요한 건 비밀번호를 단순하게 맞추라는 의미가 아니라, DevStack이 기대하는 변수 간 일관성을 유지하라는 겁니다. 실제 운영 환경에서는 당연히 더 엄격하게 관리해야 하고요.

    4-2. 서비스 프로세스와 API 포트를 확인합니다

    서비스 연동 오류처럼 보여도 실제로는 프로세스가 죽어 있는 경우가 꽤 많습니다.

    sudo systemctl --type=service | grep -E 'apache2|mariadb|mysql|rabbitmq'
    ss -lntp | grep -E '5000|8774|9292|9696|8776'
    ps -ef | grep -E 'nova|neutron|glance|keystone' | grep -v grep
    

    포트 기준으로 보면 보통 다음을 많이 확인합니다.

    • 5000: Keystone API
    • 8774: Nova API
    • 9292: Glance API
    • 9696: Neutron API
    • 8776: Cinder API
    DevStack OpenStack 연동 문제 점검을 위한 local.conf 설정 구성 이미지

    DevStack 설정 파일과 활성화된 OpenStack 서비스가 어떤 관계로 연결되는지 보여주는 설명 이미지입니다.

    4-3. 서비스 카탈로그와 엔드포인트를 검증합니다

    OpenStack 서비스 연동에서 진짜 자주 문제를 만드는 게 endpoint입니다. 서비스는 살아 있는데 잘못된 URL을 보고 있으면 호출이 실패합니다.

    openstack service list
    openstack endpoint list --long
    openstack catalog list
    

    여기서 체크할 건 단순합니다.

    1. Keystone에 각 서비스가 등록되어 있는지
    2. public, internal, admin URL이 비정상 주소를 가리키지 않는지
    3. 호스트명과 IP가 현재 DevStack 환경과 일치하는지

    특히 예전에 스냅샷이나 VM 복제로 실험 환경을 다시 만들었을 때, 예전 IP가 남아 있어서 삽질 좀 했습니다. 겉으론 다 살아 있는데 실제 호출은 엉뚱한 주소로 나가더라고요.

    4-4. 서비스별 실제 호출을 해봅니다

    CLI 목록 조회가 된다고 끝이 아닙니다. 진짜 연동이 되는지 보려면 서비스별로 최소 기능을 직접 호출해야 합니다.

    openstack image list
    openstack network list
    openstack flavor list
    openstack server list
    openstack volume service list
    

    그리고 가능하면 테스트용 네트워크와 인스턴스 생성까지 확인합니다.

    openstack network create demo-net
    openstack subnet create demo-subnet --network demo-net --subnet-range 10.10.0.0/24
    openstack router create demo-router
    openstack router add subnet demo-router demo-subnet
    

    이 단계에서 Neutron이 꼬여 있으면 바로 드러납니다. DevStack 트러블슈팅은 결국 조회 성공보다 생성/변경 요청 성공이 더 중요하더라고요.

    5. ⚠️ 실제로 많이 만나는 OpenStack 서비스 연동 문제와 해결법

    5-1. Keystone 인증은 되는데 Nova 인스턴스 생성이 실패하는 경우

    증상은 보통 인스턴스가 ERROR 상태로 떨어집니다. 이럴 때는 Nova 로그와 scheduler 흐름을 먼저 봅니다.

    sudo journalctl -u devstack@n-api -n 100 --no-pager
    sudo journalctl -u devstack@n-cpu -n 100 --no-pager
    sudo journalctl -u devstack@n-sch -n 100 --no-pager
    

    제가 자주 본 원인은 아래 셋입니다.

    • Glance 이미지 조회 실패
    • Neutron 포트 생성 실패
    • Placement 자원 조회 실패

    즉 Nova 자체 문제처럼 보여도 실제로는 다른 서비스 연동 이슈인 경우가 많습니다.

    5-2. Neutron 네트워크는 보이는데 포트 생성이 안 되는 경우

    이건 Linux bridge나 Open vSwitch 같은 네트워크 백엔드 구성과 에이전트 상태를 함께 봐야 합니다. DevStack에서는 설치가 끝났어도 에이전트가 비정상 상태일 때가 있습니다.

    openstack network agent list
    sudo journalctl -u devstack@q-svc -n 100 --no-pager
    sudo journalctl -u devstack@q-agt -n 100 --no-pager
    

    Alive 상태가 XXX 로 보이면, 네트워크 에이전트가 컨트롤 플레인과 정상 통신하지 못하는 경우가 많습니다. 여기서 중요한 포인트는 API만 보지 말고 에이전트 헬스까지 같이 봐야 한다는 점입니다.

    5-3. Glance 이미지 목록은 보이는데 부팅만 실패하는 경우

    처음엔 이게 뭔가 싶었는데, 이미지 메타데이터나 다운로드 경로 문제일 때가 있었습니다. 이미지가 등록됐다고 해서 실제 boot path가 정상이라는 뜻은 아니거든요.

    openstack image show cirros
    sudo journalctl -u devstack@g-api -n 100 --no-pager
    

    여기서는 이미지 상태가 active 인지, 접근 권한 문제는 없는지, Nova가 해당 이미지를 실제 읽을 수 있는지 확인합니다.

    5-4. RabbitMQ 또는 DB 연결 문제로 서비스가 간헐적으로 실패하는 경우

    이건 더 골치 아픕니다. 같은 명령이 한 번은 되고 한 번은 안 되거든요. 저도 실제로 써보니까 간헐 장애는 오히려 더 찾기 어렵더라고요.

    sudo systemctl status rabbitmq-server
    sudo systemctl status mariadb
    sudo journalctl -u rabbitmq-server -n 100 --no-pager
    

    메시지 큐나 DB 연결이 흔들리면 각 서비스 로그에 timeout, reconnect, access denied 같은 메시지가 섞여 나옵니다. 이럴 때는 개별 서비스보다 공통 백엔드부터 의심하는 게 빠릅니다.

    DevStack 트러블슈팅 과정에서 OpenStack 서비스 연동 로그를 분석하는 이미지

    여러 OpenStack 서비스 로그를 비교해서 장애 지점을 추적하는 실제 운영 감각의 트러블슈팅 이미지입니다.

    6. 검증: 어디까지 확인해야 진짜 해결된 걸까

    로그 한 줄 없어졌다고 끝난 건 아닙니다. 저는 아래 순서가 모두 통과하면 그제야 해결로 봅니다.

    1. 토큰 발급이 정상 동작한다.
    2. 서비스 목록과 엔드포인트가 정상 조회된다.
    3. 이미지, 네트워크, 플래버 목록 조회가 된다.
    4. 테스트 네트워크와 서브넷 생성이 된다.
    5. 테스트 인스턴스가 ACTIVE 또는 기대 상태로 전환된다.
    6. 필요 시 floating IP 연결 또는 콘솔 접속이 된다.
    openstack token issue
    openstack endpoint list
    openstack network list
    openstack subnet list
    openstack image list
    openstack server create --flavor m1.tiny --image cirros --network demo-net test-vm
    openstack server list
    openstack console url show test-vm
    

    이 단계까지 가면 DevStack OpenStack 연동 문제는 대부분 정리됩니다. 물론 테스트 이미지나 플래버는 환경에 따라 다를 수 있으니, 현재 설치 상태에 맞게 조정하시면 됩니다.

    서비스 연동이 정상화된 뒤 CLI와 대시보드에서 인스턴스, 네트워크, 이미지가 모두 보이는 결과 이미지입니다.

    7. 빠른 진단 기준

    증상 먼저 볼 곳 우선 점검 포인트
    401 인증 오류 Keystone OpenRC, 토큰, 서비스 사용자 비밀번호
    인스턴스 생성 실패 Nova Glance/Neutron/Placement 연동
    포트 생성 실패 Neutron agent 상태, 브리지 구성, endpoint
    이미지 부팅 실패 Glance 이미지 상태, 접근 권한, API 응답
    간헐적 timeout RabbitMQ/DB 공통 백엔드 연결 안정성

    이 표는 제가 실제로 자주 참고하는 기준입니다. 독자분들도 로그를 보기 전에 먼저 증상별 1차 의심 지점을 잡아두면 훨씬 덜 헤매실 겁니다.

    8. 자주 묻는 질문과 실무 팁

    Q1. 서비스가 모두 떠 있는데도 왜 연동이 안 될까요?

    A. 프로세스가 떠 있는 것과 API 호출이 성공하는 것은 다릅니다. endpoint 등록, 권한, 환경 변수, 에이전트 상태를 같이 보셔야 합니다.
    Q2. DevStack을 다시 설치하는 게 더 빠를 때도 있나요?

    A. 있습니다. 특히 실험을 여러 번 반복하면서 설정이 꼬였을 때는 부분 수정보다 재구성이 빠를 때가 있더라고요. 다만 그 전에 왜 꼬였는지를 한 번 정리해 두면 다음부터 훨씬 빨라집니다.

    Q3. 로그는 어디부터 봐야 하나요?

    A. 사용자 요청이 처음 닿는 지점부터 보는 게 좋습니다. 예를 들어 인스턴스 생성 실패면 Nova API부터 보고, 그 다음 Neutron/Glance 쪽 연동 로그를 따라가는 방식이 효율적입니다.

    • 💡 팁: CLI 테스트는 Horizon보다 원인 분리가 쉽습니다.
    • 💡 팁: 한 번에 여러 문제를 고치지 말고, 한 항목씩 검증하세요.
    • 💡 팁: 변경 전 endpoint 목록과 서비스 상태를 저장해 두면 비교가 편합니다.
    DevStack OpenStack 연동 문제 해결 체크리스트 인포그래픽

    인증, 네트워크, 이미지, 인스턴스 생성 문제를 어떤 순서로 점검할지 한 장으로 정리한 요약 인포그래픽입니다.

    9. 마무리: DevStack 트러블슈팅의 핵심은 흐름을 보는 눈입니다

    이번 글에서는 DevStack OpenStack 연동 문제를 단순히 에러 메시지별로 보는 대신, 서비스 요청 흐름 기준으로 점검하는 방법을 정리해 봤습니다. 저도 처음엔 서비스 이름이 너무 많아서 겁부터 났었는데, 실제로는 Keystone, Nova, Neutron, Glance, Cinder가 어떻게 이어지는지만 잡아도 절반은 해결되더라고요.

    정리하면 이렇습니다. 인증이 되는지 확인하고, 엔드포인트가 맞는지 보고, 서비스별 실제 생성 요청을 날려보고, 공통 백엔드까지 확인한다. 이 순서가 DevStack 트러블슈팅에서 꽤 강력합니다. 다음 글에서는 DevStack 환경에서 Neutron 네트워크를 조금 더 깊게 파서, 브리지 구성과 외부 네트워크 연결 쪽도 따로 다뤄볼 예정입니다. 이전 글에서 다뤘던 OpenStack 기본 구성 이해 편이 있으시다면 같이 보시면 흐름 잡는 데 더 도움이 될 겁니다.

    혹시 지금 비슷한 OpenStack 서비스 연동 문제를 겪고 계시다면, 오늘 소개한 체크리스트만 따라가도 원인 범위를 꽤 빨리 좁히실 수 있을 겁니다. 드디어 됐다! 하는 순간이 분명 오거든요. 그 맛에 또 홈랩 만지게 됩니다 ㅎㅎ

  • [OpenStack] OpenStack Glance 이미지 관리, 효율적인 스토리지 활용 전략

    [OpenStack] OpenStack Glance 이미지 관리, 효율적인 스토리지 활용 전략

    [OpenStack] OpenStack Glance 이미지 관리, 효율적인 스토리지 활용 전략

    OpenStack Glance 이미지 관리가 생각보다 금방 스토리지를 잡아먹는다는 점, 운영해보신 분들은 아마 바로 공감하실 겁니다. 처음엔 이미지 몇 개 올리는 정도라서 괜찮아 보이는데, 팀이 늘고 프로젝트가 늘고 베이스 이미지가 조금씩 갈라지기 시작하면 디스크 사용량이 갑자기 튀더라고요. 저도 홈랩이랑 테스트 클러스터를 같이 굴리면서 이 부분에서 삽질 좀 했습니다 ㅎㅎ 특히 같은 계열의 Ubuntu(우분투)나 Rocky Linux(로키 리눅스) 이미지를 여러 버전으로 쌓아두다 보니, 관리보다 저장 공간이 더 큰 고민이 되더군요.

    이번 글에서는 OpenStack Glance 이미지 관리를 비용 관점에서 다시 정리해보겠습니다. 단순히 이미지를 올리고 지우는 수준이 아니라, 어떤 백엔드 스토리지(back-end storage, 이미지가 실제 저장되는 저장소)를 고를지, 업로드 전 이미지를 어떻게 다듬을지, 그리고 운영 중 어떤 기준으로 정리해야 클라우드 스토리지 비용과 관리 복잡도를 같이 낮출 수 있는지 경험 위주로 풀어보겠습니다.

    Glance, Nova, Ceph 또는 파일 스토리지 간의 관계를 한눈에 보여주는 전체 구성도입니다.

    1. 왜 Glance 스토리지 전략이 먼저 잡혀야 할까

    쉽게 말해 Glance(글랜스)는 가상머신 이미지 창고입니다. 그런데 창고라고 해서 무조건 크게만 만들면 되는 건 아니거든요. 이미지가 한 번 올라오면 여러 프로젝트에서 반복 사용되고, 템플릿처럼 복제되고, 오래된 이미지가 방치되기 쉽습니다. 결국 Glance 스토리지는 성능만의 문제가 아니라 운영비와 정리 습관의 문제이기도 합니다.

    제가 직접 해보니 흔히 생기는 패턴이 이렇습니다. 처음엔 테스트용 이미지 3~4개로 시작합니다. 그러다 패키지를 미리 넣은 커스텀 이미지가 생기고, 보안 패치 반영본이 생기고, 긴급 롤백용 이전 이미지까지 남기게 됩니다. 여기서 중요한 포인트! 이미지가 늘어나는 속도는 생각보다 빠른데, 줄어드는 속도는 거의 0에 가깝습니다. 그래서 초반에 정책 없이 시작하면 나중에 정리 비용이 더 커집니다.

    • 공용 베이스 이미지와 프로젝트 전용 이미지를 구분해야 합니다.
    • 업로드 전 최적화를 하지 않으면 같은 용도의 이미지도 용량 차이가 크게 납니다.
    • 백엔드 선택에 따라 확장성, 운영 난이도, 장애 대응 방식이 달라집니다.
    • 수명주기 정책이 없으면 오래된 이미지가 계속 남습니다.

    2. OpenStack Glance 이미지 관리 핵심 개념 정리

    저도 처음엔 헷갈렸는데, Glance는 이미지를 보관하고 메타데이터(metadata, 이미지 설명 정보)를 관리하는 역할에 가깝습니다. 실제 이미지 파일은 별도 저장소에 들어갑니다. 이 저장소가 filesystem(파일시스템), Ceph RBD(분산 블록 스토리지), Swift(오브젝트 스토리지) 같은 형태로 붙는 거죠.

    2-1. 자주 보는 용어

    • Image format(이미지 포맷): qcow2, raw 같은 디스크 이미지 형식입니다.
    • Store(스토어): Glance가 실제 데이터를 저장하는 대상입니다.
    • Visibility(가시성): public, private, community처럼 누가 볼 수 있는지 정하는 속성입니다.
    • Checksum / Hash(무결성 검증값): 업로드 중 손상 여부를 확인할 때 중요합니다.

    2-2. 어떤 백엔드가 비용 효율적일까

    정답은 환경마다 다릅니다. 다만 원칙은 있습니다. 작은 단일 노드 환경이나 랩 환경에서는 filesystem이 단순하고 빠릅니다. 반대로 운영 클라우드처럼 확장성과 장애 대응이 중요하면 Ceph 같은 분산 스토리지가 훨씬 편해집니다. Swift도 오브젝트 스토리지 특성상 장점이 있지만, 실제 운영에서는 팀의 익숙함과 기존 스택 영향을 많이 받습니다.

    백엔드 장점 주의할 점 추천 상황
    Filesystem 구성이 단순하고 빠르게 시작 가능 확장성과 이중화 설계가 직접 필요 소규모 랩, 단일 리전 테스트
    Ceph RBD 확장성과 고가용성, 운영 일관성 확보에 유리 초기 학습비용과 클러스터 운영 난이도 존재 중대형 프라이빗 클라우드
    Swift 오브젝트 스토리지 기반 운영에 적합 조직 내 운영 경험이 없으면 진입장벽이 있음 기존 Swift 활용 조직

    3. 비용을 줄이는 첫 번째 방법: 업로드 전 이미지 최적화

    이미지 최적화는 생각보다 효과가 큽니다. 사실 많은 팀이 스토리지 백엔드부터 바꾸려고 하는데, 저는 그 전에 업로드 대상 이미지부터 정리하는 쪽을 먼저 권합니다. 이유는 간단합니다. 불필요하게 큰 이미지를 아무리 좋은 스토리지에 넣어도 낭비는 그대로거든요.

    실제로 써보니까 가장 기본은 세 가지였습니다. 첫째, 정말 필요한 패키지만 넣기. 둘째, 임시 파일과 캐시 비우기. 셋째, raw가 꼭 필요한 환경이 아니라면 qcow2를 우선 검토하기. 물론 성능이나 호환성 요구사항 때문에 raw가 필요한 경우도 있습니다. 그래서 무조건 하나만 고집하면 안 되고, 목적별로 나누는 게 좋습니다.

    3-1. 업로드 전 점검 순서

    1. 이미지 내부의 로그, 패키지 캐시, 임시 파일을 정리합니다.
    2. Cloud-init(클라우드 초기화 도구) 설정이 남아 있는지 확인합니다.
    3. 필요한 디스크 포맷을 결정합니다.
    4. 이미지 속성과 용도를 메모해 둡니다.
    # 이미지 정보 확인
    qemu-img info ubuntu-base.qcow2
    
    # 필요 시 다른 포맷으로 변환
    qemu-img convert -f qcow2 -O qcow2 ubuntu-base.qcow2 ubuntu-base-optimized.qcow2
    
    # OpenStack에 업로드
    openstack image create "ubuntu-base-optimized" \
      --file ubuntu-base-optimized.qcow2 \
      --disk-format qcow2 \
      --container-format bare \
      --public

    여기서 중요한 포인트! 이미지 변환은 마법이 아닙니다. 원본 안에 불필요한 데이터가 많으면 포맷만 바꿔도 큰 차이가 없더라고요. 저도 처음엔 convert만 하면 다 해결될 줄 알았는데 아니었습니다. 결국 이미지 내부 정리가 먼저였습니다.

    4. 실전 구현: Glance 스토리지 구성 전략

    이제 실제로 어떤 식으로 구성할지 보겠습니다. 저는 보통 두 가지 시나리오로 접근합니다. 작은 환경은 filesystem 기반으로 빨리 시작하고, 운영 환경은 Ceph RBD 같은 공용 스토리지로 정리합니다. 멀티 스토어(multi-store, 여러 저장소를 함께 사용하는 방식)를 쓰는 환경이라면 용도에 따라 분리하는 것도 좋습니다.

    4-1. 단순한 filesystem 기반 예시

    [glance_store]
    stores = file
    default_store = file
    filesystem_store_datadir = /var/lib/glance/images/

    이 방식은 이해하기 쉽고 장애 포인트도 적습니다. 대신 스토리지가 커질수록 확장과 백업 구조를 직접 챙겨야 합니다. 홈랩에서는 이거 진짜 편하더라고요. 근데 운영 규모가 커지면 결국 한계가 옵니다.

    4-2. Ceph RBD 기반 예시

    [glance_store]
    stores = rbd
    default_store = rbd
    rbd_store_pool = images
    rbd_store_user = glance
    rbd_store_ceph_conf = /etc/ceph/ceph.conf

    Ceph를 이미 다른 워크로드에 쓰고 있다면, Glance 이미지를 같은 운영 체계 안에서 관리하기가 훨씬 수월합니다. 장애 대응, 용량 확장, 모니터링 흐름을 통일하기 좋거든요. 물론 Ceph 자체 운영 경험이 없다면 진입장벽은 분명 있습니다.

    Glance 스토리지 백엔드 구성 다이어그램

    filesystem과 Ceph RBD 백엔드 선택 시 데이터 흐름이 어떻게 달라지는지 보여주는 구성 예시입니다.

    4-3. 이미지 분류 정책까지 같이 가야 합니다

    스토리지만 바꿔서는 절반짜리입니다. 실제 운영에서는 이미지 네이밍 규칙과 속성 관리가 같이 들어가야 합니다.

    # 이미지 목록 확인
    openstack image list
    
    # 특정 이미지 상세 확인
    openstack image show ubuntu-base-optimized
    
    # 태그 또는 속성을 활용한 구분 예시
    openstack image set \
      --property os_distro=ubuntu \
      --property image_role=base \
      ubuntu-base-optimized
    • base: 공용 베이스 이미지
    • app: 애플리케이션 포함 이미지
    • deprecated: 신규 배포 금지, 삭제 대기 이미지
    • golden: 표준 운영 이미지

    이렇게 분류해두면 나중에 정리 작업이 훨씬 쉬워집니다. OpenStack Glance 이미지 관리는 저장소 용량보다도, 사실 이름 짓기와 분류 정책에서 승부가 많이 나더라고요.

    5. ⚠️ 운영 중 자주 겪는 문제와 트러블슈팅

    여기서는 제가 실제로 자주 부딪힌 문제를 적어보겠습니다. 화려한 기능보다 이런 부분이 운영에 더 중요하거든요.

    5-1. 업로드는 되는데 부팅이 안 되는 경우

    대부분은 이미지 포맷, 버스 타입, cloud-init 설정, 또는 운영체제 내부 드라이버 문제인 경우가 많습니다. Glance 문제가 아니라 게스트 이미지 준비 상태 문제인 경우도 많더라고요.

    • disk-format이 실제 파일 형식과 맞는지 확인합니다.
    • virtio 드라이버 지원 여부를 확인합니다.
    • 부팅 직후 네트워크가 안 붙으면 cloud-init 로그를 봅니다.

    5-2. 오래된 이미지가 안 지워지는 경우

    이건 삭제 정책이 없어서 생기는 일이 많습니다. 이미지가 실제로 인스턴스 생성에 아직 참조되는지, 운영팀이 롤백 용도로 잡아둔 것인지 확인 없이 지우면 사고 납니다. 저는 최소한 아래 기준으로 봅니다.

    1. 최근 배포 이력 확인
    2. 현재 표준 이미지 여부 확인
    3. 롤백 필요 기간 경과 여부 확인
    4. 삭제 전 백업 또는 export 수행
    # 이미지 다운로드 백업
    openstack image save --file ubuntu-base-backup.qcow2 ubuntu-base-optimized
    
    # 더 이상 쓰지 않는 이미지 삭제
    openstack image delete old-ubuntu-image

    5-3. 이미지가 너무 많아서 관리가 안 되는 경우

    이건 기술 문제이기도 하지만 프로세스 문제입니다. 생성은 누구나 쉽게 하는데 폐기는 아무도 안 하거든요. 그래서 저는 월 1회 정도는 공용 이미지 점검 시간을 따로 잡습니다. 별거 아닌데 효과가 큽니다.

    • 이미지 오너(owner) 또는 관리 책임자 지정
    • 생성일과 용도 속성 관리
    • deprecated 상태를 거친 뒤 최종 삭제
    • 업로드 승인 기준 최소화

    6. 검증: 결과는 어떻게 확인할까

    구성하고 나면 꼭 확인해야 합니다. 드디어 됐다! 하고 넘어가면 나중에 누적 비용에서 뒤통수 맞습니다. 검증은 어렵지 않습니다. 이미지 목록, 이미지 크기, 실제 백엔드 사용량, 부팅 성공 여부까지 같이 보면 됩니다.

    # 이미지 목록과 상태 확인
    openstack image list --long
    
    # 특정 이미지 상세 확인
    openstack image show ubuntu-base-optimized
    
    # 파일시스템 사용량 확인 예시
    du -sh /var/lib/glance/images
    
    # Ceph 사용량 확인 예시
    rbd du -p images

    제가 직접 해보니, 검증 단계에서 가장 많이 놓치는 건 논리적 크기와 실제 사용량의 차이였습니다. 이미지 메타데이터에 보이는 크기와 백엔드에서 실제 차지하는 용량은 다를 수 있습니다. 그래서 CLI 출력만 보지 말고 저장소 쪽 사용량도 같이 봐야 합니다.

    이미지 목록, 실제 저장소 사용량, 정리 전후 변화를 확인하는 검증 화면을 표현한 시각 자료입니다.

    6-1. 제가 보는 체크리스트

    확인 항목 왜 중요한가 확인 방법
    이미지 상태 업로드 실패 또는 비정상 상태 조기 발견 openstack image list
    실제 저장소 사용량 비용 분석의 핵심 지표 du, rbd du 등
    부팅 성공 여부 최적화 후 기능 이상 여부 확인 테스트 인스턴스 생성
    중복 이미지 비율 정리 대상 선별 이름, 태그, 생성일 비교

    🎉 결과적으로 잘 정리된 환경은 운영이 훨씬 편해집니다. 저장소가 줄어드는 것도 좋지만, 더 큰 장점은 표준 이미지가 명확해져서 배포 속도가 빨라진다는 점입니다.

    7. 비용 관점에서 추천하는 운영 습관

    검색 의도가 cost analysis라면, 결국 중요한 건 기술 선택보다 운영 습관입니다. 클라우드 스토리지 비용은 한 번에 크게 터지기보다, 조금씩 새는 식으로 커집니다. 그래서 아래 습관이 꽤 중요합니다.

    1. 공용 베이스 이미지는 최소 개수로 유지합니다.
    2. 커스텀 이미지는 목적과 만료 기준을 같이 적어둡니다.
    3. 정기 정리일을 운영 캘린더에 넣습니다.
    4. 업로드 전 이미지 최적화를 표준 절차로 만듭니다.
    5. 백엔드 사용량 보고를 월 단위로 확인합니다.

    혹시 이런 경험 있으신가요? 이미지는 지우기 무섭고, 안 지우자니 저장소가 계속 늘어나는 상황 말입니다. 저도 처음엔 그냥 큰 디스크를 더 붙이면 되겠지 했었는데, 결국 관리 체계 없이 용량만 늘리면 같은 문제가 반복되더라고요.

    이미지 최적화 전후 비교 인포그래픽

    이미지 정리 정책, 업로드 전 최적화, 백엔드 선택에 따른 운영 포인트를 비교 요약한 인포그래픽입니다.

    8. 정리와 다음 단계

    정리해보면, OpenStack Glance 이미지 관리에서 가장 중요한 건 세 가지입니다. 첫째, 이미지 업로드 전에 최대한 정리할 것. 둘째, 환경에 맞는 Glance 스토리지 백엔드를 고를 것. 셋째, 이미지 수명주기 정책을 운영 프로세스로 만들 것. 이 세 가지가 잡히면 이미지 최적화와 클라우드 스토리지 비용 관리가 같이 따라옵니다.

    다음 글에서는 Nova(노바)와 Cinder(신더) 관점에서 이미지 기반 배포와 볼륨 기반 배포를 어떻게 나눠야 하는지도 다뤄볼 예정입니다. 이전 글에서 Ceph 운영 기초를 정리해두셨다면 같이 보시면 흐름이 더 잘 잡히실 겁니다. 결국 운영은 기능보다 연결이더라고요.

    자주 묻는 질문

    • Q. 무조건 Ceph가 더 좋은가요?
      A. 아닙니다. 규모와 운영 역량에 따라 filesystem이 더 합리적인 경우도 많습니다.
    • Q. qcow2가 항상 정답인가요?
      A. 아닙니다. 호환성과 성능 요구사항에 따라 raw가 더 맞는 경우도 있습니다.
    • Q. 이미지 최적화만으로 충분한가요?
      A. 아니요. 최적화와 함께 삭제 정책, 태그 정책, 검증 절차가 같이 있어야 효과가 납니다.

    ✅ 오늘 바로 해볼 수 있는 건 어렵지 않습니다. 현재 Glance 이미지 목록을 뽑고, 공용 베이스 이미지와 오래된 커스텀 이미지를 먼저 분류해보세요. 거기서부터 스토리지 전략이 보이기 시작합니다.

  • [OpenStack] OpenStack Nova 성능 최적화: CPU 스케줄링 및 리소스 할당 분석

    [OpenStack] OpenStack Nova 성능 최적화: CPU 스케줄링 및 리소스 할당 분석

    [OpenStack] OpenStack Nova 성능 최적화: CPU 스케줄링 및 리소스 할당 분석

    OpenStack Nova 성능 최적화 이야기는 결국 운영하면서 한 번쯤 꼭 부딪히는 문제로 이어집니다. 가상 머신은 충분히 띄웠는데, 어떤 인스턴스는 반응이 빠르고 어떤 인스턴스는 같은 flavor(플레이버, 가상 머신 자원 정의)인데도 체감 성능이 들쭉날쭉하거든요. 저도 처음엔 “스토리지가 느린가?” 하고 엉뚱한 데를 먼저 봤었는데, 실제로 파고 들어가 보니 Nova CPU 스케줄링과 리소스 할당 방식이 병목의 핵심인 경우가 많았습니다. 특히 benchmark(벤치마크, 성능 측정) 결과를 비교할 때 CPU 오버커밋(overcommit, 실제 물리 자원보다 더 많이 논리 할당)과 NUMA(Non-Uniform Memory Access, 메모리 접근 거리가 다른 구조) 인식 여부가 결과를 꽤 크게 흔들더라고요.

    이번 글에서는 제가 홈랩과 테스트 환경에서 반복적으로 확인했던 관찰 포인트를 기준으로, OpenStack Nova 성능 최적화를 어디서부터 봐야 하는지 정리해보겠습니다. 숫자를 지어내거나 과장된 벤치마크를 보여드리기보다는, 무엇을 설정하고 무엇을 검증해야 재현 가능한 성능 분석이 되는지에 초점을 맞추겠습니다.

    Nova 스케줄러와 컴퓨트 노드, 하이퍼바이저, NUMA 토폴로지 관계를 한눈에 보여주는 개요 이미지입니다.

    1. 왜 OpenStack Nova 성능 최적화가 생각보다 까다로운가

    쉽게 말해 Nova는 “가상 머신을 어디에 올릴지”만 결정하는 도구가 아닙니다. CPU pinning(피닝, vCPU를 특정 pCPU에 고정), emulator thread(에뮬레이터 스레드), huge page(휴즈페이지, 큰 메모리 페이지), NUMA topology(토폴로지, 자원 배치 구조) 같은 요소가 다 엮여 있습니다. 그래서 표면적으로는 인스턴스 생성이 잘 되더라도, 실제 가상 머신 성능은 스케줄링 정책에 따라 크게 달라질 수 있습니다.

    제가 직접 해보니 가장 흔한 착각은 이겁니다. “vCPU 개수만 맞으면 성능도 비슷하겠지”라는 생각이요. 근데 현실은 그렇지 않더라고요. 같은 4 vCPU 인스턴스라도 어느 소켓(socket, CPU 패키지) 위에 배치됐는지, 이웃한 워크로드가 얼마나 시끄러운지(noisy neighbor, 자원 경쟁을 유발하는 인접 워크로드), CPU 공유 정책이 어떤지에 따라 결과가 달라집니다.

    • CPU overcommit ratio가 높으면 밀도는 올라가지만 지연 시간이 튈 수 있습니다.
    • Dedicated CPU policy를 쓰면 예측 가능성은 좋아지지만 수용량은 줄어듭니다.
    • NUMA mismatch가 나면 메모리 접근 비용이 늘어나 체감 성능이 떨어질 수 있습니다.
    • Benchmark 결과는 테스트 시간대와 이웃 인스턴스 상태에 따라서도 흔들립니다.

    2. Nova CPU 스케줄링 개념, 쉽게 말해 이런 구조입니다

    여기서 중요한 포인트! Nova CPU 스케줄링은 단순한 라운드로빈(round-robin, 순환 배치)이 아닙니다. 스케줄러는 호스트 필터(filter, 후보 선별 규칙)와 weighers(가중치 계산기)를 사용해서 컴퓨트 노드를 고릅니다. 그 다음 실제 하이퍼바이저 계층에서 vCPU와 pCPU 관계가 정해지죠.

    2-1. Shared CPU와 Dedicated CPU 차이

    구분 설명 장점 주의점
    Shared CPU 여러 VM이 물리 CPU 시간을 공유 집적도 높음 성능 편차 가능
    Dedicated CPU 특정 pCPU를 인스턴스에 고정 할당 예측 가능한 성능 운영 유연성 감소
    CPU Pinning vCPU를 지정 코어에 매핑 지터 감소 NUMA 설계 필요

    실제로 써보니까 데이터베이스나 NFV(Network Functions Virtualization, 네트워크 기능 가상화)처럼 지연 시간에 민감한 워크로드는 Shared CPU보다 Dedicated CPU 쪽이 훨씬 해석하기 편했습니다. 반대로 일반 웹 애플리케이션은 적당한 오버커밋이 더 경제적일 때가 많았고요.

    2-2. 리소스 할당에서 꼭 같이 봐야 할 요소

    • vCPU allocation ratio: 논리적으로 얼마나 더 많이 잡을지
    • RAM allocation ratio: 메모리 과할당 정책
    • Reserved host memory: 호스트 OS와 에이전트가 쓸 여유 공간
    • NUMA affinity: CPU와 메모리 지역성 유지
    • Huge pages: TLB 부담 감소에 유리

    저도 처음엔 헷갈렸는데, CPU만 최적화하면 끝이 아니더라고요. 메모리 배치가 틀어지면 CPU pinning을 해도 기대만큼 안 나오는 경우가 있습니다.

    3. 실전 기준선 만들기: benchmark 전에 먼저 해야 할 것

    OpenStack Nova 성능 최적화를 하겠다고 바로 설정부터 바꾸면 나중에 비교가 안 됩니다. 삽질 좀 했습니다 ㅎㅎ 결국 가장 먼저 해야 하는 건 기준선(baseline, 비교 기준)을 만드는 일입니다.

    1. 테스트 대상 flavor를 고정합니다.
    2. 테스트용 이미지와 커널 상태를 동일하게 맞춥니다.
    3. 동일한 시간대에 반복 실행합니다.
    4. 가능하면 noisy neighbor 영향을 줄인 별도 호스트를 씁니다.
    5. 인스턴스 내부 지표와 호스트 지표를 같이 수집합니다.

    제가 권장하는 최소 수집 항목은 아래 정도입니다.

    # Compute node
    lscpu
    numactl --hardware
    virsh vcpuinfo INSTANCE_DOMAIN
    virsh emulatorpin INSTANCE_DOMAIN
    virsh dumpxml INSTANCE_DOMAIN
    
    # Guest VM
    grep -E 'processor|physical id|core id' /proc/cpuinfo
    lscpu
    uptime
    mpstat -P ALL 1 5
    

    이 정도만 모아도 “스케줄링은 잘 됐는지”, “게스트가 기대한 토폴로지를 보고 있는지” 정도는 꽤 빨리 감이 옵니다.

    4. Nova CPU 스케줄링 설정 확인 포인트

    이제 본론입니다. Nova CPU 스케줄링과 리소스 할당을 볼 때 저는 보통 nova.conf의 CPU 정책부터 확인합니다. 환경마다 값은 다를 수 있지만, 아래와 같은 항목들이 자주 등장합니다.

    [DEFAULT]
    cpu_allocation_ratio=4.0
    ram_allocation_ratio=1.0
    reserved_host_memory_mb=4096
    
    [compute]
    cpu_shared_set=2-15
    cpu_dedicated_set=16-31
    
    [libvirt]
    virt_type=kvm
    emulator_threads_policy=share
    

    위 예시는 구조 설명용입니다. 특정 값이 정답이라는 뜻은 아닙니다. 다만 운영 의도는 분명해야 합니다. 예를 들어 cpu_shared_set와 cpu_dedicated_set를 섞어서 쓴다면, 어떤 워크로드를 공유형으로 둘지, 어떤 워크로드를 전용형으로 둘지 먼저 정해야 하거든요.

    중요한 건 설정 파일의 숫자보다 정책 일관성입니다. 한 호스트는 전용 CPU 정책, 다른 호스트는 공유 정책인데 같은 aggregate(집합, 스케줄링 그룹)로 묶여 있으면 benchmark 결과가 해석 불가능해질 수 있습니다.

    OpenStack Nova 성능 최적화 설정에서 CPU 정책과 NUMA 배치를 설명하는 이미지

    공유 CPU 세트, 전용 CPU 세트, 에뮬레이터 스레드 정책이 어떻게 나뉘는지 보여주는 설정 이미지입니다.

    5. 리소스 할당 전략: 워크로드별로 다르게 가져가야 합니다

    이 부분이 현업에서 진짜 중요합니다. 모든 인스턴스에 같은 정책을 적용하면 편하긴 한데, 성능과 밀도 둘 다 애매해지기 쉽습니다.

    5-1. 일반 웹/배치 워크로드

    • Shared CPU 기반 운영이 보통 효율적입니다.
    • 적절한 오버커밋으로 집적도를 높일 수 있습니다.
    • 대신 benchmark는 피크 시간과 비피크 시간을 나눠 봐야 합니다.

    5-2. DB, 메시지 큐, 지연 민감 서비스

    • Dedicated CPU 또는 CPU pinning 검토가 필요합니다.
    • NUMA 정렬과 huge page를 함께 보는 편이 좋습니다.
    • 가상 머신 성능 비교 시 평균값보다 tail latency(꼬리 지연)를 더 중시해야 합니다.

    5-3. 혼합 클러스터 운영 팁

    제 경험상 host aggregate(호스트 애그리게이트)와 flavor extra spec(플레이버 추가 속성)을 같이 쓰는 방식이 운영 설명력이 좋았습니다. 예를 들면 성능형 호스트 풀과 일반형 호스트 풀을 나누고, 성능형 flavor만 전용 CPU 정책으로 보내는 식이죠.

    openstack flavor set perf.large \
      --property hw:cpu_policy=dedicated \
      --property hw:mem_page_size=large
    
    openstack flavor set general.medium \
      --property hw:cpu_policy=shared
    

    이렇게 해두면 나중에 문제 생겼을 때 추적이 쉬워집니다. “왜 이 인스턴스는 빠르지?” 혹은 “왜 이건 느리지?”를 설명할 근거가 남거든요.

    6. ⚠️ 실제로 자주 겪는 트러블슈팅

    여기서는 제가 실제로 많이 부딪혔던 문제 위주로 적어보겠습니다. 문서만 보면 단순해 보이는데, 현장에서는 꼭 꼬입니다.

    6-1. Pinning은 했는데 성능이 기대보다 안 나오는 경우

    가장 먼저 NUMA 배치를 의심해보세요. vCPU는 한 소켓 쪽에 몰렸는데 메모리는 다른 NUMA 노드에서 잡히면 메모리 접근이 꼬일 수 있습니다. 이럴 때는 인스턴스 XML과 호스트 NUMA 정보를 같이 확인해야 합니다.

    virsh dumpxml INSTANCE_DOMAIN | grep -i -E 'numa|vcpu|cputune|emulatorpin'
    numactl --hardware
    

    6-2. 동일한 벤치마크인데 결과 편차가 큰 경우

    이건 noisy neighbor 가능성이 큽니다. 특히 공유형 CPU 정책에서는 배치 타이밍에 따라 차이가 꽤 납니다. 저도 처음엔 테스트 툴 문제인 줄 알았는데, 같은 호스트에 다른 VM이 CPU burst를 치고 있었더라고요.

    6-3. 호스트는 여유 있는데 스케줄링이 실패하는 경우

    Placement(플레이스먼트, 자원 추적 및 배치 서비스) 관점에서 자원 클래스(resource class, 자원 분류)나 trait(특성)이 안 맞는 경우가 있습니다. 숫자상 여유와 스케줄링 가능 여부는 다를 수 있습니다. 그래서 단순히 top만 보는 식으로는 원인 파악이 안 됩니다.

    6-4. 에뮬레이터 스레드가 의외의 병목이 되는 경우

    이거 놓치기 쉽습니다. 전용 CPU만 신경 쓰다가 emulator thread가 같은 코어에 얹혀서 변동성이 생기기도 하거든요. 성능 민감 워크로드라면 이 부분도 꼭 확인해보세요.

    OpenStack Nova 성능 최적화 트러블슈팅과 벤치마크 편차 분석 이미지

    vCPU pinning, NUMA 노드, noisy neighbor 분석 지표를 함께 보는 트러블슈팅 예시 이미지입니다.

    7. 검증은 이렇게 합니다: 가상 머신 성능 확인 절차

    설정 바꾸고 느낌상 빨라진 것 같다고 끝내면 안 됩니다. 검증 절차를 남겨야 다음 변경 때도 비교가 되거든요. 저는 보통 아래 순서로 봅니다.

    1. 호스트 토폴로지 확인
    2. 인스턴스 배치 정책 확인
    3. 게스트 내부 CPU 인식 상태 확인
    4. 동일 조건으로 benchmark 반복 실행
    5. 평균값보다 편차와 최저 구간을 함께 비교
    # Example benchmark flow inside guest
    stress-ng --cpu 4 --timeout 60s --metrics-brief
    sysbench cpu --threads=4 run
    

    여기서 조심할 점은, 특정 툴의 점수 자체보다 반복 실행 시 일관성입니다. OpenStack Nova 성능 최적화가 잘 된 환경은 최고점만 높은 게 아니라, 여러 번 돌려도 편차가 상대적으로 줄어드는 경우가 많았습니다.

    검증 항목 좋은 신호 경계 신호
    CPU 사용률 분포 예상 코어에 집중 임의 분산, 잦은 변동
    Benchmark 반복성 결과 편차 작음 실행마다 차이 큼
    NUMA 정렬 CPU/메모리 지역성 유지 원격 메모리 접근 증가
    호스트 안정성 예약 자원 충분 호스트 자체가 바쁨

    드디어 됐다! 싶었던 순간도 사실 이런 표를 정리한 뒤에야 왔습니다. 그냥 체감이 아니라, 왜 결과가 좋아졌는지 설명이 되어야 다음 운영 변경에도 자신이 생기더라고요.

    OpenStack Nova 성능 최적화 전후 가상 머신 성능 비교 대시보드 이미지

    반복 벤치마크 결과의 편차 감소와 CPU 배치 안정성을 비교하는 결과 시각화 이미지입니다.

    8. 정리와 다음 단계: 무엇부터 손대면 좋을까

    정리해보면 OpenStack Nova 성능 최적화는 결국 세 가지입니다. 정책을 분리하고, 배치를 검증하고, 결과를 반복 측정하는 것이죠. Nova CPU 스케줄링은 단순 옵션 튜닝이 아니라, 워크로드 성격에 맞는 리소스 할당 전략을 설계하는 일에 가깝습니다.

    • 일반 워크로드는 공유 정책과 적절한 오버커밋으로 효율을 봅니다.
    • 민감한 워크로드는 전용 CPU, NUMA 정렬, 메모리 정책을 같이 봅니다.
    • 가상 머신 성능 평가는 평균 점수보다 재현성과 편차를 함께 봐야 합니다.
    • 벤치마크는 반드시 배치 정보와 같이 기록해야 의미가 있습니다.

    혹시 이런 경험 있으신가요? 분명 스펙은 같은데 어떤 VM만 유독 느린 상황이요. 그런 경우라면 애플리케이션을 의심하기 전에 CPU 정책과 배치 상태부터 보시는 걸 추천드립니다. 생각보다 거기서 답이 나오는 경우가 많거든요.

    다음 글에서는 Placement와 flavor extra spec을 조금 더 깊게 들어가서, 스케줄링 의도를 어떻게 코드처럼 관리할지 다뤄볼 예정입니다. 이전 글에서 다뤘던 가상화 호스트 기본 점검 내용과 함께 보시면 흐름이 더 잘 잡히실 겁니다.

    OpenStack Nova 성능 최적화 운영 체크리스트와 CPU 정책 요약 이미지

    공유 CPU와 전용 CPU 선택 기준, NUMA 체크포인트, 검증 절차를 요약한 인포그래픽 이미지입니다.

    자주 묻는 질문

    Q1. CPU overcommit을 무조건 낮추면 성능이 좋아지나요?

    항상 그렇진 않습니다. 집적도가 너무 낮아져 운영 효율이 떨어질 수 있고, 워크로드 특성상 공유 정책으로도 충분한 경우가 있습니다.

    Q2. Nova CPU 스케줄링만 조정하면 끝인가요?

    아닙니다. libvirt 설정, NUMA 구조, 메모리 정책, 게스트 OS 튜닝까지 함께 봐야 합니다.

    Q3. benchmark 결과가 매번 다르면 무엇부터 확인해야 하나요?

    테스트 시간대, noisy neighbor, 배치 호스트, NUMA 정렬, 에뮬레이터 스레드 정책 순으로 점검해보시면 됩니다.

  • [OpenStack] OpenStack Keystone 인증 시스템, 1년 운영 후기 및 보안 강화 팁

    [OpenStack] OpenStack Keystone 인증 시스템, 1년 운영 후기 및 보안 강화 팁

    [OpenStack] OpenStack Keystone 운영 후기와 보안 강화 팁

    OpenStack Keystone 운영 후기 이야기를 해보려고 합니다. 클라우드를 처음 올릴 때는 Nova(노바, 컴퓨트), Neutron(뉴트론, 네트워크), Cinder(신더, 블록 스토리지) 쪽이 더 눈에 잘 들어오는데요. 실제로 1년 정도 굴려보면 장애의 시작점이 생각보다 Keystone(키스톤, 인증 및 권한 관리 서비스)인 경우가 꽤 많습니다. 로그인은 되는데 토큰이 안 맞는다든지, 서비스 계정 권한이 꼬인다든지, 외부에 노출된 엔드포인트(endpoint, 서비스 접속 지점) 관리가 애매해진다든지요. 저도 처음엔 이게 뭔가 싶었는데, 막상 운영해보니 Keystone은 단순한 로그인 서버가 아니라 OpenStack 전체의 신뢰 기준점이더라고요.

    특히 홈랩과 사내 테스트 환경을 같이 운영하면서 느낀 건, Keystone 보안과 인증 시스템 관리가 느슨하면 나머지 서비스도 같이 흔들린다는 점이었습니다. 이번 글에서는 제가 직접 겪은 OpenStack Keystone 운영 후기와 함께, 실제로 효과 있었던 OpenStack 보안 강화 팁을 정리해보겠습니다.

    OpenStack Keystone 운영 후기를 설명하는 전체 인증 아키텍처 다이어그램

    Keystone이 사용자, 프로젝트, 역할, 토큰, 각 OpenStack 서비스 사이에서 어떻게 동작하는지 보여주는 전체 구조 예시입니다.

    1. 왜 Keystone이 운영에서 그렇게 중요할까요?

    쉽게 말해 Keystone은 누가, 어디까지, 어떤 방식으로 접근할 수 있는지를 판단하는 관문입니다. 사용자는 인증(authentication, 본인 확인)을 받고, 그 다음 권한 부여(authorization, 접근 허용 범위 결정)를 통해 프로젝트(project, 테넌트 성격의 작업 공간)와 역할(role, 권한 묶음)에 맞는 작업만 하게 됩니다.

    문제는 여기서 한 번 꼬이면 영향 범위가 넓다는 겁니다. 예를 들어:

    • 대시보드 Horizon(호라이즌) 로그인 실패
    • CLI에서 토큰 발급 실패
    • Nova나 Glance 같은 서비스 간 인증 실패
    • 내부 서비스 계정 비밀번호 만료 또는 잘못된 role 할당
    • 엔드포인트 URL 혼선으로 internal/public 트래픽 분리 실패

    제가 실제로 써보니까, 컴퓨트 노드 한 대 죽는 것보다 Keystone 설정 하나 잘못 들어간 게 복구 피로도가 더 높을 때도 있었습니다. 왜냐하면 장애가 여러 서비스에 퍼져 보이거든요. 겉으로는 Nova 오류처럼 보여도 원인은 Keystone 토큰 검증 실패인 경우가 있었습니다.

    2. Keystone 핵심 개념, 쉽게 말해 이렇게 이해하면 됩니다

    처음 접하시면 용어가 좀 많습니다. 저도 처음엔 헷갈렸는데, 아래처럼 묶어서 이해하니까 훨씬 편하더라고요.

    개념 영문 쉽게 말한 뜻
    사용자 User OpenStack에 로그인하거나 API를 호출하는 주체
    프로젝트 Project 리소스를 묶는 작업 공간
    도메인 Domain 사용자와 프로젝트를 더 큰 범위로 구분하는 단위
    역할 Role 허용된 권한 세트
    토큰 Token 인증 후 발급되는 일시적 접근 증표
    엔드포인트 Endpoint 서비스 API가 열려 있는 주소
    카탈로그 Service Catalog 사용 가능한 서비스 목록과 접속 정보

    여기서 중요한 포인트가 있습니다. Keystone 보안은 단순히 비밀번호를 복잡하게 만드는 수준이 아닙니다. 토큰 수명, 키 회전(rotation), 서비스 계정 분리, TLS(전송 구간 암호화), 로그 감사(audit)까지 같이 봐야 합니다.

    토큰 방식은 왜 신경 써야 할까요?

    운영하면서 체감이 컸던 부분이 토큰입니다. 예전에는 UUID 토큰 이야기도 많이 나왔지만, 실제 운영에선 Fernet(퍼넷, 대칭키 기반의 서명된 토큰 포맷) 쪽이 관리 포인트를 줄이는 데 도움이 됐습니다. DB 조회 부담이 줄고, 토큰 검증 구조가 단순해지는 장점이 있거든요. 다만 그 대신 Fernet 키 관리를 제대로 해야 합니다. 키를 안 돌리면 보안상 찜찜하고, 반대로 무작정 돌리면 토큰 검증 이슈가 생길 수 있습니다.

    3. 제가 1년 운영하면서 정착한 기본 구성

    제 기준의 안정적인 기본 원칙은 아래였습니다.

    1. 관리용 admin 접근과 일반 사용자 접근을 논리적으로 분리합니다.
    2. TLS(전송 계층 보안)는 반드시 앞단 프록시나 로드밸런서에서라도 적용합니다.
    3. 서비스 계정(service account)은 사람 계정과 섞지 않습니다.
    4. 권한은 최소 권한(least privilege)으로 시작합니다.
    5. Fernet 키 회전 주기와 시간 동기화(NTP/Chrony)를 같이 관리합니다.
    6. 관리 네트워크와 외부 노출 네트워크를 분리합니다.

    말은 쉬운데, 실제 운영에선 이걸 꾸준히 지키는 게 어렵습니다. 특히 테스트 환경에서 급하게 계정 하나 더 만들고, role 하나 더 붙이고, endpoint를 임시로 public에 노출해두면 나중에 꼭 빚처럼 돌아오더라고요. 삽질 좀 했습니다 ㅎㅎ

    4. 실전 구현: Keystone 기본 설정과 보안 초기값

    아래 예시는 배포판이나 패키지 구성에 따라 경로가 조금 다를 수 있지만, 큰 흐름은 비슷합니다. 핵심은 Fernet 초기화, 부트스트랩, 서비스 확인입니다.

    4-1. Fernet 키 초기화

    keystone-manage fernet_setup --keystone-user keystone --keystone-group keystone
    keystone-manage credential_setup --keystone-user keystone --keystone-group keystone

    이 단계는 토큰과 자격 증명 암호화의 기반이 됩니다. 여기서 파일 권한이 어긋나면 나중에 토큰 검증에서 조용히 말썽을 부리기도 합니다. 저는 한 번 소유권이 꼬여서 Apache(아파치, 웹 서버) 프로세스는 살아 있는데 Keystone 응답만 이상하게 나오는 상황을 겪었습니다.

    4-2. bootstrap 실행

    keystone-manage bootstrap \
      --bootstrap-password 'CHANGE_ME_STRONG_PASSWORD' \
      --bootstrap-admin-url https://keystone.example.internal:5000/v3/ \
      --bootstrap-internal-url https://keystone.example.internal:5000/v3/ \
      --bootstrap-public-url https://keystone.example.com:5000/v3/ \
      --bootstrap-region-id RegionOne

    여기서 public/internal URL을 어떻게 나눌지 미리 정해두는 게 정말 중요합니다. 처음엔 대충 같은 주소 넣어도 되지 않나 싶었는데, 운영 환경이 커지면 인증 시스템 관리가 바로 복잡해집니다. 외부 접속용, 내부 서비스 통신용, 운영자 점검용을 구분해두면 나중에 정책 적용이 쉬워집니다.

    Keystone 보안과 인증 시스템 관리에 필요한 엔드포인트 분리 구성 다이어그램

    public, internal, admin 성격의 접근 경로를 나누고 Fernet 키와 서비스 계정을 관리하는 설정 흐름 예시입니다.

    4-3. 기본 환경 변수 설정

    export OS_AUTH_URL=https://keystone.example.com:5000/v3
    export OS_USERNAME=admin
    export OS_PASSWORD='CHANGE_ME_STRONG_PASSWORD'
    export OS_PROJECT_NAME=admin
    export OS_USER_DOMAIN_NAME=Default
    export OS_PROJECT_DOMAIN_NAME=Default
    export OS_IDENTITY_API_VERSION=3

    운영 중에는 shell history(셸 기록)에 민감 정보가 남지 않도록 조심하셔야 합니다. 저는 실제로 테스트 서버에서 급하게 붙어 작업하다가 환경 변수 관리가 느슨해진 적이 있었는데요. 이후에는 별도 openrc 파일 권한 제한과 비밀값 주입 방식 통일로 정리했습니다.
    4-4. 프로젝트, 사용자, 역할 생성

    openstack project create --domain default --description "Service Project" service
    openstack project create --domain default --description "Operations Project" ops
    openstack user create --domain default --password 'STRONG_SERVICE_PASSWORD' glance
    openstack role create reader
    openstack role add --project service --user glance admin

    여기서 흔히 하는 실수가 사람 계정과 서비스 계정을 같은 패턴으로 관리하는 겁니다. 저는 초반에 편하다고 운영자 계정 하나로 이것저것 테스트했었는데, 나중에 로그를 보면 누가 무슨 작업을 했는지 흐려집니다. 사람은 사람 계정, 서비스는 서비스 계정. 이 원칙이 감사(audit) 대응에도 좋았습니다.

    4-5. 설정 파일에서 꼭 보는 항목

    [token]
    provider = fernet
    
    [cache]
    enabled = true
    
    [security_compliance]
    lockout_failure_attempts = 5
    lockout_duration = 1800
    unique_last_password_count = 5
    password_expires_days = 90

    배포판과 릴리스에 따라 지원 항목 차이가 있을 수 있으니, 실제 적용 전에는 사용 중인 문서를 꼭 확인하셔야 합니다. 다만 운영 원칙은 분명합니다. 토큰 방식 명확화, 캐시 전략 점검, 로그인 실패 잠금, 비밀번호 정책은 반드시 챙기셔야 합니다.
    5. Keystone 보안, 실제로 효과 있었던 강화 팁

    이 섹션은 정말 체감 위주입니다. 스펙 표보다 운영 안정성에 더 직접적인 것들만 추렸습니다.

    5-1. TLS 적용은 선택이 아니었습니다

    내부망이라 괜찮겠지 싶을 수 있는데, 실제로는 내부망이 제일 오래 방치됩니다. 프록시 계층에서라도 TLS를 적용하고, 인증서 갱신 주기를 운영 절차에 넣는 게 좋습니다. 특히 Horizon과 Keystone이 같이 얽혀 있을 때 mixed content나 redirect 문제도 정리되더라고요.

    5-2. Fernet 키 회전 자동화

    keystone-manage fernet_rotate

    이 명령 자체는 단순합니다. 문제는 언제, 어떤 순서로, 몇 개의 키를 유지할지입니다. 제가 운영하면서 얻은 교훈은, 키 회전은 cron만 걸어두고 끝낼 일이 아니라는 점이었습니다. 여러 컨트롤러 노드가 있다면 키 동기화 순서와 배포 타이밍을 같이 관리해야 합니다.
    5-3. 시간 동기화는 사소해 보여도 필수입니다

    토큰이 유효한데도 간헐적으로 인증이 튀는 경우가 있었습니다. 처음엔 Keystone 자체 문제인 줄 알았는데, 알고 보니 노드 간 시간이 조금씩 어긋나 있었어요. 이거 진짜 흔합니다. chrony(크로니, 시간 동기화 도구)나 NTP 상태를 같이 점검하세요.

    5-4. 서비스 카탈로그와 엔드포인트 정리

    OpenStack 보안을 이야기할 때 의외로 자주 놓치는 게 endpoint 정리입니다. 안 쓰는 public endpoint를 남겨두면 관리 부담이 생기고, 내부 서비스가 public URL을 타기 시작하면 네트워크 정책도 꼬입니다.

    openstack endpoint list
    openstack service list

    분기마다 한 번씩이라도 정리해보세요. 저는 운영 6개월 차쯤부터 정기 점검 항목으로 넣었습니다.

    5-5. Application Credential 적극 활용

    자동화 스크립트나 CI에서 사람 계정 비밀번호를 직접 쓰는 건 피하시는 게 좋습니다. 가능하면 Application Credential(애플리케이션 자격 증명) 같은 방식을 고려해 분리하세요. 스크립트 유출 범위를 줄이는 데 도움이 됩니다.

    6. ⚠️ 운영 중 실제로 겪었던 문제와 해결 방법

    여기서부터는 OpenStack Keystone 운영 후기다운 내용입니다. 책에는 짧게 나오는데, 현장에서는 꽤 귀찮은 문제들입니다.

    6-1. 토큰이 가끔만 실패하는 문제

    증상: 어떤 요청은 되고, 어떤 요청은 401이 나옵니다.

    원인: 시간 동기화 불일치, 캐시 반영 지연, 다중 노드 환경에서 키 동기화 문제.

    해결:

    1. 컨트롤러 노드 시간 차이 확인
    2. Fernet 키 디렉터리 소유권과 동기화 상태 확인
    3. 웹 서버 재로드 전후 캐시 반영 점검

    처음엔 네트워크 문제로 의심했는데, 결국 시계가 문제였던 적이 있었습니다. 정말 허탈하더라고요.

    6-2. Horizon 로그인은 되는데 일부 메뉴가 비정상인 문제

    증상: 로그인은 되는데 프로젝트 리소스가 안 보이거나 API 호출이 실패합니다.

    원인: role 할당 누락, project scope 설정 문제, endpoint 카탈로그 불일치.

    해결:

    openstack token issue
    openstack role assignment list --user admin --names
    openstack catalog list

    이 세 개를 같이 보면 방향이 잡히는 경우가 많았습니다. 특히 토큰 발급은 되는데 scope가 예상과 다르면, 사용자 입장에서는 그냥 고장처럼 보이거든요.

    6-3. 서비스 계정 비밀번호 변경 후 연쇄 장애

    Glance, Nova, Neutron 같은 서비스 설정 파일에 들어간 자격 증명을 한쪽만 바꾸면 바로 연쇄적으로 인증 실패가 납니다. 이건 진짜 조심하셔야 합니다. 제가 한 번 maintenance window(점검 시간) 없이 낮에 바꿨다가 로그 쫓아다니느라 고생했습니다.

    팁: 비밀번호 변경은 다음 순서를 추천합니다.

    1. Keystone에서 사용자 비밀번호 변경
    2. 각 서비스 설정 파일 동시 반영
    3. 서비스 재시작 또는 재로드
    4. 토큰 발급과 서비스 API 호출 검증

    7. 검증: 운영 상태는 이렇게 확인했습니다

    설정을 바꿨으면 반드시 검증해야 합니다. 저는 아래 체크리스트를 반복적으로 썼습니다.

    1. 관리자 토큰 발급이 되는지 확인
    2. 일반 사용자 계정도 동일하게 인증되는지 확인
    3. 서비스 계정으로 API 인증이 되는지 확인
    4. public/internal endpoint가 의도대로 동작하는지 확인
    5. 로그에 경고나 반복 실패가 없는지 확인
    openstack token issue
    openstack endpoint list
    openstack catalog list
    openstack user list
    journalctl -u apache2 -n 100 --no-pager

    배포판에 따라 웹 서버 서비스명이 `httpd`일 수도 있습니다. 중요한 건 CLI 성공 여부와 서버 로그를 같이 보는 겁니다. 둘 중 하나만 보면 놓치는 게 생깁니다.

    OpenStack Keystone 운영 후기의 검증 단계에서 사용하는 토큰 발급 및 카탈로그 확인 이미지

    토큰 발급, 서비스 카탈로그, 엔드포인트 점검 결과를 한눈에 확인하는 운영 검증 예시입니다.

    1년 정도 운영하고 나니 확실히 느낀 점이 있습니다. Keystone은 화려한 서비스는 아니지만, 안정적으로 굴러가면 전체 OpenStack이 훨씬 단정해집니다. 반대로 인증 시스템 관리가 흐트러지면 장애 분석 시간도 길어지고, 보안 리스크도 조용히 쌓입니다.

    8. Fernet, 계정 관리, 엔드포인트 운영 기준 정리

    항목 권장 운영 방식 이유
    토큰 Fernet 사용, 키 회전 자동화 검증 구조 단순화와 보안성 확보
    계정 사람/서비스 계정 분리 감사 추적과 사고 범위 축소
    권한 최소 권한 부여 오남용 방지
    엔드포인트 public/internal 역할 분리 네트워크 정책 단순화
    시간 모든 노드 동기화 토큰 오류 예방
    전송 보안 TLS 적용 자격 증명 노출 방지

    9. 마무리: Keystone은 결국 운영 습관 싸움입니다

    정리해보면, OpenStack Keystone 운영 후기에서 가장 크게 남은 건 기술보다 습관이었습니다. 처음엔 설정만 맞으면 끝이라고 생각했는데, 실제로는 키 회전, 시간 동기화, 계정 분리, 엔드포인트 정리, 로그 확인을 꾸준히 반복해야 하더라고요. 드디어 됐다 싶어도 몇 달 지나면 또 운영 기준이 흐트러집니다. 그래서 체크리스트와 주기 작업이 중요합니다.

    혹시 지금 Keystone을 막 구축하셨거나, 이미 돌아가는 환경인데 어딘가 불안하신가요? 그럴 땐 거창한 개편보다 아래 5가지만 먼저 점검해보세요.

    • Fernet 키 회전이 되고 있는가
    • 시간 동기화가 정확한가
    • 서비스 계정과 사람 계정이 분리되어 있는가
    • 안 쓰는 public endpoint가 남아 있지 않은가
    • 토큰 발급 검증을 정기적으로 하고 있는가

    이 다섯 가지만 잡아도 체감이 꽤 큽니다. 다음 글에서는 Horizon과 Keystone 연동 시 세션/쿠키 문제, 또는 OpenStack 보안 관점에서 서비스 계정 순환(rotation) 자동화를 다뤄볼 예정입니다. 이전 글에서 다룬 네트워크 분리와 reverse proxy 구성이 있다면 같이 참고하시면 흐름이 더 잘 잡히실 겁니다.

    Fernet 키 회전, 최소 권한, TLS, 시간 동기화, 엔드포인트 정리를 요약한 운영 체크리스트입니다.

    자주 묻는 질문

    Keystone만 안정적이면 나머지 OpenStack 서비스도 괜찮을까요?

    완전히 그렇진 않지만, 최소한 인증 관련 장애 분석 범위를 크게 줄일 수 있습니다. 운영 체감상 출발점이 훨씬 깔끔해집니다.

    OpenStack 보안에서 가장 먼저 손댈 부분은 뭔가요?

    제가 직접 해보니 TLS, 계정 분리, Fernet 키 회전, 시간 동기화 이 네 가지가 우선순위가 높았습니다.

    인증 시스템 관리는 얼마나 자주 점검하면 좋을까요?

    주간 점검으로 토큰 발급과 로그 확인, 월간 점검으로 endpoint/role/서비스 계정 상태를 보는 식이 현실적이었습니다.

  • [인프라] OpenStack Ironic으로 베어메탈 서버 자동 프로비저닝 실전 사례

    [인프라] OpenStack Ironic으로 베어메탈 서버 자동 프로비저닝 실전 사례

    [인프라] OpenStack Ironic으로 베어메탈 서버 자동 프로비저닝 실전 사례

    OpenStack Ironic 베어메탈 프로비저닝을 처음 제대로 붙잡았던 이유는 단순했습니다. 가상머신은 너무 익숙했는데, 정작 성능이 중요한 워크로드는 결국 물리 서버에 올려야 했거든요. 문제는 여기서부터였습니다. 서버를 한 대씩 BIOS 확인하고, PXE 부팅 잡고, 운영체제 이미지 밀어 넣고, 네트워크 맞추고, 다시 검증하는 과정을 반복하다 보니 사람이 할 일이 너무 많아지더라고요. 특히 서버가 3대, 5대, 10대로 늘어나면 그때부터는 실수도 같이 늘어납니다. 그래서 저는 OpenStack Ironic(아이로닉, 베어메탈 프로비저닝 서비스)을 도입해서 베어메탈 자동화 흐름을 만들었고, 실제로 운영 편의성이 얼마나 달라지는지 체감했습니다.

    혹시 이런 경험 있으신가요? 분명 같은 모델 서버인데도 한 대는 잘 올라오고, 한 대는 PXE에서 멈추고, 또 다른 한 대는 디스크 클리닝(cleaning) 단계에서 실패하는 상황이요. 저도 처음엔 이게 뭔가 싶었는데, 흐름을 한 번 제대로 잡고 나니까 서버 프로비저닝이 훨씬 예측 가능해졌습니다. 이번 글에서는 제가 직접 해보면서 정리한 OpenStack Ironic 베어메탈 프로비저닝 실전 사례를 기준으로, 개념부터 실제 등록과 배포, 그리고 삽질 포인트까지 차근차근 풀어보겠습니다.

    OpenStack Ironic, PXE 네트워크, 이미지 서비스, 관리 네트워크, 물리 서버 간의 전체 흐름을 한눈에 보여주는 아키텍처 예시입니다.

    1. 왜 베어메탈 자동화가 필요했는가

    제가 처음 자동화를 검토했던 환경은 대규모 클라우드까지는 아니고, 홈랩과 소규모 사내 테스트 랙(rack, 서버 장비 거치대)이 섞인 형태였습니다. 쿠버네티스 워커 노드, 스토리지 노드, 네트워크 기능 테스트 장비가 계속 늘어나는데, 설치 방법은 여전히 수동이었죠. 이러면 반복 작업이 많아질 뿐 아니라, 누가 언제 어떤 이미지로 설치했는지 추적도 어려워집니다.

    • 반복 작업 제거: 동일 OS 이미지와 네트워크 정책을 여러 서버에 일관되게 적용
    • 실수 감소: 수동 설치 중 IP, RAID, 부트 모드 입력 오류 감소
    • 재현성 확보: 장애 후 재배포(re-deploy) 시간이 짧아짐
    • 운영 표준화: 서버 모델이 달라도 등록 절차를 표준 흐름으로 묶기 쉬움

    여기서 중요한 포인트가 있습니다. 베어메탈 자동화는 단순히 설치를 편하게 하는 수준이 아니라, 물리 서버를 가상 리소스처럼 다루기 시작하는 첫 단계라는 점입니다. 실제로 써보니까 운영 관점이 바뀌더라고요. 서버를 장비가 아니라 풀(pool, 자원 집합)로 보게 됩니다.

    2. OpenStack Ironic 개념을 쉽게 풀어보면

    쉽게 말해 Ironic은 물리 서버를 API로 관리해 주는 서비스입니다. 가상머신을 Nova(노바, 컴퓨트 서비스)로 다루듯이, 베어메탈 서버는 Ironic으로 전원 제어, 부팅 제어, 이미지 배포, 상태 전환을 처리합니다.

    처음엔 용어가 좀 낯설 수 있습니다. 저도 처음엔 conductor가 뭐고 inspector가 뭐고 헷갈렸거든요. 실무에서는 아래 정도만 먼저 잡아도 흐름이 보입니다.

    구성 요소 역할 현장에서 이해한 방식
    Ironic API 베어메탈 요청 접수 사용자나 자동화 도구가 호출하는 입구
    Ironic Conductor 실제 작업 실행 전원 제어, 배포, 상태 변경을 수행하는 엔진
    PXE / iPXE 네트워크 부팅 로컬 디스크 없이 초기 부팅을 유도하는 통로
    IPA Ironic Python Agent 부팅 후 디스크 작업과 배포를 수행하는 에이전트
    BMC Baseboard Management Controller IPMI나 Redfish로 원격 전원/부트 제어
    Glance 이미지 저장소 배포할 운영체제 이미지를 보관하는 위치

    Ironic 베어메탈 프로비저닝 활용 사례로는 쿠버네티스 노드 자동 공급, Ceph(세프, 분산 스토리지) 스토리지 노드 배포, 테스트 장비 재설치 자동화가 대표적입니다. 특히 성능 오버헤드가 민감한 데이터 처리 워크로드에서는 가상화보다 베어메탈이 낫다고 판단하는 경우가 꽤 있죠.

    3. 실전 사례: OpenStack Ironic 베어메탈 프로비저닝 구성 방식

    이번 사례는 특정 벤더 기능에 기대지 않는, 비교적 범용적인 구성입니다. 관리 네트워크(management network)와 프로비저닝 네트워크(provisioning network)를 분리하고, BMC는 Redfish(레드피시, 표준 하드웨어 관리 API) 또는 IPMI 기반으로 접근했습니다. 디스크는 로컬 SSD를 사용했고, 운영체제 이미지는 일반적인 리눅스 클라우드 이미지 계열을 기준으로 배포했습니다.

    1. 서버 랙 장착 및 BMC IP 할당
    2. Ironic에 노드 등록
    3. 포트(MAC 주소) 연결
    4. 하드웨어 introspection(인트로스펙션, 자동 탐지) 또는 수동 속성 입력
    5. deploy image 연결
    6. manageable → available 상태 전환
    7. 베어메탈 서버 deploy 실행 및 부팅 검증

    이 흐름을 한 번 만들어 두면 신규 서버 반입 때 정말 편합니다. 예전에는 체크리스트를 사람이 읽으면서 따라갔는데, 이제는 등록 정보만 맞으면 나머지는 훨씬 기계적으로 흘러갑니다. 드디어 됐다 싶었던 순간이 여기였네요.

    4. OpenStack Ironic 베어메탈 프로비저닝 구현 단계

    4-1. 네트워크와 부트 방식 먼저 정리

    여기서 가장 많이 꼬입니다. Ironic 자체보다 PXE 네트워크가 더 큰 함정일 때가 많거든요. DHCP 범위, TFTP 또는 HTTP 부트 경로, UEFI/Legacy BIOS 모드가 서로 안 맞으면 배포가 시작도 안 됩니다. 저는 가능하면 UEFI 기준으로 통일하려고 했고, 스위치 포트 VLAN도 먼저 점검했습니다.

    openstack network list
    openstack subnet list
    openstack baremetal driver list
    openstack baremetal node list

    처음엔 단순히 노드만 등록하면 될 줄 알았는데, 실제로는 부팅 경로와 네트워크 경로가 먼저 안정화되어야 하더라고요. 특히 ToR(Top of Rack, 랙 상단 스위치) 쪽 포트 프로파일이 꼬여 있으면 증상이 굉장히 애매합니다.

    OpenStack Ironic 베어메탈 프로비저닝 PXE 부팅 흐름 이미지

    프로비저닝 VLAN, DHCP, HTTP/TFTP 부트, Ironic Conductor, 대상 서버 사이의 실제 데이터 흐름을 설명하는 이미지입니다.

    4-2. 노드 등록과 BMC 정보 입력

    다음은 물리 서버를 Ironic에 등록하는 단계입니다. 아래 예시는 개념을 보여주기 위한 형태이고, 환경에 맞게 driver와 driver-info 항목은 조정하시면 됩니다.

    openstack baremetal node create \
      --driver redfish \
      --name bm-node-01
    openstack baremetal node set bm-node-01 \
      --driver-info redfish_address=https://192.0.2.10/redfish/v1/Systems/1 \
      --driver-info redfish_username=admin \
      --driver-info redfish_password='REDACTED' \
      --property cpus=16 \
      --property memory_mb=65536 \
      --property local_gb=480 \
      --resource-class baremetal-general

    여기서 팁 하나요. 저는 초반에 서버 스펙을 전부 수동 입력했었는데, 장비가 늘어나면 이게 은근히 실수를 부릅니다. introspection을 쓸 수 있는 환경이라면 자동 탐지를 적극 활용하는 편이 낫습니다. 다만 자동 탐지 결과도 100% 맹신하면 안 되고, 디스크 수나 NIC 매핑은 꼭 눈으로 한 번 보셔야 합니다.

    4-3. 포트 연결과 배포 이미지 지정

    openstack baremetal port create aa:bb:cc:dd:ee:ff \
      --node bm-node-01
    openstack baremetal node set bm-node-01 \
      --instance-info image_source=<IMAGE_UUID> \
      --instance-info root_gb=50

    이미지 소스는 보통 Glance 이미지 UUID를 사용합니다. 저 같은 경우에는 운영체제 이미지 템플릿을 최소화해서 관리했는데, 이게 나중에 패치 기준점 맞추기가 편하더라고요. 이미지가 너무 많으면 자동화가 아니라 이미지 스파게티가 됩니다.

    4-4. 상태 전환과 배포 실행

    openstack baremetal node manage bm-node-01
    openstack baremetal node provide bm-node-01
    openstack baremetal node deploy bm-node-01

    Ironic은 상태(state)가 중요합니다. manageable, available, active 같은 상태 전환을 이해하지 못하면 왜 명령이 거부되는지 감이 안 옵니다. 저도 처음엔 deploy가 왜 안 되나 한참 봤는데, 앞단 상태가 안 맞았던 적이 꽤 많았습니다. 이 부분은 로그와 상태를 같이 보면서 익숙해지는 수밖에 없어요.

    5. OpenStack Ironic 베어메탈 프로비저닝: 운영 기준과 설정 예시

    실전에서는 단순 명령 몇 줄보다 운영 기준이 더 중요합니다. 어떤 노드를 어떤 용도로 쓸지, cleaning(클리닝, 디스크 초기화) 정책을 어디까지 강제할지, RAID 구성은 수동으로 둘지 자동으로 둘지 같은 정책이 먼저 있어야 자동화가 깔끔해집니다.

    nodes:
      - name: bm-node-01
        driver: redfish
        resource_class: baremetal-general
        boot_mode: uefi
        bmc:
          address: https://192.0.2.10/redfish/v1/Systems/1
          username: admin
        network:
          provisioning_mac: aa:bb:cc:dd:ee:ff
        deploy:
          image: ubuntu-base
          root_gb: 50

    저는 내부적으로 노드 인벤토리를 YAML 형태로 관리해 두고, 이후 등록 자동화 스크립트에서 읽어 쓰는 방식으로 정리했습니다. 이게 생각보다 큽니다. 사람이 콘솔에서 매번 입력하면 언젠가 오타가 나거든요.

    • 리소스 클래스(resource class)를 미리 정의해 워크로드 분류를 단순화
    • 부트 모드 통일로 장애 포인트 감소
    • 이미지 수 최소화로 운영 복잡도 감소
    • 인벤토리 코드화로 반복 등록 절차 표준화
    OpenStack Ironic 노드 등록과 상태 전환 운영 화면 이미지

    노드 이름, 드라이버, BMC 정보, 포트, 상태 전환 흐름이 한 번에 보이도록 구성한 운영 화면 예시입니다.

    6. ⚠️ 실제로 겪었던 문제와 해결 방법

    이 섹션이 아마 제일 현실적일 겁니다. 문서만 보면 다 잘 될 것 같은데, 실제 현장에서는 작은 불일치가 줄줄이 터집니다. 삽질 좀 했습니다 ㅎㅎ

    6-1. PXE는 되는데 베어메탈 배포가 중간에 멈추는 문제

    증상은 간단했습니다. 서버가 네트워크 부팅까지는 들어오는데, 에이전트가 올라온 뒤 이미지 배포 단계에서 멈추는 겁니다. 처음엔 이미지 문제인 줄 알았는데, 실제 원인은 프로비저닝 네트워크의 MTU와 업링크 설정 차이였습니다. 패킷 손실이 눈에 띄게 보이지 않아서 더 헷갈렸습니다.

    • 에이전트가 올라오는지 확인
    • Conductor 로그에서 타임아웃 여부 확인
    • 프로비저닝 VLAN 경로 MTU 점검
    • 이미지 다운로드 경로의 HTTP 접근성 확인

    6-2. BMC 연결은 되는데 전원 제어가 불안정한 문제

    이건 장비별 구현 차이 영향이 컸습니다. 같은 표준을 써도 Redfish 구현이 미묘하게 다르더라고요. 그래서 저는 가능하면 펌웨어 상태를 먼저 맞추고, 드라이버 타입을 혼용하지 않도록 정리했습니다. 환경에 따라 IPMI보다 Redfish가 더 안정적일 때도 있었고, 반대 경우도 있었습니다. 결국 중요한 건 표준 이름보다 내 장비에서 실제로 일관되게 동작하느냐였습니다.

    6-3. 디스크 선택이 꼬여 OS가 원하지 않는 장치에 설치되는 문제

    NVMe와 SATA SSD가 같이 있는 서버에서 이 문제가 나왔습니다. 에이전트가 잡는 장치 순서와 사람이 기대한 순서가 다를 수 있거든요. 그래서 배포 정책에서 디스크 선택 기준을 명확히 정하고, 가능하면 장치 특성 기반으로 선택하도록 운영 기준을 잡았습니다. 여기서 중요한 포인트! 베어메탈 자동화는 결국 하드웨어 다양성을 어떻게 통제하느냐의 싸움입니다.

    7. 검증과 결과: 서버 프로비저닝이 얼마나 달라졌나

    배포 후에는 단순히 active 상태만 보면 안 됩니다. 저는 최소한 아래 항목은 꼭 확인했습니다.

    1. Ironic 상태가 active로 전환되었는지 확인
    2. 운영체제가 정상 부팅되고 SSH 접근이 되는지 확인
    3. 의도한 NIC와 IP 정책이 적용되었는지 확인
    4. 디스크 레이아웃과 파일시스템이 기대값과 맞는지 확인
    5. 재배포 시 동일 절차가 반복 가능했는지 확인
    openstack baremetal node show bm-node-01
    openstack baremetal node validate bm-node-01

    실제로 써보니까 가장 큰 변화는 속도보다도 예측 가능성이었습니다. 예전에는 “이번에도 잘 되겠지”에 가까웠다면, 자동화 이후에는 “어디가 실패하면 무엇을 보면 된다”로 바뀌었습니다. 운영자는 이 차이를 굉장히 크게 느낍니다. 장애 대응 시간도 줄고, 신규 서버 투입 부담도 확실히 낮아졌습니다.

    OpenStack Ironic 베어메탈 프로비저닝 결과 검증 대시보드 이미지

    active 상태 전환, 배포 성공, 네트워크 연결, 운영체제 부팅 검증 결과를 시각적으로 요약한 이미지입니다.

    8. 정리: OpenStack Ironic 도입 전에 꼭 체크할 것

    OpenStack Ironic 베어메탈 프로비저닝은 분명 강력합니다. 하지만 설치 툴 하나 추가하는 수준으로 보면 실망할 수 있습니다. 이건 물리 서버 운영 체계를 재정리하는 일에 가깝거든요. 제가 직접 해보니 아래 네 가지가 성공 확률을 많이 좌우했습니다.

    • 네트워크 표준화: 프로비저닝 경로와 VLAN 정책을 먼저 안정화할 것
    • 하드웨어 편차 관리: 서버 모델, NIC, 디스크 구성을 가능한 한 단순화할 것
    • 상태 기반 운영: node state와 로그를 함께 보는 습관을 들일 것
    • 인벤토리 자동화: 등록 정보를 코드처럼 관리할 것
    도입 전 방식 Ironic 도입 후 방식
    서버별 수동 설치 API 기반 반복 배포
    작업자 숙련도 의존 절차 표준화
    문제 원인 추적 어려움 상태와 로그 기반 추적
    재설치 시간 편차 큼 재현성 높은 서버 프로비저닝

    혹시 지금 물리 서버를 계속 수동으로 설치하고 계시다면, 작은 랩 환경에서라도 먼저 시도해 보시는 걸 권합니다. 처음엔 헷갈립니다. 저도 그랬습니다. 근데 한 번 흐름을 이해하고 나면 이거 진짜 편하더라고요. 다음 글에서는 Ironic과 Inspector(인스펙터, 하드웨어 자동 탐지)를 엮어서 장비 등록을 더 줄이는 방향도 다뤄볼 예정입니다. 이전 글에서 다뤘던 PXE 네트워크 설계와 함께 보시면 훨씬 연결이 잘 되실 겁니다.

    OpenStack Ironic 도입 전후 비교 요약 인포그래픽

    수동 설치와 자동화된 베어메탈 프로비저닝의 차이, 그리고 도입 전 체크리스트를 한 장으로 정리한 요약 이미지입니다.

    9. 자주 묻는 질문

    Q1. Ironic은 꼭 OpenStack 전체를 다 써야 하나요?

    반드시 그렇지는 않습니다. 다만 실제 운영에서는 네트워크, 이미지, 인증 체계와의 연동이 중요해서 보통은 OpenStack 구성 요소와 함께 보는 편이 자연스럽습니다.

    Q2. 베어메탈 자동화가 작은 환경에도 의미가 있나요?

    의미 있습니다. 특히 재설치가 잦거나, 쿠버네티스 노드를 자주 교체하는 환경이라면 규모가 작아도 체감이 큽니다.

    Q3. Ironic 베어메탈 프로비저닝 활용 사례에서 가장 먼저 검증할 것은 뭔가요?

    저는 네트워크 부팅 경로와 BMC 안정성을 먼저 봅니다. 이 두 가지가 흔들리면 나머지 자동화가 전부 불안정해지거든요.

  • [스토리지] OpenStack Swift vs Ceph 선택 기준 심층 비교

    [스토리지] OpenStack Swift vs Ceph 선택 기준 심층 비교

    [스토리지] OpenStack Swift vs Ceph 선택 기준 심층 비교

    대규모 객체 스토리지(Object Storage) 이야기를 하다 보면 결국 많이 나오는 조합이 있습니다. 바로 OpenStack Swift Ceph 비교죠. 저도 처음엔 둘 다 그냥 “오브젝트 스토리지니까 비슷한 거 아닌가?” 싶었는데, 실제로 설계하고 운영해보니 성격이 꽤 다르더라고요. 특히 객체 스토리지 솔루션을 새로 도입하려는 팀, 혹은 프라이빗 클라우드(private cloud)를 운영하는 팀이라면 여기서 방향을 잘못 잡으면 나중에 운영 복잡도가 확 올라갑니다.

    제가 13년 정도 인프라 쪽에서 일하면서 느낀 건, 스토리지는 벤더 브로셔보다 운영팀의 현실이 더 중요하다는 점입니다. 성능 숫자 몇 개보다도, 장애 났을 때 복구 흐름이 명확한지, 팀이 감당할 수 있는 아키텍처인지, 기존 클라우드 스택과 얼마나 잘 붙는지가 훨씬 중요했거든요. 이번 글에서는 OpenStack Swift와 Ceph를 기능 나열식이 아니라, 실제 선택 기준 중심으로 풀어보겠습니다.

    OpenStack Swift Ceph 비교 전체 아키텍처 다이어그램

    Swift의 프록시 기반 구조와 Ceph의 클러스터형 구조를 한눈에 보여주는 비교 이미지입니다.

    1. 왜 OpenStack Swift vs Ceph 비교가 계속 나올까요?

    쉽게 말해 둘 다 분산 스토리지(Distributed Storage)이고, 둘 다 대규모 확장을 염두에 둔 설계거든요. 근데 접근 방식이 다릅니다. Swift는 오브젝트 스토리지에 좀 더 집중된 구조이고, Ceph는 오브젝트(Object), 블록(Block), 파일(File)을 함께 다룰 수 있는 범용 분산 스토리지에 가깝습니다.

    현장에서 이 차이가 바로 드러나는 순간이 있어요. 예를 들어 개발팀은 S3 호환 API만 있으면 된다고 말하는데, 플랫폼팀은 나중에 가상머신 디스크나 Kubernetes 스토리지까지 같이 보고 싶어 합니다. 이럴 때 Swift는 “오브젝트 저장소를 깔끔하게 운영”하는 쪽으로 강점이 있고, Ceph는 “스토리지 플랫폼을 하나로 통합”하는 쪽으로 무게가 실립니다.

    • Swift: 오브젝트 스토리지 중심, OpenStack 친화적
    • Ceph: 오브젝트, 블록, 파일을 아우르는 통합형
    • 선택 포인트: 기능 수보다 운영 목적과 팀 역량이 더 중요

    혹시 이런 경험 있으신가요? 처음엔 백업 저장소로 시작했는데, 나중엔 이미지 저장, 로그 아카이브, VM 디스크, 컨테이너 볼륨까지 다 얹히는 경우요. 저도 몇 번 겪었는데, 그때 초기 선택이 발목을 잡기도 했습니다.

    2. 핵심 개념 설명: Swift와 Ceph를 쉽게 풀어보면

    2-1. OpenStack Swift란?

    OpenStack Swift는 OpenStack 생태계에서 나온 오브젝트 스토리지입니다. 데이터는 Account / Container / Object 구조로 관리되고, 프록시(proxy)와 스토리지 노드(storage node), 그리고 링(ring) 기반 데이터 배치 개념이 핵심이거든요. 저도 처음 링 파일 개념을 봤을 때는 “이걸 왜 이렇게까지 나눴지?” 싶었는데, 실제로는 대규모 노드 분산과 재배치 관점에서 꽤 실용적이더라고요.

    2-2. Ceph란?

    Ceph는 객체 스토리지로만 보면 RADOS Gateway(RGW)를 통해 S3/Swift 스타일 API를 제공할 수 있고, 내부적으로는 RADOS라는 분산 객체 계층 위에 RBD(Block Device), CephFS(File System) 같은 서비스가 올라갑니다. 핵심은 CRUSH 알고리즘 기반의 데이터 배치와, 모니터(MON), 매니저(MGR), OSD(Object Storage Daemon) 조합이거든요.

    2-3. 한 줄 차이

    제가 실무에서 멘토링할 때 자주 하는 설명이 있습니다. Swift는 목적형 오브젝트 스토리지, Ceph는 스토리지 플랫폼입니다. 이 한 줄이 생각보다 많은 걸 정리해주더라고요.

    항목 OpenStack Swift Ceph
    주 용도 객체 스토리지 중심 객체, 블록, 파일 통합
    아키텍처 성격 역할 분리형, 링 기반 클러스터형, CRUSH 기반
    OpenStack 연계 친화적 Cinder, Glance, Manila 등과 폭넓게 연동
    운영 포인트 오브젝트 워크로드 최적화 통합 스토리지 운영 복잡도 관리

    3. 클라우드 스토리지 선택 기준: 무엇을 먼저 봐야 할까요?

    클라우드 스토리지 선택에서 가장 흔한 실수가 “성능이 더 좋다더라”만 보고 결정하는 거거든요. 근데 여기서 중요한 포인트! 객체 스토리지는 단순 벤치마크보다 워크로드 특성이 훨씬 중요합니다.

    1. 워크로드 유형 확인
      백업, 로그 아카이브, 미디어 저장, VM 이미지, 컨테이너 볼륨 중 무엇이 주력인지 먼저 정리합니다.
    2. API 요구사항 확인
      S3 호환성이 중요한지, OpenStack 네이티브 연동이 중요한지 봅니다.
    3. 운영팀 역량 평가
      장애 분석, 리밸런싱(rebalancing), 확장 작업을 누가 얼마나 자주 할지 생각해야 합니다.
    4. 확장 단위 확인
      단순 용량 확장인지, 멀티 서비스 확장인지에 따라 선택이 갈립니다.
    5. 장애 도메인 설계
      랙(rack), 호스트(host), 존(zone), 리전(region) 단위 복제 전략을 어떻게 가져갈지 정해야 합니다.

    제 경험상 아래처럼 정리하면 판단이 빨라졌어요.

    • 오브젝트 저장이 핵심이고 OpenStack 친화성이 중요하다: Swift 우선 검토
    • 향후 블록/파일까지 통합할 가능성이 높다: Ceph 우선 검토
    • 운영팀이 분산 스토리지 튜닝 경험이 많지 않다: 단순한 운영 모델을 먼저 고려
    • 대규모 자동화와 장기 확장을 노린다: 배치 정책과 장애 복구 절차를 먼저 설계

    4. 실전 구현: Swift와 Ceph를 어떻게 검증해보면 좋을까요?

    여기서는 “당장 프로덕션에 올리는 설치 가이드”보다는, 비교 검증용 랩(lab) 환경을 어떻게 잡으면 좋은지 중심으로 말씀드릴게요. 홈랩에서도 축소형으로 충분히 감을 잡을 수 있습니다. 저도 처음엔 큰 장비 없이 VM 몇 대로 감을 익혔어요. 삽질 좀 했습니다 ㅎㅎ

    4-1. Swift 검증 포인트

    Swift는 프록시 노드와 스토리지 노드 역할을 나누고, 링 파일을 통해 데이터 배치를 정의합니다. 실제 검증에서는 다음을 꼭 봅니다.

    • 프록시를 통해 PUT/GET 지연이 어떻게 나오는지
    • 리플리케이션(replication) 이후 데이터 일관성 흐름
    • 노드 추가 시 링 재배포 절차 난이도
    # 예시: Swift ring-builder 기본 흐름
    swift-ring-builder account.builder create 18 3 1
    swift-ring-builder container.builder create 18 3 1
    swift-ring-builder object.builder create 18 3 1
    
    swift-ring-builder account.builder add r1z1-10.0.0.11:6202/d1 100
    swift-ring-builder container.builder add r1z1-10.0.0.11:6201/d1 100
    swift-ring-builder object.builder add r1z1-10.0.0.11:6200/d1 100
    
    swift-ring-builder account.builder rebalance
    swift-ring-builder container.builder rebalance
    swift-ring-builder object.builder rebalance

    이 명령 흐름에서 중요한 건 숫자 외우는 게 아닙니다. 파티션(partition) 수, 복제 수, 장애 도메인 배치가 운영 철학을 반영한다는 점이거든요. 실제로 써보니까 여기 설계를 대충 하면 나중에 증설할 때 정말 피곤해지더라고요.

    4-2. Ceph 검증 포인트

    Ceph는 최소한 MON, MGR, OSD 구조를 이해하고 들어가야 합니다. 오브젝트 스토리지만 보더라도 결국 내부 건강 상태는 OSD 분포와 PG(Placement Group) 균형에서 드러나거든요.

    # 예시: Ceph 상태 확인과 풀(pool) 생성 흐름
    ceph -s
    ceph osd tree
    ceph health detail
    
    radosgw-admin user create --uid=testuser --display-name="Test User"
    ceph osd pool create object-test 32
    rados ls -p object-test

    여기서 초반에 꼭 확인할 건 클러스터 헬스(cluster health)입니다. API 붙이기 전에 저장 계층이 안정적인지부터 봐야 해요. 이 순서를 거꾸로 하면 문제 원인 추적이 정말 힘들어지더라고요.

    OpenStack Swift Ceph 비교를 위한 분산 구조 구성도

    Swift의 링 기반 분산과 Ceph의 CRUSH 기반 분산 개념을 비교하는 구성도입니다.

    4-3. S3 호환성과 테스트 업로드

    실전에서는 결국 애플리케이션이 붙어야 하니 간단한 업로드 테스트를 같이 봅니다.

    # 예시: S3 API 엔드포인트 검증용 aws cli 테스트
    aws --endpoint-url http://rgw.example.local s3 mb s3://lab-bucket
    aws --endpoint-url http://rgw.example.local s3 cp sample.log s3://lab-bucket/
    aws --endpoint-url http://rgw.example.local s3 ls s3://lab-bucket/

    Swift도 미들웨어(middleware)나 호환 계층을 어떻게 둘지에 따라 접근 방식이 달라집니다. 그래서 단순 기능 체크보다 현재 애플리케이션이 어떤 API를 기대하는지 먼저 보는 게 맞습니다.

    5. Swift Ceph 성능, 숫자보다 더 중요한 운영 특성

    Swift Ceph 성능 이야기를 할 때 조심해야 할 게 있습니다. 동일한 하드웨어, 동일한 네트워크, 동일한 복제 정책이 아니면 숫자 비교 자체가 큰 의미가 없거든요. 그래서 저는 성능을 볼 때 아래처럼 나눠서 봅니다.

    • 소형 객체 처리: 메타데이터 부담, API 처리량
    • 대용량 스트림: 순차 업로드/다운로드 안정성
    • 복구 중 성능: 장애 이후 리밸런싱 시 서비스 영향
    • 확장 후 균형: 노드 추가 뒤 데이터 재배치 비용

    Swift는 오브젝트 스토리지에 맞춘 단순성과 분리가 장점으로 느껴질 때가 있습니다. 반면 Ceph는 잘 구성하면 매우 유연하지만, 그만큼 봐야 할 지표와 튜닝 포인트가 더 많아요. 저도 초반에는 Ceph가 만능처럼 보여서 무조건 좋은 줄 알았는데, 작은 팀에서는 그 유연성이 오히려 운영 부담으로 돌아오더라고요.

    비교 기준 Swift에서 볼 점 Ceph에서 볼 점
    확장성 링 재배치 운영 절차 OSD 추가 후 데이터 재균형
    장애 복구 복제/재동기화 흐름 클러스터 헬스와 백필(backfill) 영향
    운영 복잡도 역할 구분이 명확 기능이 많은 만큼 관리 포인트 증가
    API 활용 오브젝트 중심 설계 RGW 기반 S3/Swift 스타일 접근

    6. ⚠️ 실제 운영에서 자주 만나는 문제와 트러블슈팅

    여기부터가 진짜 중요합니다. 비교표는 다들 잘 만드는데, 실제 문제는 운영 중에 나오거든요.

    6-1. Swift에서 겪기 쉬운 문제

    • 링 변경 후 기대와 다른 분산
      원인: 초기 장비 가중치(weight) 설계가 부정확했거나 증설 정책이 일관되지 않은 경우가 많습니다.
    • 프록시 병목
      원인: 백엔드 디스크보다 앞단 프록시 처리량이 먼저 막히는 경우가 있습니다.
    • 운영자 이해도 편차
      원인: 링, 존, 디바이스 매핑 개념을 팀 전체가 공유하지 않으면 장애 대응 속도가 확 떨어집니다.

    6-2. Ceph에서 겪기 쉬운 문제

    • HEALTH_WARN 장기 지속
      원인: PG 불균형, OSD out/in 반복, 복구 작업 장기화 같은 문제가 숨어 있는 경우가 많습니다.
    • 기능은 많은데 운영이 복잡함
      원인: 블록, 파일, 오브젝트를 한 번에 다 열면 초반 운영 난도가 급격히 올라갑니다.
    • 성능 이슈 원인 파악 난이도
      원인: 네트워크, 디스크, PG 상태, 복제 정책 등 봐야 할 층이 많습니다.

    제가 직접 해보니 공통 해법은 비슷했어요.

    1. 처음부터 모든 기능을 열지 않습니다.
    2. 장애 도메인과 확장 정책을 문서로 먼저 고정합니다.
    3. 성능 테스트보다 복구 테스트를 먼저 합니다.
    4. 운영팀이 매일 보는 대시보드 항목을 표준화합니다.
    Swift Ceph 성능 및 복구 상태를 보여주는 운영 대시보드 이미지

    복구 중인 클러스터 상태, 용량 분포, 경고 지표를 시각화한 운영 관점 이미지입니다.

    7. 검증과 결과: 어떤 팀에 무엇이 더 맞았나

    랩과 운영 경험을 합쳐보면, 저는 보통 이렇게 정리합니다.

    • Swift가 잘 맞는 경우: 대용량 오브젝트 저장이 주력이고, OpenStack와 자연스럽게 붙여 쓰려는 경우
    • Ceph가 잘 맞는 경우: 오브젝트 외에 블록 스토리지와 파일 스토리지까지 함께 설계하려는 경우
    • 작은 팀의 현실: 기능 많음이 항상 장점은 아닙니다. 운영 가능성이 더 중요해요.

    특히 OpenStack Swift Ceph 비교에서 빠지면 안 되는 결론이 하나 있습니다. 무엇이 더 우월한가가 아니라, 우리 조직에 무엇이 덜 위험한가를 봐야 한다는 점이거든요. 이거 진짜 중요합니다.

    검증할 때는 아래 체크리스트를 남겨두면 좋습니다.

    # 공통 검증 체크 예시
    # 1. 업로드/다운로드 정상 여부
    # 2. 노드 1대 장애 시 접근 가능 여부
    # 3. 복구 중 응답 지연 변화
    # 4. 증설 후 재배치 시간과 영향도
    # 5. 모니터링 지표 수집 가능 여부

    이전 글에서 다뤘던 모니터링 스택과 연결하면 더 좋고, 다음 글에서는 Prometheus(프로메테우스)와 Grafana(그라파나) 기준으로 분산 스토리지 지표를 어떻게 봐야 하는지도 다뤄볼 만하겠네요.

    8. 정리: 대규모 객체 스토리지 선택, 이렇게 가져가시면 됩니다

    마무리해보겠습니다. 객체 스토리지 솔루션을 고를 때 Swift와 Ceph는 둘 다 훌륭한 선택지가 될 수 있습니다. 다만 성격이 다르거든요. Swift는 오브젝트 스토리지에 집중한 구조, Ceph는 더 넓은 범위를 아우르는 스토리지 플랫폼입니다.

    저도 처음엔 기능이 많은 쪽이 무조건 정답인 줄 알았는데, 실제로 운영해보니까 그렇지 않더라고요. 팀이 이해하고, 장애를 감당하고, 확장을 반복할 수 있어야 비로소 좋은 선택이 됩니다. 드디어 됐다! 싶은 순간은 설치 완료가 아니라, 장애 한 번 겪고도 팀이 침착하게 복구할 수 있을 때 오더라고요.

    • 오브젝트 중심 + OpenStack 친화성: Swift 쪽이 더 자연스러울 수 있습니다.
    • 통합형 분산 스토리지 전략: Ceph 쪽이 더 유리할 수 있습니다.
    • 성능보다 중요한 것: 운영 복잡도, 장애 복구, 증설 절차입니다.
    클라우드 스토리지 선택을 위한 OpenStack Swift Ceph 비교 인포그래픽

    워크로드, 운영 난이도, 확장성 기준으로 Swift와 Ceph를 요약 비교한 인포그래픽입니다.

    혹시 지금 프라이빗 클라우드나 백업 스토리지 때문에 고민 중이시라면, 먼저 “우리 팀이 실제로 운영 가능한 구조인가”부터 체크해보세요. 그다음에야 아키텍처가 선명해집니다. 다음 글에서는 클라우드 스토리지 선택 관점에서 S3 호환 오브젝트 스토리지 검증 항목을 더 실무적으로 정리해보겠습니다. ✅