13년차의 서버실

서버, 인프라, 홈랩 기술 블로그

[태그:] 개인정보 보호

  • [보안] 스마트 보안 카메라 해킹 사례 분석과 홈 네트워크 방어

    [보안] 스마트 보안 카메라 해킹 사례 분석과 홈 네트워크 방어

    [보안] 스마트 보안 카메라 해킹 사례 분석과 홈 네트워크 방어

    스마트 보안 카메라 해킹 이야기가 뉴스에 한 번 나오고 끝나는 문제라고 생각하시면 조금 위험합니다. 집 안을 지키려고 달아둔 장비가 오히려 사생활 노출 창구가 될 수 있거든요. 저도 홈랩에서 카메라, NAS, AP를 한 네트워크에 대충 붙여 쓰던 시절이 있었는데, 나중에 포트 스캔 한 번 돌려보고 식은땀이 나더라고요. “이게 밖에서 보이면 끝인데?” 싶었습니다. 그래서 오늘은 실존 확인된 대표 사례를 바탕으로, 스마트 보안 카메라 해킹이 어떻게 벌어졌고, 우리가 집에서 바로 적용할 수 있는 IoT 보안과 홈 네트워크 보안 원칙이 뭔지 정리해보겠습니다.
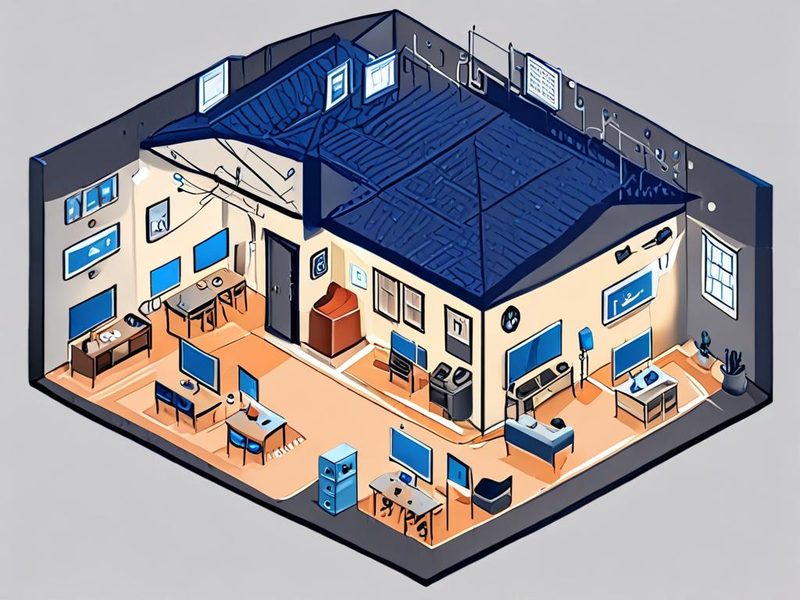
    스마트 보안 카메라 해킹 방지를 위한 홈 네트워크 보안 분리 아키텍처

    카메라를 메인 PC망과 분리한 홈 네트워크 보안 구조 예시입니다.

    1. 왜 스마트 보안 카메라 해킹이 계속 반복될까요?

    쉽게 말해 이유는 비슷합니다. 기본 비밀번호(Default Password, 출고 계정 정보), 인터넷 직접 노출(Internet Exposure, 장비가 외부에 그대로 보이는 상태), 펌웨어 업데이트 부족(Firmware Update Gap, 보안 패치 누락), 그리고 과도한 권한(Over-privileged Access, 필요 이상 관리자 권한)이 반복해서 문제를 만듭니다.

    현장에서 보면 진짜 별거 아닌 실수로 시작되는 경우가 많아요. 카메라 앱 원격 접속이 편해서 포트를 열어두고, 계정은 가족이 기억하기 쉬운 걸로 맞추고, 펌웨어 알림은 나중에 보자 하고 미루는 식이죠. 그런데 공격자는 바로 이런 지점을 노립니다. 보안 카메라 취약점은 고급 해킹 기술만의 문제가 아니라, 운영 습관의 문제이기도 합니다.

    2. 실존 사례로 보는 보안 카메라 취약점

    사례를 보면 패턴이 더 잘 보입니다. 제가 교육할 때도 추상적인 원칙보다 사건을 먼저 보여드리면 이해가 훨씬 빠르더라고요.

    사례 확인된 핵심 문제 우리에게 주는 교훈
    TRENDnet FTC 사건(2014) 사생활 영상이 인터넷에서 노출될 수 있는 소프트웨어 보안 실패 “보안” 마케팅 문구보다 실제 설정과 업데이트가 중요
    Mirai botnet 관련 사건(2016) 기본 계정 정보와 인터넷 노출된 카메라/DVR 악용 기본 비밀번호 변경은 선택이 아니라 필수
    Ring FTC 사건(2023 발표) 계정 보호 미흡, 권한 통제 부족, MFA 지연 카메라 자체보다 계정 보안이 먼저 무너지기도 함
    Verkada 보안 사고(2021) 공격자가 일부 고객의 영상/이미지 데이터에 접근 지원 권한과 관리 권한도 최소화해야 함

    2-1. TRENDnet 사건: “보안 카메라”가 공개 스트리밍이 된 사례

    미국 FTC는 2014년에 TRENDnet 사건을 공개하면서, 이 회사의 카메라가 소비자 사생활을 노출할 수 있었다고 밝혔습니다. FTC 설명을 보면 일부 카메라는 인터넷 주소만 알면 영상, 경우에 따라 오디오까지 노출될 수 있었다고 하죠. 여기서 중요한 포인트! 장비가 집 안에 있다고 안전한 게 아닙니다. 관리 인터페이스나 영상 접근 경로가 외부에 노출되면 위치는 의미가 없어집니다.

    2-2. Mirai: 카메라가 공격자의 좀비 장비가 된 사건

    2016년 Mirai botnet(미라이 봇넷)은 인터넷에 노출된 IoT 장비를 대규모로 감염시켰고, 미국 법무부와 FBI/IC3 자료에서도 카메라와 DVR이 주요 대상이었다고 확인됩니다. 핵심은 화려하지 않았어요. 기본 사용자명/비밀번호, 그리고 Telnet 같은 불필요한 관리 포트였습니다. 저도 예전에 중고 장비 테스트하다가 기본 계정으로 그냥 들어가지는 걸 보고, “이건 설치하는 순간 사고 후보구나” 싶었었습니다.

    2-3. Ring: 계정 보호 실패가 카메라 해킹으로 이어진 사례

    FTC는 2023년 Ring 사건에서 직원과 계약자의 과도한 영상 접근, 그리고 credential stuffing(크리덴셜 스터핑, 유출 계정 재사용 공격)과 brute force(무차별 대입) 대응 미흡을 문제 삼았습니다. 결과적으로 일부 사용자는 저장 영상, 라이브 스트림, 프로필 정보가 노출됐고, 약 5만5천 명의 미국 고객 계정이 영향받았다고 FTC가 적시했습니다. 이 사건은 카메라 보안 = 계정 보안 + 권한 통제라는 사실을 아주 강하게 보여줍니다.

    2-4. Verkada: 관리 편의성과 데이터 접근 통제가 충돌한 사례

    Verkada는 2021년 보안 업데이트 공지에서 공격자가 95개 고객의 영상 보안 및 이미지 데이터에 접근했다고 밝혔습니다. 이후 고객이 기술 지원 권한을 더 직접 통제하는 도구를 내놓았죠. 제가 인프라 일을 하면서 계속 느끼는 건데, 운영 편의성을 위해 넣어둔 예외 권한이 나중에 사고 반경을 키우는 경우가 많아요. 카메라도 똑같습니다.

    3. 홈 네트워크 보안 관점에서 핵심 개념 정리

    이제 개념을 아주 실무적으로 정리해보겠습니다.

    • Segmentation(세그멘테이션, 망 분리): 카메라를 PC, NAS, 스마트폰 메인망과 분리하는 거예요.
    • Least Privilege(최소 권한): 카메라 앱, 사용자, 관리자, 외부 지원 계정에 꼭 필요한 권한만 주는 원칙입니다.
    • MFA(Multi-Factor Authentication, 다중 인증): 계정 탈취 이후 피해 확산을 줄이는 가장 현실적인 장치입니다.
    • Patch Management(패치 관리): 펌웨어와 앱 업데이트를 미루지 않는 운영 습관입니다.
    • Privacy by Design(설계 단계 개인정보 보호): 애초에 카메라를 어디에 둘지, 마이크를 켤지, 클라우드 저장을 쓸지부터 보수적으로 정하는 거죠.

    혹시 이런 경험 있으신가요? 카메라를 설치할 때는 화질, 야간 촬영, 알림 속도만 보게 되고, 정작 개인정보 보호 설정은 나중으로 미루게 되거든요. 근데 사고는 대개 그 “나중”에서 납니다.

    4. 제가 홈랩에서 적용하는 방어 구조

    여기부터는 바로 따라 하기 좋은 형태로 적어보겠습니다. 특정 브랜드 종속 설정이 아니라, 원칙 중심의 예시입니다.

    1. 카메라 전용 VLAN 또는 별도 SSID를 만듭니다.
    2. 카메라 대역에서 인터넷은 꼭 필요한 목적지로만 허용합니다.
    3. 카메라에서 메인 LAN으로의 접근은 기본 차단합니다.
    4. 원격 접속은 포트포워딩 대신 VPN(Virtual Private Network, 가상사설망)으로 바꿉니다.
    5. 벤더 계정에는 MFA를 켭니다.
    6. 월 1회 펌웨어와 접근 로그를 확인합니다.

    4-1. 내 집에 어떤 카메라가 붙어 있는지 먼저 확인

    # 살아있는 장비 확인
    nmap -sn 192.168.10.0/24
    
    # 특정 카메라의 열려 있는 포트와 서비스 확인
    nmap -sV -Pn 192.168.10.23
    
    # 로컬 ARP 테이블로 제조사 힌트 확인
    ip neigh

    처음엔 이게 뭔가 싶었는데, 한 번 돌려보면 생각보다 많은 장비가 보입니다. 카메라 앱만 믿고 있으면 실제 노출 포트를 놓치기 쉽거든요.

    카메라 탐지와 VLAN 분리를 함께 설명하는 홈랩 구성 예시입니다.

    4-2. 카메라망에서 메인망으로 못 넘어오게 차단

    # 예시: nftables로 카메라 VLAN(192.168.30.0/24) 격리
    sudo nft add table inet filter
    sudo nft 'add chain inet filter forward { type filter hook forward priority 0; policy drop; }'
    
    # 카메라망에서 인터넷 DNS/HTTPS만 허용
    sudo nft add rule inet filter forward ip saddr 192.168.30.0/24 udp dport 53 accept
    sudo nft add rule inet filter forward ip saddr 192.168.30.0/24 tcp dport 53 accept
    sudo nft add rule inet filter forward ip saddr 192.168.30.0/24 tcp dport 443 accept
    
    # 카메라망에서 메인 LAN 접근 차단
    sudo nft add rule inet filter forward ip saddr 192.168.30.0/24 ip daddr 192.168.1.0/24 drop

    실제로 써보니까 포인트는 단순해요. 허용할 것만 열고 나머지는 닫는다. 이게 제일 덜 후회합니다.

    4-3. 포트포워딩 대신 VPN으로 바꾸기

    # 라우터/서버에서 외부 공개 포트 확인
    sudo ss -tulpn
    
    # UPnP로 열렸을 수 있는 매핑은 라우터에서 점검 후 비활성화 권장
    # 원격 접속은 WireGuard/OpenVPN 같은 VPN을 통해 내부망으로 들어온 뒤 사용

    NSA와 FBI/CISA 계열 가이드를 봐도 반복되는 메시지가 있어요. 원격 관리 인터페이스를 인터넷에 직접 노출하지 말 것. 이건 가정집에도 그대로 적용됩니다.

    4-4. 운영 체크리스트를 자동화

    camera_security_check:
      firmware_update: monthly
      mfa_enabled: true
      upnp_disabled: true
      remote_admin_exposed: false
      default_password_changed: true
      camera_vlan_isolated: true
      log_review: monthly

    이런 식으로 체크리스트를 문서화해두면 좋아요. 사람 기억은 생각보다 믿을 게 못 되더라고요. 저도 한동안 “나중에 해야지” 하다가 놓친 적이 꽤 있었습니다.

    5. ⚠️ 제가 자주 본 실수와 트러블슈팅

    • 기본 비밀번호를 안 바꿈: 가장 흔하고, 가장 빨리 털립니다. Mirai 사례가 딱 그랬죠.
    • 클라우드 계정 MFA 미사용: Ring 사례처럼 계정이 먼저 뚫릴 수 있습니다.
    • 카메라를 메인 NAS/PC망과 같은 대역에 둠: 침해 후 옆으로 번질 가능성이 커집니다.
    • UPnP를 켜둠: 본인도 모르게 외부 포트가 열리는 경우가 있습니다.
    • 오래된 장비를 계속 씀: 업데이트가 끊긴 카메라는 운영 리스크가 커요.

    제가 홈랩에서 제일 크게 삽질했던 건, 카메라 영상 저장 편의성 때문에 NAS와 같은 망에 둔 거였습니다. 초반엔 편해요. 진짜 편하더라고요. 근데 보안 점검 관점에서는 최악에 가까워요. 영상 보관소와 촬영 장비를 한 번에 묶어버리니까요.

    문제가 생겼을 때는 아래 순서로 보시면 됩니다.

    1. 외부 공개 포트부터 확인합니다.
    2. 기본 계정 정보와 계정 재사용 여부를 점검합니다.
    3. 카메라 펌웨어 버전과 지원 종료 여부를 확인합니다.
    4. 카메라가 어느 VLAN/SSID에 붙어 있는지 확인합니다.
    5. 로그인 이력, 알림 메일, 벤더 보안 공지를 다시 봅니다.

    6. 검증: 방어가 제대로 됐는지 이렇게 확인합니다

    설정만 하고 끝내면 안 돼요. 검증이 중요합니다.

    # 카메라 IP로 직접 접근 가능한 서비스 재확인
    nmap -sV -Pn 192.168.30.23
    
    # 카메라망 트래픽 샘플 확인
    sudo tcpdump -ni any host 192.168.30.23
    
    # 외부망에서 내부 카메라 관리 페이지가 보이지 않는지 재점검
    # 이 단계는 VPN 접속 경로와 분리해서 테스트

    정상이라면 이런 상태가 나와야 합니다.

    • ✅ 외부에서 카메라 관리 페이지가 직접 열리지 않습니다.
    • ✅ 카메라망에서 메인 PC/NAS 대역으로 접근이 안 됩니다.
    • ✅ 계정에 MFA가 적용돼 있습니다.
    • ✅ 펌웨어 업데이트 주기가 문서화돼 있습니다.
    • ✅ 로그 또는 앱 알림으로 이상 로그인 탐지가 가능합니다.
    스마트 보안 카메라 해킹 방어 설정 검증 결과 시각화

    설정 적용 후 허용된 통신만 남는 검증 결과를 시각화한 예시입니다.

    7. 자주 묻는 질문: 개인정보 보호까지 생각하면 어디까지 해야 할까요?

    Q1. 집 안 카메라는 실내용보다 실외용이 더 위험한가요?

    기술적으로는 둘 다 위험할 수 있어요. 다만 실내용 카메라는 침실, 아이 방, 거실처럼 개인정보 보호 민감도가 훨씬 높습니다. 그래서 저는 실내용은 특히 보수적으로 접근해요. 마이크가 꼭 필요 없으면 끄고, 저장 기간도 짧게 가져가는 편입니다.

    Q2. 클라우드 연결형 카메라는 다 위험한가요?

    그렇게 단순하게 볼 건 아니에요. 다만 계정 보안, 벤더의 권한 통제, 보안 공지 대응 속도를 같이 봐야 합니다. TRENDnet, Ring, Verkada 사례를 보면 문제 양상이 다르지만 결국 운영 통제와 공개 범위가 핵심이었습니다.

    Q3. 오래된 카메라는 계속 써도 될까요?

    보안 업데이트가 끝났다면 교체를 진지하게 고민하시는 게 맞아요. 기능보다 유지보수 상태가 더 중요할 때가 있거든요. 사실 저도 홈랩에서 오래된 장비 아까워서 붙잡고 있었는데, 나중엔 전기료보다 리스크가 더 크게 느껴지더라고요.

    8. 마무리: 사건은 다르지만 교훈은 비슷합니다

    스마트 보안 카메라 해킹 사례를 보면 화려한 제로데이(Zero-day, 미공개 취약점)보다 기본기 부족이 더 자주 보여요. 기본 비밀번호, 과도한 권한, 인터넷 직접 노출, 늦은 패치. 결국 우리가 당장 할 일도 명확합니다. 망 분리, MFA, 포트 비공개, 정기 업데이트, 최소 권한입니다.

    오늘 글은 사례 분석 중심으로 정리했지만, 다음 글에서는 홈랩 기준으로 IoT 보안 강화를 위한 VLAN 설계와 VPN 원격 접속 구성을 더 구체적으로 다뤄보겠습니다. 이전 글에서 공유기 보안 점검 편을 보셨다면 같이 묶어서 적용해보셔도 좋고요. 여기까지 해두면 홈 네트워크 보안 수준이 체감될 정도로 올라갑니다. 드디어 됐다 싶은 순간이 오거든요.
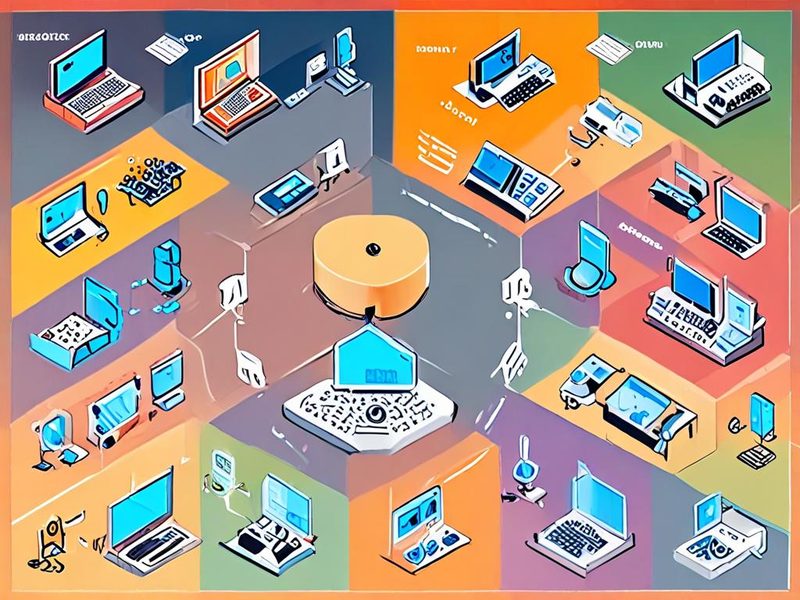
    스마트 보안 카메라 해킹 사례와 대응 원칙 요약 인포그래픽

    사례별 원인과 대응 원칙을 빠르게 복습할 수 있는 요약 인포그래픽입니다.
    9. 참고한 공개 사례와 가이드

  • [클라우드] AWS Bedrock 데이터 공유 정책 변경, 한국 기업 영향 분석

    [클라우드] AWS Bedrock 데이터 공유 정책 변경, 한국 기업 영향 분석

    [클라우드] AWS Bedrock 데이터 공유 정책 변경, 한국 기업 영향 분석

    AWS Bedrock 데이터 공유 이슈가 다시 주목받는 이유는 단순합니다. 기업 입장에서는 “우리 프롬프트(prompt, 모델에 넣는 입력)와 응답이 어디로 가는가”가 곧 리스크이기 때문입니다. 특히 클라우드 AI를 실제 업무에 붙이려는 팀이라면 더 민감하죠. 저도 처음엔 이게 뭔가 싶었는데, 실제로 PoC(Proof of Concept, 개념검증) 단계에서 보안팀이 가장 먼저 물어본 게 성능이 아니라 데이터 공유 범위였거든요.

    이번 이슈를 볼 때 중요한 건 하나입니다. 정확히는 시장 전반의 데이터 활용 정책은 계속 바뀌고 있지만, Amazon Bedrock은 공식 FAQ에서 고객 입력과 출력이 모델 제공사와 공유되지 않고, 기본 모델 학습에도 쓰이지 않는다고 명시하고 있습니다. 여기서 한국 기업이 놓칠 수 없는 포인트가 생깁니다. 단순한 기능 비교가 아니라, 개인정보 보호, 국외 이전, 감사 대응, 그리고 벤더 락인(vendor lock-in, 특정 공급자 종속)까지 같이 봐야 한다는 점입니다.

    AWS Bedrock 데이터 공유 구조와 한국 기업 거버넌스를 보여주는 아키텍처 이미지

    Amazon Bedrock에서 애플리케이션, VPC, 모델 추론, 감사 로그가 어떻게 분리되는지 보여주는 개요 다이어그램입니다.

    AWS Bedrock 데이터 공유, 쉽게 말해 뭐가 다른가

    쉽게 말해 Bedrock은 모델 마켓플레이스처럼 여러 모델을 AWS 통제면 안에서 호출하게 해주는 구조입니다. 여기서 많은 분이 헷갈리는 부분이 있어요. “Anthropic 모델을 Bedrock에서 쓰면 결국 데이터가 Anthropic으로 가는 것 아닌가요?” 저도 처음엔 그렇게 생각했었습니다. 근데 AWS 공식 문서를 보면 현재 기준으로는 사용자 입력과 모델 출력이 모델 제공사와 공유되지 않는다고 되어 있습니다.

    또 하나 중요합니다. AWS는 고객 콘텐츠가 기본 모델 개선에 사용되지 않는다고도 밝히고 있습니다. 이 문장 하나가 현업에서는 꽤 큽니다. 왜냐하면 생성형 AI 검토 문서에서 거의 반드시 들어가는 질문이 아래 3가지이기 때문이거든요.

    • 입력 데이터가 제3자에게 제공되는가
    • 입출력이 모델 재학습에 사용되는가
    • 데이터 저장 위치와 암호화 방식은 어떻게 되는가

    Bedrock은 이 세 질문에 대해 비교적 명확한 답을 주는 편입니다. 저장 데이터는 사용 중인 AWS 리전에 보관되고, 전송 중과 저장 시 암호화가 기본이며, PrivateLink(프라이빗링크, 인터넷을 거치지 않는 사설 연결)도 붙일 수 있습니다. 실무 관점에서는 정말 편하더라고요.

    AWS Bedrock 정책 변경, 어떻게 읽어야 할까

    여기서 중요한 포인트! 제목만 보면 AWS Bedrock이 데이터를 더 많이 공유하는 방향으로 정책을 바꾼 것처럼 느껴질 수 있는데, 현재 공개된 AWS 공식 FAQ만 놓고 보면 오히려 반대입니다. Bedrock 쪽은 여전히 “공유 안 함”과 “학습 안 함” 원칙을 전면에 두고 있습니다.

    그럼 왜 시장이 시끄럽냐면, 모델 사업자별 정책 차이가 커졌기 때문입니다. 예를 들어 Anthropic의 소비자용 Claude 서비스 정책은 입력과 출력이 모델 개선에 활용될 수 있고, 사용자가 설정에서 opt-out(옵트아웃, 수집 거부)해야 하는 구조가 있습니다. 반면 Anthropic도 비즈니스 오퍼링 데이터는 별도 계약이 적용된다고 설명합니다. 이 차이 때문에 기업들은 “같은 Claude라도 어디서 쓰느냐”를 따져보게 된 거죠.

    구분 Claude.ai 개인용 서비스 Amazon Bedrock
    입출력의 모델 개선 활용 정책상 활용 가능, 사용자가 opt-out 가능 기본 모델 개선에 사용되지 않음
    모델 제공사와 데이터 공유 서비스 제공사가 직접 처리 모델 제공사와 공유되지 않음
    기업 거버넌스 문서화 서비스 약관과 공급사 정책 중심 AWS 보안 통제, 리전, VPC, IAM 기반 설계 가능
    한국 기업 적합성 개별 검토 필요 보안·감사 대응 문서화가 상대적으로 쉬움

    제가 실무에서 느낀 건 이겁니다. 모델 성능만 보면 선택이 단순해 보이는데, 개인정보 보호와 감사 대응까지 들어오면 클라우드 AI 플랫폼 선택 기준이 완전히 달라집니다. 특히 한국 기업은 법무, 보안, 컴플라이언스, 인프라 팀이 같이 움직여야 하니까요.

    한국 기업에 미칠 영향: AWS Bedrock 데이터 공유가 중요한 이유

    한국 기업은 특히 세 가지에서 영향이 큽니다.

    1. 개인정보 국외 이전 검토 부담: 어떤 리전에서 추론하는지, 로그가 어디 남는지, 제3자 제공인지 위탁인지 설명이 가능해야 합니다.
    2. 내부 보안 심사 속도: Bedrock처럼 데이터 비공유 원칙이 명확하면 보안팀 질의응답이 짧아집니다.
    3. 멀티모델 전략: Anthropic, Amazon, 기타 모델을 같은 통제면에서 비교할 수 있어 벤더 전환 비용을 낮출 수 있습니다.

    특히 금융, 헬스케어, 커머스 쪽은 고객센터 요약, 상담 보조, 문서 검색형 RAG(Retrieval-Augmented Generation, 검색증강생성)를 많이 검토하시는데요. 이때 진짜 민감한 건 프롬프트보다도 원문 문서, 고객 상담 내역, 로그입니다. 모델 API 정책만 보고 안심했다가, 애플리케이션 로그에 주민번호 비슷한 값이 남는 경우를 저는 몇 번 봤습니다. 정말 삽질 좀 했습니다 ㅎㅎ

    직접 모델 서비스 사용과 Amazon Bedrock 경유 사용의 데이터 흐름 차이를 비교한 아키텍처 이미지입니다.

    실전 구현: AWS Bedrock 거버넌스 체크리스트

    말만 하면 추상적이니까, 제가 실제로 정리하는 순서대로 적어보겠습니다. PoC를 시작할 때 아래 순서로 가시면 덜 헤맵니다.

    1. 어떤 모델을 어떤 리전에서 쓸지 먼저 고정합니다

    aws bedrock list-foundation-models \
      --by-provider Anthropic \
      --region ap-northeast-2 \
      --output table

    이 명령은 현재 리전에서 어떤 모델을 쓸 수 있는지 빠르게 확인할 때 좋습니다. 여기서 모델 선택을 먼저 확정해두면, 뒤에 IAM(Identity and Access Management, 접근권한 관리)과 비용 통제를 같이 걸기 쉬워집니다.

    2. 인터넷 우회 없이 VPC 엔드포인트를 붙입니다

    aws ec2 create-vpc-endpoint \
      --vpc-id vpc-xxxxxxxx \
      --vpc-endpoint-type Interface \
      --service-name com.amazonaws.ap-northeast-2.bedrock-runtime \
      --subnet-ids subnet-aaaaaaa subnet-bbbbbbb \
      --security-group-ids sg-xxxxxxxx \
      --private-dns-enabled \
      --region ap-northeast-2

    여기서 포인트는 bedrock-runtime 엔드포인트입니다. 추론 트래픽이 인터넷을 타지 않게 설계하는 거죠. 보안팀 설명할 때 이 한 줄이 꽤 강력합니다.

    3. 엔드포인트 정책으로 호출 범위를 좁힙니다

    {
      "Version": "2012-10-17",
      "Statement": [
        {
          "Principal": "*",
          "Effect": "Allow",
          "Action": [
            "bedrock:InvokeModel",
            "bedrock:InvokeModelWithResponseStream"
          ],
          "Resource": "*"
        }
      ]
    }

    이건 AWS 문서에 나온 예시 형태입니다. 실무에서는 여기에 Principal과 Resource를 더 좁혀야 합니다. 처음엔 넓게 열고, 호출 주체가 정리되면 최소권한(minimum privilege, 필요한 만큼만 권한 부여)으로 줄이는 방식이 안전합니다.

    4. 호출 로그를 별도로 검증합니다

    aws cloudtrail lookup-events \
      --lookup-attributes AttributeKey=EventName,AttributeValue=InvokeModel \
      --max-results 20 \
      --region ap-northeast-2

    “정책상 안전하다”와 “우리 환경이 안전하게 운영된다”는 다른 이야기입니다. 실제 호출 흔적이 남는지, 어떤 역할(role)이 호출했는지 꼭 봐야 합니다.

    5. 애플리케이션 레벨 마스킹을 넣습니다

    import re
    
    def mask_pii(text: str) -> str:
        text = re.sub(r"\b\d{6}-\d{7}\b", "[RESIDENT_ID_MASKED]", text)
        text = re.sub(r"\b01[0-9]-?\d{3,4}-?\d{4}\b", "[PHONE_MASKED]", text)
        return text
    
    prompt = mask_pii(user_input)

    Bedrock이 데이터를 모델 학습에 안 쓴다고 해도, 불필요한 개인정보를 아예 넣지 않는 게 최선입니다. 이건 원칙입니다. 제가 직접 해보니 거버넌스 회의에서 제일 설득력이 있었던 것도 사실 이 부분이었어요.

    AWS Bedrock 데이터 공유 통제를 위한 PrivateLink와 IAM 설정 이미지

    PrivateLink, IAM 정책, CloudTrail 검증이 한 화면 흐름으로 연결되는 운영 구성 이미지를 넣으면 이해가 쉽습니다.

    ⚠️ 주의사항과 트러블슈팅: 여기서 많이 삽질합니다

    첫 번째 착각. Bedrock을 쓰면 모든 개인정보 이슈가 자동 해결된다고 생각하는 경우입니다. 아닙니다. Bedrock 자체 정책과 별개로, S3 원문, 애플리케이션 로그, 프롬프트 캐시, 운영자 콘솔 접근권한은 여전히 고객 책임입니다.

    두 번째 착각. 모델 호출 리전만 한국이면 끝이라고 보는 경우입니다. 실제로는 cross-region inference(교차 리전 추론)나 외부 연동 서비스가 끼면 검토 범위가 넓어질 수 있습니다. 특히 글로벌 SaaS와 붙이면 데이터 흐름도가 금방 복잡해집니다.

    세 번째 착각. Anthropic 모델이니까 곧바로 Anthropic 정책만 보면 된다고 생각하는 경우입니다. Bedrock에서는 AWS 통제면에서 서비스가 제공되는지를 같이 봐야 합니다. 같은 모델명이어도 소비자용 웹 서비스, API, Bedrock 경유 사용은 거버넌스 해석이 달라집니다.

    • ✅ 프롬프트 입력 전 PII(개인식별정보) 마스킹
    • ✅ 리전 고정 및 네트워크 경로 문서화
    • ✅ IAM 역할 분리와 CloudTrail 감사
    • ✅ RAG 문서 보존기간과 삭제 절차 정의
    • ⚠️ 운영 로그에 원문 응답 저장 여부 확인

    혹시 이런 경험 있으신가요? 모델은 잘 나오는데 보안 검토 문서 쓰다가 일정이 다 밀리는 경우요. 현업에선 진짜 흔합니다. 그래서 저는 PoC 초반부터 아키텍처 그림보다 데이터 분류표를 먼저 만듭니다.

    검증 결과: 한국 기업이 얻는 실질적인 이점

    정리하면, 현재 공개된 정책 기준에서 AWS Bedrock의 데이터 공유 원칙은 한국 기업에 꽤 유리하게 작동합니다.

    1. 법무/보안 질의에 답하기 쉽습니다: 데이터 비공유, 비학습 원칙이 비교적 분명합니다.
    2. 아키텍처 통제가 가능합니다: VPC, IAM, CloudTrail, KMS(Key Management Service, 암호키 관리) 등 기존 AWS 통제 수단을 그대로 활용할 수 있습니다.
    3. 모델 선택 유연성이 있습니다: Anthropic 같은 외부 모델을 쓰면서도 AWS 운영 표준 안에 묶을 수 있습니다.

    다만 현실적으로는 이것도 잊지 마셔야 합니다. 정책이 안전해도 구현이 느슨하면 사고는 납니다. 반대로 정책 문구가 조금 복잡해 보여도 구현을 단단히 하면 충분히 운영 가능하고요. 결국 승부는 문서 한 줄보다도 데이터 흐름 설계에서 납니다.

    AWS Bedrock 데이터 공유 검증과 개인정보 보호 점검 대시보드 이미지

    감사 로그, 리전 고정, 마스킹 적용 여부를 한눈에 보여주는 검증 대시보드 형태의 이미지를 배치하면 좋습니다.

    자주 묻는 질문: 개인정보 보호 관점에서 확인할 것

    Q1. Bedrock을 쓰면 Anthropic에 우리 데이터가 가나요?

    현재 AWS 공식 FAQ 기준으로는 사용자 입력과 모델 출력이 모델 제공사와 공유되지 않는다고 안내합니다.

    Q2. 그럼 개인정보보호 검토가 끝난 건가요?

    아닙니다. 애플리케이션 로그, 저장소, 운영자 접근권한, RAG 원문 관리까지 같이 봐야 합니다.

    Q3. 한국 기업은 어떤 팀이 먼저 움직여야 하나요?

    인프라보다 먼저 보안과 개인정보 담당자를 초반 설계에 넣는 게 좋습니다. 나중에 붙이면 거의 다시 설계하게 되더라고요.

    마무리: 이번 이슈에서 제가 보는 결론

    AWS Bedrock 데이터 공유 이슈는 단순히 “AWS가 안전하다”로 끝낼 이야기는 아닙니다. 더 정확히는, 생성형 AI 시장에서 데이터 정책이 계속 흔들리는 와중에도 Bedrock은 기업용 통제와 설명 가능성 측면에서 강한 선택지라는 쪽에 가깝습니다. 특히 한국 기업처럼 개인정보 보호, 내부 감사, 국외 이전 설명책임이 큰 환경에서는 이 차이가 꽤 큽니다.

    저라면 이렇게 접근하겠습니다. 모델 성능 비교는 두 번째로 두고, 먼저 데이터 흐름도, 리전, 로그, 마스킹, 권한모델을 고정합니다. 그 다음에 Anthropic이든 다른 모델이든 올리는 게 맞습니다. 다음 글에서는 AWS Bedrock Guardrails(가드레일, 출력 통제 장치)와 RAG 보안 설계를 같이 묶어서 다뤄보겠습니다. 이전 글에서 다뤘던 IAM 최소권한 설계와 함께 보시면 흐름이 더 잘 잡히실 겁니다. 🎉