13년차의 서버실

서버, 인프라, 홈랩 기술 블로그

[태그:] 생성형 AI

  • [AI 비교] Claude Sonnet vs GPT-4o, 실제 업무 시나리오별 선택 기준

    [AI 비교] Claude Sonnet vs GPT-4o, 실제 업무 시나리오별 선택 기준

    [AI 비교] Claude Sonnet vs GPT-4o, 실제 업무 시나리오별 선택 기준

    요즘 팀에서 Claude Sonnet과 GPT-4o 비교 이야기가 정말 자주 나오죠. 저도 홈랩에서 이것저것 붙여 보면서, 문서 요약부터 코드 리뷰, 운영 자동화 초안 작성까지 꽤 여러 흐름에 두 모델을 넣어봤습니다. 처음엔 그냥 “더 똑똑한 모델 고르면 되는 거 아닌가?” 싶었는데, 실제로 써보니까 LLM 비교는 성능 순위보다 업무 맥락이 훨씬 중요하더라고요. 같은 프롬프트라도 어떤 작업에서는 Claude Sonnet이 더 안정적으로 느껴지고, 또 어떤 작업에서는 GPT-4o가 훨씬 손에 잘 붙는 경우가 있었습니다.

    특히 AI 모델 선택을 잘못하면 자동화 파이프라인이 괜히 복잡해지거나, 사람이 다시 손봐야 하는 비율이 높아집니다. 인프라 엔지니어 관점에서는 이게 꽤 치명적이거든요. API 요금보다 더 무서운 게 운영 피로도입니다. 그래서 이번 글에서는 벤치마크 숫자놀이보다, 실제 업무 시나리오 기준으로 두 모델을 어떻게 봐야 하는지 정리해보겠습니다.

    문서 분석, 코드 작업, 운영 자동화, 멀티모달 입력 흐름을 한 장에 정리한 개요 이미지입니다.

    1. Claude Sonnet vs GPT-4o, 뭐가 다른가요?

    쉽게 말해 둘 다 범용 대형언어모델, 즉 LLM(Large Language Model, 대규모 언어 모델)이지만, 실제 사용감이 조금 다릅니다. 제가 직접 써보니 Claude Sonnet은 긴 문서를 읽고 맥락을 정리하는 쪽에서 답변의 결이 차분하고, GPT-4o는 빠르게 주고받는 인터랙션이나 이미지까지 섞인 입력에서 손에 잘 붙는 편이었습니다. 물론 이건 절대평가가 아니라 업무 자동화 관점에서의 체감입니다.

    여기서 중요한 포인트는 하나입니다. 좋은 모델을 찾는 게 아니라 내 업무에 덜 삽질하게 만드는 모델을 골라야 한다는 거죠. 저도 처음엔 헷갈렸는데, 문장 품질만 보고 고르면 나중에 파이프라인에서 꼭 한 번씩 발목을 잡더라고요.

    비교할 때 봐야 할 핵심 항목

    • 긴 문맥 유지: 정책 문서, 회의록, RFC 같은 긴 텍스트를 얼마나 안정적으로 다루는지
    • 지시 이행: 출력 포맷, 금지 조건, JSON 구조를 얼마나 잘 지키는지
    • 멀티모달: 이미지, 스크린샷, 다이어그램을 함께 넣었을 때의 작업 효율
    • 응답 속도 체감: 사람이 붙어서 쓰는 대화형 작업에서 답답하지 않은지
    • 재현성: 같은 프롬프트를 반복했을 때 결과 편차가 큰지 작은지

    2. 업무 기준으로 보면 어떤 차이가 보이나요?

    업무 항목 Claude Sonnet GPT-4o 제가 보는 포인트
    긴 문서 요약 맥락 유지가 차분한 편 빠르게 핵심을 잡는 편 정책 문서, 회의록이면 Sonnet 쪽이 편했습니다
    코드 설명/리뷰 서술이 정돈된 편 왕복 질의응답이 경쾌한 편 리뷰 코멘트 초안은 둘 다 가능, 팀 스타일이 더 중요합니다
    시각 자료 포함 분석 가능 여부보다 워크플로 설계가 중요 멀티모달 체감이 좋은 편 스크린샷 같이 보는 작업은 GPT-4o가 편하더군요
    형식 강제 출력 프롬프트 설계에 따라 안정적 도구 연동 시 편한 경우가 많음 JSON 검증기를 꼭 붙이세요
    아이디어 초안 긴 글의 구조화에 강점 체감 짧은 반복 브레인스토밍에 유리 블로그 초안은 Sonnet, 실시간 협업은 GPT-4o가 손에 잘 붙었습니다

    Anthropic Claude 계열을 고를지, GPT-4o를 고를지 고민될 때는 위 표처럼 “작업 단위”로 잘라 보시면 훨씬 결정이 쉬워집니다. 이것만 해도 불필요한 감정 소모가 많이 줄어요.

    3. 실전 구현: 감으로 고르지 말고 평가 환경부터 만드세요

    제가 추천하는 방법은 간단합니다. 모델을 바로 프로덕션에 넣지 말고, 먼저 작은 평가 하네스(harness, 반복 실험용 틀)를 만들어서 같은 입력을 양쪽에 던져보는 겁니다. 사실 이 과정이 제일 귀찮았는데요. 근데 이걸 해두면 나중에 “왜 이 모델을 골랐는지” 설명이 됩니다. 팀 설득이 쉬워져요.

    1. 업무 시나리오를 3개만 고릅니다.
    2. 각 시나리오마다 입력 샘플을 5개 정도 준비합니다.
    3. 동일 프롬프트, 동일 출력 형식을 강제합니다.
    4. 사람이 보는 평가 항목을 미리 정의합니다.
    5. 결과를 표로 남기고, 실제 실패 사례를 기록합니다.
    mkdir -p llm-eval/{inputs,prompts,outputs,scores}
    cd llm-eval
    printf '%s\n' 'temperature: 0' 'format: markdown' > settings.yaml
    scenario: incident-summary
    system: |
      You are an assistant that summarizes infrastructure incidents.
      Keep facts only. If uncertain, say "unknown".
    user_template: |
      Read the incident log below and return:
      1. Timeline
      2. Root cause
      3. Mitigation
      4. Follow-up actions
    rubric:
      - factual_consistency
      - structure
      - actionability
      - unnecessary_assumptions

    이렇게 시작하면 됩니다. 별거 아닌 것 같죠? 근데 여기서 이미 절반은 끝난 겁니다. 모델 비교에서 가장 흔한 실수가 프롬프트를 계속 바꾸는 거거든요.
    claude sonnet gpt-4o 비교를 위한 로컬 평가 하네스 구성 다이어그램

    입력 샘플, 프롬프트 템플릿, 모델 출력, 점수 파일이 어떻게 연결되는지 보여주는 이미지입니다.

    간단한 비교 스크립트 예시

    API 호출 코드는 공급자별로 바뀔 수 있어서, 여기서는 일단 결과 파일을 비교하는 로컬 스크립트로 설명드리겠습니다. 이런 방식이 오히려 오래 갑니다.

    from pathlib import Path
    import json
    
    base = Path("outputs")
    results = []
    
    for scenario_dir in base.iterdir():
        if not scenario_dir.is_dir():
            continue
        claude_file = scenario_dir / "claude_sonnet.md"
        gpt_file = scenario_dir / "gpt4o.md"
        if claude_file.exists() and gpt_file.exists():
            results.append({
                "scenario": scenario_dir.name,
                "claude_chars": len(claude_file.read_text(encoding="utf-8")),
                "gpt4o_chars": len(gpt_file.read_text(encoding="utf-8")),
            })
    
    Path("scores/summary.json").write_text(
        json.dumps(results, ensure_ascii=False, indent=2),
        encoding="utf-8"
    )
    print("summary written to scores/summary.json")

    이 스크립트 자체가 모델의 우열을 판단해주진 않습니다. 다만 반복 가능한 비교 환경을 만드는 출발점이 됩니다. 인프라 쪽도 그렇지만, 재현이 안 되면 결국 말싸움만 남더라고요.

    4. 실제 업무 시나리오별로 보면

    4-1. 긴 운영 문서 요약

    장애 보고서, 포스트모템(postmortem, 사후 분석), 보안 점검 메모처럼 긴 문서는 생각보다 까다롭습니다. 제가 실제로 써보니까 Claude Sonnet은 긴 문서에서 톤이 덜 흔들리고, 항목별로 정리해 주는 느낌이 좋았습니다. 반면 GPT-4o는 핵심을 빠르게 잡아주는 쪽이 편했어요. 회의 중간에 바로 정리해달라고 던질 때는 오히려 GPT-4o가 손이 더 자주 갔습니다.

    4-2. 코드 리뷰 초안과 자동화 스크립트

    여기서는 둘 다 충분히 실무에 들어올 수 있습니다. 다만 차이가 있다면, Claude Sonnet은 설명이 차분하게 길어지는 경우가 있고, GPT-4o는 상호작용하면서 빠르게 수정해 나가는 느낌이 있습니다. 예를 들어 Bash(배시, 셸 스크립트)나 Python(파이썬)으로 운영 스크립트 초안을 받을 때, 저는 첫 초안은 둘 다 받아보고 최종 채택은 테스트 통과율로 정합니다. 말 잘하는 모델보다, 엣지 케이스에서 덜 무너지는 모델이 낫거든요.

    4-3. 이미지나 스크린샷이 섞인 작업

    모니터링 대시보드 스크린샷, 에러 화면, 설정 UI 같은 걸 같이 보면서 설명받아야 할 때가 있죠. 이 영역은 GPT-4o가 체감상 더 편한 경우가 있었습니다. “이 버튼이 왜 비활성화됐는지” 같은 걸 빠르게 물어볼 때 특히요. 반대로 문서 중심의 차분한 정리나 긴 글 초안은 Claude Sonnet 쪽이 더 마음에 들 때가 있었습니다.

    4-4. 고객 응대 초안, 사내 공지, 운영 보고서

    이건 의외로 중요합니다. 기술적으로 맞는 말과, 사람이 읽기 편한 문장은 다르거든요. Claude Sonnet은 긴 설명문에서 문단 연결이 자연스럽다고 느낀 적이 많았고, GPT-4o는 여러 버전을 빠르게 돌려보며 어조를 다듬는 데 편했습니다. 결국 초안 품질과 수정 속도 중 어디에 더 무게를 둘지의 문제입니다.

    5. ⚠️ 주의사항: 제가 실제로 삽질한 포인트

    여기서 많이들 놓치는 게 있습니다. 모델 자체보다 비교 방식이 잘못되면 결론이 틀어집니다. 저도 처음엔 “왜 오늘은 이 모델이 별로지?” 싶었는데, 파보니까 대부분 환경 문제였어요 ㅎㅎ

    • 프롬프트가 미세하게 다름: 한쪽만 추가 설명이 들어가면 비교가 무너집니다.
    • 출력 형식 검증 없음: JSON을 기대했는데 markdown이 나오면 후처리에서 터집니다.
    • 문서 분할(chunking, 청킹) 기준이 다름: 긴 문서 비교에서는 입력 분할 전략이 결과에 큰 영향을 줍니다.
    • 사람 평가 기준이 모호함: “더 좋아 보임” 말고 체크리스트가 있어야 합니다.
    • 한 번 잘 나온 결과에 과몰입: 최소 여러 샘플로 반복해 보셔야 합니다.
    jq . outputs/incident-summary/result.json > /dev/null \
      || echo 'JSON validation failed'

    이런 식으로 형식 검증기를 붙여두면 좋습니다. 별것 아닌데, 운영 자동화에서는 이 한 줄이 진짜 사람 살립니다.

    6. 검증과 결과: 뭘 보면 “이 모델로 가자”라고 말할 수 있을까

    결과 검증은 생각보다 단순해야 합니다. 너무 많은 항목을 넣으면 결국 아무도 안 봅니다. 저는 보통 아래 네 가지를 남깁니다.

    1. 사실 보존: 없는 내용을 지어내지 않았는지
    2. 실행 가능성: 바로 복사해서 쓸 수 있는지
    3. 후편집량: 사람이 얼마나 다시 고쳐야 하는지
    4. 재현성: 비슷한 입력에서 결과가 얼마나 안정적인지
    시나리오 Claude Sonnet 경향 GPT-4o 경향 추천 선택
    장애 보고서 요약 문맥 정리가 안정적 속도감 있는 초안 정확성 우선이면 Sonnet 검토
    대시보드 스크린샷 설명 문장 정리는 무난 시각 자료 왕복이 편함 멀티모달 중심이면 GPT-4o 검토
    운영 스크립트 초안 설명형 답변이 좋음 반복 수정이 빠름 테스트 통과율로 최종 결정
    claude sonnet gpt-4o 비교 결과를 정리한 시나리오별 평가 대시보드

    각 업무 시나리오에서 어떤 기준으로 점검했고, 어느 모델이 더 적합했는지 보여주는 결과 이미지입니다.

    제 경험을 아주 짧게 정리하면 이렇습니다. 긴 문서 정리와 차분한 초안이 중요하면 Claude Sonnet을 먼저 검토했고, 빠른 상호작용과 시각 자료 포함 작업은 GPT-4o를 먼저 꺼냈습니다. 하지만 이건 어디까지나 시작점입니다. 팀 데이터와 팀 문화가 바뀌면 결론도 달라집니다.

    7. 자주 묻는 질문

    Q1. 하나만 골라야 한다면 뭘 선택하나요?

    업무가 텍스트 중심인지, 멀티모달 중심인지부터 보세요. 회의록, 운영 문서, 긴 설명문이 많다면 Claude Sonnet 쪽을 먼저 시험해 보고, 스크린샷 분석이나 빠른 협업이 많다면 GPT-4o를 먼저 넣어보는 편이 실용적입니다.

    Q2. 비용보다 먼저 볼 건 뭔가요?

    후편집 시간입니다. 사람이 다시 손보는 시간이 길어지면 비용 계산이 전부 틀어집니다. 이건 진짜 중요합니다.

    Q3. 벤치마크 점수만 보면 안 되나요?

    안 됩니다. 벤치마크는 참고용이고, 실제 업무 데이터에서의 실패 패턴이 훨씬 더 중요합니다. 인프라 운영은 예쁜 데모보다 재현 가능한 결과가 우선이거든요.
    claude sonnet gpt-4o 비교 선택 기준을 요약한 인포그래픽

    문서 중심, 코드 작업, 멀티모달, 자동화 관점에서 어떤 모델을 우선 검토할지 요약한 이미지입니다.

    8. 마무리: 정답보다 기준이 먼저입니다

    Claude Sonnet과 GPT-4o 비교를 한 줄로 끝내달라고 하면 사실 좀 곤란합니다. 왜냐하면 정답은 모델 이름이 아니라 평가 기준 안에 있기 때문입니다. 제가 직접 해보니, 모델을 바꾸는 것보다 비교 방식을 바로잡는 쪽이 훨씬 효과가 컸습니다. 처음엔 이게 뭔가 싶었는데, 평가 하네스를 만들어 두고 나니까 팀 의사결정이 훨씬 빨라졌어요. 이거 진짜 편하더라고요.

    정리하면 이렇습니다. 긴 문서와 정돈된 초안이 우선이면 Claude Sonnet을, 빠른 상호작용과 시각 자료 활용이 많다면 GPT-4o를 먼저 검토해 보세요. 그리고 어떤 쪽이든 동일 프롬프트, 동일 검증 기준, 실제 업무 샘플 이 세 가지는 꼭 지키셔야 합니다. 다음 글에서는 API 기반 자동 비교 파이프라인과 결과 저장 구조를 더 깊게 다뤄볼 예정입니다. 이전 글에서 다뤘던 로그 자동화 흐름과 같이 보시면 더 이해가 잘 되실 겁니다.
  • [AI] Gemini Advanced 활용 가이드: 구글 AI 프리미엄 기능 완벽 분석

    [AI] Gemini Advanced 활용 가이드: 구글 AI 프리미엄 기능 완벽 분석

    [LLM 활용] Gemini Advanced 활용 가이드: 구글 AI 프리미엄 기능 완벽 분석

    안녕하세요, 13년차 서버실 지킴이, 13년차 인프라 엔지니어입니다. 홈랩에서 이것저것 만져보며 새로운 기술에 대한 감을 잃지 않으려 노력하는 게 제 일상인데요. 최근 들어 가장 뜨거운 감자는 역시 생성형 AI (Generative AI), 그중에서도 LLM (Large Language Model)이 아닐까 싶습니다.

    솔직히 처음엔 ‘이게 과연 업무에 얼마나 도움이 될까?’ 싶었어요. 간단한 스크립트나 문서 요약 정도는 괜찮겠지만, 복잡하고 민감한 인프라 환경에서 AI에 의존하는 건 좀 위험하지 않나 생각했었죠. 그런데 Gemini Advanced(제미니 어드밴스드)를 직접 써보니 생각이 많이 달라지더라고요. 특히 구글 AI 프리미엄 기능들을 경험하면서, ‘아, 이건 이제 선택이 아니라 필수겠구나’ 하는 확신이 들었어요.

    오늘은 13년차 인프라 엔지니어의 시각에서 Gemini Advanced가 왜 매력적인지, 그리고 이 구글 AI 프리미엄 기능을 완벽하게 활용해서 우리 업무에 어떻게 녹여낼 수 있을지 꼼꼼하게 알려드릴게요. 삽질 경험도 솔직하게 공유하면서 여러분의 시간을 아껴드릴 겁니다. 혹시 Gemini 사용법에 대해 궁금하셨다면, 이 글이 좋은 가이드가 될 거예요.

    Gemini Advanced의 사용자 인터페이스는 직관적이고 깔끔해서 처음 사용하는 분들도 쉽게 적응할 수 있습니다.

    ✅ Gemini Advanced, 무엇이 특별할까요?

    그럼 Gemini Advanced가 기존 무료 버전이나 다른 LLM들과 무엇이 다를까요? 인프라 엔지니어의 관점에서 핵심적인 차이점들을 짚어볼게요. 쉽게 말해, ‘더 똑똑하고, 더 길게 기억하고, 더 다양한 것을 이해한다’고 보시면 됩니다.

    • Longer Context Window (긴 컨텍스트 윈도우): 이게 정말 중요하거든요. 복잡한 시스템 아키텍처 문서, 장문의 로그 파일, 혹은 수많은 설정 파일들을 한 번에 넣고 분석해달라고 할 때, 무료 버전은 중간에 잘리거나 핵심을 놓치는 경우가 많았거든요. 하지만 Advanced 버전은 훨씬 더 긴 내용을 기억하고 추론할 수 있어서, 대규모 시스템 환경 분석에는 정말 압도적으로 유리하더라고요. 제가 홈랩에서 쿠버네티스(Kubernetes) 클러스터 설정을 통째로 던져주고 특정 문제점을 찾아달라고 했는데, 그 방대한 양을 척척 소화하는 걸 보고 깜짝 놀랐거든요.
    • Advanced Reasoning Capabilities (고도화된 추론 능력): 단순히 정보를 요약하는 걸 넘어, 복잡한 문제의 원인을 분석하고 여러 대안 중 최적의 솔루션을 제시하는 능력이 정말 뛰어나더라고요. 예를 들어, ‘이런 상황에서 네트워크 성능 병목이 생겼는데, 어떤 지표를 봐야 하고 해결책은 뭘까?’ 물어보면 꽤 구체적이고 논리적인 답이 돌아와요.
    • Multimodality (멀티모달): 텍스트뿐만 아니라 이미지, 오디오, 비디오 같은 다양한 형태의 정보를 이해하고 처리할 수 있는 능력이거든요. 아직 인프라 분야에서는 활용 범위가 제한적이겠지만, 서버 랙 구성 사진을 보고 개선점을 찾는다거나 네트워크 다이어그램을 해석하는 식의 미래 가능성을 충분히 엿볼 수 있어요.

    이런 기능들 덕분에 Gemini Advanced 활용은 단순한 검색을 넘어 경험 많은 시니어 엔지니어와 대화하는 느낌을 줘요.

    💡 인프라 엔지니어의 Gemini Advanced 활용법: 실전 가이드

    그럼 이제 13년차 인프라 엔지니어의 시각에서, Gemini Advanced를 어떻게 실전 업무에 적용할 수 있을지 구체적인 Gemini 사용법을 알려드릴게요. 저도 홈랩에서 다양한 시나리오로 테스트하며 얻은 노하우들입니다.

    1. 코드/스크립트 생성 및 디버깅

    반복적인 작업 자동화는 인프라 엔지니어의 숙명이죠. 파이썬(Python)이나 배시(Bash) 스크립트 작성에 Gemini Advanced가 큰 도움을 줍니다.

    1. 기본 스크립트 초안 생성: 특정 기능을 하는 스크립트가 필요할 때, 요구사항을 자세히 적어주면 초안을 빠르게 만들어주더라고요.
    2. 기존 스크립트 개선 및 최적화: 작성된 스크립트를 붙여넣고 ‘더 효율적으로 개선해줄래?’ 하거나 ‘에러 핸들링을 추가해주면 좋을 것 같은데’ 하고 요청하면 척척 처리해주거든요.
    3. 에러 디버깅: 에러 메시지와 관련 코드 스니펫을 주면, 문제의 원인을 분석하고 해결책을 척척 제시해줍니다.

    예시 프롬프트:

    "AWS EC2 인스턴스의 특정 태그(예: Environment: Production)를 가진 인스턴스들의 IP 주소를 가져와서 CSV 파일로 저장하는 Python 스크립트를 작성해줘. boto3 라이브러리를 사용하고, 에러 핸들링도 포함해줘."

    2. 복잡한 아키텍처 문서화 및 브레인스토밍

    새로운 시스템을 설계하거나 기존 시스템을 문서화할 때, 아이디어를 얻고 정돈하는 데 정말 유용하거든요.

    • 개념 설명 요청: ‘쿠버네티스 Ingress Controller(인그레스 컨트롤러, 외부 트래픽 진입점)의 작동 원리를 초보자도 이해하기 쉽게 설명해줄래?’ 하면 핵심 개념을 정말 잘 정리해주더라고요.
    • 설계 아이디어 제안: ‘대규모 웹 서비스를 위한 고가용성(High Availability) 아키텍처를 설계하려고 하는데, AWS 환경에서 뭘 고려해야 하고 어떤 서비스를 추천할까?’ 물으면 체계적인 제안이 나와요.
    • 문서 초안 작성: 특정 시스템의 운영 가이드나 장애 복구 절차(DRP, Disaster Recovery Plan) 문서를 만들어달라고 하면 초안을 작성해주는 식으로 활용할 수 있어요.

    성공적인 Gemini Advanced 활용은 효과적인 프롬프트 엔지니어링에서 시작됩니다.

    ⚠️ 삽질 경험: 프롬프트 엔지니어링의 중요성

    솔직히 처음에는 Gemini Advanced가 만능인 줄 알았습니다. ‘내 머릿속에 있는 걸 다 알아주겠지?’ 하는 막연한 기대를 했었죠. 하지만 막상 써보니, 프롬프트(Prompt)를 어떻게 던지느냐에 따라 결과물의 퀄리티가 천차만별이더라고요. 여기서 저의 ‘삽질’이 시작됐습니다. 😅

    제가 겪었던 흔한 실수들은 다음과 같습니다.

    • 모호한 요청: ‘서버 문제 해결해줘’ 같은 두루뭉술한 요청은 당연히 좋은 결과를 주지 못합니다.
    • 충분하지 않은 컨텍스트: 문제 상황을 설명할 때 관련 로그, 시스템 환경, 현재 상태 등을 충분히 제공하지 않아 AI가 오해하는 경우가 많았습니다.
    • 원하는 형식 미지정: ‘코드 짜줘’라고만 하고 어떤 언어로, 어떤 스타일로 원하는지 명시하지 않아 엉뚱한 결과가 나오기도 했죠.

    이런 시행착오를 겪으면서 ‘프롬프트 엔지니어링(Prompt Engineering)’의 중요성을 뼈저리게 느꼈습니다. Gemini Advanced 활용의 핵심은 바로 여기에 있어요. 몇 가지 팁을 드릴게요.

    1. 명확하고 구체적으로: 역할을 정해주고, 무엇을 해야 하는지, 어떻게 해야 하는지를 명확히 제시하세요.
    2. 충분한 컨텍스트 제공: 관련 정보(코드, 로그, 에러 메시지, 시스템 구성 등)를 최대한 많이 제공하세요.
    3. 예시 제공 (Few-shot prompting): 원하는 결과물의 예시를 몇 개 보여주면 AI가 훨씬 더 잘 이해하더라고요.
    4. 원하는 형식 명시: ‘JSON 형식으로’, ‘Python 코드로’, ‘마크다운 표로’ 등 결과물의 형식을 지정하세요.
    5. 제약 조건 명시: ‘Docker Compose(도커 컴포즈) 파일 생성 시, 특정 포트는 사용하지 말 것’과 같이 제약 조건을 알려주세요.

    🎉 실제 활용 사례 및 결과

    제가 Gemini Advanced에 ‘AWS Lambda(람다) 함수 배포를 위한 간단한 CI/CD(지속적 통합/지속적 배포) 파이프라인(Pipeline)을 GitHub Actions(깃허브 액션스)로 구현하는 YAML(야믈) 파일을 만들어줄래. Python 3.9 런타임 사용하고, S3(에스쓰리) 버킷에 배포 후 Lambda 함수를 업데이트하는 과정도 포함되어야 해.’ 라고 요청했거든요.

    name: Deploy Lambda Function
    
    on:
      push:
        branches:
          - main
    
    jobs:
      deploy:
        runs-on: ubuntu-latest
        permissions:
          id-token: write
          contents: read
    
        steps:
          - name: Checkout repository
            uses: actions/checkout@v3
    
          - name: Configure AWS credentials
            uses: aws-actions/configure-aws-credentials@v1
            with:
              role-to-assume: arn:aws:iam::123456789012:role/GitHubActionsRole # IAM Role ARN
              aws-region: ap-northeast-2
    
          - name: Set up Python
            uses: actions/setup-python@v4
            with:
              python-version: '3.9'
    
          - name: Install dependencies
            run: pip install -r requirements.txt
    
          - name: Zip function code
            run: | 
              zip -r function.zip . -x "*.git*" "__pycache__/*"
    
          - name: Upload to S3
            run: aws s3 cp function.zip s3://your-lambda-code-bucket/function.zip
    
          - name: Update Lambda function
            run: aws lambda update-function-code --function-name YourLambdaFunctionName --s3-bucket your-lambda-code-bucket --s3-key function.zip
    
          - name: Clean up
            run: rm function.zip
    

    보시다시피 꽤 구체적이고 바로 활용 가능한 YAML 파일을 생성해줬어요. 물론 IAM Role ARN이나 S3 버킷 이름, Lambda 함수 이름은 제가 직접 넣어야 하지만, 기본 틀을 이렇게 빠르게 만들어주는 것만으로도 정말 시간 절약이 되더라고요. 이 LLM 활용 능력은 정말 감탄스러워요.

    Gemini Advanced는 인프라 엔지니어의 업무 효율을 혁신적으로 개선할 수 있는 잠재력을 가지고 있습니다.

    🤔 Gemini Advanced, 이런 점은 아쉽다?

    아무리 좋은 도구라도 완벽할 순 없겠죠. Gemini Advanced도 역시 아쉬운 점들이 있더라고요.

    • 할루시네이션 (Hallucination): 가끔 없는 사실을 만들어내거나 그럴듯해 보이지만 틀린 정보를 주곤 합니다. 특히 민감한 인프라 설정이나 보안 관련 조언에서는 반드시 교차 검증(Cross-verification)이 필요하거든요. ‘아, 이거 또 헛소리하네!’ 하면서 제가 직접 찾아본 적도 여러 번 있어요.
    • 최신 정보 부족: 학습 데이터 컷오프(Cut-off) 이후의 최신 기술이나 변경 사항에 대해서는 모르는 경우가 있거든요. 예를 들어, 최근에 업데이트된 소프트웨어의 새로운 기능이나 CVE(Common Vulnerabilities and Exposures) 정보는 직접 찾아봐야 하는 식이죠.
    • 복잡한 논리 오류: 복잡하고 다층적인 논리가 필요한 문제에서는 여전히 한계를 보이더라고요. 이때는 AI 답변을 맹신하기보다 아이디어 정도로 참고하고 스스로 검증해야 합니다.

    이런 한계들을 인지하고 사용하면, Gemini Advanced는 정말 강력한 도구가 될 수 있어요.

    🚀 마무리하며: 인프라 엔지니어의 새로운 동반자

    제가 Gemini Advanced 활용 가이드를 작성하면서 느낀 점은, 이 구글 AI 프리미엄 서비스가 인프라 엔지니어에게 정말 강력한 ‘동반자’가 될 수 있다는 거예요. 반복적인 작업을 자동화하고, 새로운 기술을 빠르게 학습하며, 복잡한 문제 해결의 실마리를 찾는 데 큰 도움을 주거든요.

    물론 프롬프트 엔지니어링 능력은 필수적이고, AI의 답변을 무비판적으로 받아들이면 안 됩니다. 하지만 이 도구를 잘 활용하면, 우리 인프라 엔지니어들은 더 본질적인 문제 해결과 혁신적인 아이디어에 집중할 수 있게 된다니까요. 저도 앞으로 홈랩에서 Gemini Advanced를 더 깊게 파고들면서 새로운 활용법들을 찾아낼 거고요. 다음 글에서는 특정 인프라 자동화 시나리오에 Gemini Advanced를 연동하는 방법을 다뤄볼 예정이니까요. 기대해주세요!

  • [AI] Gemini API 실전 활용 가이드: 모델 선택부터 멀티모달 요청, 비용 절감 전략까지

    [AI] Gemini API 실전 활용 가이드: 모델 선택부터 멀티모달 요청, 비용 절감 전략까지

    Gemini API, 왜 지금 주목해야 할까요?

    요즘 LLM API 시장이 정말 치열해졌어요. OpenAI의 GPT 시리즈가 한동안 독주하던 시절이 있었는데, 이제는 Google의 Gemini API가 진지하게 비교 대상이 되고 있더라고요. 저도 처음엔 “Google이 만든 거니까 검색 연동이 좀 잘 되겠지” 정도로만 생각했었는데, 실제로 써보니까 이게 생각보다 훨씬 강력하고 비용 면에서도 매력적인 선택지더라고요.

    특히 홈랩에서 AI 서비스를 구축해보려는 분들, 또는 스타트업처럼 API 비용이 민감한 환경에서 개발하시는 분들한테는 Gemini API의 가격 정책이 꽤 인상적으로 다가올 거라고 생각해요. 오늘은 제가 직접 Gemini API를 실무와 홈랩 프로젝트에 적용해보면서 배운 것들을 정리해 드릴게요. 기초 세팅부터 비용 절감 전략, 그리고 자주 빠지는 함정까지 솔직하게 공유해 드리겠습니다.

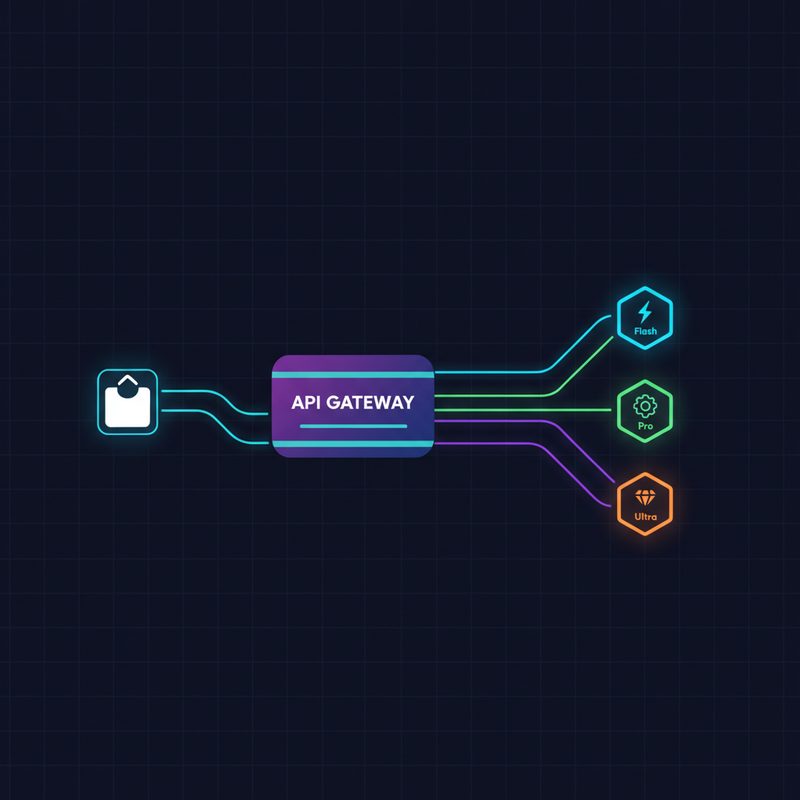
    Gemini API 전체 아키텍처 다이어그램 - 클라이언트에서 Gemini 모델까지의 요청 흐름

    ▲ Gemini API의 전체 요청/응답 흐름 — 클라이언트 앱에서 API를 통해 Gemini 모델과 통신하는 구조입니다.

    Gemini API 핵심 개념 정리

    모델 라인업, 어떤 걸 써야 할까요?

    Gemini API를 처음 접하면 모델 이름이 좀 헷갈릴 수 있어요. 쉽게 말해서 크게 세 가지 티어로 나뉜다고 보시면 됩니다.

    • Gemini 1.5 Pro: 가장 강력한 모델. 복잡한 추론, 멀티모달 작업에 최적화. 비용이 가장 높음
    • Gemini 1.5 Flash: 범용 작업에 적합한 균형 잡힌 모델. 실무에서 가장 많이 쓰이는 티어
    • Gemini 2.0 Flash: 속도와 비용 효율에 최적화된 경량 모델. 빠른 응답이 필요한 서비스에 딱

    제가 실제로 프로젝트에 적용할 때 느낀 건, 무조건 Pro를 쓸 필요가 없다는 거예요. 단순 분류 작업이나 요약, 간단한 Q&A 봇이라면 Gemini Flash가 가성비 면에서 압도적이더라고요. 처음에 괜히 Pro만 쓰다가 비용 폭탄 맞을 뻔했습니다 ㅎㅎ.

    멀티모달(Multimodal) 지원이 진짜 강점

    Gemini API의 가장 큰 특징 중 하나가 멀티모달 지원이에요. 텍스트만 처리하는 게 아니라 이미지, 동영상, 오디오, PDF 같은 파일도 같이 넘겨줄 수 있거든요. 이게 실무에서 생각보다 엄청 유용하더라고요. 예를 들어 인프라 다이어그램 이미지를 넣고 “이 구조에서 단일 장애점(SPOF, Single Point of Failure)이 어디야?” 같은 질문도 가능해요.

    Gemini API 실전 세팅: 처음부터 차근차근

    1단계: API 키 발급 및 환경 설정

    Google AI Studio(aistudio.google.com)에서 API 키를 발급받는 건 어렵지 않아요. 계정 만들고 프로젝트 생성하면 바로 키 발급이 되더라고요. 근데 여기서 중요한 포인트! API 키는 절대 코드에 하드코딩하지 마세요. 환경 변수로 관리하는 게 기본 중의 기본입니다.

    # .env 파일에 API 키 저장
    GOOGLE_API_KEY=your_api_key_here
    
    # Python 환경에 패키지 설치
    pip install google-generativeai python-dotenv

    2단계: 기본 텍스트 생성 요청

    설치가 끝나면 바로 첫 번째 요청을 날려볼 수 있어요. 아래가 가장 기본적인 형태입니다.

    import google.generativeai as genai
    from dotenv import load_dotenv
    import os
    
    # 환경 변수 로드
    load_dotenv()
    genai.configure(api_key=os.environ["GOOGLE_API_KEY"])
    
    # 모델 초기화 (gemini-1.5-flash 사용 예시)
    model = genai.GenerativeModel("gemini-1.5-flash")
    
    # 기본 텍스트 생성
    response = model.generate_content("쿠버네티스 파드(Pod)가 뭔지 초보자한테 설명해줘")
    print(response.text)

    3단계: 멀티턴 대화(Multi-turn Conversation) 구현

    챗봇이나 대화형 서비스를 만들 때는 이전 대화 맥락을 유지해야 하잖아요. Gemini API에서는 start_chat() 메서드로 이걸 쉽게 구현할 수 있어요.

    import google.generativeai as genai
    import os
    
    genai.configure(api_key=os.environ["GOOGLE_API_KEY"])
    model = genai.GenerativeModel("gemini-1.5-pro")
    
    # 대화 세션 시작
    chat = model.start_chat(history=[])
    
    # 첫 번째 메시지
    response1 = chat.send_message("나는 인프라 엔지니어야. Terraform이 뭔지 알아?")
    print("AI:", response1.text)
    
    # 두 번째 메시지 (이전 맥락 유지됨)
    response2 = chat.send_message("그럼 Ansible이랑 어떻게 다른 거야?")
    print("AI:", response2.text)
    
    # 대화 히스토리 확인
    for turn in chat.history:
        print(f"{turn.role}: {turn.parts[0].text[:50]}...")

    4단계: 이미지 포함 멀티모달 요청

    이게 진짜 Gemini API의 킬러 기능인데요. 이미지를 텍스트와 함께 넘기는 방법이에요.

    import google.generativeai as genai
    import PIL.Image
    import os
    
    genai.configure(api_key=os.environ["GOOGLE_API_KEY"])
    
    # 멀티모달 요청에는 gemini-1.5-pro 또는 flash 사용
    model = genai.GenerativeModel("gemini-1.5-flash")
    
    # 로컬 이미지 로드
    image = PIL.Image.open("server_diagram.png")
    
    # 이미지 + 텍스트 동시 전송
    response = model.generate_content([
        image,
        "이 서버 아키텍처 다이어그램을 분석해서 개선점을 알려줘"
    ])
    
    print(response.text)
    Gemini API 멀티모달 Python 코드 예시 - 이미지와 텍스트를 동시에 처리하는 구현 화면

    ▲ 멀티모달 요청 코드 예시 — 이미지와 텍스트를 동시에 API에 전달하는 구현 방식입니다.

    5단계: 스트리밍(Streaming) 응답 처리

    응답이 길어지면 사용자가 한참 기다려야 하잖아요. 스트리밍을 쓰면 토큰이 생성되는 대로 바로바로 출력할 수 있어서 사용자 경험이 훨씬 좋아져요. 저도 처음에 이걸 몰라서 사용자들이 “왜 이렇게 느려요?” 소리를 들었었는데… 스트리밍 붙이고 나서 체감 속도가 확 달라졌더라고요.

    import google.generativeai as genai
    import os
    
    genai.configure(api_key=os.environ["GOOGLE_API_KEY"])
    model = genai.GenerativeModel("gemini-1.5-pro")
    
    # stream=True로 스트리밍 활성화
    response = model.generate_content(
        "쿠버네티스 클러스터 보안 강화 방법을 자세히 설명해줘",
        stream=True
    )
    
    # 토큰 단위로 실시간 출력
    for chunk in response:
        print(chunk.text, end="", flush=True)
    
    print()  # 줄바꿈

    6단계: 시스템 인스트럭션(System Instruction)으로 역할 설정

    AI한테 “너는 인프라 전문가야” 같은 역할을 부여하고 싶을 때 사용하는 게 시스템 인스트럭션이에요. 이걸 잘 활용하면 훨씬 일관성 있는 응답을 받을 수 있어요.

    import google.generativeai as genai
    import os
    
    genai.configure(api_key=os.environ["GOOGLE_API_KEY"])
    
    # 시스템 인스트럭션으로 역할 설정
    model = genai.GenerativeModel(
        model_name="gemini-1.5-pro",
        system_instruction="""당신은 10년 이상 경력의 DevOps 엔지니어입니다.
        쿠버네티스, Terraform, CI/CD 파이프라인 전문가로서
        실용적이고 현장 중심의 답변을 제공합니다.
        복잡한 개념은 실제 예시와 함께 설명해주세요."""
    )
    
    response = model.generate_content("Helm 차트란 무엇인가요?")
    print(response.text)

    ⚠️ 실제로 겪은 문제들과 해결법

    문제 1: Rate Limit(요청 한도) 오류

    API를 처음 쓸 때 제일 많이 만나는 오류가 바로 429 Resource Exhausted예요. 무료 티어에서 테스트하다 보면 금방 한도에 걸리거든요. 이럴 때는 지수 백오프(Exponential Backoff) 전략을 써야 해요.

    import google.generativeai as genai
    import time
    import os
    
    genai.configure(api_key=os.environ["GOOGLE_API_KEY"])
    model = genai.GenerativeModel("gemini-1.5-flash")
    
    def generate_with_retry(prompt, max_retries=3):
        """지수 백오프로 Rate Limit 오류 처리"""
        for attempt in range(max_retries):
            try:
                response = model.generate_content(prompt)
                return response.text
            except Exception as e:
                if "429" in str(e) and attempt < max_retries - 1:
                    wait_time = (2 ** attempt) * 1  # 1초, 2초, 4초
                    print(f"Rate limit 도달. {wait_time}초 후 재시도... ({attempt + 1}/{max_retries})")
                    time.sleep(wait_time)
                else:
                    raise e
        return None
    
    result = generate_with_retry("간단한 테스트 메시지")
    print(result)

    문제 2: 토큰 수 관리 실패로 비용 폭탄

    이건 저도 한 번 당했는데요. 대화 히스토리를 무한정 쌓으면 토큰이 기하급수적으로 늘어나요. 특히 멀티턴 대화에서 히스토리를 관리 안 하면 나중엔 요청 하나에 엄청난 토큰이 소비됩니다. 히스토리 최대 길이를 제한하는 로직은 반드시 넣으세요.

    class ManagedChat:
        """히스토리 길이를 제한하는 대화 관리 클래스"""
        
        def __init__(self, model_name="gemini-1.5-flash", max_history=10):
            self.model = genai.GenerativeModel(model_name)
            self.max_history = max_history
            self.history = []
        
        def send_message(self, message):
            # 히스토리가 최대값 초과시 오래된 것부터 제거
            if len(self.history) >= self.max_history * 2:  # user/model 쌍
                self.history = self.history[-(self.max_history * 2):]
            
            chat = self.model.start_chat(history=self.history)
            response = chat.send_message(message)
            
            # 히스토리 업데이트
            self.history = chat.history
            return response.text
    
    # 사용 예시
    chat_manager = ManagedChat(max_history=5)
    print(chat_manager.send_message("안녕하세요!"))
    print(chat_manager.send_message("쿠버네티스에 대해 알려줘"))

    문제 3: Safety Filter(안전 필터) 예상치 못한 차단

    기술 문서나 보안 관련 내용을 다룰 때 Safety Filter가 과하게 작동하는 경우가 있어요. 특히 "취약점", "익스플로잇" 같은 단어가 포함된 정당한 기술 질문이 차단되기도 하더라고요. 이럴 때는 응답의 prompt_feedback를 확인해서 왜 차단됐는지 파악하는 게 먼저예요.

    response = model.generate_content("CVE 취약점 분석 방법")
    
    # 안전 필터 상태 확인
    if response.prompt_feedback:
        print("프롬프트 피드백:", response.prompt_feedback)
    
    # 응답 후보 확인
    for candidate in response.candidates:
        print("완료 이유:", candidate.finish_reason)
        print("안전 등급:", candidate.safety_ratings)
    Gemini API 사용량 및 비용 모니터링 대시보드 - 토큰 소비량과 모델별 비용 분석

    ▲ Gemini API 사용량 모니터링 대시보드 — 토큰 소비량과 비용 추이를 추적하는 것이 비용 관리의 핵심입니다.

    비용 효율적인 Gemini API 개발 전략

    모델 선택이 곧 비용 전략

    제가 실제로 써보면서 정리한 모델 선택 기준이에요. 무조건 좋은 모델을 쓰는 게 능사가 아니더라고요.

    사용 케이스 추천 모델 이유
    단순 분류, 키워드 추출 Gemini 1.5 Flash 빠르고 저렴, 충분한 성능
    문서 요약, 번역 Gemini 1.5 Flash 대용량 컨텍스트 처리 효율적
    코드 생성, 복잡한 추론 Gemini 1.5 Pro 정확도가 중요한 작업
    이미지/영상 분석 Gemini 1.5 Pro/Flash 멀티모달 작업, 복잡도에 따라 선택
    실시간 챗봇 Gemini 1.5 Flash 낮은 레이턴시(응답 지연)가 핵심

    프롬프트 캐싱(Context Caching)으로 비용 절감

    같은 시스템 인스트럭션이나 긴 문서를 반복해서 전송하는 경우, 컨텍스트 캐싱을 활용하면 비용을 크게 줄일 수 있어요. 이건 Gemini API에서 지원하는 기능인데, 자주 반복되는 대용량 컨텍스트를 캐시해두고 재사용하는 방식이에요.

    예를 들어 100페이지짜리 기술 문서를 기반으로 Q&A 서비스를 만든다면, 매번 그 문서 전체를 토큰으로 전송하는 게 아니라 캐시를 활용하면 엄청난 비용 절감이 가능하죠.

    배치 처리(Batch Processing) 전략

    실시간성이 필요 없는 작업이라면 배치로 묶어서 처리하는 게 효율적이에요. 예를 들어 로그 분석이나 대량 문서 분류 같은 작업은 굳이 실시간으로 처리할 필요가 없잖아요.

    import google.generativeai as genai
    import asyncio
    import os
    
    genai.configure(api_key=os.environ["GOOGLE_API_KEY"])
    model = genai.GenerativeModel("gemini-1.5-flash")
    
    async def process_single(text, semaphore):
        """세마포어로 동시 요청 수 제한"""
        async with semaphore:
            # 실제 비동기 처리 (google-generativeai 비동기 지원 확인 필요)
            response = model.generate_content(
                f"다음 로그를 분류해줘 (ERROR/WARN/INFO): {text}"
            )
            return response.text
    
    async def batch_process(texts, max_concurrent=5):
        """최대 5개 동시 요청으로 배치 처리"""
        semaphore = asyncio.Semaphore(max_concurrent)
        tasks = [process_single(text, semaphore) for text in texts]
        results = await asyncio.gather(*tasks, return_exceptions=True)
        return results
    
    # 사용 예시
    log_entries = [
        "Connection timeout after 30s",
        "User login successful: admin",
        "Disk usage 95% on /dev/sda1",
        "Service restarted successfully",
    ]
    
    results = asyncio.run(batch_process(log_entries))
    for log, result in zip(log_entries, results):
        print(f"로그: {log[:30]}... -> {result}")

    실전 활용 검증: 간단한 인프라 Q&A 봇 완성

    지금까지 배운 내용을 종합해서 간단한 인프라 Q&A 봇을 만들어봤어요. 히스토리 관리, 스트리밍, 시스템 인스트럭션을 모두 적용한 버전입니다.

    import google.generativeai as genai
    import os
    from dotenv import load_dotenv
    
    load_dotenv()
    genai.configure(api_key=os.environ["GOOGLE_API_KEY"])
    
    SYSTEM_PROMPT = """당신은 인프라 엔지니어링 전문 어시스턴트입니다.
    Kubernetes, Docker, Terraform, CI/CD, 네트워크 보안 분야의 전문가로서
    실용적이고 즉시 적용 가능한 답변을 제공합니다.
    답변은 항상 한국어로, 코드 예시와 함께 제공해주세요."""
    
    class InfraBot:
        def __init__(self):
            self.model = genai.GenerativeModel(
                model_name="gemini-1.5-flash",
                system_instruction=SYSTEM_PROMPT
            )
            self.chat = self.model.start_chat(history=[])
            self.turn_count = 0
            self.max_turns = 10
        
        def ask(self, question):
            # 히스토리 초과시 새 세션 시작
            if self.turn_count >= self.max_turns:
                print("[대화 히스토리 초기화됨]")
                self.chat = self.model.start_chat(history=[])
                self.turn_count = 0
            
            print("AI: ", end="", flush=True)
            
            # 스트리밍으로 응답
            response = self.chat.send_message(question, stream=True)
            full_response = ""
            
            for chunk in response:
                print(chunk.text, end="", flush=True)
                full_response += chunk.text
            
            print()  # 줄바꿈
            self.turn_count += 1
            return full_response
    
    # 봇 실행
    bot = InfraBot()
    print("인프라 Q&A 봇 시작! ('quit' 입력시 종료)\n")
    
    while True:
        user_input = input("질문: ").strip()
        if user_input.lower() == 'quit':
            break
        if user_input:
            bot.ask(user_input)
            print()

    이 정도면 실제 팀 내 슬랙 봇이나 간단한 웹 서비스 백엔드로 바로 활용할 수 있어요. 드디어 됐다! 싶은 순간이 있었는데, 스트리밍 적용하고 히스토리 관리 붙이고 나서 체감 퀄리티가 확 올라가더라고요. 🎉

    Gemini API 모델 비교 인포그래픽 - Flash, Pro, Ultra의 속도·비용·성능 트레이드오프

    ▲ Gemini API 모델 비교 — Flash, Pro, Ultra의 속도·비용·성능 트레이드오프를 파악하고 용도에 맞게 선택하는 게 핵심입니다.

    자주 묻는 질문 (FAQ)

    Q. Gemini API와 OpenAI API, 어떤 걸 선택해야 하나요?

    솔직히 말씀드리면, 둘 다 써보고 판단하시는 걸 추천드려요. 다만 비용 효율을 중시하거나, 멀티모달 기능이 중요하거나, 긴 컨텍스트 윈도우(한 번에 처리할 수 있는 텍스트 길이)가 필요하다면 Gemini가 매력적인 선택이 될 수 있어요. 반면 생태계와 서드파티 라이브러리 지원은 OpenAI가 아직 더 풍부한 편이에요.

    Q. 무료로 쓸 수 있나요?

    네, Google AI Studio를 통해 무료 티어가 제공돼요. 다만 분당 요청 수(RPM)와 일일 한도가 있어서 프로덕션 환경에서는 유료 플랜을 고려해야 해요. 개발·테스트 단계에서는 무료로 충분히 실험해볼 수 있더라고요.

    Q. 한국어 성능은 어떤가요?

    제가 직접 써본 경험으로는, Gemini 1.5 Pro 기준으로 한국어 이해 및 생성 품질이 꽤 좋아요. 기술 문서나 코드 관련 한국어 질문에 대한 응답 품질이 실무에서 쓸 만한 수준이더라고요. 다만 매우 전문적인 도메인 특화 용어는 영어로 질문하는 게 더 정확한 답변을 얻는 경우도 있었어요.

    마무리: Gemini API, 이렇게 시작하세요

    오늘 다룬 내용을 정리해볼게요.

    • ✅ 모델 선택 전략: 무조건 Pro가 아닌, 용도에 맞는 모델 선택이 비용 절감의 핵심
    • ✅ 히스토리 관리: 멀티턴 대화에서 토큰 폭탄 방지를 위한 히스토리 길이 제한 필수
    • ✅ 스트리밍 적용: 사용자 체감 속도를 높이려면 스트리밍 응답이 거의 필수
    • ✅ Rate Limit 대비: 지수 백오프 로직으로 안정적인 서비스 구현
    • ✅ 시스템 인스트럭션: 일관된 응답 품질을 위해 적극 활용

    처음 AI API를 써볼 때 막막했던 기억이 나는데, 사실 구조 자체는 생각보다 단순해요. 핵심은 어떤 모델을 어떤 용도에 쓸지 판단하는 것, 그리고 비용 관리를 처음부터 설계에 포함시키는 것이더라고요.

    💡 다음 글에서는 Gemini API를 활용해서 실제 Slack 봇을 만들고 사내 인프라 Q&A 시스템으로 연동하는 방법을 다룰 예정이에요. 이번 글에서 만든 InfraBot 코드를 기반으로 확장할 예정이니 참고해 두세요. 혹시 궁금한 점이나 직접 써보다가 막히는 부분이 있으면 댓글로 남겨주세요!

  • [AI] ChatGPT, Claude, Gemini: 실무 LLM 비교 분석

    [AI] ChatGPT, Claude, Gemini: 실무 LLM 비교 분석

    LLM 비교: ChatGPT, Claude, Gemini — 실무에서 직접 써본 솔직한 이야기

    요즘 팀 내에서 자주 받는 질문이 있어요. “ChatGPT랑 Claude랑 Gemini 중에 뭐 써야 해요?” 인프라 엔지니어가 LLM 비교 글을 쓰는 게 좀 뜬금없어 보일 수도 있는데, 솔직히 저도 처음엔 그냥 ChatGPT 하나만 쓰면 되는 거 아닌가 싶었거든요. 근데 실제로 업무에서 쓰다 보니까 — 스크립트 작성, 장애 로그 분석, 문서화, 코드 리뷰 요청 등등 — 도구마다 확실히 잘하는 게 다르더라고요.

    그래서 오늘은 제가 실무에서 직접 써보면서 느낀 LLM 비교 이야기를 솔직하게 풀어볼게요. ChatGPT, Claude, Gemini 세 가지를 중심으로, 어떤 상황에서 뭘 쓰는 게 유리한지 정리해 봤습니다.

    ChatGPT, Claude, Gemini LLM 비교 — 세 가지 AI 챗봇 서비스 나란히 배치

    ▲ ChatGPT, Claude, Gemini — 각자 개성이 뚜렷한 세 가지 LLM. 어떤 상황에서 무엇을 써야 할지가 핵심입니다.

    🤖 LLM(대형 언어 모델)이 뭔지 잠깐 짚고 가기

    혹시 LLM(Large Language Model, 대형 언어 모델)이라는 용어가 아직 낯선 분들을 위해 짧게 설명하고 넘어갈게요. 쉽게 말해서, 방대한 텍스트 데이터를 학습해서 사람처럼 글을 읽고 쓸 수 있는 AI 모델이에요. ChatGPT, Claude, Gemini 모두 이 LLM 기술을 기반으로 만들어진 AI 챗봇 서비스입니다.

    각각 만든 회사가 다르고, 기반 모델도 달라요:

    • ChatGPT: OpenAI에서 만든 GPT 시리즈 기반. GPT-4o 등의 모델 사용
    • Claude: Anthropic에서 만든 Claude 시리즈 기반. Claude 3 시리즈(Haiku, Sonnet, Opus 등)
    • Gemini: Google에서 만든 Gemini 시리즈 기반. Gemini 1.5 Pro, Flash 등

    같은 LLM 계열이지만, 학습 방식과 철학이 달라서 답변 스타일과 강점이 꽤 차이가 나요. 이게 핵심입니다.

    📊 세 가지 LLM 기본 특성 한눈에 보기

    먼저 기본 스펙 비교부터 보시죠. 제가 실제로 사용해보면서 느낀 체감 특성을 함께 정리했어요.

    항목 ChatGPT (OpenAI) Claude (Anthropic) Gemini (Google)
    개발사 OpenAI Anthropic Google
    대표 모델 GPT-4o, GPT-4 Turbo Claude 3 Sonnet, Opus, Haiku Gemini 1.5 Pro, Flash
    컨텍스트 창 128K 토큰(GPT-4 Turbo) 200K 토큰(Claude 3) 1M 토큰(Gemini 1.5 Pro)
    강점 분야 범용, 코드 생성, 플러그인 생태계 긴 문서 분석, 글쓰기, 안전성 멀티모달, Google 서비스 연동
    무료 플랜 있음 (제한적) 있음 (제한적) 있음
    API 제공 ✅ ✅ ✅

    표만 보면 다 비슷비슷해 보이죠? 근데 실제로 써보면 체감이 확연히 달라요. 이제 제가 실무에서 겪은 케이스별로 풀어볼게요.

    💻 실무 케이스 1: 코드 작성 및 디버깅

    인프라 엔지니어로서 제일 자주 쓰는 용도가 스크립트 작성이에요. Bash, Python, Terraform(테라폼, 인프라 자동화 도구) 코드를 짤 때 LLM을 많이 활용하는데, 여기서 ChatGPT가 확실히 강하더라고요.

    예를 들어, 로그 파일에서 특정 패턴을 뽑아서 Slack으로 알림 보내는 Python 스크립트를 만들어달라고 했을 때, ChatGPT는 바로 실행 가능한 코드를 척척 내놓거든요. Claude도 잘 하는데, 코드 외에 “이 부분은 이런 이유로 이렇게 작성했습니다” 같은 설명을 더 붙여줘서 학습 목적엔 오히려 Claude가 나을 수도 있어요.

    Gemini는 Google Cloud 관련 코드에서 빛을 발하더라고요. GCP(Google Cloud Platform) 서비스 관련 설정이나 gcloud CLI 명령어 쪽은 역시 구글 것이라 그런지 정확도가 높았어요.

    # ChatGPT에게 요청한 프롬프트 예시
    # "Nginx 액세스 로그에서 5xx 에러를 추출해서
    # Slack Webhook으로 알림 보내는 Python 스크립트 작성해줘"
    
    import re
    import requests
    from datetime import datetime
    
    LOG_FILE = "/var/log/nginx/access.log"
    SLACK_WEBHOOK_URL = "https://hooks.slack.com/services/YOUR/WEBHOOK/URL"
    
    def parse_5xx_errors(log_file):
        errors = []
        pattern = re.compile(r'(\S+) \S+ \S+ \[(.+?)\] "(.+?)" (5\d{2})')
        with open(log_file, 'r') as f:
            for line in f:
                match = pattern.search(line)
                if match:
                    errors.append({
                        'ip': match.group(1),
                        'time': match.group(2),
                        'request': match.group(3),
                        'status': match.group(4)
                    })
        return errors
    
    def send_slack_alert(errors):
        if not errors:
            return
        message = f"⚠️ *5xx 에러 감지* ({datetime.now().strftime('%Y-%m-%d %H:%M')})"
        for e in errors[:5]:  # 최대 5개만
            message += f"\n• `{e['status']}` | {e['ip']} | {e['request']}"
        payload = {"text": message}
        requests.post(SLACK_WEBHOOK_URL, json=payload)
    
    if __name__ == "__main__":
        errors = parse_5xx_errors(LOG_FILE)
        send_slack_alert(errors)
        print(f"총 {len(errors)}개의 5xx 에러 감지")
    

    💡 팁: 코드 생성 프롬프트를 쓸 때는 “실행 환경(OS, Python 버전 등)”과 “입력/출력 예시”를 함께 알려주면 훨씬 정확한 코드가 나와요. 저도 처음엔 그냥 대충 물어봤다가 쓸 수 없는 코드 받고 삽질 좀 했습니다 ㅎㅎ

    📄 실무 케이스 2: 긴 문서 분석 및 요약

    여기서는 Claude가 압도적이에요. 실제로 제가 겪은 상황인데, 100페이지짜리 벤더 제안서를 분석해야 했던 적이 있었어요. 전체 내용을 붙여넣고 “핵심 기술 스펙과 비용 구조를 표로 정리해줘”라고 했더니, Claude는 컨텍스트 창(Context Window, AI가 한 번에 처리할 수 있는 텍스트 양)이 넓어서 문서 전체를 한 번에 처리하더라고요.

    ChatGPT도 GPT-4 Turbo 기준으로 128K 토큰까지 처리하는데, Claude 3의 200K 토큰에는 못 미치고, 긴 문서에서 중간 부분을 약간 흘리는 느낌이 있었어요. 반면 Claude는 문서 전체를 꽤 꼼꼼하게 읽고 정리해주는 인상이었습니다.

    Gemini 1.5 Pro의 경우 컨텍스트 창이 1M 토큰으로 이론상 가장 크지만, 실제 사용에서 긴 문서의 세부 내용 파악 정확도는 케이스마다 달랐어요. 구글 Docs나 Drive와 연동해서 쓸 때는 편리함 면에서 확실히 좋더라고요.

    ChatGPT, Claude, Gemini의 긴 문서 분석 비교 화면

    ▲ 긴 문서 분석 시나리오 — 컨텍스트 창 크기와 정보 처리 방식에 따라 결과 품질이 달라집니다.

    ✍️ 실무 케이스 3: 기술 문서 작성 및 글쓰기

    이건 솔직히 Claude 손을 들어주고 싶어요. 글쓰기 품질이 세 가지 중 가장 자연스럽고, 문장 구조도 깔끔하더라고요. Anthropic이 Claude를 만들 때 “도움이 되고, 무해하고, 정직한(Helpful, Harmless, Honest)” 원칙을 강조했는데, 그 덕분인지 답변이 과장 없이 균형 잡혀 있어요.

    장애 보고서(Post-mortem, 포스트모템)나 운영 가이드 초안 작성할 때 Claude한테 맡기면 꽤 쓸 만한 초안이 나와요. ChatGPT도 잘 하는데, 가끔 좀 과하게 친절하거나 불필요한 서론이 길어질 때가 있거든요.

    Gemini는 Google Workspace(구글 워크스페이스)와 연동이 자연스러워서, Docs에서 직접 쓸 때는 편리해요. 특히 팀 전체가 Google 생태계를 쓰는 환경이라면 Gemini의 통합성이 큰 장점이 됩니다.

    🔍 실무 케이스 4: 멀티모달(이미지 분석) 활용

    멀티모달(Multimodal, 텍스트 외에 이미지·영상 등 다양한 형식 처리)은 Gemini와 GPT-4o가 강하더라고요. 실제로 네트워크 다이어그램 이미지를 붙여넣고 “이 구성에서 단일 장애 지점(SPOF, Single Point of Failure)이 어디야?” 하고 물어봤더니 둘 다 꽤 정확하게 짚어주더라고요.

    ChatGPT GPT-4o는 이미지 분석을 잘 하고, 실제로 많이 쓰이는 편이에요. Claude 3도 이미지 입력을 지원하는데, 이미지 분석보다는 텍스트 처리 쪽에서 더 두각을 나타내는 느낌입니다.

    ⚠️ 주의사항: 이미지에 민감한 내부 정보(IP 주소, 내부 아키텍처 등)가 포함된 경우, 외부 AI 서비스에 업로드하는 건 보안 정책 검토가 필요해요. 저희 팀에서도 이 부분 때문에 한 번 논의가 있었거든요.

    🛠️ API 활용 및 자동화 관점에서 본 LLM 비교

    인프라 엔지니어 입장에서 API(Application Programming Interface, 프로그래밍 연동 인터페이스) 활용도 중요한 비교 포인트예요. 세 가지 모두 API를 제공하는데, 각각 특징이 있어요.

    • OpenAI API (ChatGPT): 레퍼런스가 가장 많고, 커뮤니티 자료도 풍부해요. LangChain(랭체인, LLM 애플리케이션 개발 프레임워크) 같은 오픈소스 도구와의 연동 예제도 제일 많고요. 처음 LLM API를 써본다면 여기서 시작하는 걸 추천합니다.
    • Anthropic API (Claude): 문서가 깔끔하고, 응답 품질이 안정적이에요. 최근 Claude API를 써서 내부 문서 검색 봇을 만들어봤는데, 긴 컨텍스트 처리가 필요한 RAG(Retrieval-Augmented Generation, 검색 증강 생성) 구현에 잘 맞더라고요.
    • Google AI API (Gemini): Google Cloud를 이미 쓰고 있다면 Vertex AI(버텍스 AI)를 통해 Gemini를 쓰는 게 자연스러워요. IAM(Identity and Access Management, 접근 권한 관리) 연동이나 모니터링도 GCP 생태계 안에서 처리할 수 있어서 편합니다.
    # Claude API 간단 사용 예시 (Anthropic SDK)
    import anthropic
    
    client = anthropic.Anthropic(api_key="YOUR_API_KEY")
    
    message = client.messages.create(
        model="claude-3-sonnet-20240229",
        max_tokens=1024,
        messages=[
            {
                "role": "user",
                "content": "다음 Nginx 에러 로그를 분석하고 원인과 해결책을 알려줘:\n[error] 1234#1234: *1 connect() failed (111: Connection refused)"
            }
        ]
    )
    
    print(message.content[0].text)
    
    # OpenAI API 간단 사용 예시
    from openai import OpenAI
    
    client = OpenAI(api_key="YOUR_API_KEY")
    
    response = client.chat.completions.create(
        model="gpt-4o",
        messages=[
            {
                "role": "system",
                "content": "당신은 인프라 엔지니어를 돕는 DevOps 전문가입니다."
            },
            {
                "role": "user",
                "content": "Kubernetes Pod가 CrashLoopBackOff 상태일 때 디버깅 순서를 알려줘"
            }
        ]
    )
    
    print(response.choices[0].message.content)
    
    LLM API 자동화 개발 환경 — OpenAI, Anthropic, Google AI API 활용

    ▲ LLM API를 활용한 자동화 — 각 서비스의 SDK를 통해 인프라 운영 자동화에 통합할 수 있습니다.

    ⚠️ 실제로 겪은 주의사항 및 한계

    장밋빛 얘기만 하면 안 되죠. 직접 써보면서 느낀 한계도 솔직하게 공유할게요.

    할루시네이션(Hallucination, AI 환각) 문제

    세 가지 모두 가끔 틀린 정보를 자신 있게 말하는 경우가 있어요. 특히 최신 정보나 아주 구체적인 기술 스펙을 물어볼 때 주의해야 해요. 저도 한 번은 특정 오픈소스 도구의 설정 옵션을 물어봤다가 존재하지 않는 파라미터를 안내받아서 한참 삽질했습니다. 공식 문서와 교차 검증은 필수예요.

    데이터 최신성 한계

    각 모델마다 학습 데이터 컷오프(Knowledge Cutoff, 학습 데이터 기준 날짜)가 있어서, 그 이후에 출시된 도구나 버전에 대해서는 부정확할 수 있어요. “최신” 정보를 물어볼 때는 직접 공식 사이트를 확인하는 습관이 필요합니다.

    보안 및 데이터 프라이버시

    업무에서 쓸 때 제일 조심해야 할 부분이에요. 내부 코드, 고객 데이터, 기밀 정보는 절대 외부 AI 서비스에 입력하면 안 됩니다. 기업 환경에서는 각 서비스의 엔터프라이즈 플랜(데이터 학습 제외 옵션 포함)을 검토하거나, 온프레미스(On-premise, 자체 서버 운영) 배포 가능한 오픈소스 LLM을 고려해야 해요.

    비용 관리

    API를 자동화에 붙이다 보면 비용이 생각보다 빠르게 쌓여요. 토큰(Token, AI 언어 처리 단위) 사용량 모니터링과 예산 알림 설정은 꼭 해두세요. 저도 처음에 테스트 코드 잘못 돌렸다가 예상보다 많은 비용이 청구된 적 있었거든요 😅

    🎯 상황별 추천 정리

    그래서 결론적으로 어떤 상황에서 뭘 쓰면 좋냐고요? 제 경험 기반으로 정리해봤어요.

    상황 추천 도구 이유
    코드 생성 / 디버깅 ChatGPT (GPT-4o) 레퍼런스 많고, 코드 품질 안정적
    긴 문서 분석 / 요약 Claude (Sonnet/Opus) 넓은 컨텍스트 창, 정확한 내용 파악
    기술 문서 / 보고서 작성 Claude 자연스러운 문체, 균형 잡힌 답변
    이미지 분석 / 멀티모달 Gemini 또는 GPT-4o 멀티모달 처리 강점
    Google 생태계 통합 Gemini Workspace, GCP 연동 자연스러움
    LLM API 첫 도입 ChatGPT (OpenAI API) 커뮤니티 자료 가장 풍부
    RAG 기반 내부 문서 봇 Claude API 긴 컨텍스트 처리 안정적
    상황별 LLM 추천 가이드 — ChatGPT, Claude, Gemini 활용 사례 비교 인포그래픽

    ▲ 상황별 LLM 선택 가이드 — 어떤 도구도 모든 면에서 완벽하지 않습니다. 상황에 맞게 선택하는 게 핵심이에요.

    ❓ 자주 묻는 질문 (FAQ)

    Q. 하나만 써야 한다면 뭘 골라야 하나요?
    범용으로는 ChatGPT GPT-4o를 추천합니다. 코드도 되고, 문서도 되고, 이미지도 되고, 커뮤니티 자료도 제일 많아서 처음 시작하기에 좋아요.
    Q. 무료로 쓸 수 있나요?
    세 가지 모두 무료 플랜이 있어요. 다만 무료 플랜에서는 최신/고성능 모델 접근이 제한되거나 사용량 제한이 있어요. 업무용으로 제대로 쓰려면 유료 플랜이 필요한 경우가 많습니다.
    Q. 회사 내부 코드를 AI에 넣어도 되나요?
    원칙적으로는 사내 보안 정책 확인이 먼저입니다. 각 서비스의 엔터프라이즈 플랜에서는 입력 데이터를 학습에 사용하지 않는 옵션을 제공하는 경우가 있어요. 확인 전까지는 민감 정보 입력을 피하세요.
    Q. API 비용이 얼마나 드나요?
    사용량에 따라 크게 달라서 딱 말씀드리기 어렵고, 각 서비스 공식 페이지의 Pricing 페이지에서 최신 가격을 확인하시는 게 정확합니다. 토큰당 과금이라 사용 패턴에 따라 차이가 커요.

    🎉 마무리: 도구는 도구일 뿐, 판단은 내가

    13년 동안 인프라 엔지니어 하면서 느낀 건데, 좋은 도구가 생겼을 때 제일 중요한 건 “이걸 어디에 쓸 것인가”를 판단하는 능력이에요. LLM도 마찬가지예요. ChatGPT, Claude, Gemini 모두 훌륭한 도구인데, 맹목적으로 믿으면 안 되고 결과물을 항상 검증하는 습관이 필요합니다.

    저는 요즘 이렇게 쓰고 있어요. 코드 초안은 ChatGPT, 긴 문서 분석이나 문서 작성은 Claude, Google Cloud 관련 작업은 Gemini. 상황에 따라 골라 쓰는 거죠. 하나에 올인하기보다 각각의 강점을 파악하고 조합해서 쓰는 게 실무에서 훨씬 효율적이더라고요.

    다음 글에서는 이 LLM들을 활용해서 실제로 내부 지식베이스 챗봇을 만드는 과정을 다룰 예정이에요. RAG(검색 증강 생성) 아키텍처 구성부터 온프레미스 배포까지 — 관심 있으신 분들은 RSS나 뉴스레터 구독해두시면 알림 받으실 수 있어요.

    혹시 실무에서 LLM 활용하면서 재밌는 경험이나 삽질 경험 있으신 분들, 댓글로 공유해주시면 좋겠어요. 저도 아직 배우는 중이라서 ㅎㅎ 같이 성장해요! 🚀