13년차의 서버실

서버, 인프라, 홈랩 기술 블로그

[태그:] 엣지 컴퓨팅

  • [k8s] MicroK8s 벤치마크: K3s와 엣지 환경 성능 비교 [실전 가이드]

    [k8s] MicroK8s 벤치마크: K3s와 엣지 환경 성능 비교 [실전 가이드]

    [인프라] MicroK8s 벤치마크: K3s와 엣지 환경 리소스 사용량 비교

    홈랩을 굴리다 보면 결국 한 번은 부딪히는 주제가 있습니다. 바로 MicroK8s 벤치마크를 어떻게 봐야 하느냐는 점이거든요. 저도 ARM 서버를 만지면서 처음엔 “둘 다 경량 쿠버네티스인데 뭐가 그렇게 다르지?” 싶었는데, 실제로 써보니까 꽤 차이가 있더라고요. 특히 엣지 컴퓨팅이나 소형 ARM 보드, 미니 PC처럼 자원이 넉넉하지 않은 환경에서는 이런 차이가 더 크게 체감됩니다.

    이번 글에서는 MicroK8s와 K3s 성능 비교를 단순한 스펙 나열이 아니라, 실제로 어떤 항목을 벤치마크해야 의미가 있는지 중심으로 정리해보겠습니다. 제가 직접 홈랩에서 테스트할 때 썼던 방식, 삽질했던 포인트, 그리고 해석할 때 조심해야 할 점까지 같이 적어볼게요.
    MicroK8s 벤치마크를 위한 엣지 환경 ARM 서버 아키텍처 다이어그램

    엣지 환경에서 경량 쿠버네티스를 비교하는 전체 구성을 한눈에 보여주는 이미지입니다.

    1. 왜 엣지 환경에서는 MicroK8s 벤치마크가 중요할까

    데이터센터에서는 CPU랑 메모리를 조금 더 쓰더라도 관리 편의성이 좋으면 넘어가는 경우가 많습니다. 근데 엣지에서는 얘기가 달라집니다. 1~2GB 메모리 차이, 디스크 I/O 초기화 시간, 컨트롤 플레인(control plane, 클러스터 제어 영역) 기동 속도 같은 게 꽤 민감하게 다가오거든요.

    쉽게 말해, 같은 Kubernetes(쿠버네티스, 컨테이너 오케스트레이션 플랫폼) 계열이라도 무엇을 기본으로 포함하느냐, 어떤 런타임을 묶어 배포하느냐, 초기 설치와 운영 자동화가 어디까지 되어 있느냐에 따라 체감 리소스 사용량이 달라집니다. 그래서 MicroK8s 벤치마크를 볼 때는 숫자 하나보다도 “어떤 조건에서 잰 숫자인가?”를 먼저 보셔야 합니다.

    2. MicroK8s와 K3s, 쉽게 말해 뭐가 다를까

    저도 처음엔 둘 다 그냥 작은 경량 쿠버네티스 배포판 정도로 이해했었는데요, 실제로는 운영 철학이 꽤 다릅니다.

    항목 MicroK8s K3s
    배포 성격 Canonical에서 제공하는 경량 쿠버네티스 배포판 Rancher 진영에서 시작된 경량 쿠버네티스 배포판
    설치 방식 snap 기반 설치가 대표적 단일 바이너리 중심 설치 경험이 간단한 편
    체감 특징 애드온(add-on, 부가 기능) 관리가 편함 가볍고 빠르게 올리기 좋음
    엣지 적합성 기능 일체감이 좋음 최소 자원 환경에서 선호되는 경우가 많음

    여기서 중요한 포인트! 경량 쿠버네티스라고 해서 무조건 가장 적은 메모리만 쓰는 제품을 고르면 끝은 아닙니다. 예를 들어 Ingress(인그레스, 외부 트래픽 진입점), DNS, StorageClass(스토리지 클래스, 동적 볼륨 정책) 같은 기본 기능을 나중에 붙이기 시작하면, 처음의 “가벼움”이 생각보다 금방 상쇄되거든요.

    3. MicroK8s 벤치마크는 무엇을 비교해야 의미가 있을까

    MicroK8s 벤치마크라고 검색하면 CPU, 메모리 그래프 하나 딱 보여주는 자료가 많은데요, 실무에서는 그걸로 판단하기 어렵습니다. 제가 실제로 비교할 때는 아래 항목을 기준으로 잡았습니다.

    • Idle resource usage(유휴 리소스 사용량): 아무 워크로드 없을 때 CPU와 메모리 사용량
    • Cold start time(콜드 스타트 시간): 설치 후 API 응답 가능 상태까지 걸리는 시간
    • Pod scheduling latency(파드 스케줄링 지연): 테스트 파드가 실제 Running 상태가 되기까지의 시간
    • Add-on overhead(부가 기능 오버헤드): DNS, Ingress, Metrics 추가 후 증가 폭
    • Disk footprint(디스크 점유): 설치 후 데이터 디렉터리 증가량

    사실 이 다섯 개만 잡아도 꽤 감이 옵니다. 특히 ARM 서버에서는 디스크 성능이 병목이 되는 경우가 많아서, 메모리만 보면 놓치는 게 많더라고요.

    4. 제가 홈랩에서 잡은 테스트 조건

    벤치마크는 조건 통제가 핵심입니다. 같은 하드웨어, 같은 OS 계열, 같은 컨테이너 이미지, 같은 측정 횟수로 맞춰야 비교가 그나마 공정해집니다. 저는 아래처럼 맞춰서 보는 편입니다.

    1. 테스트 대상 노드는 동일한 ARM 기반 장비 또는 동일 사양 미니 PC로 구성합니다.
    2. 운영체제는 같은 Ubuntu 계열로 맞춥니다.
    3. 백그라운드 서비스와 자동 업데이트는 측정 전 최대한 정리합니다.
    4. MicroK8s와 K3s는 각각 단일 노드로 먼저 비교합니다.
    5. 기본 상태와 add-on 활성화 상태를 따로 측정합니다.
    6. 각 측정은 3회 이상 반복해서 편차를 확인합니다.

    이 부분을 안 맞추면 진짜 헷갈립니다. 저도 처음엔 결과가 들쭉날쭉해서 한참 헤맸는데, 알고 보니 한쪽은 메트릭 수집기가 떠 있었고 다른 쪽은 아니더라고요. 삽질 좀 했습니다 ㅎㅎ

    5. 실전 구현: MicroK8s와 K3s 벤치마크 준비

    5-1. MicroK8s 설치와 기본 확인

    sudo snap install microk8s --classic
    sudo usermod -a -G microk8s $USER
    newgrp microk8s
    microk8s status --wait-ready
    microk8s kubectl get nodes -o wide

    MicroK8s는 snap 기반이라 설치 경험이 꽤 일관적입니다. 대신 snapd 상태나 채널(channel, 배포 트랙)에 따라 초기 준비 시간이 다르게 느껴질 수 있습니다.

    5-2. K3s 설치와 기본 확인

    curl -sfL https://get.k3s.io | sh -
    sudo kubectl get nodes -o wide
    sudo systemctl status k3s --no-pager

    K3s는 설치가 정말 간단합니다. 처음 써보면 “이렇게 빨리 올라온다고?” 싶은 느낌이 있어요. 엣지 환경에서 자주 언급되는 이유가 괜히 있는 게 아니더라고요.
    MicroK8s 벤치마크와 K3s 성능 비교를 위한 단일 노드 설치 상태 이미지

    단일 노드 환경에서 두 배포판의 설치 직후 상태를 비교하는 장면을 보여주는 이미지입니다.

    5-3. 공통 워크로드 배포

    apiVersion: apps/v1
    kind: Deployment
    metadata:
      name: nginx-bench
    spec:
      replicas: 3
      selector:
        matchLabels:
          app: nginx-bench
      template:
        metadata:
          labels:
            app: nginx-bench
        spec:
          containers:
          - name: nginx
            image: nginx:stable
            ports:
            - containerPort: 80
    ---
    kubectl apply -f nginx-bench.yaml
    kubectl get pods -w

    여기서는 복잡한 앱보다 단순한 워크로드가 낫습니다. 이유는 비교 대상을 경량 쿠버네티스 배포판 자체로 최대한 좁혀야 하기 때문입니다.

    5-4. 유휴 리소스와 파드 상태 측정

    free -h
    vmstat 1 5
    ps aux --sort=-%mem | head
    kubectl get pods -A
    kubectl top nodes
    kubectl top pods -A

    Metrics Server(메트릭 서버, 리소스 수집 컴포넌트)가 없는 상태라면 kubectl top이 바로 안 될 수 있습니다. 이때는 OS 레벨 지표와 함께 보셔야 합니다.

    6. ⚠️ 실제로 겪었던 문제와 트러블슈팅

    6-1. 애드온 차이 때문에 공정 비교가 안 되는 문제

    이게 제일 흔합니다. MicroK8s는 add-on 활성화가 쉽고, K3s는 기본 구성이 상대적으로 간결한 편이라 시작점이 다를 수 있거든요. 그래서 기본 설치 상태와 필수 기능 포함 상태를 따로 비교해야 합니다.

    microk8s enable dns ingress metrics-server
    kubectl get pods -A

    혹시 이런 경험 있으신가요? “왜 MicroK8s가 더 무겁지?” 하고 봤더니 사실 기능이 더 많이 켜져 있었던 겁니다.

    6-2. ARM 서버에서 스토리지 지연 때문에 체감이 달라지는 문제

    특히 SD 카드나 느린 eMMC 기반 장비에서는 API 응답보다 이미지 풀(image pull, 컨테이너 이미지 다운로드)과 파일 시스템 동기화가 더 큰 변수였습니다. 그래서 이미지를 미리 받아둔 상태와 처음 내려받는 상태를 분리해서 봐야 해요.

    6-3. 첫 부팅과 재부팅 후 상태가 다른 문제

    처음엔 이게 뭔가 싶었는데, 재부팅 후 서비스 재기동 순서와 캐시 영향으로 결과가 다르게 나오더라고요. 그래서 가능하면 아래처럼 측정 구간을 분리하는 게 좋습니다.

    • 설치 직후 측정
    • 재부팅 후 안정화 뒤 측정
    • 워크로드 배포 후 측정

    7. 검증과 결과 해석: 숫자보다 패턴을 보셔야 합니다

    제가 여러 번 비교해보면서 느낀 패턴은 이렇습니다. K3s는 초기 설치와 기동이 간결하게 느껴지고, MicroK8s는 기능 통합과 관리 편의성이 좋다는 점입니다. 그리고 K3s 성능 비교 자료를 볼 때 자주 나오는 “더 가볍다”는 평은, 대체로 최소 구성 기준에서 이해하면 맞습니다.

    반대로 실서비스에 가까운 구성으로 DNS, Ingress, 모니터링 관련 요소를 하나씩 붙이기 시작하면, 단순 메모리 숫자만으로는 승부가 잘 안 나기도 합니다. 여기서 중요한 건 운영 편의성 대비 리소스 비용입니다. CPU 몇 퍼센트, 메모리 몇백 MB보다도 내가 관리하면서 덜 고생하는 쪽이 전체 비용은 더 낮을 수 있거든요.
    MicroK8s 벤치마크 결과를 보여주는 CPU 메모리 대시보드 이미지

    유휴 상태와 워크로드 배포 후 상태를 비교하는 벤치마크 대시보드 이미지입니다.

    비교 관점 MicroK8s에서 보기 좋은 점 K3s에서 보기 좋은 점
    초기 셋업 애드온 중심 운영이 편함 빠르고 단순하게 시작 가능
    리소스 민감 환경 기능 포함 시 구성 일관성 확보 최소 구성에서 부담이 적은 편
    실험/홈랩 여러 기능을 켜보며 배우기 좋음 가볍게 여러 노드 실험하기 좋음
    운영 판단 기준 기능 통합성 경량성과 단순성

    즉, MicroK8s 벤치마크 결과를 해석할 때는 “기본 상태 비교인지”, “실제 운영 기능 포함 비교인지”를 꼭 구분하셔야 합니다.

    8. 어떤 환경에 무엇을 고르면 좋을까

    • 초소형 엣지 노드나 아주 타이트한 리소스 환경이면 K3s 쪽이 출발이 편할 가능성이 큽니다.
    • 학습, 홈랩, 기능 실험을 자주 하신다면 MicroK8s의 add-on 경험이 꽤 편합니다.
    • ARM 서버를 여러 대 운영하면서 자동화까지 보실 거라면 설치 이후 운영 스크립트와 모니터링 방식까지 같이 검토하셔야 합니다.

    저는 개인적으로 “최소 자원 + 빠른 프로비저닝”이 우선이면 K3s를 먼저 보고, “기능 포함 상태에서 일관된 운영 경험”이 중요하면 MicroK8s를 먼저 봅니다. 둘 중 하나가 절대적으로 우월하다기보다, 우선순위가 다르다고 보는 게 맞더라고요.

    9. 정리와 다음 단계

    정리해보면, MicroK8s 벤치마크는 단순히 누가 더 메모리를 덜 먹느냐로 끝나지 않습니다. 엣지 환경에서는 설치 방식, 애드온 구조, 스토리지 특성, 재부팅 후 복구 속도, 그리고 운영 중 손이 얼마나 가는지가 다 같이 중요합니다. 제가 직접 해보니 숫자 하나보다 패턴이 더 중요했고, 특히 비교 조건을 통일하는 게 절반이더라고요.

    다음 글에서는 실제 홈랩 기준으로 Prometheus(프로메테우스, 메트릭 수집 시스템)와 Grafana(그라파나, 시각화 도구)를 붙여서 MicroK8s와 K3s의 장기 모니터링 방법도 다뤄볼 예정입니다. 이전 글에서 다뤘던 홈랩 네트워크 설계 내용과도 연결해서 보시면 더 이해가 쉬우실 겁니다.
    MicroK8s 벤치마크와 K3s 선택 기준을 요약한 인포그래픽

    어떤 조건에서 어떤 배포판이 더 잘 맞는지 한 장으로 정리한 요약 이미지입니다.

    자주 묻는 질문

    Q1. MicroK8s와 K3s 중 뭐가 무조건 더 빠른가요?

    무조건이라고 말하긴 어렵습니다. 최소 구성에서는 K3s가 가볍게 느껴지는 경우가 많지만, 운영 기능을 붙인 뒤에는 비교 조건에 따라 달라집니다.

    Q2. 엣지 컴퓨팅에서는 무엇을 먼저 봐야 하나요?

    CPU보다도 메모리, 디스크 I/O, 재기동 안정성을 먼저 보시는 걸 권장합니다. 특히 느린 저장장치에서는 체감 차이가 크게 납니다.

    Q3. 홈랩 입문자는 무엇으로 시작하면 좋을까요?

    기능을 빨리 배우고 싶으면 MicroK8s, 아주 가볍게 여러 노드를 올려보고 싶으면 K3s가 편할 수 있습니다.
  • [k8s] k3s와 MicroK8s 비교: 경량 쿠버네티스 환경 선택 가이드

    경량 쿠버네티스, 왜 지금 이 선택이 중요한가요?

    홈랩을 운영하다 보면 꼭 한 번씩 마주치는 고민이 있어요. “쿠버네티스(Kubernetes)는 써보고 싶은데, 풀스택 k8s를 올리기엔 서버가 너무 작다…” 저도 딱 그랬거든요. 라즈베리파이(Raspberry Pi) 클러스터 위에 뭔가 올려보려고 했는데, 일반 쿠버네티스는 메모리만 수 GB를 잡아먹으니 엄두가 안 나더라고요.

    그래서 찾게 된 게 경량 쿠버네티스(Lightweight Kubernetes)입니다. 그중에서도 현재 가장 많이 언급되는 두 가지가 바로 k3s와 MicroK8s예요. 이 둘, 뭐가 다른지 처음엔 저도 진짜 헷갈렸습니다. 이름도 비슷하고 목적도 비슷한 것 같고… 근데 실제로 써보면 꽤 다르거든요.

    이번 글에서는 제가 직접 두 솔루션을 홈랩에서 돌려보면서 느낀 점, 그리고 어떤 상황에서 어떤 걸 선택해야 하는지 정리해 드릴게요. 엣지 컴퓨팅(Edge Computing) 환경이나 라즈베리파이 쿠버네티스 구성을 고민 중이신 분들께 특히 도움이 될 거예요.

    k3s와 MicroK8s의 전체 아키텍처 구조를 한눈에 비교한 다이어그램. 각각의 구성 요소와 설계 철학의 차이를 보여줍니다.


    k3s와 MicroK8s, 각각 어떤 녀석인가요?

    k3s — “진짜 가볍게 만들어 버렸다”

    k3s는 Rancher Labs(현재 SUSE)에서 만든 경량 쿠버네티스 배포판입니다. 공식 CNCF(Cloud Native Computing Foundation) 인증 프로젝트이기도 해요. 핵심 철학은 딱 하나예요. “싱글 바이너리(single binary)로 모든 걸 해결하자.”

    쉽게 말해, etcd(이티시디, 쿠버네티스의 상태 저장소) 대신 기본적으로 SQLite를 쓰고, 불필요한 컴포넌트를 싹 쳐냈어요. 덕분에 바이너리 하나가 약 100MB 남짓이고, 메모리도 정말 적게 씁니다. 라즈베리파이 같은 저사양 ARM 기기에서도 잘 돌아가는 이유가 여기 있어요.

    • 단일 바이너리로 설치 및 실행
    • 기본 데이터스토어: SQLite (고가용성 구성 시 etcd 또는 외부 DB 사용 가능)
    • ARM 아키텍처 공식 지원 (라즈베리파이 최적)
    • Flannel(플란넬) CNI 기본 내장
    • Traefik(트래픽) Ingress Controller 기본 포함
    • CNCF 공식 인증 쿠버네티스

    MicroK8s — “Ubuntu 생태계에서 편하게”

    MicroK8s는 Canonical(캐노니컬, Ubuntu 만드는 회사)에서 만든 경량 쿠버네티스예요. 설치 방식이 좀 독특한데, Snap(스냅) 패키지 매니저를 통해 설치합니다. Ubuntu 환경이라면 진짜 설치가 간단해요.

    k3s와 달리 MicroK8s는 애드온(addon) 시스템이 핵심이에요. 기본 설치는 가볍게 하고, 필요한 기능(DNS, 대시보드, Ingress, 스토리지 등)을 명령어 하나로 활성화하는 방식이거든요. 개발 환경이나 Ubuntu 서버에서 빠르게 쿠버네티스를 시험해보고 싶을 때 특히 편합니다.

    • Snap 패키지로 설치 (Ubuntu/Linux 최적화)
    • 애드온 시스템으로 필요한 기능만 활성화
    • 단일 노드 개발 환경에 강점
    • Canonical의 지원 및 업스트림 쿠버네티스와 빠른 동기화
    • ARM 지원 (단, k3s 대비 리소스 사용량이 다소 높음)

    k3s vs MicroK8s 핵심 스펙 비교

    말로만 하면 헷갈리니까 표로 정리해 봤어요. 제가 직접 테스트하면서 확인한 내용 위주입니다.

    항목 k3s MicroK8s
    개발사 Rancher Labs / SUSE Canonical (Ubuntu)
    설치 방식 curl 스크립트 / 단일 바이너리 Snap 패키지
    기본 데이터스토어 SQLite (소규모) / etcd 선택 가능 dqlite (분산 SQLite)
    기본 CNI Flannel Calico (기본 활성화)
    Ingress 기본 포함 Traefik (기본 활성화) nginx (애드온으로 활성화)
    ARM 지원 매우 우수 (라즈베리파이 최적) 지원 (단, x86 최적화)
    멀티노드 클러스터 매우 간단 가능 (설정 다소 복잡)
    CNCF 인증 ✅ 인증 ✅ 인증
    주요 사용 환경 엣지, IoT, 라즈베리파이, 프로덕션 경량화 개발/테스트, Ubuntu 서버, 단일 노드
    OS 의존성 낮음 (대부분의 Linux 지원) 높음 (Snap 지원 OS 필요)

    💡 핵심 포인트: 둘 다 CNCF 공식 인증을 받은 쿠버네티스예요. 즉, 표준 kubectl 명령어와 YAML 매니페스트가 그대로 동작합니다. “이거 진짜 쿠버네티스 맞아?” 걱정 안 하셔도 돼요.


    k3s 설치: 진짜 이렇게 간단해도 되나?

    처음 k3s를 설치했을 때 솔직히 당황했어요. 너무 간단해서요. “이게 다야?” 싶었거든요. 라즈베리파이 OS나 Ubuntu 기준으로 설명드릴게요.

    마스터 노드(서버) 설치

    # k3s 서버(마스터 노드) 설치 — 딱 한 줄입니다
    curl -sfL https://get.k3s.io | sh -
    
    # 설치 완료 후 상태 확인
    sudo systemctl status k3s
    
    # 노드 상태 확인
    sudo kubectl get nodes

    이게 전부예요. 진짜로요. 스크립트가 k3s 바이너리를 받아서 systemd 서비스로 등록까지 해줍니다. 설치 후 1~2분 기다리면 노드가 Ready 상태가 돼요.

    워커 노드(에이전트) 추가

    # 마스터 노드에서 토큰 확인
    sudo cat /var/lib/rancher/k3s/server/node-token
    
    # 워커 노드에서 실행 (K3S_TOKEN과 서버 IP를 바꿔주세요)
    curl -sfL https://get.k3s.io | K3S_URL=https://마스터노드IP:6443 \
      K3S_TOKEN=여기에토큰값 sh -

    라즈베리파이 3대로 클러스터 구성할 때 이 명령어로 10분 만에 끝냈어요. 삽질 없이요. 😄

    kubeconfig 설정 (로컬 PC에서 접속)

    # 마스터 노드에서 kubeconfig 복사
    sudo cat /etc/rancher/k3s/k3s.yaml
    
    # 로컬 PC의 ~/.kube/config 에 붙여넣기
    # server: https://127.0.0.1:6443 부분을 실제 서버 IP로 변경
    # 예: server: https://192.168.1.100:6443

    ⚠️ 주의: k3s.yaml 파일의 server 주소가 기본적으로 127.0.0.1로 돼 있어요. 원격 접속할 때 반드시 실제 IP로 바꿔줘야 합니다. 이거 놓치면 “connection refused” 보면서 한참 헤맬 수 있어요. 저도 한 30분 고생했었습니다 ㅎㅎ


    MicroK8s 설치: Ubuntu라면 이게 편할 수도

    MicroK8s는 Ubuntu 환경이라면 진짜 편해요. Snap으로 설치하니까요. 다만 Snap이 없는 OS에서는 좀 번거로울 수 있습니다.

    설치 및 기본 설정

    # MicroK8s 설치 (Ubuntu 기준)
    sudo snap install microk8s --classic
    
    # 현재 사용자를 microk8s 그룹에 추가 (sudo 없이 사용하려면 필수)
    sudo usermod -aG microk8s $USER
    newgrp microk8s
    
    # 상태 확인
    microk8s status --wait-ready
    
    # kubectl 사용 (microk8s.kubectl 또는 alias 설정)
    microk8s kubectl get nodes
    
    # 편하게 쓰려면 alias 등록
    alias kubectl='microk8s kubectl'

    애드온 활성화 — 이게 MicroK8s의 핵심이에요

    # DNS 활성화 (거의 필수)
    microk8s enable dns
    
    # 대시보드 활성화
    microk8s enable dashboard
    
    # Ingress 컨트롤러 활성화
    microk8s enable ingress
    
    # 스토리지(hostpath) 활성화
    microk8s enable hostpath-storage
    
    # 여러 개 한 번에 활성화
    microk8s enable dns dashboard ingress hostpath-storage
    
    # 활성화된 애드온 확인
    microk8s status

    MicroK8s의 애드온 시스템과 k3s 멀티노드 클러스터 구성 화면. 각각의 설치 및 설정 방식의 차이를 보여줍니다.

    MicroK8s 멀티노드 클러스터 구성

    # 마스터 노드에서 조인 토큰 생성
    microk8s add-node
    
    # 출력된 명령어를 워커 노드에서 실행 (예시)
    # microk8s join 192.168.1.100:25000/토큰값/해시값

    k3s보다 조금 더 손이 가긴 하지만, 출력된 명령어를 그대로 복붙하면 돼서 어렵진 않아요.


    ⚠️ 실제로 써보면서 만난 문제들

    둘 다 써보면서 “아, 이거 주의해야 하는구나” 싶었던 것들 솔직하게 공유할게요.

    k3s에서 자주 만나는 문제들

    • 라즈베리파이 cgroup 설정: 라즈베리파이 OS에서 k3s 실행 시 cgroup(컨트롤 그룹, 리소스 제어 메커니즘) 설정이 안 돼 있으면 노드가 NotReady 상태로 뜹니다. /boot/cmdline.txt (또는 /boot/firmware/cmdline.txt)에 cgroup_enable=cpuset cgroup_enable=memory cgroup_memory=1를 추가하고 재부팅해야 해요.
    • Traefik vs 내 Ingress 충돌: k3s는 Traefik을 기본으로 깔아줘요. 근데 nginx Ingress를 따로 쓰고 싶다면 k3s 설치 시 --disable traefik 옵션을 줘야 합니다. 나중에 충돌 나면 진짜 원인 찾기 어렵거든요.
    • 방화벽 포트: 멀티노드 구성 시 6443(API 서버), 8472(Flannel VXLAN), 10250(kubelet) 포트가 열려있어야 해요. UFW 켜놓고 왜 에이전트가 안 붙나 한참 봤던 경험이 있어요.

    MicroK8s에서 자주 만나는 문제들

    • Snap 업데이트 자동 재시작: Snap 패키지 특성상 자동 업데이트가 되면서 MicroK8s가 재시작되는 경우가 있어요. 프로덕션에서 쓴다면 sudo snap refresh --hold microk8s로 자동 업데이트를 잠시 홀드해두는 게 좋습니다.
    • Snap 미지원 OS: CentOS나 일부 최소화 배포판에서는 Snap 자체가 없어서 설치가 번거로워요. 이런 환경에선 k3s가 훨씬 편합니다.
    • DNS 애드온 활성화 순서: 다른 애드온보다 DNS를 먼저 활성화해야 해요. 순서 안 지키면 파드 간 통신이 안 되는 경우가 있더라고요.

    💡 공통 팁: 두 솔루션 모두 kubectl 명령어는 동일하게 사용할 수 있어요. 한쪽에서 작성한 YAML 매니페스트를 다른 쪽에서 그대로 apply해도 됩니다. 그 점은 진짜 편하더라고요.


    간단한 애플리케이션 배포로 검증해보기

    설치만 하고 끝내면 아쉽죠. 간단한 nginx 파드를 배포해서 정상 동작을 확인해 봅시다. 두 솔루션 모두 동일한 YAML로 테스트할 수 있어요.

    # nginx-test.yaml
    apiVersion: apps/v1
    kind: Deployment
    metadata:
      name: nginx-test
      labels:
        app: nginx-test
    spec:
      replicas: 2
      selector:
        matchLabels:
          app: nginx-test
      template:
        metadata:
          labels:
            app: nginx-test
        spec:
          containers:
          - name: nginx
            image: nginx:stable
            ports:
            - containerPort: 80
    ---
    apiVersion: v1
    kind: Service
    metadata:
      name: nginx-test-svc
    spec:
      selector:
        app: nginx-test
      ports:
      - port: 80
        targetPort: 80
      type: NodePort
    # 배포
    kubectl apply -f nginx-test.yaml
    
    # 파드 상태 확인 (Running이 되어야 정상)
    kubectl get pods -o wide
    
    # 서비스 확인 (NodePort 번호 확인)
    kubectl get svc nginx-test-svc
    
    # 접속 테스트 (NodePort 번호는 위에서 확인한 번호로)
    curl http://노드IP:NodePort번호

    “Welcome to nginx!” 가 뜨면 성공입니다! 🎉 이 YAML은 k3s든 MicroK8s든 동일하게 동작해요.

    kubectl get nodes와 get pods 명령어로 확인한 클러스터 정상 동작 결과. 두 노드 모두 Ready 상태이며 파드가 Running 중인 것을 확인할 수 있습니다.


    결국 뭘 골라야 할까? — 상황별 선택 가이드

    “그래서 뭐 써요?”라는 질문을 제일 많이 받아요. 솔직히 말씀드리면, 상황에 따라 달라요. 제가 정리한 선택 기준 공유해 드릴게요.

    k3s를 선택해야 하는 경우

    • ✅ 라즈베리파이나 ARM 기기를 사용하는 경우 — k3s가 압도적으로 유리해요
    • ✅ 엣지 컴퓨팅, IoT 환경 — 리소스가 제한적인 환경에서의 프로덕션 배포
    • ✅ 멀티노드 클러스터를 빠르게 구성해야 할 때
    • ✅ Ubuntu 외 OS(CentOS, Debian, Alpine 등)를 사용하는 경우
    • ✅ CI/CD 파이프라인에 경량 쿠버네티스 환경이 필요할 때
    • ✅ Snap을 쓰기 싫거나 쓸 수 없는 환경

    MicroK8s를 선택해야 하는 경우

    • ✅ Ubuntu 서버/데스크탑이 주 환경인 경우 — 설치와 관리가 정말 편해요
    • ✅ 로컬 개발/테스트 환경 — 단일 노드에서 빠르게 시험해볼 때
    • ✅ 애드온 시스템이 매력적인 경우 — 필요한 기능을 명령어 하나로 켜고 끄고 싶을 때
    • ✅ Canonical 생태계와 통합이 필요한 경우 (Ubuntu Pro, Landscape 등)
    • ✅ 업스트림 쿠버네티스 최신 버전을 빠르게 따라가고 싶을 때

    제 개인적인 결론

    저는 홈랩에서 라즈베리파이 클러스터는 k3s, x86 Ubuntu 서버에서 빠른 테스트는 MicroK8s를 씁니다. 둘 다 훌륭한 도구예요. 어느 쪽을 선택하든 “진짜 쿠버네티스”를 배울 수 있고, 나중에 풀스택 k8s로 넘어가도 배운 게 그대로 써먹힙니다.

    k3s와 MicroK8s 상황별 선택 가이드 요약. 사용 환경, 목적, OS에 따른 최적의 선택을 한눈에 정리한 인포그래픽입니다.


    자주 묻는 질문 (FAQ)

    Q. k3s와 MicroK8s는 실제 쿠버네티스랑 호환되나요?

    네, 둘 다 CNCF 공식 인증을 받은 쿠버네티스입니다. 표준 kubectl 명령어와 YAML 매니페스트가 그대로 동작하고, Helm 차트도 사용할 수 있어요.

    Q. 라즈베리파이 4에서 어느 쪽이 더 잘 돌아가나요?

    k3s가 더 유리합니다. ARM 아키텍처 최적화가 잘 돼 있고, 메모리 사용량도 더 적어요. MicroK8s도 ARM을 지원하지만, 라즈베리파이 환경에서는 k3s가 훨씬 검증이 잘 돼 있습니다.

    Q. 나중에 풀스택 쿠버네티스로 마이그레이션하기 어렵나요?

    애플리케이션 레벨(YAML 매니페스트, Helm 차트)은 그대로 이전할 수 있어요. 다만 스토리지 클래스나 네트워크 플러그인 설정은 환경에 맞게 다시 잡아줘야 합니다. 어렵다기보다는 손이 좀 가는 작업이에요.

    Q. 프로덕션 환경에서 써도 되나요?

    k3s는 실제로 엣지 컴퓨팅, 리테일, 제조업 현장 등 다양한 프로덕션 환경에서 사용되고 있습니다. 고가용성(HA) 구성도 지원해요. MicroK8s도 프로덕션 사용이 가능하지만, 일반적으로 개발/테스트 환경에서 더 많이 쓰이는 경향이 있습니다.


    마무리: 일단 설치해 보세요

    k3s와 MicroK8s 비교, 어떠셨나요? 사실 이 글을 쓰면서 다시 한번 느낀 건데, 이 두 도구 모두 “쿠버네티스 진입 장벽을 낮추자”는 목표 하나는 정말 잘 달성했어요. 예전엔 쿠버네티스 클러스터 하나 올리는 데 반나절씩 걸렸는데, 지금은 30분이면 충분하니까요.

    제 추천은 간단해요. 라즈베리파이나 ARM 기기, 또는 멀티노드 엣지 환경이라면 k3s, Ubuntu 서버에서 빠르게 개발/테스트하고 싶다면 MicroK8s. 고민이 길어지면 일단 k3s로 시작해보세요. 단일 명령어 설치에 문서도 풍부하거든요.

    다음 글에서는 k3s 위에 Helm(헬름, 쿠버네티스 패키지 매니저)과 ArgoCD(아르고시디, GitOps 배포 도구)를 올려서 홈랩 GitOps 파이프라인을 구성하는 내용을 다뤄볼 예정입니다. 경량 쿠버네티스를 설치했으면, 이제 그 위에 뭔가를 올려야죠! 🚀

    혹시 설치하다가 막히는 부분이 있으시면 댓글로 남겨주세요. 제가 겪어본 삽질이라면 같이 풀어드릴 수 있을 것 같아요. 😄

  • [k8s] k3s로 경량 쿠버네티스 클러스터 구축: 홈랩과 엣지 완벽 가이드

    [k8s] k3s로 경량 쿠버네티스 클러스터 구축: 홈랩과 엣지 완벽 가이드

    k3s로 경량 쿠버네티스 클러스터 구축하기: 13년차 엔지니어의 삽질 완전 정복

    안녕하세요, 13년차의 서버실 주인장입니다. 오늘은 제가 최근 홈랩에서 직접 구축해보고, 엣지 컴퓨팅 환경에서도 정말 유용하겠다 싶었던 기술, k3s(케이쓰리 에스)에 대해 이야기해보려고 해요. 기존 쿠버네티스(Kubernetes)는 아무래도 무겁고 복잡해서 홈랩이나 리소스가 제한적인 엣지 환경에 도입하기가 쉽지 않았거든요. 근데 k3s를 만나고 나서 생각이 확 바뀌었습니다. 가볍고 빠르면서도 쿠버네티스의 강력한 기능을 고스란히 쓸 수 있다는 게 정말 매력적이더라고요!

    저도 처음엔 이게 뭔가 싶었는데, 실제로 써보니까 ‘아, 이거 진짜 물건이다!’ 싶었습니다. 제 경험을 바탕으로 k3s 경량 쿠버네티스를 활용해서 클러스터를 어떻게 구축하는지, 그리고 어떤 삽질을 겪었고 어떻게 해결했는지 솔직하게 공유해볼게요. 특히 엣지 컴퓨팅(Edge Computing)이나 저처럼 홈랩(Home Lab)을 운영하는 분들께 큰 도움이 될 거라 생각합니다.

    💡 k3s, 왜 선택했을까? 경량 쿠버네티스의 진짜 매력

    혹시 이런 경험 있으신가요? 작은 라즈베리 파이(Raspberry Pi)나 오래된 미니 PC에 k3s를 포함한 쿠버네티스를 올려보고 싶었는데, 리소스 문제나 복잡한 설치 과정 때문에 포기했던 경험 말이죠. 저도 그랬거든요. 일반적인 쿠버네티스 배포판은 마스터 노드(Master Node) 하나만 해도 꽤 많은 메모리와 CPU를 요구합니다. 그런데 k3s는 이런 제약을 확 낮춰줍니다. 말 그대로 ‘경량(Lightweight)’ 쿠버네티스죠.

    k3s는 Rancher Labs에서 개발한 CNCF(Cloud Native Computing Foundation) 샌드박스 프로젝트로, 리소스가 제한적인 환경, 예를 들면 IoT 디바이스, 엣지 서버, 그리고 저의 사랑스러운 홈랩 같은 곳에 최적화되어 있습니다. 바이너리 파일 하나로 설치가 끝나고, 필요 없는 기능들을 쳐내서 메모리 사용량도 훨씬 적어요. 제가 직접 해보니, 512MB RAM 이상이면 마스터 노드를 구동할 수 있더라고요! 정말 놀랍지 않습니까? 🎉

    k3s 경량 쿠버네티스 클러스터의 간소화된 아키텍처 다이어그램: 마스터 노드와 여러 워커 노드가 연결되어 엣지 및 홈랩 환경에서 효율적으로 동작하는 모습을 보여줍니다.

    k3s 기본 이해: 경량 쿠버네티스의 핵심 개념

    쉽게 말해 k3s는 쿠버네티스(Kubernetes)의 모든 핵심 기능을 제공하면서도, 배포판을 경량화한 버전입니다. k3s는 기존 쿠버네티스가 제공하는 API Server, Controller Manager, Scheduler, etcd 같은 핵심 컴포넌트들을 모두 포함하고 있어요. 하지만 몇 가지 차이점이 있습니다.

    • 단일 바이너리(Single Binary): 설치 파일이 하나로 되어 있어 배포가 정말 간편합니다.
    • SQLite3 내장(Embedded SQLite3): 기본적으로 외부 etcd 대신 SQLite3를 데이터 저장소로 사용합니다. 물론 PostgreSQL, MySQL, etcd 등 외부 DB도 연결할 수 있어요.
    • 불필요한 기능 제거: 레거시(Legacy) 코드나 클라우드 제공업체(Cloud Provider) 관련 기능을 제거하여 경량화했습니다.
    • 컨테이너 런타임(Container Runtime) 변경: 도커(Docker) 대신 containerd(컨테이너디)를 기본 컨테이너 런타임으로 사용합니다.

    이런 특징들 덕분에 k3s는 일반적인 쿠버네티스에 비해 설치도 빠르고 리소스 소모도 적어서, 소규모 프로젝트나 학습용, 그리고 저처럼 홈랩에서 다양한 실험을 해보고 싶을 때 최적의 선택이 됩니다. 컨테이너 오케스트레이션(Container Orchestration)이라는 쿠버네티스의 핵심 개념은 그대로 가져가면서도, 훨씬 쉽게 접근할 수 있게 해주는 거죠.

    실전! k3s 경량 쿠버네티스 클러스터 구축 스텝별 가이드

    자, 이제 직접 k3s 클러스터를 구축해볼 시간입니다. 저는 라즈베리 파이 4B 두 대와 오래된 미니 PC 한 대를 이용해서 클러스터를 만들어봤어요. OS는 모두 Ubuntu Server 22.04 LTS를 사용했습니다. 여러분도 리눅스(Linux) 기반의 어떤 장비든 준비하시면 됩니다.

    1. k3s 마스터 노드(Server) 설치

    가장 먼저 클러스터의 ‘뇌’ 역할을 할 마스터 노드를 설치합니다. k3s는 정말 설치가 간단해서 명령어 한 줄이면 끝나버려요. 💡 팁: 실제 운영 환경에서는 스크립트 내용을 확인하고 사용하는 것이 좋습니다.

    
    curl -sfL https://get.k3s.io | sh -
    

    이 명령어를 실행하면 k3s가 자동으로 설치되고 서비스로 등록되어 실행됩니다. 설치가 끝나면 제대로 작동하는지 확인해볼까요?

    
    sudo k3s kubectl get nodes
    

    기본적으로 k3s는 자체적으로 제공하는 k3s kubectl 명령어를 사용하도록 설정되어 있어요. 처음엔 조금 어색하지만 익숙해지니 괜찮더라고요. k3s가 정상적으로 설치되었다면 마스터 노드가 Ready 상태로 보일 겁니다. 예를 들면 이런 식이죠:

    
    NAME         STATUS   ROLES                  AGE   VERSION
    master-node   Ready    control-plane,master   2m    v1.28.3+k3s1
    

    2. k3s 워커 노드(Agent) 추가

    이제 마스터 노드에 연결할 워커 노드(Agent Node)를 추가해봅시다. 워커 노드 역시 명령어 한 줄로 설치되는데, 다만 마스터 노드와 연결하기 위한 토큰(Token)이 필요해요. 이 토큰은 마스터 노드에서 확인할 수 있습니다.

    
    sudo cat /var/lib/rancher/k3s/server/node-token
    

    이 명령어를 실행하면 긴 문자열이 나올 텐데, 이게 바로 워커 노드를 연결할 때 필요한 토큰입니다. 이 토큰과 마스터 노드의 IP 주소를 알고 있다면, 워커 노드에서 다음 명령어를 실행해주세요. <master-ip> 부분은 마스터 노드의 실제 IP 주소로, <token> 부분은 위에서 확인한 토큰으로 바꿔주셔야 합니다.

    
    curl -sfL https://get.k3s.io | K3S_URL=https://<master-ip>:6443 K3S_TOKEN=<token> sh -
    

    워커 노드 설치 후, 다시 마스터 노드에서 sudo k3s kubectl get nodes 명령어를 실행해보세요. 몇 분 뒤에 워커 노드가 Ready 상태로 보인다면 성공입니다! 🎉

    k3s 마스터 및 워커 노드 구성과 kubectl 환경 설정이 완료된 명령줄 인터페이스 스크린샷입니다.

    3. kubectl 환경 설정으로 편하게 사용하기

    매번 sudo k3s kubectl이라고 치는 게 귀찮으시죠? 저도 그랬거든요. 일반적인 kubectl 명령어를 사용할 수 있도록 환경 설정을 해봅시다. 마스터 노드에서 다음 명령어를 실행하여 kubeconfig 파일을 홈 디렉토리로 복사하고 환경 변수를 설정합니다.

    
    mkdir -p ~/.kube
    sudo cp /etc/rancher/k3s/k3s.yaml ~/.kube/config
    sudo chown $(id -u):$(id -g) ~/.kube/config
    chmod 600 ~/.kube/config
    export KUBECONFIG=~/.kube/config
    

    마지막 export 명령어는 현재 세션에만 적용되므로, 로그인할 때마다 자동으로 적용되게 하려면 .bashrc나 .zshrc 파일에 추가하는 것이 좋습니다. 이제 kubectl get nodes 명령어를 실행해보세요. 잘 동작할 겁니다!

    ⚠️ k3s 설치 중 만난 난관들 & 해결법

    제가 13년차 엔지니어라고 해도 삽질은 피할 수 없죠! k3s 설치 중 저를 괴롭혔던 몇 가지 문제와 해결법을 공유합니다. 혹시 여러분도 비슷한 문제를 겪는다면 참고가 되셨으면 좋겠어요.

    1. 워커 노드가 연결되지 않는 문제 (방화벽!)

      처음엔 마스터 노드와 워커 노드 간 통신이 안 되는 거예요. kubectl get nodes를 하면 워커 노드가 NotReady 상태로 계속 머물러 있었죠. 알고 보니 방화벽(Firewall) 문제였습니다. Ubuntu Server는 기본적으로 ufw(Uncomplicated Firewall)가 활성화되어 있는 경우가 많거든요. k3s는 기본적으로 6443/tcp 포트를 사용하는데, 이 포트가 막혀있었던 겁니다. 🤯

      해결법: 마스터 노드와 워커 노드 모두에서 필요한 포트를 열어줬습니다.

      
      sudo ufw allow 6443/tcp  # k3s API Server
      sudo ufw allow 10250/tcp # Kubelet (필수)
      sudo ufw reload
      

      특히 마스터 노드는 워커 노드의 Kubelet과 통신해야 하므로 10250 포트도 열어주는 것이 좋습니다. 이 문제를 해결하고 나니 워커 노드가 바로 Ready 상태로 바뀌더라고요. 역시 네트워크 문제는 언제나 기본부터 체크해야 합니다.

    2. 토큰(Token) 불일치로 인한 연결 실패

      간혹 워커 노드를 추가할 때 K3S_TOKEN 값을 잘못 입력하는 경우가 있어요. 아니면 복사 붙여넣기 할 때 공백이 들어간다거나요. 그럼 당연히 워커 노드가 마스터에 연결되지 않습니다.

      해결법: 워커 노드에서 k3s 서비스를 중지하고 삭제한 후, 정확한 토큰 값으로 다시 설치했습니다.

      
      sudo systemctl stop k3s-agent
      sudo systemctl disable k3s-agent
      sudo k3s-uninstall.sh # 워커 노드에 설치된 k3s 삭제 스크립트
      # 정확한 토큰으로 다시 설치
      curl -sfL https://get.k3s.io | K3S_URL=https://<master-ip>:6443 K3S_TOKEN=<correct-token> sh -
      
    3. 로그 확인의 중요성

      어떤 문제가 발생하든, 가장 먼저 해야 할 일은 로그를 확인하는 것입니다. k3s 서비스의 로그는 journalctl 명령어를 통해 볼 수 있어요.

      
      sudo journalctl -u k3s --since "10 minutes ago" -f
      # 워커 노드는
      sudo journalctl -u k3s-agent --since "10 minutes ago" -f
      

      로그를 보면 에러 메시지나 경고 메시지를 통해 문제의 원인을 파악할 수 있는 경우가 많습니다. 저는 방화벽 문제도 로그에서 connection refused 같은 메시지를 보고 눈치챘거든요.

    🎉 완성! k3s 클러스터에 애플리케이션 배포하기

    클러스터가 성공적으로 구축되었다면, 이제 간단한 애플리케이션을 배포해서 잘 동작하는지 확인해봐야죠. 저는 웹 서버로 유명한 Nginx(엔진엑스)를 배포해볼게요. 다음 YAML 파일을 nginx-deployment.yaml로 저장합니다.

    
    apiVersion: apps/v1
    kind: Deployment
    metadata:
      name: nginx-deployment
      labels:
        app: nginx
    spec:
      replicas: 2
      selector:
        matchLabels:
          app: nginx
      template:
        metadata:
          labels:
            app: nginx
        spec:
          containers:
          - name: nginx
            image: nginx:latest
            ports:
            - containerPort: 80
    ---
    apiVersion: v1
    kind: Service
    metadata:
      name: nginx-service
    spec:
      selector:
        app: nginx
      ports:
        - protocol: TCP
          port: 80
          targetPort: 80
      type: NodePort
    

    저장한 파일을 클러스터에 배포합니다.

    
    kubectl apply -f nginx-deployment.yaml
    

    배포가 성공적으로 완료되었다면, 파드(Pod)와 서비스(Service)가 잘 생성되었는지 확인해봅시다.

    
    kubectl get pods -o wide
    kubectl get svc
    

    kubectl get svc 결과에서 nginx-service의 NodePort를 확인해보세요. 예를 들어 30000번대 포트가 할당될 겁니다. 이제 워커 노드의 IP 주소와 할당된 NodePort를 이용하여 웹 브라우저에서 Nginx 웹 페이지에 접속할 수 있습니다. 예를 들어, http://<워커-노드-IP>:<NodePort> 이런 식으로요. 드디어 제 홈랩 k3s 클러스터에서 Nginx가 동작하는 걸 보니 정말 뿌듯하더라고요! 🎉

    k3s 클러스터에 Nginx 애플리케이션 배포 후 웹 브라우저 접속 화면 및 kubectl 명령 결과를 보여주는 스크린샷입니다.

    🚀 13년차 엔지니어의 제언: k3s 경량 쿠버네티스 활용처

    k3s를 직접 구축하고 사용해보니, 이 경량 쿠버네티스가 얼마나 유용한지 다시 한번 깨달았습니다. 제가 생각하는 k3s의 주요 활용처는 다음과 같습니다.

    활용 분야 k3s의 장점 예시
    홈랩 (Home Lab) 저렴한 비용으로 쿠버네티스 학습 및 개인 서비스 운영 라즈베리 파이 클러스터, 개인 웹서버, 미디어 서버
    엣지 컴퓨팅 (Edge Computing) 제한된 리소스 환경에서 컨테이너 애플리케이션 배포 및 관리 스마트 팩토리, 스마트 시티 IoT 게이트웨이, 지점 서버
    개발/테스트 환경 로컬 머신이나 가상 머신에 빠르고 가볍게 k3s 클러스터 구축 CI/CD 파이프라인 테스트, 개발자 개인 환경
    IoT (사물 인터넷) 수많은 IoT 디바이스의 애플리케이션 배포 및 업데이트 관리 자율주행 차량, 스마트 농장 센서 데이터 처리

    k3s는 쿠버네티스의 복잡성을 줄여주면서도 강력한 기능을 제공하기 때문에, 위와 같은 환경에서 컨테이너 기반 애플리케이션을 효율적으로 배포하고 관리하는 데 탁월한 선택이 될 수 있습니다. 저처럼 인프라를 직접 만져보고 실험하는 걸 좋아하는 분들에게는 정말 최고의 장난감이 될 거예요. 💡

    물론 k3s가 모든 상황에 완벽한 만능 해결책은 아니에요. 대규모 엔터프라이즈 환경에서는 여전히 표준 쿠버네티스 배포판이 더 적합할 수 있습니다. 하지만 소규모, 리소스 제한 환경에서는 k3s가 제공하는 가치는 엄청나다고 생각합니다. 저도 처음엔 ‘이 작은 걸로 뭘 할 수 있을까?’ 싶었는데, 지금은 제 홈랩의 핵심 인프라가 되었습니다. 다음 글에서는 k3s 위에 Helm(헬름)으로 애플리케이션을 배포하거나 Persistent Storage(영구 스토리지)를 구성하는 방법에 대해서도 다뤄볼 예정이니 기대해주세요!

    k3s의 주요 장점과 활용 사례를 간결하게 요약한 인포그래픽입니다.

    오늘 제가 공유한 삽질 경험과 해결 과정이 여러분의 k3s 경량 쿠버네티스 클러스터 구축에 조금이나마 도움이 되었기를 바랍니다. 혹시 궁금한 점이나 또 다른 삽질 경험이 있다면 언제든지 댓글로 남겨주세요! 13년차의 서버실은 언제나 열려있습니다. 다음 글에서 또 만나요! 👋

  • [Cloud] Cloudflare Workers 실전 가이드: 서버리스 엣지 컴퓨팅 및 최신 AI 활용 전략

    [Cloud] Cloudflare Workers 실전 가이드: 서버리스 엣지 컴퓨팅 및 최신 AI 활용 전략

    안녕하세요, 13년차 서버실 지킴이입니다. 🤓

    오늘은 제가 최근 홈랩에서 이것저것 실험하면서 꽤나 재미를 보고 있는 기술, 바로 Cloudflare Workers(클라우드플레어 워커스)에 대한 이야기를 풀어볼까 합니다. 다들 서버리스(Serverless)니, 엣지 컴퓨팅(Edge Computing)이니 하는 말 많이 들어보셨을 텐데요. 이게 실제 제 서비스에 어떻게 적용될 수 있을까 궁금하셨던 분들에게 좋은 길잡이가 되었으면 합니다.

    사실 저도 처음엔 ‘이게 뭔가 싶었는데’ 직접 써보고 나니 ‘와, 이거 진짜 물건이네!’ 싶더라고요. 특히 작은 API나 특정 요청을 처리해야 할 때, 굳이 무거운 서버 인스턴스를 띄우지 않고 전 세계 Cloudflare(클라우드플레어) 엣지 네트워크에서 코드를 바로 실행할 수 있다는 점이 매력적이었습니다. 저지연(low-latency)을 줄이고, 비용 효율적으로 서비스를 운영할 수 있는 강력한 도구거든요.

    이번 글에서는 Cloudflare Workers가 무엇인지부터 시작해서, 제가 직접 겪었던 삽질 경험과 해결 과정까지, Cloudflare Workers 실전 가이드: 서버리스 엣지 컴퓨팅 활용 전략을 자세히 알려드리겠습니다. 그럼, 함께 떠나볼까요? 🎉

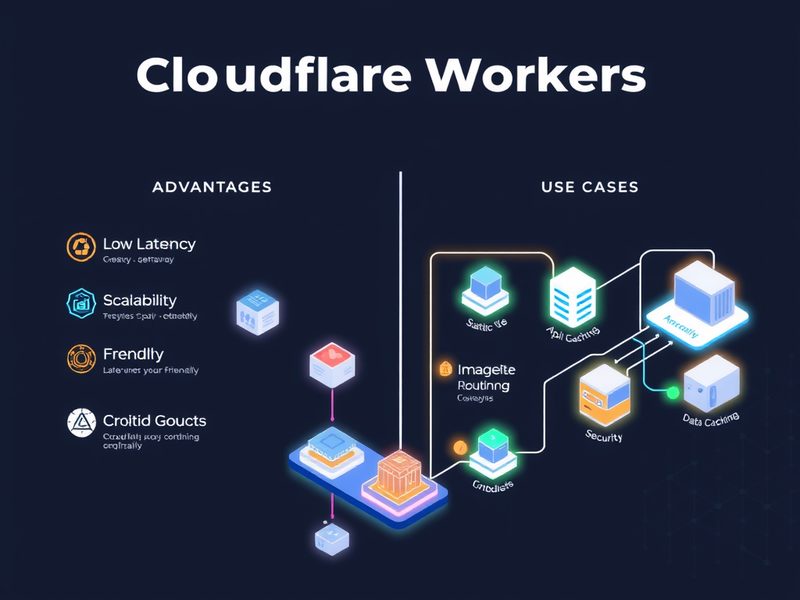
    Cloudflare Workers와 엣지 컴퓨팅 아키텍처 개요 다이어그램

    Cloudflare Workers의 전체적인 아키텍처와 엣지 컴퓨팅 개념을 시각적으로 보여주는 다이어그램입니다.

    Cloudflare Workers, 대체 뭘까요?

    쉽게 말해, Cloudflare Workers는 Cloudflare의 전 세계 분산된 엣지 네트워크(Edge Network) 위에서 JavaScript나 WebAssembly 코드를 실행할 수 있게 해주는 서버리스 실행 환경(Serverless Execution Environment)이에요. 기존의 서버리스 함수(Lambda, Cloud Functions 등)와 비슷하지만, 사용자와 물리적으로 가장 가까운 엣지 로케이션에서 실행된다는 점에서 엣지 컴퓨팅의 특성을 지니고 있습니다.

    제가 처음 접했을 때 가장 놀랐던 건 ‘콜드 스타트(Cold Start)’ 거의 없이 극도로 빠른 응답 시간을 보여준다는 점이었어요. 기존 서버리스 함수들은 유휴 상태일 때 첫 요청에서 약간의 지연이 생길 수 있거든요. 하지만 Workers는 그런 걱정을 거의 할 필요가 없었습니다.

    Cloudflare Workers의 주요 장점

    • 극도로 낮은 지연 시간(Ultra-low Latency): 사용자와 가장 가까운 엣지 서버에서 코드가 실행되므로, 응답 시간이 획기적으로 단축됩니다. 이는 글로벌 네트워크를 활용한 개발자 경험 개선에 크게 기여합니다.
    • 뛰어난 확장성(Massive Scalability): Cloudflare의 강력한 인프라 위에서 작동해서 트래픽이 폭증해도 자동으로 확장되고 안정적인 서비스를 제공합니다. 제가 직접 트래픽 테스트를 해보니 정말 안정적이더라고요.
    • 비용 효율성(Cost-effectiveness): 사용량 기반(pay-per-use) 요금 모델로, 요청 수에 비례하여 비용이 발생합니다. 특히 무료 티어(Free Tier)가 넉넉해서 소규모 서비스나 실험에 정말 좋습니다.
    • 개발자 친화적(Developer-friendly): JavaScript/TypeScript 기반으로 익숙한 언어로 개발할 수 있고, Wrangler CLI 등 개발 도구도 잘 갖춰져 있어요.

    Cloudflare Workers 실전 구현: 첫 Workers 배포하기

    자, 이제 이론은 충분히 봤으니 직접 한번 만들어보고 배포해보는 시간을 가져볼까요? 제가 홈랩에서 했던 과정을 그대로 따라 해보시면 금방 첫 Workers를 만나보실 수 있을 겁니다. 준비물은 Cloudflare 계정 하나면 충분해요!

    1. Cloudflare 계정 생성 및 로그인

    아직 Cloudflare 계정이 없으시다면, Cloudflare 웹사이트에서 가입하세요. 무료 계정으로도 충분합니다. 계정을 생성하고 로그인하면 준비 끝입니다.

    2. Wrangler CLI 설치

    Cloudflare Workers를 개발하고 배포하는 데는 wrangler라는 CLI(Command Line Interface) 도구를 사용하는 것이 가장 편리합니다. Node.js가 설치되어 있어야 합니다.

    
    npm install -g wrangler
    

    설치가 완료되면, 터미널에서 wrangler login 명령어를 실행하여 Cloudflare 계정에 로그인합니다.

    
    wrangler login
    

    이 명령어를 실행하면 브라우저가 열리고 Cloudflare 인증 페이지로 리다이렉트됩니다. 인증을 완료하면 터미널로 돌아와 성공 메시지를 확인할 수 있습니다.

    3. 새 Workers 프로젝트 생성

    이제 새로운 Workers 프로젝트를 생성해봅시다. 최신 개발 환경을 위해 npm create cloudflare 명령어를 사용하는 것을 권장합니다. 여기서는 TypeScript 템플릿을 기반으로 진행하겠습니다.

    
    npm create cloudflare my-first-worker -- --typescript
    cd my-first-worker
    

    이 명령어는 TypeScript 템플릿을 사용하여 기본적인 Workers 프로젝트 구조를 만들어줍니다. my-first-worker 디렉토리로 이동해주세요.

    4. 간단한 Worker 코드 작성

    src/index.ts 파일을 열어보면 다음과 같은 코드를 볼 수 있습니다. 이게 기본 ‘Hello World’ Workers 코드에요.

    
    /**
     * Welcome to Cloudflare Workers! This is your first worker. 
     *
     * - Run `npm run dev` in your terminal to start a development server
     * - Open a browser tab at http://localhost:8787/ to see your worker in action
     * - Run `npm run deploy` to publish your worker
     *
     * Learn more at https://developers.cloudflare.com/workers/ 
     */
    
    export interface Env {
    	// Example binding to KV. Learn more at https://developers.cloudflare.com/workers/runtime/kv/
    	// MY_KV_NAMESPACE: KVNamespace;
    	//	// Example binding to Durable Object. Learn more at https://developers.cloudflare.com/workers/runtime/durable-objects/
    	// MY_DURABLE_OBJECT: DurableObjectNamespace;
    	//	// Example binding to R2. Learn more at https://developers.cloudflare.com/workers/runtime/r2/
    	// MY_BUCKET: R2Bucket;
    }
    
    export default {
    	async fetch(
    		request: Request,
    		env: Env,
    		ctx: ExecutionContext
    	): Promise<Response> {
    		return new Response('Hello Cloudflare Workers!');
    	},
    };
    

    여기서 new Response('Hello Cloudflare Workers!'); 부분을 원하는 메시지로 바꿔볼 수도 있어요. 예를 들어, 제가 좋아하는 메시지인 ’13년차 서버실에서 보내는 메시지!’로 바꿔보겠습니다.

    
    // ... (생략)
    
    export default {
    	async fetch(
    		request: Request,
    		env: Env,
    		ctx: ExecutionContext
    	): Promise<Response> {
    		return new Response('13년차 서버실에서 보내는 메시지! 안녕하세요!');
    	},
    };
    

    5. Workers 배포

    코드를 수정했다면, 이제 Cloudflare 엣지 네트워크에 배포할 차례입니다. wrangler deploy 명령어를 사용하면 됩니다. 배포 시 Workers의 이름은 wrangler.toml 파일에 설정된 name을 따릅니다.

    
    wrangler deploy
    

    이 명령어를 실행하면 코드가 컴파일되고 Cloudflare에 업로드됩니다. 몇 초 안에 배포가 완료되고, 배포된 Workers의 URL을 터미널에서 확인할 수 있어요. 🎉 드디어 됐다!

    Cloudflare Workers 대시보드 배포 설정 화면

    Cloudflare Workers 대시보드에서 방금 배포한 Workers의 설정 화면을 보여주는 스크린샷입니다.

    ⚠️ 주의사항 및 트러블슈팅 경험

    제가 Cloudflare Workers를 사용하면서 겪었던 몇 가지 주의사항과 ‘아, 이거 때문에 삽질 좀 했네’ 싶었던 경험들을 공유합니다.

    1. 런타임 환경 이해하기

    • Node.js 호환성: Workers는 Node.js 런타임이 아니에요. V8 엔진 기반의 독자적인 런타임인 Workers Runtime을 사용하거든요. 그래서 Node.js의 모든 내장 모듈(fs, http 등)을 사용할 수 없습니다. 특정 Node.js 모듈이 필요하다면, Cloudflare의 Node.js 호환성 문서를 참고하거나, WebAssembly(Wasm) 같은 대안을 고려해봐야 합니다. 처음엔 Node.js 모듈을 무심코 사용했다가 에러를 뿜어서 당황했던 기억이 있네요.
    • 글로벌 객체: Node.js의 process나 브라우저의 window 같은 전역 객체(Global Object)는 Workers 환경에 없어요. 대신 self나 globalThis를 사용해야 합니다.

    2. 리소스 제한(Limits)

    Cloudflare Workers는 매우 강력하지만, 엣지 환경의 특성상 몇 가지 리소스 제한이 있습니다. 저도 이 제한 때문에 몇 번 코드를 수정해야 했었죠. (이 정보는 2026년 9월 현재 기준입니다.)

    • CPU 시간: 단일 요청 처리 시 50ms(무료 플랜) ~ 30초(유료 플랜)의 CPU 시간이 주어집니다. 복잡한 연산보다는 빠르고 가벼운 요청 처리에 적합합니다.
    • 메모리: 약 128MB의 메모리 제한이 있어요. 큰 데이터를 처리하거나 복잡한 상태를 유지하는 데는 한계가 있을 수 있습니다.
    • 요청/응답 본문 크기: 기본적으로 50MB로 제한돼요. 큰 파일을 업로드하거나 다운로드하는 프록시를 만들 때는 이 점을 고려해야 합니다.

    3. 로컬 개발 환경

    wrangler dev 명령어를 사용하면 로컬에서 Workers를 개발하고 테스트할 수 있어요. 이게 진짜 편하더라고요. 실제 배포하기 전에 충분히 테스트해보는 습관을 들이는 것이 중요합니다. 💡

    
    wrangler dev
    

    이 명령어를 실행하면 로컬 개발 서버가 시작되고, 브라우저에서 http://localhost:8787/로 접속하여 Workers의 동작을 바로 확인할 수 있습니다.

    검증 및 결과 확인

    배포된 Workers가 잘 작동하는지 확인하는 과정도 중요하죠. 제가 배포한 my-first-worker의 URL을 확인한 뒤, curl 명령어나 웹 브라우저로 접속해보면 됩니다.

    1. Workers URL 확인

    배포가 성공적으로 끝나면 터미널에 다음과 비슷한 URL이 표시됩니다.

    
    # 예시 URL
    https://my-first-worker.YOUR_ACCOUNT_ID.workers.dev/
    

    2. 웹 브라우저 또는 curl로 확인

    해당 URL로 접속하면, 우리가 작성했던 메시지 '13년차 서버실에서 보내는 메시지! 안녕하세요!'가 잘 출력되는 것을 확인할 수 있어요.

    
    curl https://my-first-worker.YOUR_ACCOUNT_ID.workers.dev/
    

    응답으로 13년차 서버실에서 보내는 메시지! 안녕하세요!가 보인다면 성공입니다! ✅

    Cloudflare 대시보드에서도 Workers의 로그와 분석(Analytics)을 확인할 수 있어요. 얼마나 많은 요청이 들어왔고, CPU 시간은 얼마나 사용했는지 등을 한눈에 볼 수 있어서 모니터링하기 정말 편리하더라고요.

    Cloudflare Workers 성능 지표 대시보드 그래프

    Cloudflare Workers 대시보드에서 Workers의 요청 수, CPU 시간 등 성능 지표를 보여주는 그래프나 차트입니다.

    🌟 최신 Cloudflare Workers의 주요 변화 및 신기능

    Cloudflare Workers는 지난 몇 달간 눈부신 발전을 거듭하며 엣지 컴퓨팅의 지평을 넓히고 있습니다. 특히 AI 시대의 엣지 컴퓨팅을 선도하는 새로운 기능들이 대거 추가되었어요. 이 변화들을 통해 Workers는 단순한 서버리스 함수를 넘어, 강력한 엣지 애플리케이션 플랫폼으로 진화하고 있습니다.

    • Workers AI: 엣지 AI의 새로운 지평을 열었습니다. Workers AI를 통해 개발자들은 Cloudflare의 글로벌 네트워크에서 직접 AI 모델을 배포하고 추론을 실행할 수 있습니다. 텍스트 생성, 이미지 분류, 임베딩 등 다양한 AI 작업을 저지연으로 처리할 수 있어, 사용자에게 더 빠르고 개인화된 경험을 제공할 수 있게 되었죠. 이는 서버리스 AI의 가능성을 극대화합니다.
    • Vectorize (벡터 데이터베이스): Workers AI와 함께 사용하기 좋은 벡터 데이터베이스 서비스인 Vectorize가 정식 출시되었습니다. 벡터 임베딩을 저장하고 검색하여 AI 기반 검색, 추천 시스템 등을 엣지에서 구현할 수 있게 해줍니다.
    • D1 (서버리스 SQL 데이터베이스): Cloudflare D1은 SQLite 기반의 서버리스 SQL 데이터베이스로, Workers와 긴밀하게 통합되어 엣지에서 데이터를 영속적으로 저장하고 관리할 수 있게 합니다. 이제 Workers만으로도 복잡한 데이터 기반 애플리케이션을 구축하는 것이 더욱 쉬워졌습니다.
    • Cloudflare Queues: 안정적인 메시징 시스템인 Cloudflare Queues를 통해 Workers 간 또는 외부 시스템과의 비동기 통신을 더욱 견고하게 구축할 수 있습니다. 이는 복잡한 분산 시스템 아키텍처를 엣지에서 구현하는 데 필수적인 요소입니다.

    이러한 기능들은 Workers가 단순한 “함수”를 넘어, 완전한 “엣지 애플리케이션 플랫폼”으로 성장했음을 보여줍니다. 글로벌 네트워크를 활용한 개발자 경험은 더욱 풍부해지고 있습니다.

    마무리하며: 엣지 컴퓨팅의 미래를 Workers와 함께

    오늘은 13년차 인프라 엔지니어의 시선으로 Cloudflare Workers에 대해 자세히 알아보고, 직접 배포까지 해보는 실전 가이드를 소개해드렸습니다. 최신 업데이트를 통해 Workers가 단순한 서버리스 함수를 넘어, 엣지 AI와 데이터 스토리지를 결합한 강력한 플랫폼으로 진화하고 있음을 확인했습니다.

    처음엔 단순히 ‘클라우드플레어에서 코드 돌리는 건가?’ 싶었는데, 직접 써보고 삽질도 해보면서 엣지 컴퓨팅의 진정한 가치를 깨달았네요. 특히 지연 시간에 민감한 서비스나 글로벌 사용자들을 대상으로 하는 서비스에는 Workers가 정말 강력한 대안이 될 수 있겠다는 생각이 들었습니다.

    Cloudflare Workers의 다양한 활용 사례

    • API 게이트웨이(API Gateway): 복잡한 백엔드 없이 간단한 API 엔드포인트를 만들거나, 기존 API에 대한 인증/인가 레이어를 추가할 수 있어요.
    • 정적 웹사이트 라우팅(Static Site Routing): 여러 정적 사이트를 하나의 도메인 아래에서 라우팅하거나, A/B 테스트를 위한 트래픽 분배에 활용할 수 있습니다.
    • 이미지 최적화(Image Optimization): 요청 시점에 이미지를 동적으로 리사이징하거나 포맷을 변환하여 전달할 수 있어요.
    • 보안 및 필터링(Security & Filtering): 악성 트래픽을 차단하거나, 특정 IP 대역의 접근을 제한하는 등 보안 로직을 엣지에서 구현할 수 있습니다.
    • 데이터 캐싱(Data Caching): 자주 요청되는 데이터를 엣지에 캐싱하여 백엔드 부하를 줄이고 응답 속도를 높일 수 있어요.
    • 엣지 AI 애플리케이션: Workers AI를 활용하여 실시간 번역, 콘텐츠 모더레이션, 개인화된 추천 등 AI 기반 서비스를 엣지에서 직접 구현할 수 있습니다.

    저의 작은 경험과 삽질이 Cloudflare Workers를 시작하려는 분들에게 조금이나마 도움이 되었기를 바랍니다. 다음번에는 Workers KV나 Durable Objects 같은 Workers의 고급 기능들을 활용하는 방법에 대해 더 깊이 파고들어 볼 예정입니다. 기대해주세요! 😄

    Cloudflare Workers 주요 장점 및 활용 사례 요약 인포그래픽

    Cloudflare Workers의 주요 장점과 활용 사례를 요약하는 인포그래픽입니다.

    🔄 마지막 업데이트: 2026년 09월

  • [Cloud] Cloudflare Workers로 서버리스 API 및 엣지 컴퓨팅 구축 가이드

    서버 없이 전 세계에서 실행되는 API? Cloudflare Workers 이야기

    솔직히 말씀드리면, 처음 Cloudflare Workers를 접했을 때 “이게 뭔 소리지?” 싶었거든요. 서버리스(Serverless)라는 개념 자체는 알고 있었는데, “엣지에서 실행된다”는 말이 딱 와닿지 않았습니다. 그러다 실제로 간단한 API 하나를 올려봤는데… 서울에서 요청하면 서울 근처 데이터센터에서, 미국에서 요청하면 미국 데이터센터에서 응답이 오는 거예요. 레이턴시(Latency, 응답 지연)가 확 줄어드는 게 느껴졌습니다. 그때 “아, 이래서 엣지 컴퓨팅이구나” 하고 감이 왔죠.

    홈랩에서 이것저것 돌리다 보면 늘 고민이 생기잖아요. 외부에서 접근 가능한 간단한 API가 필요한데, 서버 하나 띄우자니 유지보수가 귀찮고, 클라우드 VM 쓰자니 비용이 아깝고. 그 틈새를 Cloudflare Workers가 정말 잘 채워줬습니다. 오늘은 제가 실제로 Workers로 서버리스 API를 구축하면서 겪은 경험을 바탕으로, 처음 시작하시는 분들도 따라할 수 있게 정리해 드릴게요.

    ▲ Cloudflare Workers의 엣지 컴퓨팅 구조 — 전 세계 데이터센터에서 코드가 실행되는 개념도


    Cloudflare Workers가 뭔지 쉽게 풀어보기

    엣지 컴퓨팅(Edge Computing)이란?

    일반적인 클라우드 서버는 특정 리전(Region, 지역)에 고정되어 있어요. 예를 들어 AWS ap-northeast-2(서울 리전)에 서버를 올리면, 미국 사용자가 접속할 때는 태평양을 건너서 요청이 오가야 하죠. 이게 레이턴시의 주범입니다.

    엣지 컴퓨팅은 이 문제를 뒤집어서 생각한 거예요. “서버를 중앙에 두지 말고, 사용자 가까이에 두자!” 라는 발상이죠. Cloudflare는 전 세계 200개 이상의 도시에 데이터센터(PoP, Point of Presence)를 운영하고 있는데, Workers 코드가 이 모든 위치에서 실행됩니다. 쉽게 말해, 사용자가 어디에 있든 가장 가까운 서버에서 응답이 오는 거예요.

    Workers의 핵심 특징

    • V8 엔진 기반: Node.js가 아닌 V8 Isolate(아이솔레이트) 방식으로 실행됩니다. 컨테이너보다 훨씬 빠르게 시작해요 (콜드 스타트 거의 없음)
    • JavaScript / TypeScript 지원: 프론트엔드 개발자분들도 친숙하게 쓸 수 있어요
    • Workers KV: 엣지에서 사용 가능한 키-값(Key-Value) 스토리지
    • 무료 티어 존재: 하루 10만 요청까지 무료 (최신 정보는 Cloudflare 공식 가격 페이지 확인 권장)
    • 배포가 초간단: Wrangler CLI 명령어 하나로 전 세계 배포 완료
    구분 전통적 서버 일반 서버리스 (Lambda 등) Cloudflare Workers
    실행 위치 단일 리전 단일 리전 전 세계 엣지
    콜드 스타트 없음 수백ms ~ 수초 거의 없음 (0ms 수준)
    관리 부담 높음 낮음 매우 낮음
    런타임 자유 Node.js, Python 등 V8 (JS/TS/Wasm)
    무료 티어 없음 있음 있음

    환경 설정: Wrangler CLI 설치부터 시작

    본격적으로 시작해볼게요. Wrangler는 Cloudflare Workers 개발을 위한 공식 CLI(Command Line Interface) 도구입니다. 이게 없으면 아무것도 못 하니까 먼저 설치부터요.

    1단계: Node.js 및 Wrangler 설치

    Node.js 16 이상이 설치되어 있다는 전제 하에 진행합니다.

    # Wrangler CLI 전역 설치
    npm install -g wrangler
    
    # 설치 확인
    wrangler --version
    
    # Cloudflare 계정 로그인 (브라우저가 열립니다)
    wrangler login

    로그인하면 브라우저에서 Cloudflare 대시보드로 이동해서 권한 허용을 요청해요. 그냥 허용 누르시면 됩니다. 처음에 이 과정이 좀 낯설었는데, 익숙해지면 진짜 편하더라고요.

    2단계: 새 Workers 프로젝트 생성

    # 새 프로젝트 생성 (대화형 설정)
    npm create cloudflare@latest my-api-worker
    
    # 프로젝트 디렉토리로 이동
    cd my-api-worker

    생성 과정에서 몇 가지 질문이 나오는데, “Hello World” 템플릿 선택하고, TypeScript 쓸지 JavaScript 쓸지 고르면 됩니다. 저는 보통 TypeScript를 선택하는 편이에요. 타입 안정성이 있으니까요.

    프로젝트 구조는 이렇게 됩니다:

    my-api-worker/
    ├── src/
    │   └── index.ts        # 메인 Worker 코드
    ├── wrangler.toml       # Worker 설정 파일
    ├── package.json
    └── tsconfig.json

    실전 구현: 서버리스 REST API 만들기

    이제 진짜 코드를 써볼게요. 단순한 “Hello World”는 재미없으니까, 실제로 쓸 만한 간단한 REST API를 만들어보겠습니다. 라우팅(Routing)과 메서드 분기를 포함한 구조예요.

    ▲ Wrangler를 이용한 로컬 개발 환경 — wrangler dev 명령으로 로컬에서 Workers를 테스트할 수 있어요

    기본 라우팅이 포함된 API Worker

    // src/index.ts
    
    export interface Env {
      // 나중에 KV 바인딩을 여기 추가할 거예요
      MY_KV: KVNamespace;
    }
    
    export default {
      async fetch(request: Request, env: Env, ctx: ExecutionContext): Promise<Response> {
        const url = new URL(request.url);
        const path = url.pathname;
        const method = request.method;
    
        // CORS 헤더 설정
        const corsHeaders = {
          'Access-Control-Allow-Origin': '*',
          'Access-Control-Allow-Methods': 'GET, POST, PUT, DELETE, OPTIONS',
          'Access-Control-Allow-Headers': 'Content-Type',
        };
    
        // Preflight 요청 처리
        if (method === 'OPTIONS') {
          return new Response(null, { headers: corsHeaders });
        }
    
        // 라우팅 처리
        if (path === '/api/hello' && method === 'GET') {
          return Response.json(
            { message: '안녕하세요! Cloudflare Workers에서 응답합니다.', timestamp: Date.now() },
            { headers: corsHeaders }
          );
        }
    
        if (path === '/api/items' && method === 'GET') {
          return handleGetItems(env, corsHeaders);
        }
    
        if (path === '/api/items' && method === 'POST') {
          return handlePostItem(request, env, corsHeaders);
        }
    
        // 404 처리
        return Response.json(
          { error: 'Not Found', path },
          { status: 404, headers: corsHeaders }
        );
      },
    };
    
    // GET /api/items — KV에서 아이템 목록 조회
    async function handleGetItems(env: Env, headers: Record<string, string>): Promise<Response> {
      const data = await env.MY_KV.get('items', 'json') as string[] | null;
      return Response.json(
        { items: data ?? [] },
        { headers }
      );
    }
    
    // POST /api/items — KV에 아이템 추가
    async function handlePostItem(
      request: Request,
      env: Env,
      headers: Record<string, string>
    ): Promise<Response> {
      const body = await request.json() as { name: string };
    
      if (!body.name) {
        return Response.json(
          { error: 'name 필드가 필요합니다' },
          { status: 400, headers }
        );
      }
    
      const existing = await env.MY_KV.get('items', 'json') as string[] | null;
      const items = existing ?? [];
      items.push(body.name);
    
      await env.MY_KV.put('items', JSON.stringify(items));
    
      return Response.json(
        { success: true, items },
        { status: 201, headers }
      );
    }

    코드 보시면 구조가 꽤 직관적이죠? fetch 함수가 모든 HTTP 요청의 진입점이고, URL 경로와 HTTP 메서드로 분기처리를 합니다. Node.js의 Express 같은 느낌이에요.

    Workers KV 설정하기

    Workers KV는 엣지에서 사용 가능한 분산 키-값 스토리지예요. 데이터베이스를 별도로 운영하지 않아도 간단한 데이터를 저장하고 조회할 수 있거든요. 쓰기는 약간의 전파 지연이 있지만, 읽기는 엣지에서 바로 처리되니까 빠릅니다.

    # KV 네임스페이스(Namespace) 생성
    wrangler kv:namespace create MY_KV
    
    # 로컬 개발용 프리뷰 네임스페이스도 생성
    wrangler kv:namespace create MY_KV --preview

    명령어 실행 후 출력되는 ID를 wrangler.toml에 붙여넣어야 합니다.

    # wrangler.toml
    name = "my-api-worker"
    main = "src/index.ts"
    compatibility_date = "2024-01-01"
    
    [[kv_namespaces]]
    binding = "MY_KV"          # 코드에서 env.MY_KV로 접근
    id = "여기에_실제_KV_ID_입력"
    preview_id = "여기에_프리뷰_KV_ID_입력"

    💡 팁: binding 이름이 TypeScript 인터페이스의 Env에 선언한 이름과 일치해야 해요. 처음에 이게 안 맞아서 에러가 났었는데, 삽질 좀 했습니다 ㅎㅎ

    로컬에서 테스트하기

    # 로컬 개발 서버 실행
    wrangler dev
    
    # 기본적으로 http://localhost:8787 에서 실행됩니다
    
    # 다른 터미널에서 API 테스트
    curl http://localhost:8787/api/hello
    
    # POST 테스트
    curl -X POST http://localhost:8787/api/items \
      -H "Content-Type: application/json" \
      -d '{"name": "테스트 아이템"}'
    
    # GET으로 확인
    curl http://localhost:8787/api/items

    로컬에서 잘 돌아가면 이제 배포할 차례예요!

    # 전 세계 배포 (진짜 이 명령어 하나예요)
    wrangler deploy
    
    # 배포 후 URL이 출력됩니다
    # 예: https://my-api-worker.your-subdomain.workers.dev

    🎉 배포 완료! 이 URL로 전 세계 어디서든 접근 가능합니다. 처음에 이게 진짜로 되는 건지 믿기지 않아서 VPN으로 미국, 일본, 유럽 각각에서 테스트해봤는데 전부 잘 됐더라고요.


    ⚠️ 주의사항 및 실제 겪은 트러블슈팅

    좋은 것만 얘기하면 재미없죠. 실제로 쓰다 보면 꼭 한 번씩 걸리는 것들이 있어요.

    문제 1: Workers KV 쓰기 전파 지연

    KV에 데이터를 쓰고 바로 읽으면 이전 값이 나오는 경우가 있어요. KV는 최종 일관성(Eventual Consistency) 모델이라서, 쓰기 작업이 전 세계 엣지에 전파되는 데 시간이 걸립니다. 공식 문서에 따르면 최대 60초 정도 걸릴 수 있어요. 로컬 개발 환경에서는 이게 즉시 반영되는 것처럼 보이는데, 프로덕션에서는 다를 수 있습니다.

    해결책: 쓰기 직후 즉시 읽기가 필요한 로직은 KV 대신 Durable Objects(내구성 있는 객체, 강한 일관성 보장)를 고려하세요. 단순 캐시나 설정값 저장에는 KV가 딱 좋습니다.

    문제 2: CPU 시간 제한

    Workers는 요청당 CPU 시간 제한이 있어요. 무료 티어는 요청당 10ms, 유료 플랜은 더 길어요. 무거운 연산(이미지 처리, 복잡한 암호화 등)은 Workers에 맞지 않습니다. 저도 처음에 이미지 리사이징 로직을 Workers에 넣으려다 바로 한계에 부딪혔어요.

    해결책: Workers는 가볍고 빠른 로직에 최적화되어 있거든요. 무거운 작업은 백엔드 서버로 위임하고, Workers는 게이트웨이(Gateway, 진입 관문) 역할만 맡기는 패턴이 좋습니다.

    문제 3: Node.js API 호환성 이슈

    Workers는 Node.js 런타임이 아니에요. V8 Isolate 기반이라 Node.js 전용 API(예: fs, path, crypto 일부)가 기본적으로 없어요. npm 패키지 중에도 Node.js 내장 모듈에 의존하는 것들은 Workers에서 안 돌아갈 수 있습니다.

    해결책: wrangler.toml에 node_compat = true를 추가하면 일부 Node.js API 폴리필(Polyfill, 하위 호환 구현체)이 활성화됩니다. 그래도 안 되는 경우엔 Workers 환경에 맞는 대안 라이브러리를 찾아야 해요.

    # wrangler.toml에 추가
    node_compat = true

    문제 4: 환경 변수 관리

    API 키 같은 민감한 정보를 코드에 하드코딩하면 절대 안 되죠. Workers에는 Secrets(시크릿) 기능이 있어요.

    # 시크릿 등록 (값은 프롬프트로 입력)
    wrangler secret put MY_API_KEY
    
    # 등록된 시크릿 목록 확인
    wrangler secret list
    // 코드에서 env로 접근
    export interface Env {
      MY_KV: KVNamespace;
      MY_API_KEY: string;  // 시크릿도 Env에 선언
    }
    
    // 사용 예시
    const apiKey = env.MY_API_KEY;

    결과 확인: 대시보드에서 모니터링하기

    배포 후 Cloudflare 대시보드에서 Workers 섹션을 보면 꽤 유용한 정보들을 확인할 수 있어요.

    ▲ Cloudflare Workers 대시보드 — 요청 수, 에러율, CPU 시간 등 실시간 모니터링이 가능해요

    • ✅ 요청 수(Requests): 분/시간/일별 요청량 확인
    • ✅ 에러율(Error Rate): 4xx, 5xx 에러 비율
    • ✅ CPU 시간: 요청당 평균 CPU 사용 시간
    • ✅ 실시간 로그: wrangler tail 명령으로 실시간 로그 스트리밍 가능
    # 실시간 로그 스트리밍
    wrangler tail
    
    # 특정 Worker 지정
    wrangler tail my-api-worker

    로그에서 요청 경로, 응답 코드, 실행 시간 등이 다 나와요. 디버깅할 때 꽤 유용하더라고요. 처음에 이 기능 몰라서 console.log 찍어가며 고생했는데, 알고 나서 “진작 쓸걸” 했죠.

    커스텀 도메인 연결

    기본 제공되는 *.workers.dev 도메인 말고, 본인 도메인을 연결할 수도 있어요. Cloudflare에 도메인이 등록되어 있다면 Workers 설정에서 Route(라우트, 트래픽 경로)를 추가하면 됩니다.

    # wrangler.toml에 라우트 추가
    [[routes]]
    pattern = "api.yourdomain.com/*"
    zone_name = "yourdomain.com"

    이렇게 하면 api.yourdomain.com으로 들어오는 모든 요청이 Workers로 처리돼요. 깔끔하죠?


    마무리: Workers가 잘 맞는 상황 vs 아닌 상황

    ▲ Cloudflare Workers 적합/비적합 사용 사례 요약 — 어떤 상황에서 Workers를 선택해야 할지 한눈에 보기

    몇 달 써보면서 느낀 건, Workers는 만능이 아니에요. 잘 맞는 상황이 있고, 억지로 쓰면 오히려 복잡해지는 상황도 있더라고요.

    ✅ Workers가 잘 맞는 경우

    • CORS 프록시, API 게이트웨이
    • A/B 테스트, 기능 플래그(Feature Flag) 처리
    • 간단한 인증/인가(Authentication/Authorization) 미들웨어
    • 정적 사이트의 동적 기능 추가 (Jamstack 패턴)
    • 봇 차단, 요청 필터링
    • 지리적으로 분산된 캐시 레이어

    ⚠️ 다른 선택지를 고려해야 할 경우

    • 무거운 연산이나 긴 실행 시간이 필요한 작업
    • 강한 데이터 일관성이 필요한 트랜잭션 처리
    • 파일 시스템 접근이 필요한 경우
    • 기존 Node.js/Python 등 런타임 의존성이 많은 경우

    자주 묻는 질문 (FAQ)

    Q. Workers KV와 일반 데이터베이스의 차이는?
    A. Workers KV는 읽기에 최적화된 분산 스토리지예요. 복잡한 쿼리나 관계형 데이터가 필요하다면 Cloudflare D1(SQLite 기반) 이나 외부 DB를 연동하는 게 낫습니다.
    Q. 무료로 얼마나 쓸 수 있나요?
    A. 공식 문서 기준 무료 티어는 하루 10만 요청까지 제공합니다. 정확한 현행 조건은 Cloudflare 공식 가격 페이지에서 반드시 확인하세요. 자주 바뀌는 편이거든요.
    Q. TypeScript 말고 다른 언어도 되나요?
    A. WebAssembly(웹어셈블리)로 컴파일되는 언어라면 이론상 가능해요. Rust로 Workers를 작성하는 사례도 있습니다. 다만 생태계는 JS/TS가 가장 풍부해요.

    오늘 다룬 내용이 Cloudflare Workers로 서버리스 API와 엣지 컴퓨팅을 시작하는 데 도움이 됐으면 좋겠어요. 다음 글에서는 Cloudflare D1(서버리스 SQLite 데이터베이스)과 Workers를 연동해서 더 완성도 있는 API를 만드는 방법을 다룰 예정입니다. Workers KV만으로는 아쉬울 때 딱 좋은 조합이거든요.

    궁금한 점이나 직접 해보다가 막히는 부분 있으시면 댓글로 남겨주세요. 같이 삽질해봅시다! 😄

  • [k8s] k3s vs MicroK8s: 2026년 9월 기준 경량 쿠버네티스 비교 분석 및 선택 가이드

    [k8s] k3s vs MicroK8s: 2026년 9월 기준 경량 쿠버네티스 비교 분석 및 선택 가이드

    경량 쿠버네티스, 왜 지금 이 선택이 중요한가요?

    홈랩에 쿠버네티스를 올리려고 처음 도전했을 때가 생각나네요. 풀스택 쿠버네티스를 라즈베리파이 클러스터에 올렸다가 메모리가 터져서 노드가 죽어버리는 경험을 했거든요. 그때 처음 알게 된 게 바로 경량 쿠버네티스(Lightweight Kubernetes)라는 개념이었습니다.

    요즘은 엣지 컴퓨팅, IoT, 홈랩 쿠버네티스, 로컬 개발 환경, 소규모 프로덕션 클러스터까지 쿠버네티스를 돌려야 하는 상황이 정말 많아졌죠. 그런데 풀 쿠버네티스를 그대로 올리기엔 리소스 부담이 큽니다. 그래서 여전히 많은 분들이 k3s vs MicroK8s라는 주제로 고민하세요.

    저도 실제로 두 가지를 모두 운영해봤습니다. 홈랩 서버에서는 k3s를 오래 써왔고, 개발 팀 환경 구성이나 Ubuntu 기반 테스트 환경에서는 MicroK8s도 여러 번 써봤거든요. 이번 글에서는 2026년 9월 기준으로 바뀐 내용까지 반영해서, 어떤 상황에서 뭘 선택해야 하는지 현실적으로 정리해보겠습니다.

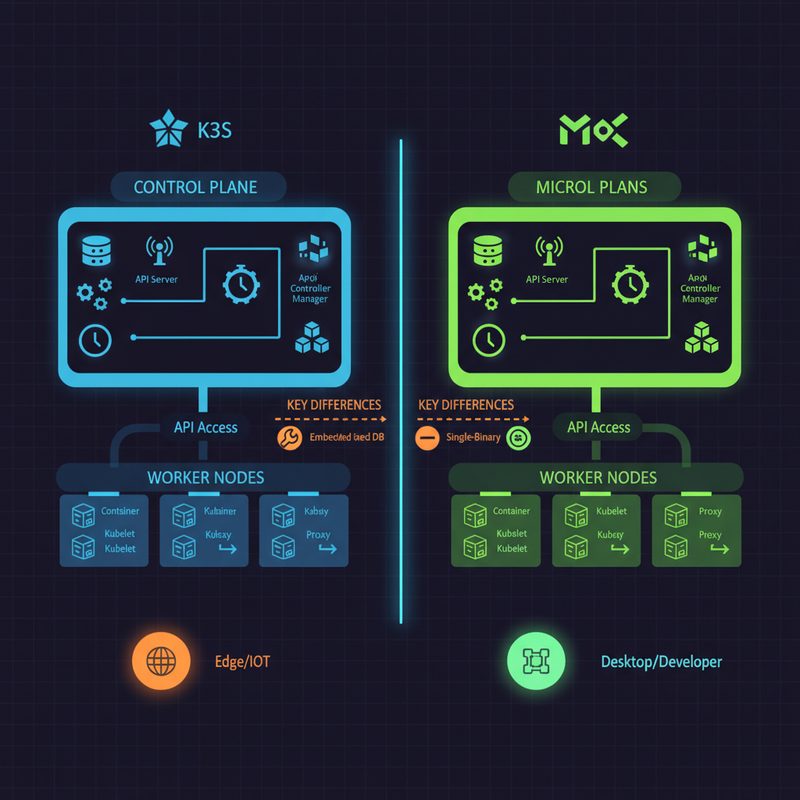
    k3s와 MicroK8s 경량 쿠버네티스 아키텍처 비교 다이어그램

    ▲ k3s와 MicroK8s의 전체 아키텍처 개요 — 두 경량 쿠버네티스의 구조적 차이를 한눈에 비교한 다이어그램


    k3s와 MicroK8s가 뭔지 먼저 짚고 가요

    k3s — 더 이상 40MB는 아니지만 여전히 가장 가벼운 축

    k3s는 Rancher Labs, 현재 SUSE에서 만든 경량 쿠버네티스 배포판입니다. 이름의 k3s는 k8s보다 더 가볍다는 의미에서 붙은 이름이고요. 요즘 기준으로는 100MB 안팎의 단일 바이너리라고 보는 게 더 정확합니다. 예전처럼 40MB짜리 쿠버네티스라고 딱 잘라 말하긴 어렵지만, 여전히 경량 쿠버네티스 대표 주자라는 건 변함이 없어요.

    주요 특징을 보면:

    • 단일 바이너리 중심 배포 — 설치가 정말 간단해요
    • 기본 스토리지 백엔드는 SQLite, 고가용성(HA)은 임베디드 etcd 또는 외부 DB 선택 가능
    • ARM 아키텍처 지원이 매우 좋아서 라즈베리파이 쿠버네티스 용도로 강함
    • containerd, Flannel, CoreDNS, Traefik, ServiceLB, local-path-provisioner 등을 기본 제공
    • 엣지 쿠버네티스, IoT, 에어갭 환경, 홈랩에 특히 잘 맞음
    • 2026년 9월 기준 최신 주요 릴리스 흐름은 Kubernetes 1.37 기반 k3s 1.37 계열까지 올라왔고, 1.34/1.35 계열도 패치 릴리스가 계속 제공되는 상황

    MicroK8s — Canonical이 만든 스냅 패키지 쿠버네티스

    MicroK8s는 Ubuntu를 만든 Canonical에서 개발한 경량 쿠버네티스입니다. 여전히 가장 큰 특징은 snap 패키지로 설치된다는 점이에요. Ubuntu 기반 서버나 개발용 워크스테이션에서는 정말 편합니다.

    • snap 패키지로 설치 — Ubuntu/Debian 계열에서 매우 간편
    • 애드온 시스템으로 기능 확장 — 필요한 것만 켜고 끄는 구조
    • 단일 노드부터 멀티노드, 고가용성 클러스터까지 지원
    • DNS, hostpath 스토리지, Ingress, MetalLB, GPU, observability 등 애드온 활성화가 쉬움
    • CNCF 인증 쿠버네티스 — 표준 호환성 높음
    • 업스트림 쿠버네티스 버전을 빠르게 따라가는 편이지만, 실제 설치 전에는 snap info microk8s로 채널별 최신 버전을 확인하는 게 안전함

    k3s vs MicroK8s 핵심 스펙 비교표

    말로만 설명하면 헷갈리니까 표로 정리해봤습니다. 특히 2026년 기준으로 바뀐 부분은 MicroK8s의 대시보드 제거, Ingress 애드온의 Traefik 전환, Gateway API 중요도 상승입니다.

    항목 k3s MicroK8s
    개발사 SUSE (원 개발: Rancher Labs) Canonical
    설치 방식 curl 스크립트 / 단일 바이너리 snap 패키지
    최소 메모리 약 512MB 수준부터 시작 가능 약 540MB 이상 권장
    기본 스토리지 백엔드 SQLite / 임베디드 etcd / 외부 DB dqlite 기반 HA 데이터스토어
    기본 컨테이너 런타임 containerd containerd
    기본 Ingress Traefik 포함 없음. microk8s enable ingress로 활성화, 최신 계열은 Traefik 기반
    Gateway API k3s 1.37부터 Gateway API CRD 번들 제공 Ingress 애드온과 Traefik 구성에서 Gateway API 흐름이 중요해짐
    ARM 지원 매우 강함 지원
    멀티노드 클러스터 비교적 단순 지원, HA 기본 지원 구조
    애드온 시스템 내장 컴포넌트 + Helm Chart 패턴 microk8s enable 명령어
    주요 사용 환경 엣지, IoT, 홈랩, 경량 프로덕션 개발 환경, Ubuntu 기반 서버, 빠른 테스트랩
    CNCF 인증 지원 지원

    포인트: 메모리 차이보다 더 중요한 건 운영 모델입니다. k3s는 최대한 작고 단순하게, MicroK8s는 Ubuntu 생태계에서 빠르게 확장 가능하게 쪽에 더 가깝습니다.


    실전 설치 및 구성 — 직접 해봤습니다

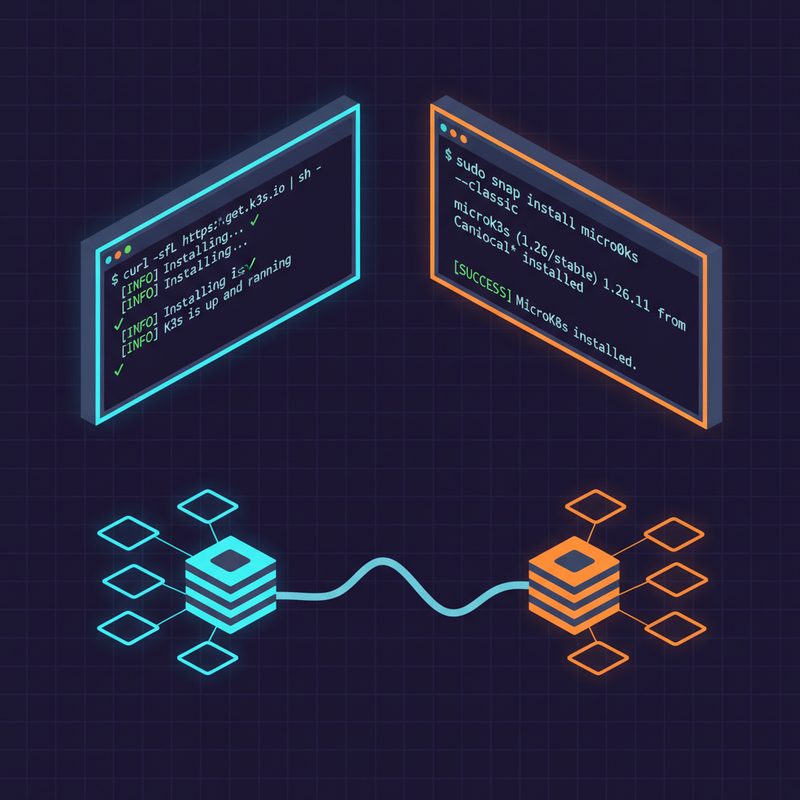
    k3s와 MicroK8s 터미널 설치 과정 단계별 화면

    ▲ k3s와 MicroK8s 실제 설치 과정 — 터미널에서 진행되는 단계별 설치 명령어 실행 화면

    k3s 설치 — 진짜 이렇게 쉬울 수가

    # k3s 서버 설치
    curl -sfL https://get.k3s.io | sh -
    
    # 설치 확인
    sudo k3s kubectl get nodes
    
    # 노드 토큰 확인
    sudo cat /var/lib/rancher/k3s/server/node-token

    워커 노드 추가

    curl -sfL https://get.k3s.io | K3S_URL=https://마스터IP:6443 K3S_TOKEN=서버토큰값 sh -

    kubeconfig 설정

    mkdir -p ~/.kube
    sudo cp /etc/rancher/k3s/k3s.yaml ~/.kube/config
    sudo chown $(id -u):$(id -g) ~/.kube/config
    chmod 600 ~/.kube/config
    sed -i 's/127.0.0.1/마스터서버IP/g' ~/.kube/config
    kubectl get nodes

    주의: kubeconfig 권한이 너무 넓으면 kubectl이 경고를 냅니다. chmod 600 ~/.kube/config까지 같이 해두는 게 깔끔해요.

    k3s 추가 설정 — Traefik 비활성화 또는 버전 고정

    # Traefik 없이 설치
    curl -sfL https://get.k3s.io | INSTALL_K3S_EXEC="--disable traefik" sh -
    
    # 특정 버전 지정 설치 예시. 실제 최신 패치는 릴리스 노트 확인 권장
    curl -sfL https://get.k3s.io | INSTALL_K3S_VERSION="v1.37.0+k3s1" sh -

    k3s 고가용성(HA) 시작점

    # 첫 서버를 embedded etcd 기반 HA 초기 노드로 시작
    curl -sfL https://get.k3s.io | sh -s - server --cluster-init
    
    # 이후 추가 서버 조인
    curl -sfL https://get.k3s.io | K3S_URL=https://첫서버IP:6443 K3S_TOKEN=서버토큰값 sh -s - server

    MicroK8s 설치 — Ubuntu라면 더 편해요

    # 설치 전 채널 확인
    snap info microk8s
    
    # snap으로 MicroK8s 설치. 운영 환경은 버전 채널을 명시하는 편이 안전합니다.
    sudo snap install microk8s --classic --channel=1.36/stable
    
    sudo usermod -a -G microk8s $USER
    mkdir -p ~/.kube
    sudo chown -f -R $USER ~/.kube
    newgrp microk8s
    
    microk8s status --wait-ready
    microk8s kubectl get nodes

    MicroK8s 핵심 애드온 활성화

    microk8s enable dns
    microk8s enable hostpath-storage
    microk8s enable ingress
    microk8s enable metallb:192.168.1.200-192.168.1.220
    microk8s enable dns hostpath-storage ingress

    예전 글이나 오래된 튜토리얼에는 microk8s enable dashboard가 자주 나오는데요. MicroK8s 1.36부터 dashboard 애드온과 dashboard-proxy 명령은 제거됐습니다. 웹 UI가 필요하다면 Lens, Headlamp, Argo CD, Rancher 같은 별도 도구를 검토하는 쪽이 현실적입니다.

    MicroK8s kubectl 별칭 설정

    alias kubectl='microk8s kubectl'
    alias k='microk8s kubectl'
    microk8s config > ~/.kube/microk8s-config
    export KUBECONFIG=~/.kube/config:~/.kube/microk8s-config

    MicroK8s 멀티노드 클러스터 구성

    microk8s add-node
    microk8s join 마스터IP:25000/토큰값/해시값
    microk8s join 마스터IP:25000/토큰값/해시값 --worker
    microk8s kubectl get nodes

    실제 삽질 포인트와 트러블슈팅

    k3s 트러블슈팅

    문제 1: 방화벽 때문에 워커 노드가 조인이 안 돼요

    sudo ufw allow 6443/tcp
    sudo ufw allow 10250/tcp
    sudo ufw allow 8472/udp
    sudo ufw allow 51820/udp
    sudo k3s kubectl get nodes -o wide
    sudo journalctl -u k3s -f

    문제 2: SQLite에서 HA로 커지기 시작할 때

    단일 노드면 SQLite도 충분합니다. 다만 처음부터 고가용성 운영을 할 거면 embedded etcd로 시작하는 게 가장 깔끔해요. 중간에 뒤늦게 구조를 바꾸면 생각보다 손이 많이 갑니다.

    curl -sfL https://get.k3s.io | sh -s - server --cluster-init

    문제 3: 이미지 pull 속도가 너무 느려요

    # /etc/rancher/k3s/registries.yaml
    mirrors:
      docker.io:
        endpoint:
          - "https://mirror.gcr.io"
      "내부레지스트리주소:5000":
        endpoint:
          - "http://내부레지스트리주소:5000"
    configs:
      "내부레지스트리주소:5000":
        auth:
          username: admin
          password: password
        tls:
          insecure_skip_verify: true
    sudo systemctl restart k3s

    MicroK8s 트러블슈팅

    문제 1: snap/커널 조합 때문에 설치가 꼬여요

    uname -r
    microk8s inspect
    sudo snap refresh microk8s --channel=1.36/stable

    문제 2: 예전 튜토리얼대로 dashboard 접근이 안 돼요

    이건 사용자가 잘못한 게 아니라, 최신 버전에서 절차가 바뀐 것입니다. MicroK8s 1.36부터는 dashboard 애드온과 microk8s dashboard-proxy가 제거됐어요. 따라서 예전 방식으로는 당연히 안 됩니다.

    문제 3: snap 자동 업데이트로 버전이 올라가버려요

    sudo snap refresh --hold microk8s
    sudo snap refresh --hold=forever microk8s
    snap refresh --time

    MicroK8s는 같은 채널 안에서는 자동 refresh가 일어날 수 있습니다. 운영 환경이라면 채널 고정, hold 정책, 업그레이드 테스트 순서를 미리 정해두는 게 좋습니다.


    실제 운영 결과 및 성능 비교

    k3s와 MicroK8s 리소스 사용량 성능 모니터링 대시보드 비교

    ▲ k3s와 MicroK8s 리소스 사용량 모니터링 대시보드 — CPU, 메모리 사용량 실시간 비교 차트

    동일한 스펙의 VM 두 대에 각각 설치해서 비교해봤습니다. 수치는 환경과 활성화한 애드온에 따라 달라질 수 있으니 참고용으로 봐주세요.

    유휴 상태(Idle) 리소스 사용량

    측정 항목 k3s MicroK8s
    메모리 사용량 약 450MB~600MB 약 550MB~750MB
    CPU 사용률 유휴 시 0.5% 이하인 경우가 많음 유휴 시 1~2% 수준인 경우가 많음
    준비 시간 약 15~30초 약 30~60초
    디스크 사용량 상대적으로 작음 snap 포함 시 더 큼

    k3s가 전반적으로 더 가벼운 편이긴 한데, 이 차이는 정말 빡빡한 ARM 보드나 소형 엣지 장비에서 더 크게 느껴집니다. 일반적인 VM이나 미니 PC 수준에선 완전히 다른 세상 정도는 아니에요.

    Pod 배포 속도 테스트

    time kubectl create deployment nginx-test --image=nginx --replicas=5
    kubectl rollout status deployment/nginx-test

    결론적으로 두 환경 모두 배포 체감은 비슷했습니다. 실제 차이는 컨테이너 이미지 pull, CNI 초기화, 스토리지 프로비저너 상태 같은 주변 요소에서 더 많이 납니다.


    어떤 걸 선택해야 할까요? — 상황별 가이드

    k3s를 선택해야 하는 경우

    • 라즈베리파이, 임베디드 시스템 등 ARM 기반 엣지 환경
    • 멀티노드 클러스터를 간단하게 구성하고 싶을 때
    • Ubuntu 외 다른 Linux 배포판을 사용할 때
    • 프로덕션 엣지 배포가 목적일 때
    • 인터넷 연결이 불안정하거나 에어갭 설치가 필요한 환경
    • 홈랩 쿠버네티스를 최대한 가볍게 운영하고 싶을 때
    • Gateway API CRD 번들 제공 같은 최신 k3s 1.37 흐름을 활용하고 싶을 때

    MicroK8s를 선택해야 하는 경우

    • Ubuntu 기반 개발 환경에서 빠르게 쿠버네티스 셋업
    • 애드온 시스템으로 간편하게 기능 확장하고 싶을 때
    • Canonical/Ubuntu 생태계를 이미 사용 중일 때
    • 개발자가 로컬에서 표준 쿠버네티스 환경이 필요할 때
    • GPU 워크로드나 observability 애드온을 빨리 붙여보고 싶을 때
    • snap 기반 설치와 채널 관리 모델이 조직 운영 방식에 잘 맞을 때

    둘 다 아닌 경우도 있어요

    개발 환경에서 쿠버네티스가 필요한데 설치도 귀찮고 리소스도 아끼고 싶다면, kind(Kubernetes in Docker)나 minikube도 충분히 좋은 선택입니다. 특히 CI 파이프라인이나 일회성 테스트 환경은 kind가 더 깔끔할 때가 많아요.


    자주 묻는 질문 (FAQ)

    Q. k3s와 MicroK8s 중 어느 게 더 프로덕션에 적합한가요?

    엣지, 홈랩, 소규모 서비스 운영처럼 가볍고 단순한 운영이 중요하면 k3s 쪽을 먼저 봅니다. Ubuntu 표준 환경, snap 기반 배포, 애드온 중심 운영이 편한 팀이라면 MicroK8s도 충분히 좋은 선택입니다.

    Q. 라즈베리파이에는 뭘 써야 하나요?

    개인적으로는 k3s를 먼저 추천합니다. ARM 지원, 설치 단순성, 리소스 사용량 면에서 라즈베리파이 쿠버네티스와 잘 맞습니다.

    Q. 기존 kubectl 명령어를 그대로 쓸 수 있나요?

    네. k3s는 k3s kubectl 또는 일반 kubectl을 사용할 수 있고, MicroK8s는 microk8s kubectl을 쓰거나 alias/kubeconfig를 설정하면 됩니다.

    Q. 풀 쿠버네티스에서 k3s/MicroK8s로 마이그레이션이 쉬운가요?

    기본 리소스는 대부분 비슷하지만, Ingress Controller, StorageClass, LoadBalancer, CNI, CSI 드라이버 차이에서 손볼 일이 생깁니다. 특히 2026년 기준으로는 Ingress와 Gateway API 전략을 함께 검토하는 게 좋습니다.


    2026년 9월 기준, 꼭 알아야 할 최신 변화

    1. MicroK8s는 이제 대시보드 기본 경로를 기대하면 안 됩니다

    MicroK8s 1.36부터 dashboard 관련 기능이 제거됐습니다. 예전처럼 microk8s enable dashboard와 microk8s dashboard-proxy를 기대하면 막힙니다. 운영 가시성이 필요하다면 Headlamp, Lens, Grafana, Argo CD UI 같은 대안을 선택하는 편이 낫습니다.

    2. Ingress와 Traefik, Gateway API 변화는 생각보다 영향이 큽니다

    MicroK8s의 ingress 애드온은 최신 계열에서 Traefik 중심으로 바뀌었고, k3s도 기본 Ingress Controller로 Traefik을 포함합니다. 여기에 k3s 1.37부터는 Gateway API CRD가 번들로 제공되기 시작했습니다. 앞으로 새 클러스터를 만든다면 단순히 Ingress만 볼 게 아니라 Kubernetes Gateway API, Traefik Gateway, Cilium Gateway API 같은 선택지도 함께 비교하는 게 좋습니다.

    3. 홈랩 쿠버네티스와 엣지 쿠버네티스 운영 포인트

    홈랩에서는 설치보다 백업, 인증서, 스토리지, 자동 업데이트 관리가 더 중요합니다. k3s라면 etcd/SQLite 백업과 /etc/rancher/k3s 설정 보관, MicroK8s라면 snap refresh 정책과 애드온 상태 점검을 운영 체크리스트에 넣어두세요.

    4. Kubernetes 1.37 시대의 새 키워드: Gateway API와 워크로드 스케줄링

    Kubernetes 1.37에서는 Gateway API, 동적 리소스 할당(DRA), 워크로드 인식 스케줄링 같은 흐름이 더 중요해졌습니다. k3s와 MicroK8s를 비교할 때도 이제는 단순히 가볍냐 무겁냐만 볼 게 아니라, 엣지 AI 워크로드, GPU 워크로드, 로컬 쿠버네티스 개발환경, GitOps 운영까지 함께 고려하는 쪽이 더 현실적입니다.


    마무리 — 그래서 저는 뭘 쓰냐고요?

    제 기준은 단순합니다. 홈랩, 라즈베리파이, 엣지 장비, 작고 오래 가는 클러스터라면 k3s를 고릅니다. Ubuntu 개발 장비에서 빠르게 켜고 끄는 테스트 클러스터, 애드온을 손쉽게 붙여보는 실험 환경이라면 MicroK8s를 고릅니다.

    둘 다 좋은 도구입니다. 다만 운영 방식이 다릅니다. k3s는 작고 조용하게 오래 가는 쪽에 가깝고, MicroK8s는 Ubuntu 생태계 안에서 빠르게 실험하고 확장하는 쪽에 가깝습니다. 결국 답은 내 환경이 어떤 실패를 견뎌야 하는지에 달려 있습니다.

    🔄 마지막 업데이트: 2026년 09월