13년차의 서버실

서버, 인프라, 홈랩 기술 블로그

[태그:] 컨테이너 오케스트레이션

  • [OpenStack] OpenStack Magnum, 왜 다시 주목받나? CAPI Helm 최신 동향

    [OpenStack] OpenStack Magnum, 왜 다시 주목받나? CAPI Helm 최신 동향

    [인프라] OpenStack Magnum, 왜 다시 주목받나?

    OpenStack Magnum을 다시 보는 이유는 예전과 조금 다릅니다. 2026년 8월 기준 공식 문서와 릴리즈 노트를 다시 읽어보면, 지금의 Magnum은 단순히 Heat로 클러스터를 띄우는 오래된 서비스로 보기 어렵더라고요. 방향이 분명히 Cluster API 기반 Kubernetes as a Service 쪽으로 옮겨갔기 때문입니다.

    핵심은 이제 “쿠버네티스를 한 번 띄우는 법”이 아닙니다. Keystone 인증, Neutron 네트워크, Cinder 스토리지, Octavia 로드밸런서, Barbican 인증서 저장 같은 OpenStack 자원을 하나의 운영 모델로 묶을 수 있느냐가 더 중요하거든요. 이 글에서는 OpenStack Magnum을 언제 검토할 만한지, 반대로 언제 과감히 제외하는 게 맞는지 실무 관점으로 정리해 보겠습니다.
    OpenStack Magnum과 Cluster API 기반 프라이빗 클라우드 아키텍처 개요

    OpenStack Magnum이 Keystone, Neutron, Cinder, Octavia와 어떻게 연결되고 Cluster API 기반으로 Kubernetes 클러스터를 관리하는지 보여주는 개요 이미지입니다.

    1. OpenStack Magnum을 볼 때 먼저 버려야 할 오해

    Magnum을 아직도 “Heat로 쿠버네티스를 띄우는 서비스”로만 보면 판단이 자꾸 어긋납니다. 최신 Magnum 사용자 가이드는 Heat 드라이버가 deprecated이며, 앞으로 제거될 예정이라고 분명히 적고 있습니다. 신규 설계에서 Heat를 기본 전제로 잡는 건 이제 장기 운영 관점에서 무리가 있습니다.

    지금 봐야 할 축은 k8s_capi_helm과 k8s_cluster_api입니다. 특히 magnum-capi-helm은 OpenStack 거버넌스 아래에서 유지되고 있고, 공식 릴리즈 노트는 이 드라이버를 production use에 generally ready라고 설명합니다. 다만 이 표현을 곧바로 “대규모 운영에 아무 검증도 필요 없다”로 받아들이면 곤란합니다. 제 해석은 이렇습니다. 이제 Magnum의 실전성은 클러스터 생성 성공 여부보다, 관리 클러스터와 Cluster API 수명주기를 얼마나 안정적으로 운영하느냐에 달려 있습니다.

    • 예전 시선: Magnum이 Heat 템플릿으로 인프라를 직접 밀어 올린다.
    • 지금 시선: Magnum은 OpenStack API 진입점이고, 실제 클러스터 수명주기는 Cluster API와 provider가 선언적으로 맞춘다.
    • 실무 함의: 장애 지점도 Magnum API, 관리 클러스터, CAPO, Helm chart, addon reconciliation까지 넓게 봐야 한다.

    구성요소가 늘어나니 관찰 포인트도 많아집니다. 그래도 장점은 분명합니다. 예전에는 여기저기 흩어져 있던 업그레이드, 노드그룹 변경, autoscaling, 기본 정책 강제가 이제 플랫폼 계층에서 조금 더 정리되기 시작했거든요.

    2. OpenStack Magnum이 다시 주목받는 이유

    2026년 기준으로 다시 볼 만한 이유는 다섯 가지 정도로 압축됩니다.

    1. 공식 방향이 Heat에서 CAPI 계열로 옮겨갔습니다. Heat는 유지 중인 환경을 이해하는 용도에 가깝고, 신규 표준으로 추천되는 분위기는 아닙니다.
    2. magnum-capi-helm의 성숙도가 높아졌습니다. 공식 릴리즈 노트는 production use에 generally ready라고 밝히지만, 동시에 예상하지 못한 이슈 가능성도 언급합니다. 즉, 실전 배치 가능성은 높아졌지만 검증 책임이 사라진 건 아닙니다.
    3. 생성보다 변경 관리가 중심으로 들어왔습니다. create, delete, upgrade, node group size update 같은 수명주기 작업이 문서 중심에 올라와 있습니다.
    4. autoscaling 범위가 넓어졌습니다. 기본 워커뿐 아니라 non-default worker node group에도 min/max 정책을 줄 수 있고, 최신 릴리즈 노트 기준으로 min_node_count=0을 통한 scale-to-zero도 지원합니다. 다만 이 기능은 capi-helm-charts >= 0.26.0과 cluster-api-provider-openstack >= 0.26.0 조건을 확인해야 합니다.
    5. 운영자 기본값 설계가 쉬워졌습니다. [capi_helm_cluster_labels] 섹션에서 사이트 전역 기본 라벨을 둘 수 있어서 사용자 자유도와 플랫폼 일관성의 균형을 잡기 편해졌습니다.

    한 문장으로 줄이면 이렇습니다. OpenStack Magnum은 더 이상 “OpenStack에 쿠버네티스를 얹는 기능”이 아니라, OpenStack 조직 구조 안에서 Kubernetes 수명주기를 표준화하는 서비스에 가까워졌습니다.

    선택지 어울리는 환경 강점 숨은 비용 제 판단
    직접 kubeadm 운영 소규모 팀, 단일 클러스터, 빠른 실험 단순하게 시작 가능 업그레이드, 인증, 스토리지, LB 연동을 팀이 직접 책임져야 함 초반은 빠르지만 플랫폼화 단계에서 부담이 커짐
    Magnum + legacy Heat 이미 운영 중인 기존 환경 현재 자산을 당장 버리지 않아도 됨 공식 방향과 어긋나고 신규 기능 이점이 제한적 유지는 가능하지만 신규 표준으로는 비추천
    Magnum + CAPI Helm OpenStack 기반 프라이빗 KaaS OpenStack 자원과 일관된 수명주기 운영 관리 클러스터와 버전 조합 검증 필요 OpenStack이 핵심 플랫폼이면 가장 현실적
    외부 managed Kubernetes 퍼블릭 클라우드 우선, 운영 단순화가 최우선 제어면 운영 부담 감소 내부망, 규제, OpenStack 통합 요구에는 약할 수 있음 OpenStack 통합 가치가 작으면 이쪽이 더 나음

    3. OpenStack Magnum 운영에서 더 중요한 건 기본값 설계

    현장에서 진짜 갈리는 지점은 Magnum 자체보다 기본값을 어떻게 잠그느냐입니다. 많은 글이 ClusterTemplate 예제만 보여주고 끝나는데, 운영팀은 그 전에 무엇을 사용자 자율에 맡길지, 무엇을 플랫폼 기본값으로 강제할지 먼저 정해야 하거든요. 이걸 늦게 정하면 클러스터가 늘어날수록 편차가 커집니다.

    최신 magnum-capi-helm 설정 레퍼런스를 보면 핵심 섹션은 [capi_helm]와 [capi_helm_cluster_labels]입니다. 시작점으로는 아래와 같은 구성이 무난합니다.

    [capi_helm]
    kubeconfig_file = /etc/magnum/kubeconfig
    namespace_prefix = magnum
    helm_chart_repo = https://azimuth-cloud.github.io/capi-helm-charts
    helm_chart_name = openstack-cluster
    default_helm_chart_version = 0.26.0
    minimum_flavor_ram = 2048
    minimum_flavor_vcpus = 2
    
    [capi_helm_cluster_labels]
    auto_scaling_enabled = true
    min_node_count = 1
    max_node_count = 5
    monitoring_enabled = true
    kube_dashboard_enabled = false
    auto_healing_enabled = true
    keystone_auth_enabled = true
    octavia_provider = amphora
    octavia_lb_healthcheck = true
    csi_cinder_reclaim_policy = Retain
    csi_cinder_volume_binding_mode = WaitForFirstConsumer
    csi_cinder_allow_volume_expansion = true
    master_lb_floating_ip_enabled = true
    api_master_lb_allowed_cidrs = 10.20.0.0/16
    fixed_subnet_cidr = 10.40.0.0/24
    pod_network_cidr = 10.100.0.0/16
    service_network_cidr = 172.24.0.0/13

    몇 가지는 그냥 옵션 나열로 보면 안 됩니다.

    • kubeconfig_file: Magnum이 붙는 CAPI management cluster의 kubeconfig입니다. 이 관리 클러스터가 흔들리면 생성뿐 아니라 업그레이드와 노드그룹 변경도 같이 막힙니다.
    • namespace_prefix: 여러 Magnum 배포가 하나의 관리 클러스터를 공유할 때 충돌을 피하는 최소 장치입니다.
    • default_helm_chart_version: 여기서 버전을 통제하지 않으면 사용자별 드리프트가 시작됩니다.
    • minimum_flavor_ram, minimum_flavor_vcpus: 성능 튜닝이라기보다 실패 방지용 안전장치에 가깝습니다.
    • csi_cinder_volume_binding_mode=WaitForFirstConsumer: 멀티 AZ나 토폴로지 제약이 있는 환경에서는 특히 보수적으로 가져가는 편이 안전합니다.
    • api_master_lb_allowed_cidrs: Kubernetes API를 너무 넓게 여는 실수가 의외로 자주 나옵니다. 초기에 편하다고 넓게 열면 나중에 되돌리는 비용이 더 큽니다.

    제가 보는 핵심 질문은 하나입니다. 사용자가 바꿔야 하는 값과 플랫폼이 묶어야 하는 값을 구분했는가? OpenStack 기반 KaaS는 자유도보다 일관성이 중요할 때가 많습니다. 특히 여러 프로젝트가 같은 기반 인프라를 쓰는 조직에서는 더 그렇습니다. 이전에 다뤘던 Neutron·Octavia 운영 글과 함께 보면 이 경계가 더 또렷하게 잡힙니다.
    magnum.conf와 ClusterTemplate 라벨 설정 흐름 다이어그램

    운영자 설정 파일에서 기본 라벨을 정의하고, 사용자가 ClusterTemplate와 Cluster 생성 시 이를 어떻게 상속하거나 덮어쓰는지 보여주는 이미지입니다.

    4. ClusterTemplate는 청사진이 아니라 운영 계약서입니다

    ClusterTemplate를 만들 때 흔한 실수는 “생성만 되면 된다”는 태도로 옵션을 넣는 겁니다. 그렇게 만든 템플릿은 나중에 업그레이드, 보안, 확장성에서 발목을 잡습니다. Magnum의 템플릿은 사용자에게 노출되는 상품 정의서에 더 가깝습니다.

    아래 예시는 공식 CLI 문법에 맞춰 정리한 시작 예시입니다. 다만 이미지 이름이나 flavor 이름은 환경마다 다르니, 실제 배포 전에는 운영 중인 Glance 이미지와 Nova flavor를 먼저 맞춰 확인하는 편이 좋습니다.

    openstack coe cluster template create k8s-capi-template \
      --coe kubernetes \
      --image <validated-kubernetes-image> \
      --external-network public \
      --fixed-network tenant-net-prod \
      --fixed-subnet tenant-subnet-prod \
      --dns-nameserver 8.8.8.8 \
      --flavor m1.large \
      --master-flavor m1.large \
      --network-driver calico \
      --master-lb-enabled \
      --labels auto_scaling_enabled=true,min_node_count=1,max_node_count=3,monitoring_enabled=true,keystone_auth_enabled=true,octavia_provider=amphora,csi_cinder_volume_binding_mode=WaitForFirstConsumer,csi_cinder_reclaim_policy=Retain,api_master_lb_allowed_cidrs=10.20.0.0/16,pod_network_cidr=10.100.0.0/16,service_network_cidr=172.24.0.0/13 \
      k8s-capi-template
    
    openstack coe cluster create prod-k8s-01 \
      --cluster-template k8s-capi-template \
      --master-count 3 \
      --node-count 2 \
      --timeout 90 \
      prod-k8s-01
    
    openstack coe cluster config --dir ./kubeconfig --force prod-k8s-01
    export KUBECONFIG=./kubeconfig/config
    kubectl get nodes -o wide
    kubectl get storageclass
    kubectl get pods -A

    여기서 체크할 기준은 분명합니다.

    • 신규 구축이면 control plane 고가용성과 로드밸런서 경로를 먼저 잡는 편이 낫습니다. 실제로 magnum-capi-helm 문서는 업그레이드 안정성 측면에서 로드밸런서 사용을 강하게 시사합니다.
    • 운영 안정성이 우선이면 CNI는 Calico부터 시작하는 편이 안전합니다. 공식 문서도 Cilium 지원은 언급하지만, 정기 검증은 Calico 중심이라고 설명합니다.
    • master-lb-enabled는 CLI 옵션으로 존재하지만, CAPI Helm 문서상 현재 드라이버는 이 플래그를 사실상 무시합니다. 실무적으로는 로드밸런서를 전제로 설계하는 편이 낫습니다.

    그리고 하나 더 있습니다. autoscaling을 켜면 초기 워커 수 해석이 Heat 시절과 다를 수 있습니다. 공식 릴리즈 노트에 따르면 auto_scaling_enabled=true일 때 min_node_count, max_node_count를 존중하며, 이 경우 기본 워커는 node_count 대신 최소 노드 수로 시작할 수 있습니다. 이 부분은 운영팀이 미리 공유해 두는 게 좋습니다.

    5. nodegroup 설계가 좋으면 운영 절반은 끝납니다

    실무에서 비용과 안정성을 동시에 좌우하는 건 워커를 한 덩어리로 둘지, 역할별 nodegroup으로 나눌지입니다. OpenStack 위에서 Magnum을 쓸 때는 기본 워커 그룹 하나로 오래 버티는 설계가 나중에 꽤 답답해지더라고요.

    • 스토리지 성격이 다른 워크로드가 섞입니다.
    • ingress, 배치, 일반 애플리케이션의 확장 패턴이 다릅니다.
    • flavor 요구사항도 달라집니다.
    • scale-to-zero 같은 정책은 특정 그룹에만 적용하고 싶은 경우가 많습니다.

    그래서 역할 분리를 먼저 해두는 편이 낫습니다.

    openstack coe nodegroup create \
      --node-count 2 \
      --min-nodes 2 \
      --max-nodes 6 \
      --flavor m1.large \
      --role worker \
      --labels workload=general \
      prod-k8s-01 general-workers
    
    openstack coe nodegroup create \
      --node-count 1 \
      --min-nodes 0 \
      --max-nodes 4 \
      --flavor m1.xlarge \
      --role worker \
      --labels workload=batch \
      prod-k8s-01 batch-workers
    
    openstack coe nodegroup list prod-k8s-01
    openstack coe nodegroup show prod-k8s-01 batch-workers
    openstack coe cluster resize --nodegroup general-workers prod-k8s-01 3

    min_node_count=0은 확실히 매력적입니다. 다만 공식 릴리즈 노트 기준으로 scale-to-zero는 capi-helm-charts 0.26.0 이상과 cluster-api-provider-openstack 0.26.0 이상이 필요합니다. 조건이 안 맞으면 명시적 에러가 납니다. 이건 단순 옵션 문제가 아니라 플랫폼 버전 관리 문제로 봐야 합니다.

    워크로드 유형 추천 nodegroup 전략 이유 피해야 할 설계
    일반 웹/백엔드 기본 worker 그룹, min 2 이상 가용성과 예측 가능한 확장성 확보 모든 역할을 한 그룹에 섞기
    배치/야간 작업 별도 worker 그룹, 조건 충족 시 scale-to-zero 유휴 자원 점유 감소 stateful 서비스와 동일 그룹 사용
    Ingress/Gateway 별도 flavor와 보수적 min/max 트래픽 급변 대응과 네트워크 역할 분리 일반 앱 노드와 동일 정책
    스토리지 민감 워크로드 AZ와 volume 정책을 고려한 별도 그룹 Cinder 바인딩 충돌 감소 Immediate 바인딩 남용

    6. OpenStack Magnum 장애는 생성 실패보다 상태 전이 실패가 더 까다롭습니다

    문서만 보면 클러스터 생성 성공 여부가 가장 중요해 보입니다. 그런데 실무에서는 CREATE_IN_PROGRESS가 왜 오래 가는지, DELETE_IN_PROGRESS에서 왜 자원이 남는지, 노드는 떴는데 왜 Ready가 안 되는지를 빨리 분리하는 쪽이 훨씬 중요합니다.

    저는 장애를 볼 때 계층을 네 개로 나눠서 봅니다.

    • Magnum API 계층: 요청이 접수되고 상태 전이가 시작됐는가
    • OpenStack 인프라 계층: Nova, Neutron, Octavia, Cinder 자원이 기대대로 생성됐는가
    • CAPI management cluster 계층: CRD와 controller가 reconciliation을 정상 수행하는가
    • 워크로드 클러스터 계층: kubelet, CNI, CSI, addon이 정상 기동하는가

    이 구분 없이 한 화면만 보면 시간이 꽤 많이 날아갑니다. 아래처럼 대조해 보는 습관이 실제로 편합니다.

    openstack coe cluster show prod-k8s-01
    openstack coe nodegroup list prod-k8s-01
    openstack coe nodegroup show prod-k8s-01 general-workers
    openstack server list --name prod-k8s-01
    openstack loadbalancer list
    kubectl --kubeconfig /etc/magnum/kubeconfig get clusters.cluster.x-k8s.io -A
    kubectl --kubeconfig /etc/magnum/kubeconfig get machinedeployments.cluster.x-k8s.io -A
    kubectl --kubeconfig /etc/magnum/kubeconfig get openstackmachines.infrastructure.cluster.x-k8s.io -A

    이 명령 묶음이 좋은 이유는 분명합니다. Magnum에서 보이는 추상 상태와 CAPI에서 실제 reconcile 중인 객체 상태를 한 번에 비교할 수 있기 때문입니다.

    7. 자주 막히는 실패 모드와 원인

    7-1. Pod/Service CIDR 겹침: 증상은 Kubernetes인데 원인은 주소 설계일 때가 많습니다

    최신 설정 레퍼런스의 기본값은 fixed_subnet_cidr=10.0.0.0/24, pod_network_cidr=10.100.0.0/16, service_network_cidr=172.24.0.0/13입니다. 공식 문서도 Pod/Service CIDR가 OpenStack provider나 external network subnet과 겹치면 안 된다고 설명합니다.

    현장에서는 CNI부터 의심하기 쉽지만, 실제 원인이 Neutron 주소계획 충돌인 경우가 정말 있습니다. 이 부분은 감으로 보지 말고 숫자로 대조하는 게 빠릅니다.

    openstack subnet list
    openstack network list
    openstack coe cluster template show k8s-capi-template -f yaml
    openstack coe cluster show prod-k8s-01 -f yaml
    kubectl get nodes -o wide
    kubectl get pods -A -o wide

    7-2. Cilium 선택: 지원과 운영 추천은 다른 말입니다

    공식 릴리즈 노트에는 network_driver로 calico와 cilium을 선택할 수 있다고 나옵니다. 다만 magnum-capi-helm 구성 문서는 현재 정기 테스트가 Calico 중심이라고 적고 있습니다. 그래서 제 추천은 단순합니다. 운영 서비스 중심이면 Calico, 특정 네트워크 기능 검증이 목적이면 Cilium입니다.

    7-3. scale-to-zero 실패: autoscaling보다 버전 매트릭스를 먼저 봐야 합니다

    min_node_count=0이 안 먹는다면 autoscaler 설정만 볼 게 아닙니다. 공식 릴리즈 노트는 차트와 provider 버전 조건이 맞지 않으면 명시적으로 막는다고 설명합니다. 그래서 scale-to-zero 같은 기능은 사용자 문서보다 플랫폼 지원 매트릭스를 먼저 정리해 두는 게 훨씬 낫습니다.

    7-4. DELETE_IN_PROGRESS 잔류: 상태 표시와 실자원 정리는 다를 수 있습니다

    최신 릴리즈 노트에는 non-default node group 삭제 시 DELETE_IN_PROGRESS에 머물고 VM이 남는 이슈가 수정됐다고 나옵니다. 실무적으로 중요한 포인트입니다. 화면상 삭제 중인데 실제 자원 점유가 계속될 수 있기 때문이죠.

    • Magnum 상태: nodegroup 또는 cluster 상태 전이
    • 실자원 상태: Nova 인스턴스, 로드밸런서, 볼륨 잔존 여부

    7-5. 인증서 저장: 동작보다 수명주기 관리가 더 중요합니다

    Magnum 설치 가이드는 kubectl 접근용 TLS 인증서를 저장할 때 Barbican 사용을 권장합니다. 데이터베이스 저장도 가능하지만, 운영 환경에서는 누가 접근을 통제하고 어떻게 회전하고 감사 추적을 남길지가 더 중요하거든요. 이건 실제로 커질수록 차이가 크게 납니다.

    8. 무엇을 보면 정상이라고 판단할까

    클러스터가 생성됐다고 바로 정상 판정을 내리면 위험합니다. OpenStack 위의 KaaS는 클러스터 내부 상태와 OpenStack 연동 상태를 같이 봐야 하거든요. 저는 최소한 아래 네 묶음을 통과해야 초기 정상으로 봅니다.

    openstack coe cluster show prod-k8s-01 -f yaml
    kubectl get nodes
    kubectl get pods -A
    kubectl get storageclass
    kubectl get pvc -A
    kubectl cluster-info
    • Cluster 상태: 상태가 완료로 수렴하는지, API 주소가 기대대로 생성됐는지 확인합니다.
    • Node 상태: 모든 노드가 Ready인지 봅니다.
    • 스토리지 상태: 기본 StorageClass가 의도한 reclaim policy와 binding mode를 사용하는지 확인합니다.
    • API 접근 경로: 업그레이드 계획이 있다면 API endpoint가 로드밸런서 뒤에서 안정적으로 열리는지 확인해야 합니다.

    그리고 하나 더요. 정상 판정은 단발성 스냅샷보다 상태 전이의 일관성으로 보는 편이 낫습니다. 생성 직후 잠깐 좋아 보이는 건 큰 의미가 없더라고요.
    OpenStack Magnum으로 배포된 Kubernetes 클러스터 검증 화면과 상태 점검 개요

    클러스터 생성 완료 후 노드 상태, 스토리지 클래스, API 엔드포인트, 로드밸런서 연결 상태를 함께 검증하는 장면을 표현한 이미지입니다.

    9. 그래서 OpenStack Magnum은 언제 쓰고, 언제 쓰지 말아야 할까

    • OpenStack이 이미 조직의 핵심 플랫폼이고, 프로젝트 단위로 Kubernetes를 표준 서비스처럼 공급해야 한다면 Magnum을 검토할 가치가 충분합니다.
    • 기존 Heat 기반 Magnum 기억만으로 판단하면 안 됩니다. 공식 방향은 CAPI 계열에 집중돼 있습니다.
    • 퍼블릭 클라우드 managed Kubernetes 제약이 없고 OpenStack 통합 요구가 약하면 Magnum을 굳이 들고 오지 않는 편이 낫습니다.
    • 멀티테넌시, 내부망, 규제, 인증 통합, 스토리지 정책 일관성이 중요하면 Magnum 쪽 설득력이 커집니다.
    • 신규 구축이면 처음부터 CAPI Helm 기준으로 설계하는 편이 낫습니다.
    • 운영 안정성이 우선이면 Calico, 실험 목적이 분명할 때만 Cilium을 권합니다.
    • autoscaling이 필요하면 nodegroup 분리부터 먼저 설계해야 합니다.
    • 업그레이드를 생각한다면 API 로드밸런서를 전제로 잡는 편이 덜 아픕니다.
    OpenStack Magnum 도입 판단 기준과 선택 시나리오 요약 인포그래픽

    OpenStack Magnum을 도입해야 할 상황과 그렇지 않은 상황을 한눈에 비교하는 요약 이미지입니다.

    10. 결론: OpenStack Magnum은 이제야 자기 자리를 찾는 중입니다

    결론은 꽤 분명합니다. OpenStack Magnum은 지금 프라이빗 클라우드 안에서 Kubernetes를 OpenStack 자원처럼 제공하고 운영하려는 팀에게 다시 현실적인 선택지가 되고 있습니다. 유행이라서가 아니라 역할이 더 또렷해졌기 때문입니다.

    물론 환상은 버려야 합니다. Magnum을 넣는다고 운영이 자동으로 쉬워지지는 않습니다. 대신 운영 난이도가 개별 팀의 임시 스크립트와 수작업에서 플랫폼 차원의 제어로 옮겨갑니다. 이 차이가 꽤 큽니다.

    제 추천은 간단합니다. 기존 Heat 기반 환경은 CAPI 전환 검토를 시작하고, 신규 구축은 처음부터 CAPI Helm 기준으로 설계하세요. 반대로 OpenStack 통합 가치가 약한 조직이라면 외부 managed Kubernetes가 더 나을 수 있습니다. 이건 취향보다 운영 모델의 문제에 가깝습니다.

    다음 단계까지 이어간다면 두 가지를 먼저 정리해 두면 좋겠습니다. 하나는 관리 클러스터 운영 책임 주체, 다른 하나는 지원할 chart/provider 버전과 nodegroup 정책 매트릭스입니다. 이 두 가지가 정리되면 OpenStack Magnum이 훨씬 덜 추상적으로 보입니다.
    11. 참고한 공식 문서

  • [k8s] AWX로 쿠버네티스 워크플로우 자동화: 실전 가이드

    [k8s] AWX로 쿠버네티스 워크플로우 자동화: 실전 가이드

    안녕하세요, 13년차 인프라 엔지니어 ’13년차의 서버실’ 주인장입니다. 오늘은 많은 분들이 고민하시는 쿠버네티스(Kubernetes) 워크플로우 자동화에 대해 이야기해보려고 해요. 특히 AWX를 활용해서 어떻게 복잡한 배포 과정을 효율적으로 관리할 수 있는지, 제가 직접 겪었던 경험과 실전 사례를 중심으로 풀어볼까 합니다. Ansible과 DevOps 문화에 관심 있는 분들이라면 이번 글이 정말 도움이 될 거예요.

    저도 처음엔 쿠버네티스 클러스터에 애플리케이션을 배포하는 과정이 꽤나 번거롭더라고요. 매번 kubectl apply -f 명령어를 입력하고, 버전 관리하고, 환경별로 설정 바꾸고… 반복적인 작업은 언제나 실수의 여지를 남기기 마련이잖아요. 그러다 보니 자연스럽게 자동화의 필요성을 느끼게 됐고, 홈랩에서 AWX(Ansible Workflow eXecutor)를 활용한 솔루션을 모색하게 됐습니다. 직접 삽질해가며 구축했던 과정, 지금부터 솔직하게 공유해볼게요.

    AWX와 쿠버네티스 연동을 통한 워크플로우 자동화 개요 아키텍처 다이어그램, AWX가 Git에서 Ansible Playbook을 가져와 쿠버네티스에 배포하는 과정을 보여줍니다.

    AWX와 쿠버네티스 연동을 통한 워크플로우 자동화 개요 아키텍처 다이어그램. AWX가 Git 저장소에서 Ansible Playbook을 가져와 쿠버네티스 API를 통해 리소스를 배포하는 과정을 보여줍니다.

    AWX와 쿠버네티스, 왜 함께 써야 할까요?

    먼저 핵심 개념부터 짚고 넘어갈게요. AWX는 Ansible Automation Platform의 업스트림 오픈소스 프로젝트로, 웹 기반 UI를 통해 Ansible Playbook을 실행하고 관리해주는 도구예요. 쉽게 말해, 터미널에서 명령어로 실행하던 Ansible 작업을 UI로 편하게 스케줄링하고, 권한을 관리하고, 실행 결과를 모니터링할 수 있다는 거죠. 제가 홈랩에서 다양한 자동화 실험을 할 때 정말 유용하게 써먹고 있는 녀석입니다.

    그리고 쿠버네티스(Kubernetes, K8s)는 컨테이너화된 워크로드와 서비스를 자동으로 배포, 스케일링 및 관리해주는 오픈소스 시스템이에요. 컨테이너 오케스트레이션(Container Orchestration)의 사실상 표준이 되었죠. 선언적(Declarative) 방식으로 원하는 상태를 정의하면, 쿠버네티스가 그 상태를 유지하도록 알아서 관리해줍니다. 저는 주로 Deployment(디플로이먼트)와 Service(서비스), Ingress(인그레스, 외부 트래픽 진입점) 같은 리소스들을 YAML 파일로 정의해서 사용하고 있어요.

    이 둘을 함께 쓰면 어떤 시너지가 생길까요? 바로 선언적 인프라(Declarative Infrastructure) 관리가 가능해진다는 거예요. Ansible Playbook으로 쿠버네티스 리소스의 최종 상태를 정의하고, AWX가 이 Playbook을 실행해서 클러스터에 배포하는 방식이죠. 이렇게 하면 수동 작업으로 인한 오류를 줄이고, 배포 과정을 표준화하며, 지속적인 통합/배포(CI/CD) 워크플로우를 구축하는 데 정말 큰 도움이 돼요. 실제 운영 환경에서 이 조합은 정말 강력하더라고요.

    실전 구현: AWX로 쿠버네티스 워크플로우 자동화하기

    자, 그럼 이제 제가 직접 구축했던 방법을 단계별로 보여드릴게요. 목표는 AWX를 통해 간단한 Nginx 웹 서버를 쿠버네티스 클러스터에 배포하고, 외부에 노출시키는 거예요.

    1단계: AWX 환경 설정

    1. 인벤토리(Inventory) 생성: AWX에서 Playbook을 실행할 대상(Host)을 정의합니다. 여기서는 쿠버네티스 클러스터의 API 서버에 접근해야 하므로, 로컬 호스트를 대상으로 하거나, 쿠버네티스 API 엔드포인트를 지정해요. 저는 주로 localhost를 대상으로 하고, kubeconfig 파일을 통해 클러스터에 접근하는 방식을 선호합니다.
    2. 자격 증명(Credential) 생성: 쿠버네티스 클러스터에 접근하기 위한 자격 증명이 필요해요. kubeconfig 파일을 AWX에 등록하는 방법이 가장 일반적입니다.
    # AWX Credential 설정 예시 (Kubeconfig Type)
    # --- Kubeconfig 내용 --- (실제 파일 내용)
    apiVersion: v1
    clusters:
    - cluster:
        certificate-authority-data: ...
        server: https://your-kubernetes-api-server:6443
      name: my-cluster
    contexts:
    - context:
        cluster: my-cluster
        user: my-user
      name: my-context
    current-context: my-context
    kind: Config
    preferences: {}
    users:
    - name: my-user
      user:
        client-certificate-data: ...
        client-key-data: ...
    

    2단계: Ansible Playbook 작성

    쿠버네티스 리소스를 배포하기 위한 Playbook을 작성해요. Ansible이 제공하는 kubernetes.core.k8s 모듈로 쿠버네티스 리소스 관리가 정말 쉬워진다니까요. 저는 Nginx Deployment와 Service를 배포하는 Playbook을 만들었어요.

    # playbook.yaml
    ---
    - name: Deploy Nginx to Kubernetes
      hosts: localhost
      connection: local
      collections:
        - kubernetes.core
    
      vars:
        namespace: default
        app_name: my-nginx
        image_version: 1.25.3
    
      tasks:
        - name: Ensure Namespace exists
          kubernetes.core.k8s:
            api_version: v1
            kind: Namespace
            name: "{{ namespace }}"
            state: present
    
        - name: Deploy Nginx Deployment
          kubernetes.core.k8s:
            state: present
            definition: |
              apiVersion: apps/v1
              kind: Deployment
              metadata:
                name: "{{ app_name }}-deployment"
                namespace: "{{ namespace }}"
                labels:
                  app: "{{ app_name }}"
              spec:
                replicas: 2
                selector:
                  matchLabels:
                    app: "{{ app_name }}"
                template:
                  metadata:
                    labels:
                      app: "{{ app_name }}"
                  spec:
                    containers:
                    - name: "{{ app_name }}"
                      image: nginx:"{{ image_version }}"
                      ports:
                      - containerPort: 80
    
        - name: Expose Nginx Service
          kubernetes.core.k8s:
            state: present
            definition: |
              apiVersion: v1
              kind: Service
              metadata:
                name: "{{ app_name }}-service"
                namespace: "{{ namespace }}"
                labels:
                  app: "{{ app_name }}"
              spec:
                selector:
                  app: "{{ app_name }}"
                ports:
                  - protocol: TCP
                    port: 80
                    targetPort: 80
                type: NodePort # 또는 LoadBalancer, ClusterIP 등 환경에 맞게
    

    이 Playbook을 Git 저장소(예: GitHub, GitLab)에 커밋해요. AWX가 이 저장소에서 Playbook을 가져와 실행할 거거든요.

    3단계: AWX 프로젝트 및 작업 템플릿(Job Template) 설정

    AWX UI에서 다음을 설정합니다.

    1. 프로젝트(Project) 생성: Git 저장소를 연결하여 Playbook을 가져와요.
    2. 작업 템플릿(Job Template) 생성: 이 템플릿에 위에서 만든 인벤토리, 자격 증명, 프로젝트, 그리고 실행할 Playbook 파일(playbook.yaml)을 연결합니다.
    AWX 작업 템플릿 설정 화면 스크린샷, Git 프로젝트, 인벤토리, 쿠버네티스 자격 증명, 실행할 Playbook 파일을 지정하는 모습

    AWX 작업 템플릿 설정 화면 스크린샷. Git 프로젝트, 인벤토리, 쿠버네티스 자격 증명, 실행할 Playbook 파일을 지정하는 모습을 보여줍니다.

    ⚠️ 삽질 경험 & 워크플로우 자동화 트러블슈팅

    제가 이 AWX와 쿠버네티스 자동화 과정을 진행하면서 겪었던 몇 가지 삽질과 그 해결책을 공유할게요. 혹시 비슷한 문제를 겪는 분들이 있다면 도움이 될 거예요.

    • 인증 오류 (Authentication Error): 가장 흔한 문제 중 하나예요. kubeconfig 파일의 권한 문제, 또는 파일 내용 자체가 잘못된 경우가 많았어요. 특히 client-certificate-data와 client-key-data가 정확한 base64 인코딩 값인지 여러 번 확인했거든요. AWX가 실행되는 컨테이너 환경에서 kubeconfig 파일에 접근 권한이 없어서 생기는 경우도 있었고요. 💡 팁: AWX 컨테이너 내부에서 kubectl get pods를 직접 실행해보며 인증 문제를 디버깅해보세요.
    • YAML 문법 오류: 쿠버네티스 리소스 정의는 YAML 파일로 하는데, 들여쓰기나 오타 하나로도 워크플로우가 실행 안 돼요. 특히 Ansible Playbook 내 definition 블록 안에 YAML을 넣을 때는 더욱 주의해야 합니다. ⚠️ 경고: definition: | 다음 줄부터는 반드시 두 칸 이상 들여쓰기 해야 합니다!
    • Ansible kubernetes.core.k8s 모듈 문제: 처음에는 이 모듈을 쓰는 게 익숙하지 않아서 헤맸어요. 특히 state: present로 리소스를 생성하고, state: absent로 삭제하는 방식에 익숙해지는 데 시간이 좀 걸렸거든요. 그리고 kubeconfig 파일 경로를 명시적으로 지정해야 하는 경우도 있었습니다 (kubeconfig: /path/to/kubeconfig).
    • 네트워크 연결 문제: AWX가 쿠버네티스 API 서버에 접근할 수 없는 네트워크 환경일 경우 당연히 실패하죠. 방화벽 규칙이나 네트워크 정책을 다시 확인해야 해요.

    ✅ 결과 검증 및 자동화의 힘!

    모든 설정이 끝나면, AWX UI에서 작업 템플릿을 실행(Launch)해요. Playbook이 성공적으로 실행되면 AWX 작업 로그에서 초록색 SUCCESS 메시지를 확인할 수 있어요. 저도 이 메시지를 처음 봤을 때, “드디어 됐다!” 하고 쾌재를 불렀던 기억이 생생해요.

    이제 쿠버네티스 클러스터에서 실제로 리소스가 배포되었는지 확인해볼 차례입니다.

    
    kubectl get deployments -n default
    # NAME                  READY   UP-TO-DATE   AVAILABLE   AGE
    # my-nginx-deployment   2/2     2            2           2m
    
    kubectl get services -n default
    # NAME              TYPE       CLUSTER-IP      EXTERNAL-IP   PORT(S)        AGE
    # my-nginx-service   NodePort   10.96.123.456   <none>        80:3xxxx/TCP   2m
    

    정상적으로 Nginx Deployment와 Service가 생성된 걸 확인할 수 있어요. 이제 NodePort로 할당된 포트를 통해 Nginx 웹 서버에 접속하면 “Welcome to Nginx!” 페이지를 볼 수 있을 거예요. 🎉 정말 편리하지 않나요? 몇 번의 클릭만으로 쿠버네티스에 애플리케이션을 배포하는 워크플로우 자동화가 완성된 거죠.

    AWX 작업 성공 로그와 kubectl get pods/deployments 명령 결과 비교 화면, AWX의 성공적인 Task 완료와 쿠버네티스 배포 리소스 확인

    AWX 작업 성공 로그와 kubectl get pods/deployments 명령 결과 비교 화면. AWX의 Job Output에서 Task가 성공적으로 완료된 것을 보여주고, 터미널에서 kubectl 명령어로 배포된 리소스들을 확인하는 모습을 나란히 보여줍니다.

    마무리하며: 자동화, 멈추지 않는 여정

    이번 AWX와 쿠버네티스 연동 사례를 통해 워크플로우 자동화가 얼마나 강력한지 다시 한번 느꼈어요. 단순한 배포를 넘어, IaC(Infrastructure as Code, 코드형 인프라)의 개념을 실현하고, DevOps 파이프라인의 핵심 구성 요소로 활용할 수 있다는 것이 핵심이죠.

    인프라 엔지니어로서 제가 얻은 가장 큰 교훈은 “반복되는 작업은 무조건 자동화하라”는 거예요. 처음엔 자동화 스크립트 작성에 시간이 들지언정, 장기적으로는 시간과 노력을 아끼고, 휴먼 에러를 줄여준다는 걸 뼈저리게 경험했거든요. 이 경험이 여러분의 인프라 관리에도 작은 영감이 되기를 바랍니다.

    다음 글에서는 이 워크플로우를 확장해서 Ingress 컨트롤러를 배포하고, 외부 도메인으로 서비스에 접근하는 방법을 다뤄볼까 해요. 기대해주세요!

    AWX, Ansible, Kubernetes, DevOps 로고들이 원형으로 배치된 인포그래픽. 각 로고들이 서로 연결되어 워크플로우 자동화를 이루는 모습을 시각적으로 보여줍니다.

  • [K8s] 쿠버네티스 Ingress Controller 비교: Nginx, Traefik, Gateway API 선택 가이드

    [K8s] 쿠버네티스 Ingress Controller 비교: Nginx, Traefik, Gateway API 선택 가이드

    쿠버네티스 Ingress Controller, 뭘 써야 할지 모르겠다면?

    쿠버네티스(Kubernetes)를 처음 도입할 때 가장 많이 막히는 부분 중 하나가 바로 Ingress Controller(인그레스 컨트롤러) 선택이에요. 저도 처음엔 “Nginx 쓰면 되는 거 아닌가?” 하고 무심코 설치했다가, 나중에 Traefik이 더 편하다는 걸 알고 갈아엎은 경험이 있거든요. 그리고 최근엔 Gateway API라는 새로운 표준까지 등장해서 선택지가 더 복잡해졌습니다.

    이 글에서는 쿠버네티스 클러스터 운영에서 가장 중요한 선택 중 하나인 Ingress Controller의 세 가지 주요 선택지를 실제 운영 경험을 바탕으로 비교해 드릴게요. 홈랩부터 프로덕션까지 다양한 환경에서 직접 써본 입장에서 솔직하게 이야기해 보겠습니다.

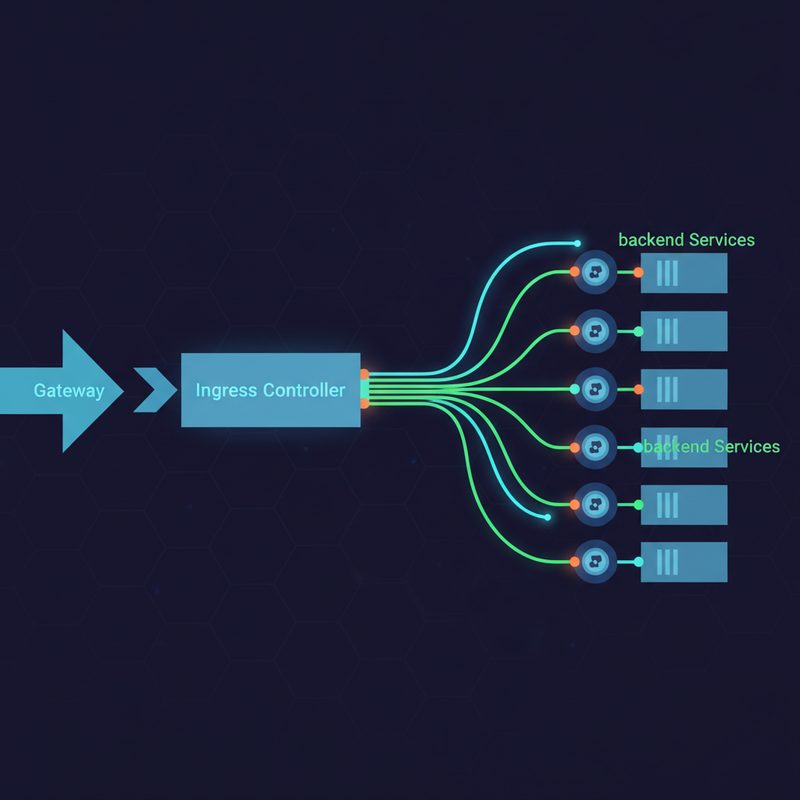
    쿠버네티스 Ingress Controller 전체 아키텍처 — 외부 트래픽이 인그레스 컨트롤러를 통해 내부 서비스로 라우팅되는 구조

    ▲ 쿠버네티스 클러스터에서 외부 트래픽이 Ingress Controller를 거쳐 내부 서비스로 전달되는 전체 흐름 다이어그램

    Ingress Controller가 뭔지부터 짚고 가자

    쉽게 말해서, Ingress(인그레스)는 외부에서 쿠버네티스 클러스터 안으로 들어오는 HTTP/HTTPS 트래픽을 어떻게 라우팅할지 정의하는 규칙이에요. 근데 이 규칙만 있다고 실제로 동작하는 게 아니에요. 규칙을 실제로 실행해 주는 주체가 바로 Ingress Controller(인그레스 컨트롤러)입니다.

    비유하자면, Ingress 리소스는 “1번 도메인은 A 서비스로, 2번 도메인은 B 서비스로 보내라”는 지시서고, Ingress Controller는 그 지시서를 읽고 실제로 트래픽을 처리하는 리버스 프록시(Reverse Proxy) 서버라고 보시면 됩니다.

    쿠버네티스 자체에는 Ingress Controller가 기본 내장되어 있지 않아요. 그래서 우리가 직접 선택해서 설치해야 합니다. 그리고 이 선택이 생각보다 중요한 결정이거든요.

    왜 선택이 중요한가요?

    • 운영 중에 교체하면 서비스 중단이 발생할 수 있어요
    • 각 컨트롤러마다 지원하는 기능과 설정 방식이 달라요
    • 팀의 기술 스택과 러닝 커브도 고려해야 합니다
    • 트래픽 규모와 패턴에 따라 성능 특성이 다르게 나타나요

    세 가지 선택지 한눈에 비교

    본격적인 비교 전에 전체 그림을 먼저 보시죠.

    항목 Nginx Ingress Controller Traefik Gateway API
    기반 기술 Nginx (리버스 프록시) Go 기반 자체 구현 표준 API (구현체 별도)
    설정 방식 Ingress + Annotation Ingress + CRD Gateway/HTTPRoute CRD
    자동 설정 갱신 지원 (일부 재시작 필요) ✅ 완전 동적 구현체에 따라 다름
    대시보드 별도 설치 필요 ✅ 내장 없음 (구현체 의존)
    학습 난이도 낮음 (Nginx 경험자) 중간 높음
    성숙도 매우 높음 높음 성장 중 (GA 달성)
    멀티 팀 지원 제한적 중간 ✅ 설계 목표
    커뮤니티/레퍼런스 매우 풍부 풍부 성장 중

    Nginx Ingress Controller — 검증된 베테랑

    솔직히 말씀드리면, 저도 처음 쿠버네티스 클러스터 구성할 때 고민 없이 Nginx Ingress를 선택했어요. 이유는 단순했습니다. Nginx를 이미 10년 넘게 써왔으니까요.

    Nginx Ingress Controller는 CNCF(Cloud Native Computing Foundation) 산하 프로젝트인 kubernetes/ingress-nginx와, Nginx Inc.에서 만든 nginxinc/kubernetes-ingress 두 가지가 있어요. 헷갈리시는 분들이 많은데, 커뮤니티에서 주로 쓰는 건 전자인 ingress-nginx입니다.

    Helm으로 설치하기

    # Nginx Ingress Controller Helm 설치
    helm repo add ingress-nginx https://kubernetes.github.io/ingress-nginx
    helm repo update
    
    helm install ingress-nginx ingress-nginx/ingress-nginx \
      --namespace ingress-nginx \
      --create-namespace \
      --set controller.replicaCount=2

    기본 Ingress 리소스 예시

    apiVersion: networking.k8s.io/v1
    kind: Ingress
    metadata:
      name: my-app-ingress
      annotations:
        nginx.ingress.kubernetes.io/rewrite-target: /
        nginx.ingress.kubernetes.io/ssl-redirect: "true"
    spec:
      ingressClassName: nginx
      tls:
      - hosts:
        - myapp.example.com
        secretName: myapp-tls
      rules:
      - host: myapp.example.com
        http:
          paths:
          - path: /
            pathType: Prefix
            backend:
              service:
                name: my-app-service
                port:
                  number: 80

    Nginx Ingress의 장단점

    ✅ 장점

    • 레퍼런스가 압도적으로 많아요. 구글에서 뭐든 찾을 수 있습니다
    • Nginx에 익숙한 분들은 Annotation으로 세밀한 튜닝이 가능해요
    • 안정성이 검증된 오랜 역사를 가지고 있습니다
    • 대규모 트래픽 처리에 강점이 있어요

    ⚠️ 단점

    • 설정 변경 시 nginx.conf를 reload해야 해서, 대규모 클러스터에선 부담이 될 수 있어요
    • Annotation이 너무 많아서 처음엔 뭘 써야 할지 헷갈립니다
    • 내장 대시보드가 없어서 별도로 Prometheus + Grafana를 구성해야 해요

    Traefik — 쿠버네티스 네이티브의 매력

    Traefik을 처음 접한 건 홈랩에서 Docker Compose로 운영하다가였어요. 당시에 “이거 레이블(Label) 하나 달면 자동으로 라우팅이 된다고?” 하면서 신기해했던 기억이 납니다. 쿠버네티스에서도 비슷한 경험을 할 수 있어요.

    Traefik의 핵심 철학은 동적 설정(Dynamic Configuration)이에요. 새로운 서비스가 배포되면 자동으로 감지해서 라우팅 규칙을 업데이트합니다. Nginx처럼 reload가 없어요.

    Traefik Helm 설치

    # Traefik Helm 설치
    helm repo add traefik https://helm.traefik.io/traefik
    helm repo update
    
    helm install traefik traefik/traefik \
      --namespace traefik \
      --create-namespace \
      --set dashboard.enabled=true \
      --set ingressRoute.dashboard.enabled=true

    Traefik IngressRoute CRD 예시

    Traefik은 표준 Ingress 리소스도 지원하지만, 자체 CRD인 IngressRoute를 쓰면 훨씬 풍부한 기능을 쓸 수 있어요.

    apiVersion: traefik.io/v1alpha1
    kind: IngressRoute
    metadata:
      name: my-app-ingressroute
      namespace: default
    spec:
      entryPoints:
        - websecure
      routes:
        - match: Host(`myapp.example.com`)
          kind: Rule
          services:
            - name: my-app-service
              port: 80
          middlewares:
            - name: my-ratelimit
      tls:
        certResolver: letsencrypt

    Middleware로 Rate Limiting 적용

    apiVersion: traefik.io/v1alpha1
    kind: Middleware
    metadata:
      name: my-ratelimit
    spec:
      rateLimit:
        average: 100
        burst: 50

    💡 Traefik의 진짜 강점은 Let’s Encrypt 인증서 자동 발급이 내장되어 있다는 거예요. cert-manager를 별도로 설치하지 않아도 TLS 인증서를 자동으로 관리해 줍니다. 홈랩에서 이거 하나 때문에 Traefik으로 갈아탔을 정도로 편하더라고요.

    Traefik 내장 대시보드 화면 — 라우터, 서비스, 미들웨어 현황을 한눈에 확인하는 모니터링 인터페이스

    ▲ Traefik 내장 대시보드에서 라우터, 서비스, 미들웨어 현황을 한눈에 확인할 수 있는 화면

    Traefik의 장단점

    ✅ 장점

    • 동적 설정 갱신 — 서비스 변경 시 reload 없이 즉시 반영돼요
    • 내장 대시보드로 라우팅 현황을 바로 확인할 수 있어요
    • Let’s Encrypt 자동 인증서 발급/갱신 내장
    • Middleware로 인증, Rate Limiting, 헤더 조작 등을 깔끔하게 구성 가능

    ⚠️ 단점

    • CRD 방식이 Nginx Annotation과 달라서 러닝 커브가 있어요
    • Nginx에 비해 레퍼런스가 적습니다 (그래도 요즘은 많이 늘었어요)
    • 초대형 클러스터에서의 성능 검증 사례가 Nginx보다 적은 편이에요

    Gateway API — 쿠버네티스 네트워크의 미래

    처음 Gateway API 문서를 읽었을 때 솔직히 “이게 뭐가 다른 건데?” 싶었어요. 근데 알고 보니 기존 Ingress 리소스의 한계를 근본적으로 해결하려는 시도더라고요.

    Gateway API는 SIG Network(쿠버네티스 네트워킹 특별관심그룹)에서 만든 공식 표준이에요. 2023년에 v1.0으로 GA(Generally Available, 정식 출시)를 달성했습니다. Ingress 리소스를 대체하려는 게 아니라, 더 표현력 있고 역할 기반으로 분리된 네트워크 설정을 가능하게 하는 게 목표예요.

    Gateway API의 핵심 개념

    기존 Ingress는 개발자와 인프라 관리자가 같은 리소스를 수정해야 했어요. Gateway API는 역할을 명확히 분리합니다.

    • GatewayClass: 인프라 제공자가 정의 (“이 구현체를 쓸게”)
    • Gateway: 클러스터 운영자가 정의 (“이 포트, 이 프로토콜로 받을게”)
    • HTTPRoute: 개발자가 정의 (“이 경로는 내 서비스로 보내줘”)

    Gateway API 설치 (CRD 먼저)

    # Gateway API CRD 설치
    kubectl apply -f https://github.com/kubernetes-sigs/gateway-api/releases/download/v1.1.0/standard-install.yaml
    
    # 구현체 예시: Nginx Gateway Fabric
    helm install ngf oci://ghcr.io/nginxinc/charts/nginx-gateway-fabric \
      --namespace nginx-gateway \
      --create-namespace

    Gateway와 HTTPRoute 설정 예시

    # Gateway 리소스 (운영자가 관리)
    apiVersion: gateway.networking.k8s.io/v1
    kind: Gateway
    metadata:
      name: main-gateway
      namespace: infra
    spec:
      gatewayClassName: nginx
      listeners:
      - name: https
        port: 443
        protocol: HTTPS
        tls:
          mode: Terminate
          certificateRefs:
          - name: main-tls-cert
        allowedRoutes:
          namespaces:
            from: Selector
            selector:
              matchLabels:
                gateway-access: allowed
    # HTTPRoute 리소스 (개발자가 관리)
    apiVersion: gateway.networking.k8s.io/v1
    kind: HTTPRoute
    metadata:
      name: my-app-route
      namespace: my-app-ns
    spec:
      parentRefs:
      - name: main-gateway
        namespace: infra
      hostnames:
      - myapp.example.com
      rules:
      - matches:
        - path:
            type: PathPrefix
            value: /api
        backendRefs:
        - name: api-service
          port: 8080
      - matches:
        - path:
            type: PathPrefix
            value: /
        backendRefs:
        - name: frontend-service
          port: 3000

    보이시나요? Gateway는 인프라팀이 관리하고, HTTPRoute는 각 개발팀이 자기 네임스페이스에서 독립적으로 관리할 수 있어요. 멀티 팀 환경에서 진짜 강력한 구조입니다.

    Gateway API의 장단점

    ✅ 장점

    • 역할 기반 분리로 멀티 팀 환경에 최적화되어 있어요
    • 표현력이 풍부해서 복잡한 라우팅 규칙도 명확하게 표현 가능
    • 쿠버네티스 공식 표준이라 장기적으로 생태계 지원이 확대될 거예요
    • 구현체를 교체해도 HTTPRoute 설정은 그대로 재사용 가능 (이식성)

    ⚠️ 단점

    • 개념이 많아서 처음 배우기가 쉽지 않아요. 저도 꽤 헷갈렸습니다
    • 구현체마다 지원하는 기능이 달라서 사전 확인이 필요해요
    • 소규모 팀이나 단순한 환경에선 오버엔지니어링이 될 수 있어요
    • 레퍼런스와 사례가 아직 Nginx/Traefik에 비해 적습니다

    ⚠️ 실제 트러블슈팅 경험담

    각 컨트롤러를 쓰면서 제가 직접 겪은 문제들을 공유할게요.

    Nginx Ingress — 413 Request Entity Too Large

    파일 업로드 기능이 있는 서비스에서 자꾸 413 에러가 났었어요. Nginx 기본 설정의 client_max_body_size 제한 때문이었는데, Annotation으로 해결했습니다.

    metadata:
      annotations:
        nginx.ingress.kubernetes.io/proxy-body-size: "50m"

    Traefik — 인증서가 갱신 안 되는 문제

    Let’s Encrypt 인증서를 Traefik이 자동으로 갱신해 주는 게 편한데, 어느 날 갑자기 인증서 만료 알림이 왔어요. 알고 보니 acme.json 파일이 저장된 PersistentVolume이 Pod 재시작 시 초기화되는 문제였습니다. acme.json은 반드시 영구 스토리지에 마운트해야 해요.

    # values.yaml에서 persistence 설정
    persistence:
      enabled: true
      storageClass: "longhorn"
      size: 128Mi

    Gateway API — 구현체 호환성 확인 필수

    HTTPRoute의 고급 기능(예: RequestRedirect, URLRewrite)을 사용했는데, 특정 구현체에서 지원하지 않아서 라우팅이 묵묵히 실패하는 경우가 있었어요. 구현체의 Conformance Report(적합성 보고서)를 미리 확인하는 게 중요합니다. Gateway API 공식 문서에서 구현체별 지원 기능표를 제공하고 있어요.

    쿠버네티스 Ingress Controller 모니터링 대시보드 — Prometheus와 Grafana를 활용한 요청 수, 에러율, 레이턴시 시각화

    ▲ Prometheus와 Grafana를 활용한 Ingress Controller 모니터링 대시보드 — 요청 수, 에러율, 레이턴시를 실시간으로 확인

    상황별 선택 가이드

    “그래서 뭘 써야 하나요?” 라고 물어보신다면, 상황에 따라 다르다고 답할 수밖에 없어요. 하지만 경험상 이런 기준으로 선택하시면 크게 후회는 없더라고요.

    Nginx Ingress Controller를 선택하세요, 만약…

    • 팀에 Nginx 경험자가 있고, 레퍼런스가 많은 안정적인 선택을 원할 때
    • 대규모 트래픽을 처리해야 하고 검증된 성능이 필요할 때
    • 기존 Nginx 설정을 쿠버네티스로 마이그레이션할 때
    • 복잡한 Nginx 설정(custom snippet 등)이 필요할 때

    Traefik을 선택하세요, 만약…

    • 홈랩이나 소규모 환경에서 편리하게 운영하고 싶을 때
    • Let’s Encrypt 자동 인증서 관리를 간단하게 하고 싶을 때
    • 내장 대시보드로 라우팅 현황을 빠르게 파악하고 싶을 때
    • 동적 환경에서 서비스 변경이 잦을 때

    Gateway API를 선택하세요, 만약…

    • 여러 팀이 각자의 라우팅 설정을 독립적으로 관리해야 할 때
    • 장기적으로 쿠버네티스 표준에 맞춰 가고 싶을 때
    • 복잡한 트래픽 분산(카나리 배포, A/B 테스트 등)이 필요할 때
    • 구현체 이식성을 확보하고 싶을 때
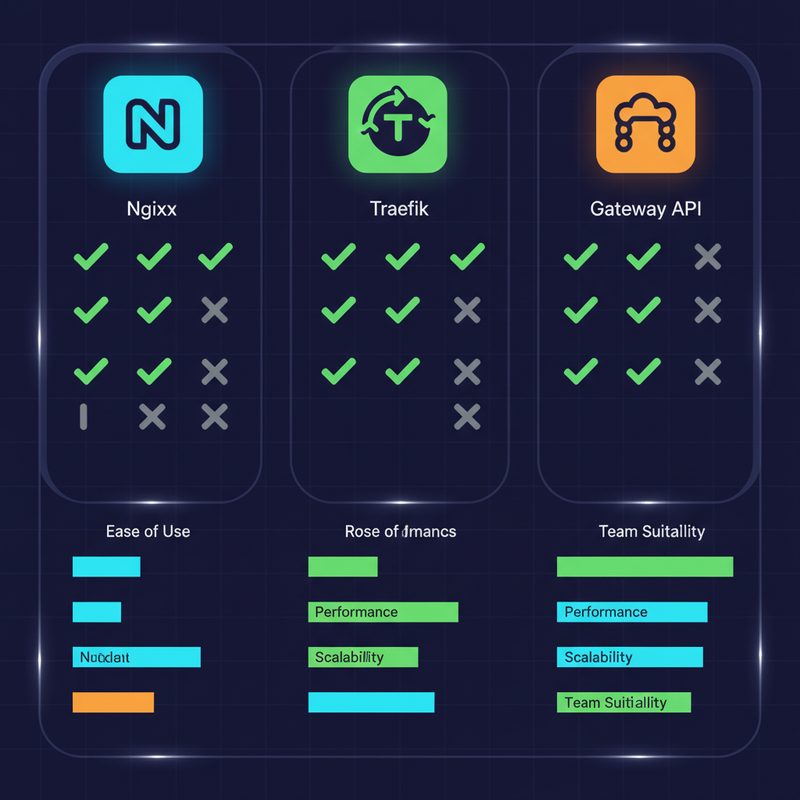
    쿠버네티스 Ingress Controller 비교 인포그래픽 — Nginx Ingress, Traefik, Gateway API 특징과 선택 기준 요약

    ▲ 환경과 요구사항에 따른 Ingress Controller 선택 가이드 요약 인포그래픽

    마무리 — 정답은 없지만, 기준은 있다

    13년 동안 인프라를 운영하면서 느낀 건, 기술 선택에 절대적인 정답은 없다는 거예요. 중요한 건 내 환경과 팀의 요구사항에 맞는 선택을 하는 겁니다.

    개인적으로는 이렇게 정리하고 싶어요.

    • 처음 시작하는 분들: Nginx Ingress로 시작하세요. 레퍼런스가 많아서 막힐 때 찾기 쉬워요
    • 홈랩이나 소규모 팀: Traefik을 강력 추천합니다. 편의성이 정말 좋아요
    • 엔터프라이즈/멀티 팀 환경: Gateway API를 진지하게 검토해 보세요. 미래 방향성이 여기 있거든요

    그리고 하나 더 — 저는 지금 홈랩에서 Traefik을 쓰고, 회사 프로덕션에서는 Nginx Ingress를 씁니다. 두 개 다 쓸 줄 알면 더 좋아요. 😄

    다음 글에서는 Traefik의 Middleware를 활용한 인증/인가(Authentication/Authorization) 설정을 더 자세히 다룰 예정이에요. cert-manager를 이용한 TLS 자동화 내용도 이전 글에서 다룬 적 있으니 참고해 보세요.

    자주 묻는 질문 (FAQ)

    Q. Nginx Ingress Controller와 Nginx Gateway Fabric은 다른 건가요?

    네, 다릅니다. ingress-nginx는 기존 Ingress API 기반이고, Nginx Gateway Fabric은 Gateway API 표준의 구현체예요. 용도와 설정 방식이 다릅니다.

    Q. 하나의 클러스터에 여러 Ingress Controller를 동시에 쓸 수 있나요?

    가능합니다. ingressClassName을 통해 어떤 컨트롤러를 사용할지 지정할 수 있어요. 다만 운영 복잡도가 올라가니 꼭 필요한 경우에만 권장합니다.

    Q. Gateway API는 Ingress를 완전히 대체하나요?

    장기적으로는 그 방향이지만, 현재는 공존하는 상태예요. 기존 Ingress 리소스가 deprecated되지는 않았고, Gateway API가 더 복잡한 요구사항을 위한 차세대 표준으로 자리잡고 있는 중입니다.