13년차의 서버실

서버, 인프라, 홈랩 기술 블로그

[태그:] 클라우드 AI

  • [클라우드] AWS Bedrock 데이터 공유 정책 변경, 한국 기업 영향 분석

    [클라우드] AWS Bedrock 데이터 공유 정책 변경, 한국 기업 영향 분석

    [클라우드] AWS Bedrock 데이터 공유 정책 변경, 한국 기업 영향 분석

    AWS Bedrock 데이터 공유 이슈가 다시 주목받는 이유는 단순합니다. 기업 입장에서는 “우리 프롬프트(prompt, 모델에 넣는 입력)와 응답이 어디로 가는가”가 곧 리스크이기 때문입니다. 특히 클라우드 AI를 실제 업무에 붙이려는 팀이라면 더 민감하죠. 저도 처음엔 이게 뭔가 싶었는데, 실제로 PoC(Proof of Concept, 개념검증) 단계에서 보안팀이 가장 먼저 물어본 게 성능이 아니라 데이터 공유 범위였거든요.

    이번 이슈를 볼 때 중요한 건 하나입니다. 정확히는 시장 전반의 데이터 활용 정책은 계속 바뀌고 있지만, Amazon Bedrock은 공식 FAQ에서 고객 입력과 출력이 모델 제공사와 공유되지 않고, 기본 모델 학습에도 쓰이지 않는다고 명시하고 있습니다. 여기서 한국 기업이 놓칠 수 없는 포인트가 생깁니다. 단순한 기능 비교가 아니라, 개인정보 보호, 국외 이전, 감사 대응, 그리고 벤더 락인(vendor lock-in, 특정 공급자 종속)까지 같이 봐야 한다는 점입니다.
    AWS Bedrock 데이터 공유 구조와 한국 기업 거버넌스를 보여주는 아키텍처 이미지

    Amazon Bedrock에서 애플리케이션, VPC, 모델 추론, 감사 로그가 어떻게 분리되는지 보여주는 개요 다이어그램입니다.

    AWS Bedrock 데이터 공유, 쉽게 말해 뭐가 다른가

    쉽게 말해 Bedrock은 모델 마켓플레이스처럼 여러 모델을 AWS 통제면 안에서 호출하게 해주는 구조입니다. 여기서 많은 분이 헷갈리는 부분이 있어요. “Anthropic 모델을 Bedrock에서 쓰면 결국 데이터가 Anthropic으로 가는 것 아닌가요?” 저도 처음엔 그렇게 생각했었습니다. 근데 AWS 공식 문서를 보면 현재 기준으로는 사용자 입력과 모델 출력이 모델 제공사와 공유되지 않는다고 되어 있습니다.

    또 하나 중요합니다. AWS는 고객 콘텐츠가 기본 모델 개선에 사용되지 않는다고도 밝히고 있습니다. 이 문장 하나가 현업에서는 꽤 큽니다. 왜냐하면 생성형 AI 검토 문서에서 거의 반드시 들어가는 질문이 아래 3가지이기 때문이거든요.

    • 입력 데이터가 제3자에게 제공되는가
    • 입출력이 모델 재학습에 사용되는가
    • 데이터 저장 위치와 암호화 방식은 어떻게 되는가

    Bedrock은 이 세 질문에 대해 비교적 명확한 답을 주는 편입니다. 저장 데이터는 사용 중인 AWS 리전에 보관되고, 전송 중과 저장 시 암호화가 기본이며, PrivateLink(프라이빗링크, 인터넷을 거치지 않는 사설 연결)도 붙일 수 있습니다. 실무 관점에서는 정말 편하더라고요.

    AWS Bedrock 정책 변경, 어떻게 읽어야 할까

    여기서 중요한 포인트! 제목만 보면 AWS Bedrock이 데이터를 더 많이 공유하는 방향으로 정책을 바꾼 것처럼 느껴질 수 있는데, 현재 공개된 AWS 공식 FAQ만 놓고 보면 오히려 반대입니다. Bedrock 쪽은 여전히 “공유 안 함”과 “학습 안 함” 원칙을 전면에 두고 있습니다.

    그럼 왜 시장이 시끄럽냐면, 모델 사업자별 정책 차이가 커졌기 때문입니다. 예를 들어 Anthropic의 소비자용 Claude 서비스 정책은 입력과 출력이 모델 개선에 활용될 수 있고, 사용자가 설정에서 opt-out(옵트아웃, 수집 거부)해야 하는 구조가 있습니다. 반면 Anthropic도 비즈니스 오퍼링 데이터는 별도 계약이 적용된다고 설명합니다. 이 차이 때문에 기업들은 “같은 Claude라도 어디서 쓰느냐”를 따져보게 된 거죠.

    구분 Claude.ai 개인용 서비스 Amazon Bedrock
    입출력의 모델 개선 활용 정책상 활용 가능, 사용자가 opt-out 가능 기본 모델 개선에 사용되지 않음
    모델 제공사와 데이터 공유 서비스 제공사가 직접 처리 모델 제공사와 공유되지 않음
    기업 거버넌스 문서화 서비스 약관과 공급사 정책 중심 AWS 보안 통제, 리전, VPC, IAM 기반 설계 가능
    한국 기업 적합성 개별 검토 필요 보안·감사 대응 문서화가 상대적으로 쉬움

    제가 실무에서 느낀 건 이겁니다. 모델 성능만 보면 선택이 단순해 보이는데, 개인정보 보호와 감사 대응까지 들어오면 클라우드 AI 플랫폼 선택 기준이 완전히 달라집니다. 특히 한국 기업은 법무, 보안, 컴플라이언스, 인프라 팀이 같이 움직여야 하니까요.

    한국 기업에 미칠 영향: AWS Bedrock 데이터 공유가 중요한 이유

    한국 기업은 특히 세 가지에서 영향이 큽니다.

    1. 개인정보 국외 이전 검토 부담: 어떤 리전에서 추론하는지, 로그가 어디 남는지, 제3자 제공인지 위탁인지 설명이 가능해야 합니다.
    2. 내부 보안 심사 속도: Bedrock처럼 데이터 비공유 원칙이 명확하면 보안팀 질의응답이 짧아집니다.
    3. 멀티모델 전략: Anthropic, Amazon, 기타 모델을 같은 통제면에서 비교할 수 있어 벤더 전환 비용을 낮출 수 있습니다.

    특히 금융, 헬스케어, 커머스 쪽은 고객센터 요약, 상담 보조, 문서 검색형 RAG(Retrieval-Augmented Generation, 검색증강생성)를 많이 검토하시는데요. 이때 진짜 민감한 건 프롬프트보다도 원문 문서, 고객 상담 내역, 로그입니다. 모델 API 정책만 보고 안심했다가, 애플리케이션 로그에 주민번호 비슷한 값이 남는 경우를 저는 몇 번 봤습니다. 정말 삽질 좀 했습니다 ㅎㅎ

    직접 모델 서비스 사용과 Amazon Bedrock 경유 사용의 데이터 흐름 차이를 비교한 아키텍처 이미지입니다.

    실전 구현: AWS Bedrock 거버넌스 체크리스트

    말만 하면 추상적이니까, 제가 실제로 정리하는 순서대로 적어보겠습니다. PoC를 시작할 때 아래 순서로 가시면 덜 헤맵니다.

    1. 어떤 모델을 어떤 리전에서 쓸지 먼저 고정합니다

    aws bedrock list-foundation-models \
      --by-provider Anthropic \
      --region ap-northeast-2 \
      --output table

    이 명령은 현재 리전에서 어떤 모델을 쓸 수 있는지 빠르게 확인할 때 좋습니다. 여기서 모델 선택을 먼저 확정해두면, 뒤에 IAM(Identity and Access Management, 접근권한 관리)과 비용 통제를 같이 걸기 쉬워집니다.

    2. 인터넷 우회 없이 VPC 엔드포인트를 붙입니다

    aws ec2 create-vpc-endpoint \
      --vpc-id vpc-xxxxxxxx \
      --vpc-endpoint-type Interface \
      --service-name com.amazonaws.ap-northeast-2.bedrock-runtime \
      --subnet-ids subnet-aaaaaaa subnet-bbbbbbb \
      --security-group-ids sg-xxxxxxxx \
      --private-dns-enabled \
      --region ap-northeast-2

    여기서 포인트는 bedrock-runtime 엔드포인트입니다. 추론 트래픽이 인터넷을 타지 않게 설계하는 거죠. 보안팀 설명할 때 이 한 줄이 꽤 강력합니다.

    3. 엔드포인트 정책으로 호출 범위를 좁힙니다

    {
      "Version": "2012-10-17",
      "Statement": [
        {
          "Principal": "*",
          "Effect": "Allow",
          "Action": [
            "bedrock:InvokeModel",
            "bedrock:InvokeModelWithResponseStream"
          ],
          "Resource": "*"
        }
      ]
    }

    이건 AWS 문서에 나온 예시 형태입니다. 실무에서는 여기에 Principal과 Resource를 더 좁혀야 합니다. 처음엔 넓게 열고, 호출 주체가 정리되면 최소권한(minimum privilege, 필요한 만큼만 권한 부여)으로 줄이는 방식이 안전합니다.

    4. 호출 로그를 별도로 검증합니다

    aws cloudtrail lookup-events \
      --lookup-attributes AttributeKey=EventName,AttributeValue=InvokeModel \
      --max-results 20 \
      --region ap-northeast-2

    “정책상 안전하다”와 “우리 환경이 안전하게 운영된다”는 다른 이야기입니다. 실제 호출 흔적이 남는지, 어떤 역할(role)이 호출했는지 꼭 봐야 합니다.

    5. 애플리케이션 레벨 마스킹을 넣습니다

    import re
    
    def mask_pii(text: str) -> str:
        text = re.sub(r"\b\d{6}-\d{7}\b", "[RESIDENT_ID_MASKED]", text)
        text = re.sub(r"\b01[0-9]-?\d{3,4}-?\d{4}\b", "[PHONE_MASKED]", text)
        return text
    
    prompt = mask_pii(user_input)

    Bedrock이 데이터를 모델 학습에 안 쓴다고 해도, 불필요한 개인정보를 아예 넣지 않는 게 최선입니다. 이건 원칙입니다. 제가 직접 해보니 거버넌스 회의에서 제일 설득력이 있었던 것도 사실 이 부분이었어요.
    AWS Bedrock 데이터 공유 통제를 위한 PrivateLink와 IAM 설정 이미지

    PrivateLink, IAM 정책, CloudTrail 검증이 한 화면 흐름으로 연결되는 운영 구성 이미지를 넣으면 이해가 쉽습니다.

    ⚠️ 주의사항과 트러블슈팅: 여기서 많이 삽질합니다

    첫 번째 착각. Bedrock을 쓰면 모든 개인정보 이슈가 자동 해결된다고 생각하는 경우입니다. 아닙니다. Bedrock 자체 정책과 별개로, S3 원문, 애플리케이션 로그, 프롬프트 캐시, 운영자 콘솔 접근권한은 여전히 고객 책임입니다.

    두 번째 착각. 모델 호출 리전만 한국이면 끝이라고 보는 경우입니다. 실제로는 cross-region inference(교차 리전 추론)나 외부 연동 서비스가 끼면 검토 범위가 넓어질 수 있습니다. 특히 글로벌 SaaS와 붙이면 데이터 흐름도가 금방 복잡해집니다.

    세 번째 착각. Anthropic 모델이니까 곧바로 Anthropic 정책만 보면 된다고 생각하는 경우입니다. Bedrock에서는 AWS 통제면에서 서비스가 제공되는지를 같이 봐야 합니다. 같은 모델명이어도 소비자용 웹 서비스, API, Bedrock 경유 사용은 거버넌스 해석이 달라집니다.

    • ✅ 프롬프트 입력 전 PII(개인식별정보) 마스킹
    • ✅ 리전 고정 및 네트워크 경로 문서화
    • ✅ IAM 역할 분리와 CloudTrail 감사
    • ✅ RAG 문서 보존기간과 삭제 절차 정의
    • ⚠️ 운영 로그에 원문 응답 저장 여부 확인

    혹시 이런 경험 있으신가요? 모델은 잘 나오는데 보안 검토 문서 쓰다가 일정이 다 밀리는 경우요. 현업에선 진짜 흔합니다. 그래서 저는 PoC 초반부터 아키텍처 그림보다 데이터 분류표를 먼저 만듭니다.

    검증 결과: 한국 기업이 얻는 실질적인 이점

    정리하면, 현재 공개된 정책 기준에서 AWS Bedrock의 데이터 공유 원칙은 한국 기업에 꽤 유리하게 작동합니다.

    1. 법무/보안 질의에 답하기 쉽습니다: 데이터 비공유, 비학습 원칙이 비교적 분명합니다.
    2. 아키텍처 통제가 가능합니다: VPC, IAM, CloudTrail, KMS(Key Management Service, 암호키 관리) 등 기존 AWS 통제 수단을 그대로 활용할 수 있습니다.
    3. 모델 선택 유연성이 있습니다: Anthropic 같은 외부 모델을 쓰면서도 AWS 운영 표준 안에 묶을 수 있습니다.

    다만 현실적으로는 이것도 잊지 마셔야 합니다. 정책이 안전해도 구현이 느슨하면 사고는 납니다. 반대로 정책 문구가 조금 복잡해 보여도 구현을 단단히 하면 충분히 운영 가능하고요. 결국 승부는 문서 한 줄보다도 데이터 흐름 설계에서 납니다.
    AWS Bedrock 데이터 공유 검증과 개인정보 보호 점검 대시보드 이미지

    감사 로그, 리전 고정, 마스킹 적용 여부를 한눈에 보여주는 검증 대시보드 형태의 이미지를 배치하면 좋습니다.

    자주 묻는 질문: 개인정보 보호 관점에서 확인할 것

    Q1. Bedrock을 쓰면 Anthropic에 우리 데이터가 가나요?

    현재 AWS 공식 FAQ 기준으로는 사용자 입력과 모델 출력이 모델 제공사와 공유되지 않는다고 안내합니다.

    Q2. 그럼 개인정보보호 검토가 끝난 건가요?

    아닙니다. 애플리케이션 로그, 저장소, 운영자 접근권한, RAG 원문 관리까지 같이 봐야 합니다.

    Q3. 한국 기업은 어떤 팀이 먼저 움직여야 하나요?

    인프라보다 먼저 보안과 개인정보 담당자를 초반 설계에 넣는 게 좋습니다. 나중에 붙이면 거의 다시 설계하게 되더라고요.

    마무리: 이번 이슈에서 제가 보는 결론

    AWS Bedrock 데이터 공유 이슈는 단순히 “AWS가 안전하다”로 끝낼 이야기는 아닙니다. 더 정확히는, 생성형 AI 시장에서 데이터 정책이 계속 흔들리는 와중에도 Bedrock은 기업용 통제와 설명 가능성 측면에서 강한 선택지라는 쪽에 가깝습니다. 특히 한국 기업처럼 개인정보 보호, 내부 감사, 국외 이전 설명책임이 큰 환경에서는 이 차이가 꽤 큽니다.

    저라면 이렇게 접근하겠습니다. 모델 성능 비교는 두 번째로 두고, 먼저 데이터 흐름도, 리전, 로그, 마스킹, 권한모델을 고정합니다. 그 다음에 Anthropic이든 다른 모델이든 올리는 게 맞습니다. 다음 글에서는 AWS Bedrock Guardrails(가드레일, 출력 통제 장치)와 RAG 보안 설계를 같이 묶어서 다뤄보겠습니다. 이전 글에서 다뤘던 IAM 최소권한 설계와 함께 보시면 흐름이 더 잘 잡히실 겁니다. 🎉
  • [Cloud] Ollama 클라우드 12개월 후기: 로컬 GPU 없이 LLM 활용 전략

    [Cloud] Ollama 클라우드 12개월 후기: 로컬 GPU 없이 LLM 활용 전략

    Ollama 클라우드 12개월 후기: 로컬 GPU 없이 LLM 활용 전략

    지난 12개월 동안 제가 가장 많이 고민했던 주제 중 하나가 바로 Ollama 클라우드 운영 방식이었습니다. 여기서 먼저 짚고 갈 게 하나 있습니다. 2026년 10월 기준으로는 Ollama Cloud Models라는 공식 기능이 이미 자리잡았기 때문에, 이제는 “Ollama 클라우드“가 단순히 자가 구축 원격 서버만 뜻하는 표현은 아닙니다. 다만 이 글에서는 여전히 실무에서 많이 쓰는 두 갈래, 즉 Ollama를 원격 서버나 클라우드 GPU 환경에 올려서 로컬 GPU 없이 쓰는 방식과 공식 cloud models를 활용하는 방식을 함께 묶어서 보겠습니다.

    특히 노트북만 쓰거나, 데스크톱에 고성능 GPU가 없거나, 홈랩은 있는데 전기료와 발열이 부담되는 분들께는 꽤 현실적인 선택지입니다. 저처럼 인프라 일을 오래 하신 분들은 공감하실 겁니다. 결국 문제는 기술 자체보다 운영 복잡도, 비용 통제, 그리고 응답 지연이거든요. 이번 글에서는 제가 직접 해보면서 정리한 GPU 없이 LLM을 활용하는 현실적인 전략을, self-hosted LLM과 OpenAI 호환 API 관점까지 포함해서 클라우드 LLM 및 AI 인프라 최적화 관점에서 풀어보겠습니다.

    로컬 장비, 클라우드 GPU 인스턴스, 리버스 프록시, 그리고 클라이언트가 어떻게 연결되는지 한눈에 보여주는 구조입니다.

    1. 왜 다들 Ollama 클라우드를 찾게 되는가

    쉽게 말해, LLM 활용은 하고 싶은데 항상 내 PC에 GPU를 꽂아둘 수는 없기 때문입니다. 모델이 커질수록 메모리도 많이 먹고, 추론 시간도 길어집니다. 집에서 잠깐 테스트할 때는 괜찮은데, 막상 여러 기기에서 접근하려고 하면 귀찮은 문제가 줄줄이 생기더라고요.

    • 노트북에서는 메모리와 발열이 금방 한계에 닿습니다.
    • 데스크톱은 켜 둬야 해서 전력 부담이 생깁니다.
    • 여러 서비스가 동시에 붙으면 로컬 환경이 불안정해집니다.
    • 사내나 팀 단위로 쓰려면 접근 제어가 필요합니다.

    저도 초반에는 로컬에서만 돌렸습니다. 그런데 코드 요약, 로그 분석, 초안 작성 같은 작업이 점점 늘어나니까 “이걸 개인 장비에서만 처리하는 건 운영적으로 비효율적이네”라는 결론이 나오더라고요. 그 시점부터는 클라우드 AI, 프라이빗 LLM, AI inference, 그리고 온프레미스 LLM 관점에서 다시 보기 시작했습니다.

    2. Ollama 클라우드 개념을 쉽게 풀어보면

    Ollama는 로컬 또는 서버에서 LLM을 비교적 단순한 방식으로 실행하고 관리할 수 있게 도와주는 도구입니다. 쉽게 말해 모델 런타임을 다루기 쉽게 만들어주는 계층이라고 보면 됩니다. 2026년 10월 기준으로 Ollama 클라우드라는 표현은 보통 아래 다섯 중 하나를 뜻합니다.

    1. Ollama의 공식 cloud models를 써서 로컬 GPU 없이 큰 모델을 호출하는 방식
    2. 클라우드 VM이나 베어메탈에 Ollama를 직접 설치해서 원격 API처럼 쓰는 방식
    3. GPU가 있는 서버 한 대를 중앙에서 운영하고, 로컬에서는 API 호출만 하는 방식
    4. 일부 작업은 외부 모델 API로 보내고, 민감한 작업만 원격 Ollama로 보내는 하이브리드 방식
    5. Ollama의 내장 RAG(Retrieval Augmented Generation) 기능을 활용하여 자체 데이터 기반 LLM을 구축하는 방식

    여기서 중요한 포인트! Ollama 자체가 비용을 magically 줄여주는 건 아닙니다. 비용을 줄이는 건 아키텍처 선택입니다. 예를 들어 항상 큰 모델을 켜 두는 대신, 필요한 시간에만 GPU 인스턴스를 올리거나, 평소엔 작은 모델로 처리하고 긴 문서 요약처럼 무거운 작업만 상위 경로로 보내는 식이 훨씬 효과적이었습니다. 이는 곧 클라우드 비용 절감과 직결됩니다.

    어떤 구성이 현실적인가

    구성 방식 장점 주의할 점 추천 상황
    공식 Ollama Cloud Models 시작이 가장 빠르고 운영 부담이 낮음 계정, 사용량 제한, 데이터 처리 경계를 확인해야 함 빠른 검증, 개인 생산성, API 기반 자동화
    단일 원격 Ollama 서버 구성이 단순하고 데이터 통제가 쉬움 장애 지점이 하나로 몰림 개인 실험, 홈랩, 소규모 팀
    GPU 인스턴스 + 프록시 접근 제어와 TLS 적용이 쉬움 프록시 설정 삽질 가능성 높음 외부 접속이 필요한 환경
    하이브리드 LLM 활용 비용과 성능 균형 조절이 유연함 라우팅 로직을 따로 관리해야 함 실서비스 전 단계, 비용 최적화
    Ollama 내장 RAG 활용 자체 데이터 기반으로 LLM 응답 강화, 데이터 통제 용이 데이터 준비 및 관리 필요, 모델과의 연동 최적화 필요 정확성 및 최신성 요구되는 내부 자료 활용, 데이터 거버넌스 중요 환경

    3. 제가 12개월 동안 정착한 운영 전략

    결론부터 말씀드리면, 저는 항상 큰 모델을 붙잡고 있지 않는 구조로 갔습니다. 처음엔 “어차피 서버 띄울 거면 제일 큰 모델 하나 두고 끝내자”라고 생각했었는데, 이게 실제로 써보면 낭비가 많습니다. 요청 패턴이 일정하지 않거든요. 이는 LLM 최적화의 핵심입니다.

    • 짧은 초안 작성, 로그 요약, 명령어 설명은 경량 모델 경로
    • 긴 문서 분석, 구조화된 응답 생성은 상위 모델 경로
    • 민감한 데이터는 자체 통제 가능한 원격 Ollama 경로 (온프레미스 LLM)
    • 가끔만 쓰는 고비용 작업은 필요 시에만 인스턴스 기동 (AI 워크로드 관리)
    • 기존 앱 연동은 OpenAI 호환 API 경로를 우선 검토

    이렇게 나누니까 체감상 운영이 훨씬 편해졌습니다. 무엇보다 LLM 활용이 “실험“에서 “일상 도구“로 넘어가더라고요. 이거 진짜 큽니다. 매번 환경 걱정하면 결국 안 쓰게 되거든요.

    4. 실전 구현: 원격 Ollama 서버 구성 흐름

    여기서는 가장 단순하고 재현 가능한 구조를 기준으로 설명드리겠습니다. Linux 서버 한 대에 Ollama를 올리고, Nginx로 외부 노출을 제어하는 흐름입니다. 저도 처음엔 보안 생각 없이 열었다가 식은땀 좀 났습니다 ㅎㅎ 그래서 지금은 최소한의 프록시와 접근 제한은 꼭 넣습니다.

    1. 원격 서버 준비: 공개 IP 또는 VPN 뒤의 Linux 서버를 준비합니다.
    2. Ollama 설치: 서버에서 Ollama 데몬을 실행합니다.
    3. 바인딩 주소 확인: 외부 접근이 필요한지, 내부 전용인지 먼저 결정합니다.
    4. 리버스 프록시 구성: TLS 종료와 접근 제어를 프록시에서 담당하게 합니다. (Ollama 프록시)
    5. 클라이언트 분리: 로컬에서는 HTTP API만 호출하도록 구성합니다.

    기본 설치 예시

    curl -fsSL https://ollama.com/install.sh | sh
    sudo systemctl enable --now ollama
    ollama pull llama3 # 예시 모델은 최신 인기 모델로 업데이트
    curl http://127.0.0.1:11434/api/tags

    설치 직후에는 먼저 로컬 루프백에서만 응답하는지 확인해 보시는 걸 권장합니다. 외부에 바로 열기보다 내부 테스트를 먼저 해야 삽질이 줄어듭니다. 예제 모델은 예전의 막연한 llama3보다, 실제로 서버에 받아 둔 태그를 /api/tags로 확인해서 쓰는 편이 덜 헷갈립니다.

    systemd override 예시

    sudo systemctl edit ollama
    [Service]
    Environment="OLLAMA_HOST=0.0.0.0:11434"

    이 설정은 외부 바인딩에 영향을 주므로 신중하게 봐야 합니다. 무심코 열어두면 원치 않는 접근이 생길 수 있습니다. 가능하면 방화벽, IP 제한, 인증 프록시와 함께 사용하세요.

    Ollama 클라우드 환경에서 Nginx 리버스 프록시와 API 연결 구성을 설명하는 이미지

    외부 요청이 프록시를 거쳐 Ollama API로 전달되는 흐름과 인증 또는 IP 제한이 어디서 걸리는지 보여주는 이미지입니다. 이는 AI 인프라의 핵심 구성 요소입니다.

    Nginx 프록시 예시

    server {
        listen 443 ssl http2;
        server_name ollama.example.internal;
    
        location / {
            proxy_pass http://127.0.0.1:11434;
            proxy_http_version 1.1;
            proxy_set_header Host $host;
            proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
            proxy_set_header X-Forwarded-Proto $scheme;
            proxy_read_timeout 600s;
        }
    }

    실제로 써보니까 여기서 많이들 놓치는 게 인증과 속도 제한입니다. 내부망이라고 방심하면 안 됩니다. 특히 여러 툴이 자동으로 붙기 시작하면 생각보다 요청량이 빠르게 늘어납니다. 응답이 길어지는 워크로드라면 proxy_read_timeout 같은 타임아웃도 같이 보셔야 합니다. 안정적인 Ollama 프록시 운영을 위해 필수적입니다.

    클라이언트 호출 예시

    curl https://ollama.example.internal/api/generate \
      -H 'Content-Type: application/json' \
      -d '{
        "model": "llama3",
        "prompt": "nginx 502 에러 원인 정리해줘"
      }'

    모델명은 실제 서버에 내려받아 둔 모델 기준으로 확인하셔야 합니다. 저는 여기서 한 번 크게 헷갈렸습니다. 로컬에서 쓰던 이름과 서버에 있는 태그가 다르면 호출이 그냥 실패하더라고요. 처음엔 네트워크 문제인 줄 알았습니다.

    5. 주의사항과 트러블슈팅: 제가 실제로 막혔던 지점들

    ⚠️ 여기부터가 진짜 실전입니다. 설치보다 운영이 더 어렵습니다. 저도 처음엔 금방 끝날 줄 알았는데, 결국 문제는 대부분 인프라 쪽에서 났습니다.

    • 포트는 열렸는데 응답이 없다
      대부분 서비스 바인딩 주소나 방화벽 정책 문제였습니다. 서버 프로세스가 127.0.0.1만 듣고 있는지 먼저 확인해 보세요.
    • 모델 다운로드가 느리거나 실패한다
      원격 환경의 디스크 여유 공간과 네트워크 품질부터 봐야 합니다. 저는 저장 경로 용량 부족으로 몇 번 다시 받았습니다.
    • 응답 지연이 생각보다 크다
      모델 크기만 보지 말고 프롬프트 길이, 동시 요청 수, 프록시 레이어를 함께 봐야 합니다. 지연은 한 군데서만 생기지 않더라고요.
    • 비용이 예상보다 빨리 오른다
      상시 실행 인스턴스가 있으면 한가한 시간대 비용이 누적됩니다. 사용 시간대를 분리하거나 자동 중지 전략이 필요합니다. 이는 클라우드 비용 절감의 핵심입니다.
    • 클라우드 기능과 로컬 전용 운영을 혼동한다
      공식 cloud models를 쓰는 경우에는 편하지만, strict한 데이터 거버넌스 경계가 필요한 환경이라면 self-hosted LLM이 더 맞을 수 있습니다.

    제가 가장 크게 배운 건, GPU 없이 LLM을 활용하는 전략의 핵심은 “어떻게 원격으로 돌릴까“보다 “어떤 요청을 어디로 보낼까“에 있다는 점입니다. 즉, 라우팅 설계가 훨씬 중요합니다. 이는 AI 워크로드를 효율적으로 관리하는 길입니다.

    6. 검증 방법: 결과를 어떻게 확인했나

    저는 아래 세 가지를 기준으로 계속 점검했습니다. 막연하게 “잘 되는 것 같다“고 보면 나중에 꼭 문제 생깁니다.

    1. 기능 검증: API가 정상 응답하는지, 모델 태그가 일치하는지 확인
    2. 운영 검증: 재부팅 후 서비스 자동 기동, 프록시 연결, 로그 적재 상태 확인
    3. 사용성 검증: 로컬에서 체감이 좋아졌는지, 실제 업무 흐름이 빨라졌는지 확인
    curl -s https://ollama.example.internal/api/tags
    curl -s https://ollama.example.internal/api/generate \
      -H 'Content-Type: application/json' \
      -d '{
        "model": "llama3",
        "prompt": "최근 장애 원인 분석 체크리스트를 5개만 정리해줘"
      }'

    실제로 써보니까 가장 만족스러웠던 부분은 작업 시작 장벽이 낮아진 것입니다. 예전엔 “아 GPU 켜야 하지“부터 생각했는데, 이제는 그냥 API 호출하듯 붙이면 되니까 훨씬 자주 쓰게 됐습니다. 이는 로컬 AI 환경의 한계를 넘어선 GPU 가속의 이점을 원격으로 누리는 셈입니다. 이건 숫자로 딱 잘라 말하기보다 체감 생산성에서 차이가 컸습니다.

    Ollama 클라우드 결과 검증과 모니터링 대시보드를 나타내는 이미지

    API 호출 결과, 서비스 상태, 그리고 지연 시간 추이를 함께 보여주는 검증 장면입니다.

    7. 2026년 10월 기준 주목할 변화

    이 부분은 원문 작성 이후 더 중요해진 포인트라서 따로 정리해 두는 게 좋겠습니다. 지금은 단순히 “원격 서버에 Ollama만 띄우면 끝“이라고 보기 어려워졌습니다. 클라우드 LLM 생태계가 빠르게 발전하고 있기 때문입니다.

    • 공식 Ollama Cloud Models가 이미 실사용 단계로 자리잡았습니다.
      로컬 GPU 없이도 큰 모델을 붙일 수 있고, CLI에서 ollama signin 후 같은 사용감으로 접근할 수 있습니다. 빠른 시작은 정말 편합니다.
    • Ollama의 OpenAI 호환 API가 연동성을 크게 높였습니다.
      기존 도구가 /v1/chat/completions 또는 /v1/responses 기반이면, 원격 Ollama나 cloud models를 AI gateway처럼 붙이기가 훨씬 쉬워졌습니다.
    • 데이터 경계는 더 분명하게 구분해서 봐야 합니다.
      로컬 또는 self-hosted LLM 경로는 직접 통제에 유리하고, 공식 cloud models는 서비스 제공을 위해 프롬프트와 응답이 처리되지만 저장이나 로깅은 하지 않는다고 안내하고 있습니다. 그래서 데이터 거버넌스 요구사항이 높은 조직일수록 어느 경로를 쓰는지 문서화가 필요합니다.
    • 아직 기능 차이는 남아 있습니다.
      예를 들어 공식 문서 기준으로 structured outputs는 cloud models에서 아직 지원되지 않습니다. 자동화 파이프라인에서 JSON 스키마 강제가 중요하면 이 차이를 꼭 확인해야 합니다.
    • 2026년 9월에는 Ollama의 내장 RAG(Retrieval Augmented Generation) 기능이 더욱 강화되어, 자체 데이터 기반 LLM 활용이 쉬워졌습니다.
      이는 특히 온프레미스 LLM 환경에서 데이터 거버넌스를 유지하며 LLM 최적화를 꾀하는 데 큰 도움이 됩니다.
    • 2026년 8월에는 Claude Desktop 연동도 추가됐습니다.
      즉, 이제는 “로컬 앱 + Ollama cloud models + 기존 워크플로“를 묶는 선택지가 더 넓어졌습니다. 예전보다 진입장벽이 낮아진 건 확실합니다.

    정리하면, 지금의 Ollama 클라우드 전략은 단순한 서버 구축기를 넘어서 공식 cloud models, OpenAI 호환 API, 보안 경계, 자동화 연동성, 그리고 Ollama RAG까지 같이 봐야 완성됩니다. 이는 곧 AI 인프라 전반에 대한 이해를 요구합니다.

    8. Ollama 후기: 어떤 분께 맞고, 어떤 분께는 안 맞는가

    제 기준에서 Ollama 후기를 한 줄로 요약하면 이렇습니다. 로컬 GPU가 없거나, 있어도 계속 붙잡고 있기 싫은 분들에겐 매우 현실적인 선택지입니다. GPU 가속의 이점을 원격으로 활용할 수 있기 때문입니다. 반대로 아주 낮은 지연이 절대적으로 중요하거나, 대규모 동시성 처리가 필요한 환경이라면 별도 서빙 구조를 더 검토하셔야 합니다.

    잘 맞는 경우 덜 맞는 경우
    개인 생산성 자동화, 홈랩 실험, 소규모 팀 도구화, 로컬 AI 환경 강화 초고속 응답이 필수인 실시간 서비스
    민감 데이터 통제가 필요한 내부 활용, 온프레미스 LLM 구축 대규모 동시 요청을 즉시 처리해야 하는 구조
    비용과 운영 복잡도 사이에서 균형을 찾고 싶은 경우, 클라우드 비용 절감 완전관리형 서비스만 선호하면서 세부 제어는 포기하기 어려운 경우

    혹시 이런 경험 있으신가요? 처음엔 기술 자체보다 운영 동선 때문에 포기하게 되는 경우요. 저도 그랬습니다. 그래서 지금은 무조건 “작게 시작해서, 라우팅을 분리하고, 보안을 앞단에서 막는 구조“를 권합니다. 이는 LLM 최적화의 기본입니다.

    9. 자주 묻는 질문과 마무리

    자주 묻는 질문

    • Q. 로컬 GPU가 전혀 없어도 되나요?
      네, 가능합니다. 원격 Ollama 서버를 두거나 공식 cloud models를 쓰면 됩니다. 다만 모든 추론을 원격에 의존하게 되므로 네트워크 품질과 접근 제어가 중요해집니다. 이는 로컬 AI의 한계를 극복하는 방법이기도 합니다.
    • Q. Ollama 클라우드 구성이 무조건 저렴한가요?
      아닙니다. self-hosted LLM은 인스턴스 상시 비용이 누적될 수 있고, 공식 cloud models도 사용량과 요금제를 같이 봐야 합니다. 핵심은 사용 패턴에 맞춘 라우팅과 기동 전략입니다. 클라우드 비용 절감을 위해서는 면밀한 계획이 필요합니다.
    • Q. 처음 시작하는 사람도 가능한가요?
      가능합니다. 다만 보안, 프록시, 방화벽 개념은 최소한 이해하고 시작하시는 걸 권장합니다. 단순 체험은 공식 cloud models가 더 쉽고, 프라이빗 LLM 운영은 self-hosted가 더 낫습니다.

    정리하자면, 지난 12개월 동안 제가 느낀 Ollama 클라우드 운영의 핵심은 세 가지였습니다. 첫째, 로컬 GPU가 없어도 충분히 실용적인 LLM 활용이 가능합니다. 둘째, 성능보다 먼저 봐야 할 건 운영 단순화입니다. 셋째, 비용 절감은 기술 선택이 아니라 트래픽 분기와 실행 시간 관리에서 나옵니다.

    지금 시점에서는 여기에 한 가지가 더 붙습니다. 바로 공식 cloud models와 self-hosted LLM을 어떻게 나눠 쓸지입니다. 그리고 Ollama RAG 기능을 활용한 자체 데이터 연동도 중요한 고려사항이 됩니다. 이 분기만 잘 잡아도 운영 복잡도와 데이터 통제 수준을 꽤 안정적으로 맞출 수 있습니다.

    다음 글에서는 Ingress, 인증 프록시, 내부 DNS를 묶어서 홈랩에서 더 안전하게 운영하는 방법도 다뤄볼 예정입니다. 이전 글에서 다뤘던 reverse proxy 튜닝 내용과도 연결되는 부분이 있어서 같이 보시면 흐름이 더 잘 잡히실 겁니다.

    Ollama 클라우드와 GPU 없이 LLM 운영 전략을 비교 요약한 인포그래픽

    로컬 실행, 원격 Ollama, 하이브리드 구성, 그리고 공식 cloud models까지 한 번에 비교하고 선택 포인트를 정리한 요약 이미지입니다.

    처음엔 이게 뭔가 싶었는데, 한 번 구조를 잡아두니 정말 편해졌습니다. 완벽한 답은 아니어도, 적어도 “GPU 없어서 못 한다“ 단계는 확실히 넘길 수 있었습니다. 이 부분이 가장 컸네요.

    🔄 마지막 업데이트: 2026년 10월

  • [AI] 로컬 LLM 활용: Ollama와 최신 Claude 모델 비교 분석

    [AI] 로컬 LLM 활용: Ollama와 최신 Claude 모델 비교 분석

    [AI] 로컬 LLM 활용: Ollama와 최신 Claude 비교 분석

    안녕하세요, 13년차 인프라 엔지니어, ’13년차의 서버실’ 주인장입니다. 요즘 LLM(Large Language Model, 대규모 언어 모델)이 정말 핫하잖아요? 저도 홈랩에서 이것저것 써보면서 참 많은 걸 느끼고 있습니다. 특히 개인 정보 보호나 비용 문제 때문에 로컬 LLM에 대한 관심이 뜨거운데요. 오늘은 제가 직접 Ollama를 사용해 로컬 환경에서 LLM을 돌려본 경험과, 강력한 클라우드 LLM인 Claude Sonnet 4.6을 비교 분석해보고자 합니다.

    사실 처음엔 ‘로컬에서 LLM을 돌리는 게 정말 의미가 있을까?’ 싶기도 했어요. 클라우드 서비스들이 워낙 잘 되어 있으니까요. 근데 막상 써보니까 비용이나 프라이버시 측면에서 로컬 LLM이 주는 이점이 상당하더라고요. 물론 클라우드 LLM의 압도적인 성능과 편리함도 무시할 수 없고요. 그래서 오늘은 이 두 가지 접근 방식의 장단점을 솔직하게 파헤쳐 보려고 합니다. 여러분의 상황에 맞는 최적의 LLM 활용법을 찾는 데 도움이 되셨으면 좋겠네요! 💡

    로컬 LLM (Ollama)과 클라우드 LLM (Claude Sonnet 4.6)의 개념적 비교 아키텍처 다이어그램입니다. 각 접근 방식의 프라이버시, 비용, 성능 등의 요소를 시각적으로 보여줍니다.

    1. LLM, Ollama, Claude Sonnet 4.6, 개념부터 잡고 가시죠!

    먼저 비교 분석에 앞서 핵심 개념들을 간단하게 짚고 넘어갈게요. 혹시 이미 잘 아시는 분들도 계시겠지만, 다시 한번 정리하는 의미에서 봐주시면 감사하겠습니다.

    1.1. LLM (Large Language Model, 대규모 언어 모델)이란?

    쉽게 말해, 우리가 쓰는 언어를 이해하고 생성하는 능력을 가진 인공지능 모델입니다. 방대한 양의 텍스트 데이터를 학습해서 질문에 답하고, 글을 쓰고, 번역하는 등 다양한 언어 작업을 수행할 수 있죠. 요즘 우리가 ‘챗GPT’, ‘클로드’ 같은 서비스로 접하는 것이 바로 이 LLM의 결과물이라고 보시면 됩니다.

    1.2. Ollama: 내 컴퓨터에서 LLM을!

    Ollama (올라마)는 로컬 환경에서 다양한 오픈소스 LLM을 쉽게 실행할 수 있도록 도와주는 프레임워크입니다. 예전에는 로컬에서 LLM을 돌리려면 복잡한 설정과 의존성 관리가 필요했는데, Ollama 덕분에 아주 간편해졌어요. 마치 Docker로 컨테이너를 띄우듯이, 몇 가지 명령어로 원하는 모델을 다운로드하고 실행할 수 있게 해줍니다. NVIDIA GPU (엔비디아 GPU)나 Apple Silicon (애플 실리콘)이 있다면 더욱 빠르게 모델을 돌릴 수 있죠. 제가 홈랩에서 정말 유용하게 쓰고 있는 도구 중 하나입니다. 🎉

    1.3. Claude Sonnet 4.6: 클라우드의 강력함

    Claude Sonnet 4.6은 Anthropic (앤트로픽)에서 개발한 최신 클라우드 기반 LLM입니다. ‘Sonnet’은 Claude 모델 라인업 중 성능과 비용의 균형을 잘 맞춘 모델인데요, 뛰어난 성능으로 많은 개발자들에게 사랑받고 있습니다. 클라우드 기반이기 때문에 사용자는 별도의 하드웨어 없이 인터넷만 연결되어 있으면 API (Application Programming Interface, 응용 프로그래밍 인터페이스)를 통해 모델을 활용할 수 있습니다. Ollama와 가장 큰 차이점은 바로 이 ‘로컬’과 ‘클라우드’라는 점입니다. Claude Sonnet 4.6은 현재 로컬 환경에서 직접 실행할 수 있는 모델이 아닙니다. 이 점을 명확히 하고 비교를 시작하겠습니다!

    2. 실전 구현: Ollama 설치 및 로컬 LLM 실행하기

    제가 홈랩에서 Ollama를 설치하고 Llama 2 (라마 2) 모델을 돌려봤던 경험을 공유해 드릴게요. 생각보다 정말 간단해서 놀랐습니다.

    2.1. Ollama 설치

    Ollama는 다양한 운영체제를 지원합니다. 저는 주로 리눅스 서버에서 작업하지만, Mac이나 Windows에서도 설치가 가능합니다. 공식 웹사이트에서 다운로드 받거나, 아래처럼 간단한 명령어로 설치할 수 있습니다.

    curl -fsSL https://ollama.com/install.sh | sh

    이 명령어를 실행하면 Ollama가 자동으로 시스템에 설치됩니다. 설치가 완료되면 백그라운드에서 Ollama 서비스가 실행되는 걸 확인할 수 있어요. 💡

    2.2. 로컬 LLM 모델 다운로드 및 실행

    Ollama가 설치되었다면, 이제 원하는 LLM 모델을 다운로드해서 실행할 차례입니다. Ollama는 다양한 오픈소스 모델들을 지원하는데요, 저는 가장 대중적인 Llama 2를 선택했습니다.

    ollama pull llama2

    이 명령어를 입력하면 Llama 2 모델이 다운로드되기 시작합니다. 모델 크기가 꽤 크기 때문에 네트워크 환경에 따라 시간이 좀 걸릴 수 있어요. 제 홈랩 서버는 기가비트 이더넷이라 금방 받더라고요. ㅎㅎ

    다운로드가 완료되면, 바로 모델을 실행해서 대화할 수 있습니다.

    ollama run llama2

    드디어 됐다! 이 명령어를 입력하면 터미널에서 Llama 2 모델과 직접 대화할 수 있는 프롬프트가 나타납니다. 처음엔 이게 뭔가 싶었는데, 실제로 써보니까 정말 신기하더라고요. 로컬에서 AI와 대화할 수 있다는 것이 말이죠. 🤯

    Ollama를 이용해 로컬 LLM (llama2)을 실행하는 터미널 화면

    Ollama를 이용해 로컬 LLM (llama2)을 실행하는 터미널 화면입니다. 모델 다운로드 및 실행 과정을 보여주며, 사용자 입력 프롬프트가 활성화된 모습입니다.

    3. Ollama 로컬 LLM의 장단점

    제가 직접 Ollama를 써보니 명확한 장단점들이 보이더라고요. 로컬 LLM을 고려하는 분들이라면 꼭 확인해야 할 부분입니다.

    ✅ 장점:

    • 프라이버시 (Privacy) 보호: 가장 큰 장점이죠. 민감한 데이터를 외부 서버로 보내지 않고 내 컴퓨터 안에서 처리하기 때문에 데이터 유출 걱정이 적습니다. 보안이 중요한 기업 환경이나 개인 연구에 유리합니다.
    • 비용 효율성 (Cost-effectiveness): 초기 하드웨어 투자 비용은 있지만, 한 번 구축하면 API 사용료 같은 추가 비용이 거의 들지 않습니다. 특히 사용량이 많을수록 클라우드 대비 비용 절감 효과가 큽니다.
    • 오프라인 사용 가능 (Offline Capability): 인터넷 연결 없이도 LLM을 사용할 수 있습니다. 네트워크가 불안정하거나 없는 환경에서도 작업이 가능하죠.
    • 완전한 제어권 (Full Control): 모델의 설정, 버전 관리, 커스터마이징 등 모든 것을 사용자가 직접 제어할 수 있습니다. 실험적인 시도나 특정 목적에 맞춰 모델을 튜닝하기 좋습니다.

    ⚠️ 단점:

    • 하드웨어 요구사항 (Hardware Requirements): LLM은 GPU 메모리(VRAM)와 RAM을 많이 잡아먹습니다. 최소 8GB 이상의 VRAM을 가진 GPU가 권장되며, 더 큰 모델은 16GB, 24GB 이상이 필요하기도 합니다. 홈랩 서버의 GPU 성능이 여기서 한계를 보이더라고요. 😥
    • 성능 한계 (Performance Limitations): 클라우드 LLM에 비해 응답 속도나 추론 품질이 떨어질 수 있습니다. 특히 경량화된 오픈소스 모델을 사용하거나 하드웨어 성능이 충분하지 않을 때 체감됩니다.
    • 모델 선택의 폭 (Limited Model Variety): Ollama가 많은 모델을 지원하지만, 최신 또는 특정 고성능 모델은 클라우드에서만 사용 가능한 경우가 많습니다.
    • 관리 및 유지보수 (Management & Maintenance): 업데이트, 오류 해결, 의존성 관리 등 모든 것을 직접 해야 합니다. 이것도 인프라 엔지니어의 숙명이겠죠? 삽질 좀 했습니다 ㅎㅎ.

    4. Claude Sonnet 4.6 활용 및 장단점

    이제 클라우드 기반의 Claude Sonnet 4.6에 대해 이야기해 볼 차례입니다. Ollama와는 다른 매력을 가지고 있죠.

    4.1. Claude Sonnet 4.6 활용 방식

    Claude Sonnet 4.6은 Anthropic에서 제공하는 API를 통해 사용합니다. 프로그래밍 언어(주로 Python)를 사용하여 API를 호출하고 모델과 상호작용할 수 있습니다. 웹 인터페이스인 ‘Claude.ai’를 통해서도 직접 대화할 수 있지만, 개발자 입장에서는 API 활용이 핵심이죠. 간단한 Python 코드 예시를 통해 어떻게 사용되는지 보여드릴게요.

    import anthropic
    
    client = anthropic.Anthropic(api_key="YOUR_ANTHROPIC_API_KEY")
    
    message = client.messages.create(
        model="claude-sonnet-4-6",
        max_tokens=1024,
        messages=[
            {"role": "user", "content": "What is the capital of France?"}
        ]
    )
    print(message.content)

    위 코드처럼 API 키만 있으면 쉽게 Claude Sonnet 4.6의 강력한 성능을 활용할 수 있습니다. 💡

    ✅ 장점:

    • 압도적인 성능 (Superior Performance): Claude Sonnet 4.6은 현재 상업용 LLM 중에서도 매우 뛰어난 성능을 자랑합니다. 복잡한 추론, 긴 컨텍스트 처리, 다국어 지원 등 대부분의 작업에서 로컬 LLM보다 훨씬 좋은 결과를 보여줍니다.
    • 편리한 접근성 및 확장성 (Easy Accessibility & Scalability): 별도의 하드웨어 구축 없이 API 키만 있으면 바로 사용할 수 있습니다. 사용량에 따라 자동으로 확장되므로, 트래픽이 급증해도 걱정할 필요가 없죠. 인프라 관리에 신경 쓸 필요가 없다는 점이 정말 편합니다.
    • 최신 모델 유지 (Always Up-to-date): 제조사에서 지속적으로 모델을 업데이트하고 개선합니다. 항상 최신 버전의 LLM을 사용할 수 있다는 장점이 있습니다.
    • 다양한 기능 지원 (Rich Feature Set): 이미지/동영상 처리 같은 멀티모달(Multimodal) 기능이나, 복잡한 프롬프트 엔지니어링 기법을 지원하는 경우가 많습니다.

    ⚠️ 단점:

    • 비용 (Cost): 사용량(토큰 수)에 따라 비용이 발생합니다. 사용량이 많아질수록 지출이 커지므로, 비용 관리가 중요합니다. 예상치 못한 과금이 발생하지 않도록 모니터링이 필수입니다. 💸
    • 데이터 프라이버시 (Data Privacy Concerns): 사용자의 데이터가 클라우드 제공업체 서버를 거쳐 처리됩니다. 민감한 정보를 다룰 때는 이 부분이 항상 고려되어야 합니다.
    • 인터넷 의존성 (Internet Dependency): 인터넷 연결이 필수입니다. 네트워크가 끊기면 서비스를 사용할 수 없습니다.
    • 제한된 제어권 (Limited Control): 모델 자체를 사용자가 직접 튜닝하거나 내부 동작을 변경할 수는 없습니다.

    5. Ollama 로컬 LLM vs. Claude Sonnet 4.6 비교 분석

    자, 이제 두 가지 접근 방식을 한눈에 비교해 볼 시간입니다. 어떤 상황에 어떤 솔루션이 더 적합한지 판단하는 데 도움이 되실 거예요.

    항목 Ollama (로컬 LLM) Claude Sonnet 4.6 (클라우드 LLM)
    성능 및 품질 하드웨어 및 모델에 따라 편차 큼, 클라우드 대비 낮은 경향 매우 뛰어남, 복잡한 작업에 강력
    비용 초기 하드웨어 투자 후 유지비 적음, 사용량 많을수록 이득 사용량 기반 과금, 사용량에 비례하여 비용 증가
    프라이버시 매우 높음 (데이터 외부 전송 없음) 클라우드 제공업체 정책에 따름 (데이터 전송 필요)
    하드웨어 요구사항 필수 (GPU VRAM, RAM 등) 없음 (인터넷 연결 필수)
    설치 및 관리 직접 설치 및 관리 필요, 삽질 가능성 있음 API 키 발급 후 즉시 사용, 관리 용이
    유연성 모델 커스터마이징, 오프라인 사용 등 높은 유연성 제공되는 API 기능 내에서 활용
    주요 활용 분야 개인 프로젝트, 민감 데이터 처리, 비용 절감, 오프라인 환경 상업 서비스, 고성능 요구 앱, 빠른 개발, 다양한 기능 활용

    Ollama 로컬 LLM과 Claude Sonnet 4.6 클라우드 LLM의 주요 특징을 시각적으로 비교한 인포그래픽입니다. 성능, 비용, 프라이버시 등을 아이콘으로 표현했습니다.

    6. 주의사항 및 트러블슈팅 ⚠️

    두 가지 솔루션을 사용하면서 제가 겪었던 몇 가지 주의사항과 팁을 공유해 드릴게요. 삽질은 저 혼자 하는 걸로 족합니다! 😅

    6.1. Ollama 관련

    • GPU 메모리 (VRAM) 부족 문제: 이게 제일 흔한 문제일 거예요. 모델 크기에 비해 GPU VRAM이 부족하면 모델 로딩 자체가 안 되거나, 실행 중 오류가 발생합니다.
      💡 팁: ollama run [model_name] 실행 시 모델을 불러오다가 VRAM 부족 에러가 나면, 더 작은 모델을 사용하거나 GPU 업그레이드를 고려해야 합니다. 아니면 CPU 모드로 실행될 수도 있는데, 속도는 기대하지 마세요.
    • 모델 다운로드 실패: 네트워크 문제나 저장 공간 부족으로 모델 다운로드가 실패할 수 있습니다.
      💡 팁: ollama list 명령어로 현재 다운로드된 모델 목록을 확인하고, df -h로 저장 공간을 확인해 보세요.
    • CUDA (쿠다) 드라이버 문제 (NVIDIA GPU 사용자): 리눅스에서 NVIDIA GPU를 사용한다면 CUDA 드라이버 설치가 제대로 되어 있는지 확인해야 합니다.
      💡 팁: nvidia-smi 명령어로 드라이버와 GPU 상태를 확인하세요.

    6.2. Claude Sonnet 4.6 (클라우드 LLM) 관련

    • API 키 관리: API 키는 여러분의 계정에 직접 연결되어 과금됩니다. 절대 외부에 노출되어서는 안 됩니다!
      ⚠️ 경고: Git 저장소에 API 키를 올리거나, 클라이언트 사이드 코드에 직접 삽입하는 행위는 절대 금물입니다. 환경 변수나 보안 저장소를 이용하세요.
    • 비용 모니터링: 사용량 기반 과금이기 때문에 예상치 못한 비용이 발생할 수 있습니다.
      💡 팁: Anthropic 대시보드에서 사용량 및 지출을 주기적으로 확인하고, 필요하다면 사용 한도를 설정해두는 것이 좋습니다.
    • Rate Limit (요청 제한): API 호출 횟수에 제한이 있을 수 있습니다.
      💡 팁: 대량의 요청을 보낼 때는 API 문서에서 Rate Limit 정보를 확인하고, 적절한 Backoff (지연) 전략을 구현해야 합니다.

    7. 결론 및 활용 제안: 나에게 맞는 LLM은?

    결국 Ollama (로컬 LLM)와 Claude Sonnet 4.6 (클라우드 LLM) 중 무엇을 선택할지는 여러분의 상황과 목적에 달려 있습니다. 제가 내린 결론은 이렇습니다.

    • 프라이버시가 최우선이고, 비용을 절감하며, 하드웨어 투자가 가능한 환경이라면 Ollama를 활용한 로컬 LLM이 좋은 선택입니다. 개인 연구, 내부 개발, 특정 도메인에 특화된 모델 실험에 아주 적합하죠. 저처럼 홈랩을 운영하는 분들에게는 최고의 장난감이 될 겁니다!
    • 최고의 성능과 최신 기능을 원하고, 빠른 개발 및 확장성이 중요하며, 데이터 민감도가 낮은 상업 서비스라면 Claude Sonnet 4.6과 같은 클라우드 LLM이 압도적으로 유리합니다. 인프라 관리 부담 없이 핵심 비즈니스 로직에 집중할 수 있다는 것이 큰 장점입니다.

    가장 이상적인 것은 두 가지 접근 방식을 하이브리드(Hybrid) 형태로 활용하는 것입니다. 예를 들어, 민감한 개인 정보가 포함된 내부 문서는 로컬 LLM으로 요약하고, 일반적인 정보 검색이나 창의적인 글쓰기는 클라우드 LLM을 사용하는 방식이죠. 이렇게 하면 각자의 장점을 최대한 살리면서 단점을 보완할 수 있습니다. 🚀

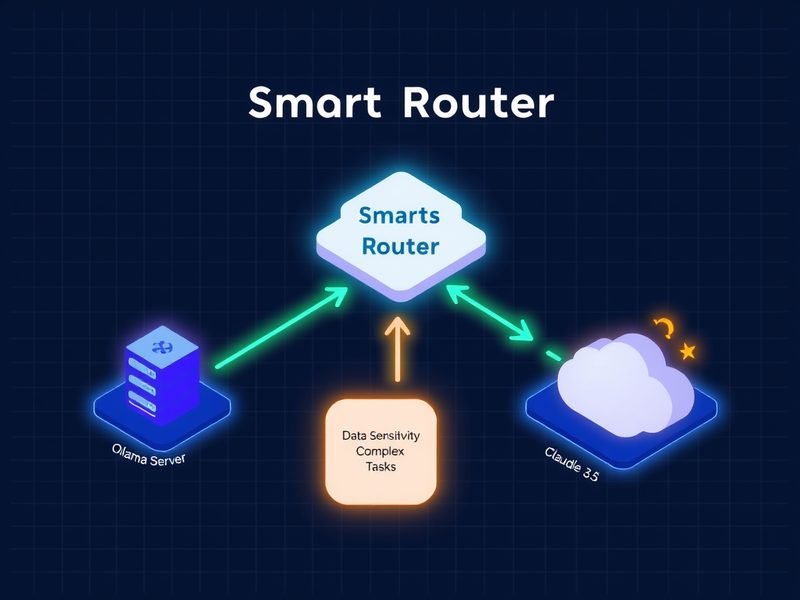
    로컬 LLM과 클라우드 LLM을 결합한 하이브리드 LLM 활용 전략 다이어그램

    로컬 LLM과 클라우드 LLM을 결합한 하이브리드 LLM 활용 전략 다이어그램입니다. 데이터 민감도, 응답 시간, 복잡성 등의 기준에 따라 쿼리를 적절한 LLM으로 라우팅하는 개념을 보여줍니다.

    지금까지 제가 직접 써보면서 느낀 로컬 LLM과 클라우드 LLM의 차이점과 활용법을 공유해 드렸습니다. LLM 기술은 매일매일 발전하고 있으니, 앞으로 또 어떤 새로운 기술이 나올지 기대되네요. 저도 계속해서 홈랩에서 다양한 실험을 해보고, 유용한 정보가 있다면 ’13년차의 서버실’에서 또 찾아뵙겠습니다. 혹시 여러분도 로컬 LLM이나 클라우드 LLM을 활용한 경험이 있으시다면 댓글로 공유해 주세요! 다음 글에서는 Ollama에 올라가는 다른 재미있는 모델들을 직접 돌려본 후기를 들려드릴게요. 감사합니다! 👋