목차
- 1. Whisper API vs 로컬 모델, 쉽게 말해 뭐가 다른가
- 2. whisper api 로컬 비용, 어디서 새는가
- 3. Whisper API 경로: 가장 빨리 시작하는 방법
- 3-1. 가장 단순한 API 호출
- 3-2. Python으로 결과 저장하기
- 4. 로컬 모델 경로: 고정비 구조를 만들고 싶을 때
- 4-1. 로컬 환경 준비
- 4-2. 로컬 STT 실행 예제
- 4-3. 로컬 운영에서 꼭 챙길 것
- 5. whisper api 로컬 비용 최적화의 핵심: 하이브리드 라우팅
- 6. 실제로 많이 겪는 문제와 해결법
- 6-1. 긴 파일에서 처리 실패 또는 품질 저하
- 6-2. 고유명사 인식이 자꾸 틀림
- 6-3. 로컬 GPU는 있는데 생각보다 안 빠름
- 6-4. 개인정보 처리 이슈가 불안함
- 7. 검증과 결과 확인: 무엇을 봐야 성공인가
- 7-1. 제가 추천하는 검증 체크리스트
- 8. 정리와 다음 단계: 어떤 팀에 어떤 선택이 맞는가
- 자주 묻는 질문
Whisper API 로컬 비용 비교: STT 최적화 전략
Whisper 음성 인식 이야기를 하면 결국 다들 같은 질문으로 돌아오더라고요. \”whisper api 로컬 비용, 뭐가 더 이득이냐\” 하는 질문입니다. 저도 홈랩에서 STT(Speech-to-Text, 음성 인식) 파이프라인을 여러 번 갈아엎으면서 이걸 꽤 오래 붙잡고 있었거든요. 처음엔 API가 무조건 편해서 그쪽으로 갔다가, 파일이 쌓이기 시작하니까 비용 구조가 슬슬 신경 쓰이기 시작했습니다. 반대로 로컬 모델은 공짜처럼 보이지만, 막상 GPU 하나 붙이고 운영해보면 전기, 장애 대응, 큐 적체, 모델 관리까지 생각할 게 많더라고요.
그래서 이 글에서는 감성적인 취향 얘기 말고, 실제로 운영 관점에서 Whisper API와 로컬 모델을 어떻게 나눠 쓰면 비용 효율이 좋아지는지 정리해보겠습니다. 음성 인식, STT, 온프레미스 AI(On-premises AI, 사내·자체 서버에서 돌리는 AI), AI 비용 절감 쪽을 같이 보고 계신 분이라면 바로 적용하실 수 있게 예제도 넣었습니다. 결론부터 말하면, whisper api 로컬 비용 비교는 단순 단가보다 트래픽 패턴과 운영 방식에서 갈립니다.
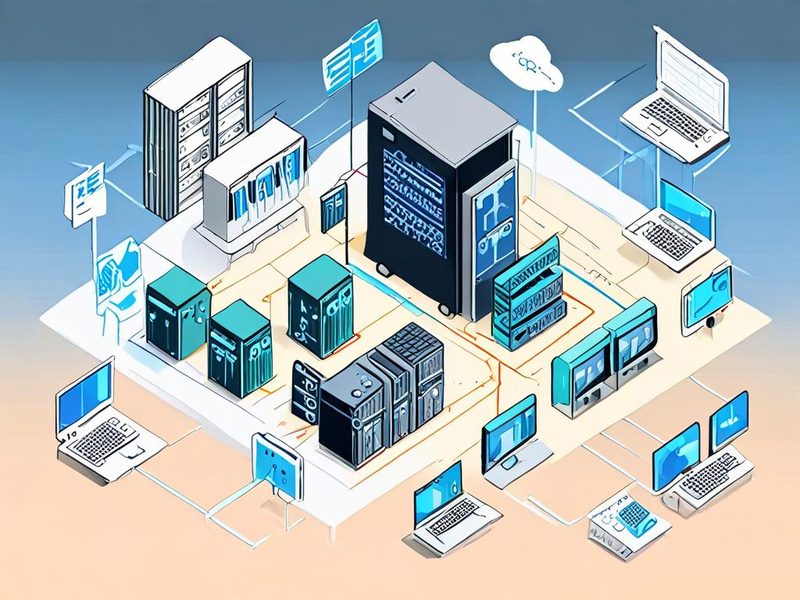
API 호출 경로와 온프레미스 AI 경로를 한눈에 비교하는 개요 이미지입니다.
1. Whisper API vs 로컬 모델, 쉽게 말해 뭐가 다른가
쉽게 말해 이렇습니다. API 방식은 내가 음성 파일을 보내고, 외부 서비스가 STT 결과를 돌려주는 구조입니다. 장점은 빠릅니다. 인프라를 거의 안 만져도 되고, 확장도 편하죠. 대신 처리량이 커질수록 사용량 기반 비용이 누적됩니다.
로컬 모델은 whisper.cpp, faster-whisper 같은 구현체를 서버나 워크스테이션에서 직접 돌리는 방식입니다. 이건 반대예요. 초기 세팅은 귀찮고 손볼 것도 많습니다. 대신 일정 규모 이상으로 올라가면 예측 가능한 고정비 구조를 만들기 좋습니다.
- API: 빠른 도입, 낮은 운영 부담, 사용량 증가 시 비용 누적
- 로컬: 초기 구축 필요, 운영 난이도 있음, 일정 처리량 이상에서 비용 통제 유리
- 하이브리드: 짧고 급한 요청은 API, 길고 반복적인 배치 작업은 로컬
여기서 중요한 포인트가 있습니다. 많은 분이 API와 로컬을 경쟁 관계로만 보시는데, 실제 운영에서는 둘 중 하나를 고르는 것보다 섞어 쓰는 쪽이 더 현실적이었습니다.
2. whisper api 로컬 비용, 어디서 새는가
제가 직접 해보니 비용은 모델 이름보다 워크로드 특성에서 갈리더라고요. 같은 음성 인식이라도 회의록, 콜센터, 인터뷰, 숏폼 자막은 패턴이 다릅니다. 그래서 비용 계산 전에 먼저 어떤 파일이 얼마나 자주 들어오는지부터 봐야 합니다.
| 항목 | API 중심 | 로컬 중심 |
|---|---|---|
| 초기 구축 | 낮음 | 높음 |
| 운영 난이도 | 낮음 | 중간~높음 |
| 비용 구조 | 변동비 중심 | 고정비 중심 |
| 확장성 | 즉시 확장 쉬움 | 하드웨어 한계 고려 필요 |
| 보안/데이터 통제 | 정책 검토 필요 | 내부 통제 유리 |
| 적합한 작업 | 실시간, 급한 요청, 소량 처리 | 대량 배치, 반복 처리, 사내 데이터 |
저는 보통 아래 기준으로 판단합니다.
- 월간 총 처리 시간이 작고, 서비스 출시가 급하면 API로 시작합니다.
- 긴 파일이 많고, 매일 반복 처리되는 배치가 있으면 로컬 후보로 봅니다.
- 개인정보나 사내 민감 음성이 많으면 온프레미스 AI 쪽 가중치를 높입니다.
- 낮 시간에만 몰리는지, 24시간 고르게 들어오는지도 같이 봅니다.
특히 짧은 파일이 아주 많이 들어오는 서비스는 운영 패턴에 따라 결과가 달라집니다. API는 관리가 편하지만 건수가 많아지면 누적 비용이 눈에 띄고, 로컬은 큐만 잘 잡으면 의외로 안정적이더라고요.
3. Whisper API 경로: 가장 빨리 시작하는 방법
처음엔 이게 뭔가 싶었는데, 음성 인식 기능은 일단 빨리 붙여보는 게 중요합니다. 프로덕션 전 검증 단계라면 API가 정말 편합니다. 파일 업로드, 인증, 결과 저장만 만들면 되거든요.
여기서 한 가지는 짚고 가는 게 좋습니다. OpenAI 음성 전사 API에는 <code>whisper-1과 gpt-4o-transcribe 계열이 함께 쓰입니다. 이 글은 제목이 Whisper 기준이라서, 아래 예시는 이름 그대로 Whisper API에 맞춰 whisper-1 기준으로 보여드리겠습니다.
3-1. 가장 단순한 API 호출
export OPENAI_API_KEY="YOUR_API_KEY"

curl --request POST \
  --url https://api.openai.com/v1/audio/transcriptions \
  --header "Authorization: Bearer $OPENAI_API_KEY" \
  --header 'Content-Type: multipart/form-data' \
  --form file=@./sample.wav \
  --form model=whisper-1 \
  --form response_format=text
이 방식의 장점은 명확합니다. 애플리케이션에서 파일만 넘기면 바로 결과를 받을 수 있습니다. 그리고 긴 파이프라인을 만들기 전에, 내 데이터셋에서 어느 정도 품질이 나오는지 빨리 확인할 수 있습니다. 저는 새 프로젝트 시작할 때 항상 이 경로로 먼저 베이스라인을 잡습니다.
3-2. Python으로 결과 저장하기
from pathlib import Path
from openai import OpenAI

client = OpenAI()
audio_path = Path("sample.wav")

with audio_path.open("rb") as audio_file:
    transcription = client.audio.transcriptions.create(
        model="whisper-1",
        file=audio_file,
        response_format="text"
    )

output_path = Path("sample.txt")
output_path.write_text(transcription.text, encoding="utf-8")
print("saved:", output_path)
실제로 써보니까 API 방식에서 중요한 건 모델 선택보다 전처리였습니다. 무음이 긴 파일, 배경 소음이 큰 파일, 채널이 뒤섞인 파일은 비용만 더 먹고 결과는 안 좋아질 수 있거든요. 그래서 저는 업로드 전에 VAD(Voice Activity Detection, 음성 구간 감지)나 간단한 무음 제거를 먼저 넣는 편입니다.
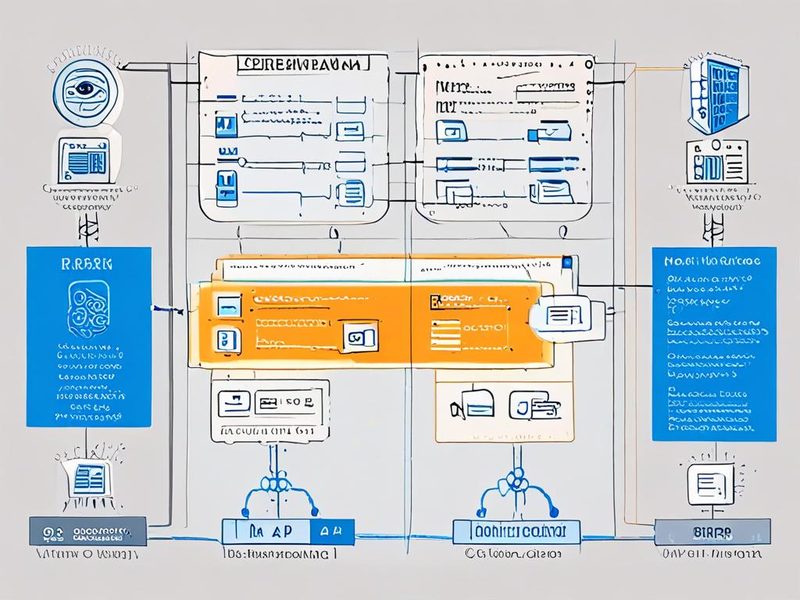
애플리케이션에서 API로 음성을 보내고 결과를 저장하는 흐름을 시각화한 이미지입니다.
4. 로컬 모델 경로: 고정비 구조를 만들고 싶을 때
이제 로컬입니다. 여기서는 whisper.cpp나 faster-whisper 같은 구현체가 많이 쓰이죠. 저는 반복 배치 작업에서는 로컬을 자주 검토합니다. 이유는 단순합니다. 파일이 계속 쌓이는 워크로드에서는 외부 API보다 예측 가능한 운영이 가능하거든요.
4-1. 로컬 환경 준비
sudo apt-get update
sudo apt-get install -y ffmpeg python3-pip
pip install faster-whisper
CPU만으로도 돌아가긴 합니다. 다만 처리 시간이 길어질 수 있어서, 실제 운영에서는 GPU 유무에 따라 설계가 꽤 달라집니다. 저도 처음엔 CPU로 충분하겠지 했다가, 배치 작업이 밤새 밀리는 걸 보고 바로 생각을 바꿨습니다.
4-2. 로컬 STT 실행 예제
from faster_whisper import WhisperModel

model = WhisperModel("small", device="cpu", compute_type="int8")
segments, info = model.transcribe("sample.wav", beam_size=5)

print("language:", info.language)
for segment in segments:
    print(f"[{segment.start:.2f}s - {segment.end:.2f}s] {segment.text}")
여기서 모델 크기는 정확도와 처리 속도의 타협점입니다. 무조건 큰 모델이 답은 아니더라고요. 짧은 고객 문의나 내부 회의 메모처럼 대략 문맥만 맞으면 되는 데이터는 작은 모델도 꽤 실용적입니다. 반면 고유명사, 전문 용어, 다국어가 섞이면 더 신중해야 합니다.
4-3. 로컬 운영에서 꼭 챙길 것
- 큐 분리: 실시간 요청과 배치 요청을 섞지 않습니다.
- 스토리지 관리: 원본 음성, 중간 청크, 결과 텍스트 보관 기간을 나눕니다.
- 관측성: 처리 시간, 실패율, 재시도 횟수, 큐 길이를 기록합니다.
- 전처리: 샘플레이트 변환, 무음 제거, 채널 정리만 해도 체감이 큽니다.
이거 진짜 편하더라고요. 로컬이 귀찮긴 해도 한번 파이프라인이 잡히면, 특히 야간 배치 처리에서는 마음이 한결 편합니다.
5. whisper api 로컬 비용 최적화의 핵심: 하이브리드 라우팅
제가 여러 번 돌려본 끝에 제일 현실적이었던 건 하이브리드 라우팅입니다. 모든 요청을 API로 보내지도 않고, 모든 요청을 로컬로 처리하지도 않습니다. 조건을 나눠서 보내는 거죠.
예를 들면 이런 식입니다.
- 길이가 짧고 즉시 응답이 필요한 파일은 API로 보냅니다.
- 길이가 길거나 야간 일괄 처리 가능한 파일은 로컬 큐로 보냅니다.
- 민감 데이터는 기본적으로 온프레미스 AI 경로로 보냅니다.
- 로컬 큐가 임계치를 넘으면 일시적으로 API로 우회합니다.
routing:
  realtime_max_seconds: 90
  sensitive_data_default: local
  local_queue_threshold: 20
  overflow_target: api
  batch_window: "22:00-06:00"
설정만 있으면 끝나는 건 아닙니다. 실제 분기 로직도 최대한 단순하게 두는 편이 좋습니다. 복잡하게 짜면 처음엔 똑똑해 보여도 운영할 때 더 아프더라고요.
def choose_stt_backend(duration_seconds, sensitive, local_queue_size, realtime):
    if sensitive:
        return "local"
    if realtime and duration_seconds <= 90 and local_queue_size > 20:
        return "api"
    if realtime and duration_seconds <= 90:
        return "api"
    return "local"
이런 단순한 규칙만 있어도 AI 비용 절감 효과가 꽤 납니다. 중요한 건 멋진 알고리즘이 아니라, 내 트래픽 패턴에 맞는 기준을 세우는 것입니다. 저도 처음엔 복잡하게 만들었다가 오히려 운영이 더 힘들어졌습니다. 결국 남는 건 단순한 룰셋이더라고요.
실시간 요청은 API로, 장시간 배치는 로컬로 분기하는 하이브리드 구성 예시입니다.
6. 실제로 많이 겪는 문제와 해결법
여기서부터는 삽질 기록입니다. 저도 처음엔 헷갈렸는데, 이 부분을 미리 알면 시간 꽤 아낄 수 있습니다.
6-1. 긴 파일에서 처리 실패 또는 품질 저하
원인: 파일이 너무 길거나, 무음이 길거나, 중간에 끊어 나누면서 문맥이 깨지는 경우가 많습니다.
해결: 시간 기준이 아니라 발화 구간 기준으로 청크를 나눕니다. 가능하면 문장 중간이 아니라 호흡 단위로 자르는 게 좋습니다.
6-2. 고유명사 인식이 자꾸 틀림
원인: 회사명, 제품명, 사람 이름은 어느 엔진이든 흔들릴 수 있습니다.
해결: 용어 사전(glossary, 용어집)을 따로 두고 후처리합니다. API를 쓸 때는 프롬프트를 통해 철자 힌트를 주는 방식을 검토할 수 있고, 로컬은 후처리 치환이 실용적입니다.
6-3. 로컬 GPU는 있는데 생각보다 안 빠름
원인: 디코딩, 파일 I/O, 전처리, 큐 설계가 병목일 때가 많습니다. 모델만 빠르다고 끝이 아닙니다.
해결: 음성 변환 작업을 워커로 분리하고, 모델 추론 워커와 스토리지 워커를 나눕니다. 처음엔 한 프로세스에 다 넣고 돌렸는데, 이게 진짜 병목이 심했습니다.
6-4. 개인정보 처리 이슈가 불안함
원인: 음성 데이터는 텍스트보다 민감할 수 있습니다.
해결: 민감 업무는 기본값을 로컬로 두고, 원본 보관 기간을 짧게 가져가세요. 필요하면 전사 결과만 남기고 원본을 삭제하는 정책을 먼저 만드는 게 좋습니다.
7. 검증과 결과 확인: 무엇을 봐야 성공인가
드디어 됐다 하고 끝내면 안 됩니다. STT는 돌아가는 것보다 운영 지표가 보이는 상태가 더 중요하거든요. 저는 최소한 아래 항목은 봅니다.
- 처리 시간: 파일 업로드부터 결과 저장까지 얼마나 걸리는지
- 실패율: 재시도 포함 최종 실패 비율
- 큐 적체: 시간대별 대기열 증가 패턴
- 정확도 체감: 샘플링 검수 결과와 자주 틀리는 유형
- 백엔드 비율: API와 로컬이 각각 몇 % 처리하는지
운영 초반에는 완벽한 정확도보다도, 비용 대비 만족도를 보는 게 낫습니다. 예를 들어 회의록 초안을 만드는 용도라면 100점짜리 전사보다 80점짜리를 빠르고 싸게 만드는 쪽이 현업에서는 더 낫더라고요.
처리 시간과 실패율, API/로컬 분배 비율을 확인하는 운영 대시보드 예시입니다.
7-1. 제가 추천하는 검증 체크리스트
- 실제 업무 음성 20개 이상으로 샘플 테스트를 합니다.
- 짧은 파일, 긴 파일, 소음 많은 파일을 섞습니다.
- API와 로컬 결과를 같은 기준으로 비교합니다.
- 품질 차이가 작으면 비용과 운영 편의성을 우선합니다.
- 한 달 단위로 백엔드 분배 정책을 다시 조정합니다.
8. 정리와 다음 단계: 어떤 팀에 어떤 선택이 맞는가
정리해보면 이렇습니다. Whisper API는 시작이 빠르고 운영 부담이 낮습니다. 반면 로컬 모델은 구축 난이도가 있지만, 일정 수준 이상의 반복 처리에서는 비용 통제가 쉬워집니다. 그래서 whisper api 로컬 비용 비교를 할 때는 무조건 단가 싸움으로 가시면 안 됩니다. 트래픽 패턴, 데이터 민감도, 운영 인력, 야간 배치 여부를 같이 봐야 합니다.
혹시 이런 경험 있으신가요? 처음엔 API가 너무 편해서 그냥 밀어붙였는데, 나중에 월간 사용량이 쌓이며 구조를 다시 뜯어고치게 되는 경우요. 저도 그랬습니다. 그래서 요즘은 아예 처음 설계할 때부터 API 시작 + 로컬 확장을 염두에 둡니다. 이게 제일 덜 아프더라고요.
어떤 상황에서 API와 로컬을 선택하면 좋은지 한눈에 정리한 요약 이미지입니다.
자주 묻는 질문
Q. 소규모 서비스도 로컬 STT를 먼저 구축해야 할까요?
아닙니다. 대개는 API로 먼저 검증하고, 반복 처리량이 늘 때 로컬을 붙이는 쪽이 안전합니다.
Q. 온프레미스 AI가 무조건 더 저렴한가요?
그렇지는 않습니다. 유휴 시간이 많으면 하드웨어가 놀 수 있고, 운영 인건비도 무시하기 어렵습니다.
Q. 가장 현실적인 AI 비용 절감 방법은 뭔가요?
전처리로 무의미한 구간을 줄이고, 실시간과 배치를 분리하고, 하이브리드 라우팅을 적용하는 겁니다.
로컬 운영 쪽이 더 궁금하시면 이전 글의 홈랩 GPU 운영 글도 같이 보시면 흐름이 더 잘 잡힙니다. 다음 글에서는 이 내용을 이어서 Whisper 기반 배치 전사 파이프라인을 Docker와 큐 워커로 구성하는 방법도 다뤄보겠습니다.