목차
- LLM 업무 자동화, 쉽게 말해 뭐가 다른가요?
- 도입 전 필수 체크리스트 7가지
- 1. 자동화 대상 업무가 정말 적합한가
- 2. 정답 기준과 실패 기준이 있는가
- 3. 데이터 보안과 개인정보 범위를 정했는가
- 4. 프롬프트보다 입력 포맷을 먼저 고정했는가
- 5. 사람 승인 구간(Human-in-the-loop)이 있는가
- 6. 모니터링과 재현 로그를 남길 수 있는가
- 7. 비용보다 먼저 처리량과 실패율을 보았는가
- 실전 구현: 작은 파일럿부터 만드는 방법
- 1. 입력 스키마 정의
- 2. 실행용 환경 변수 분리
- 3. Python으로 최소 호출기 작성
- 4. 출력 검증과 실패 처리 추가
- 5. 승인 워크플로우 붙이기
- ⚠️ 제가 실제로 겪었던 문제와 해결법
- 문제 1. 입력 길이가 제각각이라 결과 품질이 흔들림
- 문제 2. JSON 형식이 깨져서 후속 시스템이 실패
- 문제 3. 프롬프트 수정 이력이 없어 원인 추적이 안 됨
- 문제 4. LLM이 맞는 말처럼 보이는 틀린 답을 만듦
- 검증과 결과 확인: 파일럿에서 뭘 봐야 하나
- RPA와 LLM, 어떻게 같이 가져가면 좋을까요?
- 정리: 도입 전에 이 7가지만은 꼭 보세요
- 자주 묻는 질문
- Q1. LLM 업무 자동화는 어디서부터 시작하는 게 좋나요?
- Q2. RPA만으로도 되는데 굳이 LLM이 필요한가요?
- Q3. 생산성 향상은 어떻게 측정하나요?
[자동화] LLM 업무 자동화 도입 전 필수 체크리스트 7가지
업무 자동화에 관심 있는 팀이라면 한 번쯤은 LLM 업무 자동화를 붙여보고 싶다는 생각을 하셨을 겁니다. 저도 처음엔 “프롬프트 몇 줄이면 반복 업무가 확 줄겠지” 싶었는데요. 실제로 써보니까 그렇게 단순하지는 않더라고요. 특히 기존 RPA(Robotic Process Automation, 반복 작업 자동화)와 다르게 LLM(Large Language Model, 대규모 언어 모델)은 답이 매번 조금씩 달라질 수 있어서, 운영 관점에서 체크해야 할 포인트가 분명히 있어요.
제가 홈랩이랑 사내 파일 정리, 티켓 분류, 문서 요약 같은 작은 자동화부터 붙여보면서 느낀 건 하나입니다. 도입 전에 체크리스트를 먼저 만들면 삽질이 확 줄어든다는 점이죠. 반대로 이 과정을 건너뛰면 데모는 멋있는데 운영에서 무너집니다. 이번 글에서는 AI 자동화 체크리스트 관점에서, LLM을 업무에 붙이기 전에 꼭 확인해야 할 7가지를 경험 기반으로 정리해봤습니다.
입력 데이터, 프롬프트, 검증 단계, 승인 흐름, 로그 저장까지 한눈에 보이는 LLM 업무 자동화 구조 예시입니다.
LLM 업무 자동화, 쉽게 말해 뭐가 다른가요?
쉽게 말해 RPA는 정해진 버튼을 누르고 정해진 필드를 채우는 데 강합니다. 반면 LLM은 문장을 읽고 요약하고 분류하고 초안을 만드는 데 강하죠. 그래서 둘은 경쟁 관계라기보다 역할이 다릅니다. 실제 현장에서는 RPA와 LLM을 섞는 경우가 더 많습니다.
- RPA: 화면 클릭, 파일 이동, 정해진 양식 입력처럼 규칙이 명확한 작업
- LLM: 메일 분류, 티켓 요약, 문서 초안 작성, 자연어 질의 처리처럼 언어 이해가 필요한 작업
- 함께 쓸 때: LLM이 판단하고, RPA가 실행하는 구조
여기서 중요한 포인트! LLM은 똑똑해 보이지만, 운영 시스템에 넣는 순간엔 “모델 성능”보다 입력 품질, 실패 처리, 감사 로그가 더 중요해요. 저도 처음엔 모델만 바꾸면 해결될 줄 알았는데, 실제 문제는 프롬프트보다 데이터 형식 불일치에서 더 많이 터졌습니다 ㅎㅎ
도입 전 필수 체크리스트 7가지
1. 자동화 대상 업무가 정말 적합한가
첫 번째는 의외로 기술이 아닙니다. 무엇을 자동화할지가 먼저예요. 사람이 매번 판단 기준을 설명하기 어려운 업무, 입력 형태가 너무 제각각인 업무, 결과 오류가 바로 금전 손실로 이어지는 업무는 처음부터 크게 시작하면 위험합니다.
제가 직접 해보니 처음 붙이기 좋은 건 아래 유형이었습니다.
- 입력은 텍스트 중심이고
- 출력 형식이 비교적 고정되어 있고
- 사람 검토를 중간에 넣을 수 있는 업무
예를 들면 고객 문의 1차 분류, 장애 티켓 요약, 회의록 초안 정리 같은 작업이죠. 반대로 승인 없이 바로 외부 시스템을 수정하는 자동화는 초반엔 피하는 게 낫습니다.
2. 정답 기준과 실패 기준이 있는가
이건 정말 중요합니다. 많은 팀이 “잘 요약해 주세요” 같은 목표로 시작하는데요. 운영에서는 그걸로는 부족해요. 무엇이 성공인지, 무엇이 실패인지를 먼저 정해야 합니다.
- 분류 작업: 카테고리 집합이 고정되어 있는가
- 요약 작업: 반드시 포함할 항목이 있는가
- 초안 작성: 금지 표현, 누락되면 안 되는 문장이 있는가
- 추출 작업: JSON 구조가 엄격하게 정의되어 있는가
처음엔 이게 좀 귀찮아 보였는데, 나중에 품질 측정하려면 결국 다시 돌아오게 되더라고요. 드디어 됐다 싶었는데 결과 비교 기준이 없어서 다시 설계한 적도 있습니다.
3. 데이터 보안과 개인정보 범위를 정했는가
LLM 도입 전략에서 가장 먼저 결재받는 항목이기도 합니다. 어떤 데이터를 모델에 넣을 수 있고, 어떤 데이터는 마스킹(masking, 민감정보 가리기)해야 하는지 정해두는 게 중요해요. 특히 메일, 계약서, 고객 문의처럼 개인정보가 섞이는 업무라면 더 그렇습니다.
| 항목 | 질문 | 권장 조치 |
|---|---|---|
| 입력 데이터 | 개인정보가 포함되는가 | 마스킹 또는 제외 규칙 정의 |
| 출력 결과 | 외부 공유 가능 문서인가 | 민감정보 재검사 추가 |
| 로그 | 원문 저장이 필요한가 | 요약 로그와 원문 로그 분리 |
| 권한 | 누가 실행 결과를 보는가 | 역할 기반 접근 제어 적용 |
혹시 이런 경험 있으신가요? 자동화는 편해졌는데, 나중에 “이 텍스트가 어디까지 외부로 갔죠?”라는 질문이 나오면 갑자기 분위기가 싸해집니다. 그래서 보안 범위는 초반에 문서로 박아두는 게 좋습니다.
4. 프롬프트보다 입력 포맷을 먼저 고정했는가
실제로 써보니까 프롬프트(prompt, 모델 지시문)보다 더 중요한 게 입력 포맷 표준화였습니다. 입력이 들쭉날쭉하면 모델도 흔들립니다. 반대로 입력 템플릿만 잘 잡아도 품질이 꽤 안정돼요.
예를 들어 티켓 분류 자동화라면 제목, 본문, 서비스명, 긴급도 후보, 작성 시각 같은 필드를 미리 정리해서 넣는 식이죠. 자유 문장을 그대로 던지는 것보다 훨씬 낫습니다.
5. 사람 승인 구간(Human-in-the-loop)이 있는가
저는 이걸 초반 필수 조건으로 봅니다. 특히 외부 발송 메일, 공지문 초안, 운영 명령 추천 같은 건 자동 실행보다 추천 + 승인 구조가 안전해요. LLM이 완전히 틀리지 않더라도, 어조나 맥락이 미묘하게 어긋나는 순간이 있거든요.
- 초기 단계: 전수 검토
- 안정화 단계: 샘플링 검토
- 고위험 작업: 상시 승인 유지
근데 여기서 욕심내서 승인 단계를 바로 빼면, 나중에 복구 비용이 더 커요. 이건 진짜 여러 번 봤습니다.
6. 모니터링과 재현 로그를 남길 수 있는가
인프라 쪽에서 오래 일하다 보면 결국 남는 건 로그입니다. 왜 저런 결과가 나왔는지 재현이 안 되면 운영이 안 돼요. 최소한 아래는 남겨두는 걸 추천해요.
- 입력 텍스트 해시 또는 식별자
- 프롬프트 버전
- 모델 이름 또는 엔드포인트 구분값
- 응답 시간
- 출력 결과
- 후처리 검증 성공 여부
- 사람 승인 여부
이거 진짜 편하더라고요. 나중에 “이번 주부터 갑자기 분류가 이상해졌어요” 같은 이슈가 나왔을 때 프롬프트 변경인지, 입력 포맷 변경인지, 후처리 버그인지 좁혀갈 수 있습니다.
7. 비용보다 먼저 처리량과 실패율을 보았는가
많은 분들이 가격부터 보시는데, 저는 초반엔 처리량, 지연 시간(latency, 응답 지연), 실패율을 먼저 봐요. 자동화는 결국 사용자 경험과 운영 효율로 판단해야 하거든요. 응답이 너무 느리면 사람이 그냥 수동으로 처리하는 게 나을 수 있습니다.
그래서 파일럿 단계에서는 다음 질문을 꼭 던져보면 좋습니다.
- 하루 몇 건을 처리해야 하는가
- 한 건당 몇 초까지 허용 가능한가
- 실패 시 재시도 정책은 있는가
- 실패한 건을 사람이 이어받는 절차가 있는가
입력 템플릿, 모델 호출, JSON 검증, 사람 승인 단계를 연결한 구성 예시입니다.
실전 구현: 작은 파일럿부터 만드는 방법
이제 말만 하면 아쉽죠. 아래는 문서 요약과 태깅을 하는 아주 작은 파일럿 예시입니다. 핵심은 모델 호출 자체보다 입력 표준화, 출력 검증, 로그 기록을 같이 넣는 겁니다.
1. 입력 스키마 정의
task: ticket_summary
input_schema:
  - title
  - body
  - service
  - priority_hint
output_schema:
  summary: string
  category: string
  action_items: array
rules:
  - category must be one of: incident, request, billing, account
  - action_items must be shorter than 5 items
  - do not include personal data in output
이런 식으로 정리해두면 프롬프트가 길어져도 중심이 흔들리지 않습니다.
2. 실행용 환경 변수 분리
export LLM_API_URL="https://example-llm-endpoint.local"
export LLM_API_KEY="change-me"
export APP_ENV="pilot"
export LOG_LEVEL="info"
실서비스라면 비밀값은 시크릿 저장소(secret store)에 넣는 게 맞고요. 홈랩 수준에서도 최소한 평문 하드코딩은 피하는 게 좋습니다.
3. Python으로 최소 호출기 작성
import json
import os
import time
from urllib import request

payload = {
    "input": {
        "title": "VPN 접속이 자주 끊깁니다",
        "body": "재택 근무 중 오후 시간대에 접속이 반복적으로 종료됩니다.",
        "service": "remote-access",
        "priority_hint": "medium"
    },
    "instruction": (
        "Summarize the ticket in Korean. "
        "Return JSON with keys: summary, category, action_items. "
        "Category must be one of incident, request, billing, account."
    )
}

req = request.Request(
    os.environ["LLM_API_URL"],
    data=json.dumps(payload).encode("utf-8"),
    headers={
        "Content-Type": "application/json",
        "Authorization": f"Bearer {os.environ['LLM_API_KEY']}"
    }
)

start = time.time()
with request.urlopen(req, timeout=30) as resp:
    raw = resp.read().decode("utf-8")
elapsed = time.time() - start

print(json.dumps({"elapsed_seconds": round(elapsed, 2), "raw_response": raw}, ensure_ascii=False))
여기서 중요한 건 응답이 예쁘게 오는지가 아니라, 운영에 필요한 메타데이터를 같이 남기는가입니다.
4. 출력 검증과 실패 처리 추가
import json

ALLOWED = {"incident", "request", "billing", "account"}

def validate_output(text):
    data = json.loads(text)
    if data.get("category") not in ALLOWED:
        raise ValueError("invalid category")
    if not isinstance(data.get("action_items"), list):
        raise ValueError("action_items must be list")
    return data
처음엔 이게 너무 빡빡한가 싶었는데, 실제로 운영해보면 이 단계가 없으면 장애 분석이 너무 힘들어요.
5. 승인 워크플로우 붙이기
- LLM이 요약과 분류 결과 생성
- 후처리 검증 수행
- 담당자가 결과 확인
- 승인된 결과만 티켓 시스템에 반영
이 구조가 초반엔 조금 느려 보여도, 품질 학습에는 훨씬 유리해요. 나중에 승인 로그를 기반으로 프롬프트 개선 포인트도 뽑을 수 있거든요.
⚠️ 제가 실제로 겪었던 문제와 해결법
여기부터가 진짜 운영 이야기입니다. 데모에서는 잘 되는데 실전에서 흔히 터지는 문제들이 있습니다.
문제 1. 입력 길이가 제각각이라 결과 품질이 흔들림
처음엔 원문을 통째로 넣었는데, 짧은 문의와 긴 장애 보고서가 섞이니까 출력 형식이 흔들렸습니다. 해결은 단순했어요. 사전 전처리(preprocessing, 입력 정리)를 넣고, 긴 문서는 먼저 섹션 분리 후 요약하게 했습니다.
문제 2. JSON 형식이 깨져서 후속 시스템이 실패
이건 많이 겪습니다. 사람이 보기엔 말이 되는데, 시스템은 JSON 파싱에서 바로 죽어요. 그래서 저는 모델 응답을 바로 저장하지 않고, 검증 실패 시 재시도하거나 사람 검토 큐로 보내는 방식으로 바꿨습니다.
문제 3. 프롬프트 수정 이력이 없어 원인 추적이 안 됨
삽질 좀 했습니다 ㅎㅎ 어느 날부터 결과가 달라졌는데, 누가 프롬프트를 바꿨는지 안 남아 있더라고요. 그 뒤로는 프롬프트를 파일로 분리하고 버전 태그를 로그에 남겼습니다.
문제 4. LLM이 맞는 말처럼 보이는 틀린 답을 만듦
이른바 hallucination(환각, 사실과 다른 생성)이죠. 해결은 모델을 믿지 않는 쪽으로 설계하는 겁니다. 자유 생성 대신 분류 후보 제한, 필수 필드 강제, 외부 기준 데이터와 대조를 넣으면 훨씬 안정돼요.
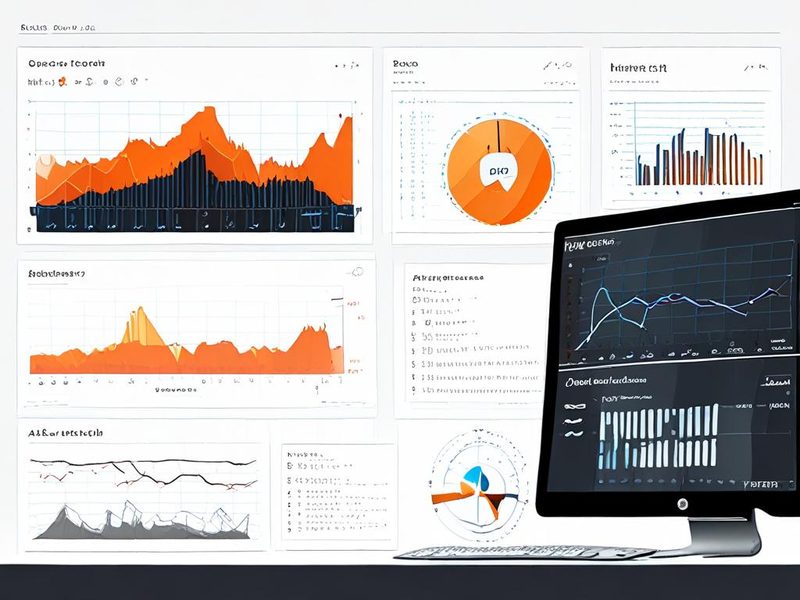
처리량, 응답 시간, 검증 실패 건수, 사람 승인 비율을 함께 보는 운영 대시보드 예시입니다.
검증과 결과 확인: 파일럿에서 뭘 봐야 하나
파일럿을 돌릴 때는 “느낌상 괜찮다” 말고 숫자와 절차를 같이 봐야 합니다. 저는 보통 아래 항목을 체크해요.
- 자동 분류 성공률
- 사람 수정 비율
- 평균 응답 시간
- 검증 실패 비율
- 재시도 후 복구 비율
- 최종 승인까지 걸리는 시간
여기서 핵심은 완벽함이 아닙니다. 어느 단계에서 실패하는지 보이는 구조를 만드는 게 먼저예요. 그래야 생산성 향상도 진짜인지 판단할 수 있어요. 단순히 생성만 빨라도 승인과 수정 시간이 길면 전체 흐름은 오히려 느려질 수 있거든요.
그래서 결과 보고는 아래처럼 나누면 깔끔합니다.
| 구분 | 확인 포인트 | 의미 |
|---|---|---|
| 품질 | 사람 수정 비율 | 출력 신뢰도 판단 |
| 속도 | 평균 처리 시간 | 수동 업무 대비 효율 비교 |
| 안정성 | 검증 실패 및 재시도 비율 | 운영 가능성 판단 |
| 보안 | 민감정보 누출 여부 | 확장 가능성 판단 |
RPA와 LLM, 어떻게 같이 가져가면 좋을까요?
RPA와 LLM을 대립적으로 볼 필요는 없습니다. 오히려 가장 현실적인 조합은 이겁니다. LLM이 문서를 읽고 분류하고, RPA가 그 결과를 받아 시스템에 입력하는 구조요. 이렇게 나누면 책임 경계가 분명해집니다.
- LLM: 언어 처리와 판단 보조
- 검증기: 형식 체크와 정책 확인
- RPA 또는 API 연동: 실제 시스템 반영
- 사람: 승인과 예외 처리
이 구조는 LLM 도입 전략을 세울 때도 설명하기 좋습니다. 경영진에게는 생산성 향상 포인트를, 운영팀에는 실패 처리와 감사 가능성을 보여줄 수 있으니까요.
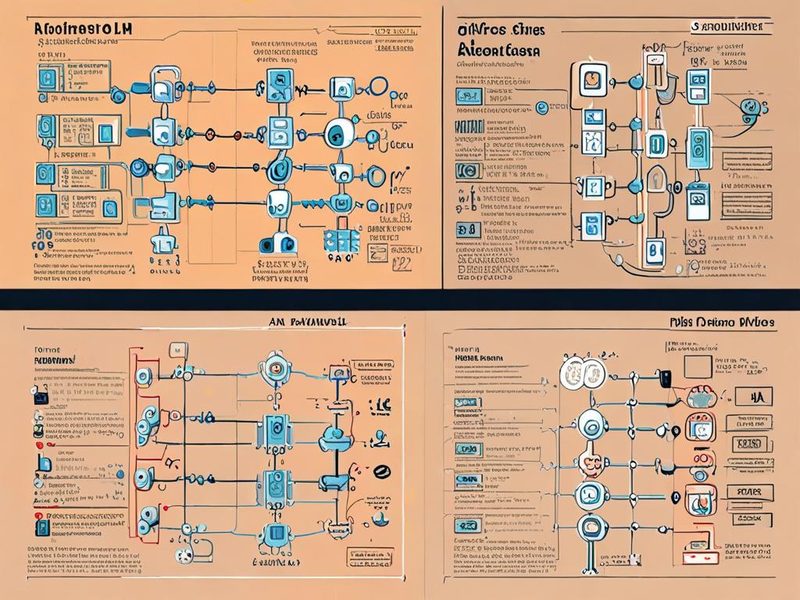
문서 이해는 LLM, 정형 실행은 RPA가 맡는 역할 분담을 한눈에 정리한 비교 그림입니다.
정리: 도입 전에 이 7가지만은 꼭 보세요
마무리해보겠습니다. LLM 업무 자동화는 분명 강력합니다. 저도 직접 붙여보니 반복 업무를 줄이는 데 꽤 효과가 있었고요. 다만 운영으로 들어가는 순간, 멋진 데모보다 체크리스트와 검증 흐름이 훨씬 중요했습니다.
- 자동화 대상 업무가 LLM에 맞는지 확인
- 성공 기준과 실패 기준 정의
- 보안 및 개인정보 범위 확정
- 입력 포맷 표준화
- 사람 승인 구간 설계
- 로그와 재현 정보 저장
- 비용보다 처리량과 실패율 먼저 점검
여기까지 정리하면 적어도 “일단 붙여보고 나중에 보자” 단계에서 생기는 큰 사고는 많이 줄어듭니다. 다음 글에서는 실제로 AI 자동화 체크리스트를 팀 문서 템플릿으로 만드는 방법, 그리고 프롬프트 버전 관리 흐름을 다뤄볼 예정입니다. 이전 글에서 다뤘던 로그 표준화 이야기도 함께 보면 연결이 더 잘 되실 겁니다.
자주 묻는 질문
Q1. LLM 업무 자동화는 어디서부터 시작하는 게 좋나요?
정답이 명확하고 사람이 검토할 수 있는 작은 분류나 요약 업무부터 시작하는 게 좋습니다. 처음부터 완전 자동 실행은 위험해요.
Q2. RPA만으로도 되는데 굳이 LLM이 필요한가요?
정형 데이터 입력만 하면 되는 업무는 RPA가 더 단순할 수 있습니다. 다만 메일, 문서, 문의 내용처럼 비정형 텍스트를 다루면 LLM이 훨씬 유리해요.
Q3. 생산성 향상은 어떻게 측정하나요?
생성 속도보다 전체 처리 시간을 보셔야 합니다. 사람 수정 시간, 승인 시간, 실패 재처리 시간을 같이 봐야 실제 생산성 향상인지 판단할 수 있어요.