13년차의 서버실

서버, 인프라, 홈랩 기술 블로그

[태그:] RAG 디버깅

  • [AI] LangChain 오류 디버깅 전략과 실전 트러블슈팅

    [AI] LangChain 오류 디버깅 전략과 실전 트러블슈팅

    LangChain 오류 디버깅 전략과 실전 트러블슈팅

    LangChain 오류를 오래 들여다보면 한 가지 패턴이 보입니다. 실제 장애의 상당수는 “모델이 이상해서”가 아니라, 모델에 도달하기 전후의 계약이 깨져서 납니다. 입력 키가 하나 빠졌거나, 프롬프트 변수명이 바뀌었거나, retriever가 엉뚱한 문서를 가져왔거나, 출력 파서가 모델의 자연어 한 줄을 JSON으로 착각하는 식이죠.

    인프라 엔지니어 관점에서 보면 LangChain은 단순한 체인 문법이 아니라 API 서버, 큐, 환경변수, 네트워크, 관측성까지 이어지는 실행 파이프라인에 가깝습니다. 이 글은 작은 RAG(Retrieval-Augmented Generation, 검색 증강 생성) 앱을 운영하며 정리한 실전 기준입니다. “어제 되던 코드가 오늘 왜 안 되지?” 싶은 순간에 바로 확인할 수 있도록 명령어와 판단 기준을 함께 넣었습니다.

    LangChain 앱에서 입력, 프롬프트, 모델, 파서, 관측 도구가 어떻게 이어지는지 보여주는 개요 이미지입니다.

    1. LangChain 오류는 컴포넌트보다 계약부터 봐야 합니다

    LangChain은 Prompt Template(프롬프트 템플릿), Chat Model(채팅 모델), Retriever(검색기), Output Parser(출력 파서), Tool(도구)을 파이프처럼 이어줍니다. 여기서 중요한 건 각 단계가 서로 “어떤 입력을 받고 어떤 출력을 넘기는지”입니다. 저는 장애를 볼 때 컴포넌트 이름보다 계약 위반 여부를 먼저 봅니다.

    • 입력 계약 위반: 프롬프트가 요구하는 변수와 실제 payload 키가 다릅니다.
    • 타입 계약 위반: 다음 단계는 문자열을 기대하는데 앞 단계가 dict, list, Document 객체를 넘깁니다.
    • 의존성 계약 위반: 예전 예제의 import 경로와 현재 설치된 패키지 구조가 맞지 않습니다.
    • 인증·네트워크 계약 위반: API 키, 조직 설정, 프록시, 방화벽, timeout 설정이 실행 환경과 충돌합니다.
    • 출력 계약 위반: 모델 응답이 JSON, Pydantic 스키마, enum 값 같은 엄격한 형식을 따르지 않습니다.
    • 검색 품질 계약 위반: RAG에서 retriever가 질문과 관련 없는 문서를 가져오고, 모델은 그 문서 안에서만 그럴듯하게 답합니다.

    이 관점이 유용한 이유는 단순합니다. “LLM이 틀렸다”는 말은 범위가 너무 넓거든요. 반면 “prompt 입력 계약이 깨졌다”, “parser 출력 계약이 깨졌다”라고 말하면 바로 재현 코드와 테스트 케이스를 만들 수 있습니다.

    2. 재현 가능한 환경부터 고정하세요

    LangChain 디버깅을 시작할 때 제일 먼저 할 일은 코드 수정이 아니라 환경 스냅샷입니다. 특히 LangChain은 코어 패키지, 통합 패키지, 커뮤니티 패키지가 분리되어 있어 import 경로와 설치 패키지를 같이 봐야 합니다. OpenAI 연동을 쓴다면 공식 문서 기준으로 langchain-openai를 별도로 설치하는 방식이 일반적입니다.

    python -m venv .venv
    source .venv/bin/activate
    python -m pip install -U pip
    python -m pip install -U langchain langchain-core langchain-openai langsmith python-dotenv
    python -m pip check
    python -m pip freeze > requirements.lock.txt
    python -m pip show langchain langchain-core langchain-openai langsmith

    pip check는 의존성 충돌을 빠르게 확인할 때 좋습니다. 여기서 문제가 나오면 LangChain 코드를 보기 전에 패키지 상태부터 정리하는 편이 낫습니다. 운영 서버에서만 깨지는 오류라면 로컬과 서버에서 아래 명령 결과를 나란히 비교하세요.

    python --version
    python -m pip --version
    python -m pip show langchain langchain-core langchain-openai langsmith
    python - <<'PY'
    import importlib.metadata as m
    for name in ['langchain', 'langchain-core', 'langchain-openai', 'langsmith']:
        try:
            print(name, m.version(name))
        except m.PackageNotFoundError:
            print(name, 'NOT INSTALLED')
    PY

    튜토리얼을 따라 했는데 ModuleNotFoundError나 ImportError가 나면, 코드보다 먼저 “그 예제가 어느 시기의 패키지 구조를 기준으로 쓰였는지”를 보세요. 오래된 글에서 langchain.chat_models 계열 import를 복사했다면 현재 프로젝트의 공식 import 경로와 맞지 않을 수 있습니다. 이건 실력 문제가 아니라 패키지 분리의 흔적입니다.

    3. INVALID_PROMPT_INPUT를 일부러 재현해보기

    초보 단계에서 자주 만나는 LangChain 오류는 프롬프트 변수 누락입니다. LangChain의 INVALID_PROMPT_INPUT 오류는 프롬프트 템플릿이 요구하는 입력과 실제 전달한 값이 어긋날 때 발생합니다. 운영에서는 이게 더 교묘합니다. 프론트엔드에서는 question으로 보내는데 백엔드에서는 query로 넘기거나, 큐 메시지에 필드 하나가 빠지는 식이죠.

    from langchain_core.prompts import ChatPromptTemplate
    
    prompt = ChatPromptTemplate.from_messages([
        ('system', 'You are a helpful assistant.'),
        ('human', '{question}에 대해 {tone} 말투로 설명해줘'),
    ])
    
    print('required variables:', prompt.input_variables)
    
    # 일부러 tone을 빼서 오류를 재현합니다.
    messages = prompt.invoke({'question': 'LangChain 오류'})
    print(messages)

    실제로는 모델 호출 전에 payload를 검증해서 “모델 API 비용을 쓰기도 전에 실패”하게 만드는 편이 좋습니다. 오류를 늦게 발견할수록 로그가 지저분해지고 비용도 새기 쉽거든요.

    def validate_prompt_payload(prompt, payload: dict) -> None:
        required = set(prompt.input_variables)
        received = set(payload.keys())
        missing = required - received
        extra = received - required
    
        if missing:
            raise ValueError(f'Missing prompt variables: {sorted(missing)}')
        if extra:
            print(f'[debug] Extra payload keys ignored by prompt: {sorted(extra)}')
    
    payload = {'question': 'LangChain 디버깅', 'tone': '친절한'}
    validate_prompt_payload(prompt, payload)
    messages = prompt.invoke(payload)
    print(messages)

    실무 기준으로는 extra를 무조건 오류로 보지 않습니다. API 요청 전체에는 사용자 ID, trace ID, locale 같은 부가 필드가 들어갈 수 있으니까요. 다만 missing은 즉시 실패시키는 편이 낫습니다. 누락된 값을 빈 문자열로 채우면 당장은 지나가도 모델 응답 품질이 조용히 망가집니다.

    4. LCEL 체인은 예쁘게 쓰되, 디버깅은 끊어서 합니다

    LCEL(LangChain Expression Language)은 prompt | model | parser처럼 읽기 좋은 체인을 만들 수 있어서 생산성이 좋습니다. 문제는 한 줄로 연결한 체인이 실패하면 어느 단계에서 깨졌는지 한눈에 보이지 않는다는 점입니다. 장애 상황에서는 체인을 잠시 해체하세요. 각 연결부에서 실제 값이 무엇인지 보는 게 훨씬 빠릅니다.
    LangChain 디버깅을 위한 LCEL 체인 단계별 구성도

    프롬프트, 모델, 파서 단계를 나누어 어디서 입력과 출력이 바뀌는지 확인하는 구성도입니다.

    from langchain_core.prompts import ChatPromptTemplate
    from langchain_core.output_parsers import StrOutputParser
    from langchain_openai import ChatOpenAI
    
    prompt = ChatPromptTemplate.from_template('{topic}을 초보자에게 3문장으로 설명해줘.')
    model = ChatOpenAI(model='gpt-4o-mini', temperature=0, timeout=30, max_retries=2)
    parser = StrOutputParser()
    
    inputs = {'topic': 'LangChain 트러블슈팅'}
    
    prompt_value = prompt.invoke(inputs)
    print('[prompt type]', type(prompt_value))
    print('[prompt value]', prompt_value)
    
    model_result = model.invoke(prompt_value)
    print('[model type]', type(model_result))
    print('[model content]', model_result.content)
    
    parsed = parser.invoke(model_result)
    print('[parsed type]', type(parsed))
    print('[parsed]', parsed)

    temperature=0은 디버깅할 때 변동성을 줄이려는 선택입니다. 창의적인 답변을 평가하는 단계가 아니라 오류 재현 단계라면, 같은 입력에 최대한 비슷한 응답이 나오는 편이 원인 분석에 유리합니다. timeout과 max_retries는 운영에서 더 중요합니다. timeout이 없으면 요청이 오래 붙잡혀 API 서버 worker를 묶을 수 있고, retry가 과하면 장애 상황에서 외부 API를 더 세게 두드릴 수 있습니다.

    실패 위치 흔한 에러 신호 근본 원인 먼저 할 일 주의할 트레이드오프
    Prompt 필수 변수 누락, 템플릿 포맷 오류 payload 스키마와 템플릿 변수명 불일치 prompt.input_variables와 요청 body 비교 기본값으로 덮으면 조용한 품질 저하가 생길 수 있음
    Model 인증 실패, timeout, rate limit, 모델명 오류 환경변수, 네트워크, provider 설정 문제 API 키 존재 여부와 실제 모델명을 로그로 확인 retry를 늘리면 안정성은 오르지만 지연과 비용이 늘 수 있음
    Parser JSONDecodeError, validation error 자연어 응답을 엄격한 스키마로 해석 raw output을 저장하고 스키마와 비교 구조화 출력은 안정적이지만 provider 지원 여부를 확인해야 함
    Retriever 답변은 자연스럽지만 근거가 엉뚱함 청크, 임베딩, 검색 쿼리, 필터 조건 문제 검색된 문서 제목·점수·본문 일부 출력 top_k를 늘리면 recall은 오르지만 잡음과 토큰 사용량도 늘 수 있음
    Tool 도구 인자 validation 실패 모델이 tool schema와 다른 인자를 생성 tool call 원문과 schema 필수 필드 확인 스키마를 너무 엄격하게 만들면 재시도가 잦아질 수 있음

    5. 환경변수는 .env와 런타임 값을 분리해서 봅니다

    LLM 앱에서 인증 오류는 의외로 단순한 곳에서 납니다. .env에는 키가 있는데 프로세스에는 로드되지 않았거나, Docker 컨테이너에는 다른 값이 들어갔거나, 스테이징 서버가 운영용 LangSmith 프로젝트로 trace를 보내는 식입니다. 로컬 개발에서는 python-dotenv가 편하지만, 운영에서는 플랫폼의 secret 관리 기능을 우선하세요.

    OPENAI_API_KEY=sk-여기에_실제_키를_넣지_말고_로컬에서만_관리
    LANGSMITH_API_KEY=lsv2_여기에_LANGSMITH_키
    LANGSMITH_TRACING=true
    LANGSMITH_PROJECT=langchain-debug-local
    from dotenv import load_dotenv
    import os
    
    load_dotenv()
    
    required_env = ['OPENAI_API_KEY']
    for key in required_env:
        if not os.getenv(key):
            raise RuntimeError(f'Missing required environment variable: {key}')
    
    print('LANGSMITH_TRACING=', os.getenv('LANGSMITH_TRACING', 'false'))
    print('LANGSMITH_PROJECT=', os.getenv('LANGSMITH_PROJECT', 'not-set'))

    운영 관점에서 LANGSMITH_PROJECT는 꼭 나누는 편이 좋습니다. 개발, 스테이징, 운영 trace가 섞이면 장애 분석 때 “어느 요청이 진짜 고객 요청인지”부터 다시 걸러야 합니다. 로그 비용과 보안 정책도 같이 봐야 합니다. 프롬프트나 검색 문서에 개인정보·계약 정보·내부 장애 내용이 들어갈 수 있다면 trace에 무엇을 남길지 팀 기준을 먼저 정해야 합니다.

    6. LangSmith trace는 print의 대체가 아니라 요청 단위 블랙박스입니다

    로컬에서 한 명이 테스트할 때는 print만으로도 충분합니다. 하지만 API 서버에서 동시에 여러 요청이 들어오면 stdout 로그는 금방 섞입니다. LangSmith 같은 관측성 도구를 붙이면 chain run, model call, parser 실행 흐름을 요청 단위 trace로 따라갈 수 있습니다. 이거 붙여두면 장애 회고 때 진짜 편하더라고요.

    • 입력: 사용자가 보낸 원문과 서버가 체인에 넘긴 값이 같은지 확인합니다.
    • 중간 출력: 프롬프트 완성본, 검색된 문서, 모델 raw response를 분리해서 봅니다.
    • 실패 지점: 전체 latency 중 어디에서 오래 걸렸고 어느 단계에서 예외가 났는지 봅니다.
    export OPENAI_API_KEY='여기에_API_키'
    export LANGSMITH_API_KEY='여기에_LANGSMITH_키'
    export LANGSMITH_TRACING='true'
    export LANGSMITH_PROJECT='langchain-debug-lab'
    python app.py

    print 로그를 완전히 버리라는 뜻은 아닙니다. 개발 초반에는 print + 단계별 invoke가 가장 빠릅니다. 다만 팀 단위 운영으로 넘어가면 trace ID를 HTTP 응답 헤더나 애플리케이션 로그에 같이 남기는 쪽이 좋습니다. 고객 문의, 서버 로그, LangSmith trace를 같은 ID로 묶을 수 있으면 원인 추적 속도가 확 달라집니다.

    상황 추천 도구 이유 쓰지 않아도 되는 경우
    개인 실험, 노트북 코드 print, 단계별 invoke 설정이 적고 즉시 확인 가능 동시 요청이 없고 실패 입력이 단순할 때
    FastAPI/Flask API 서버 구조화 로그 + trace ID 요청별 입력과 예외를 묶기 쉬움 일회성 데모라면 과할 수 있음
    팀 운영 서비스 LangSmith tracing 체인 내부 단계와 모델 호출을 시각적으로 추적 민감 데이터 로깅 정책을 정하지 못했다면 먼저 보류
    회귀 방지 pytest 재현 테스트 한 번 고친 오류가 다시 나는지 확인 모델 품질 평가처럼 정답이 유동적인 경우엔 별도 eval이 필요

    7. JSON 파싱 오류는 프롬프트만으로 해결하기 어렵습니다

    AI 프레임워크 오류 중 사람을 가장 오래 붙잡는 게 출력 파싱입니다. 모델은 자연어를 잘하지만, 애플리케이션은 종종 엄격한 JSON을 원합니다. 쉼표 하나, 따옴표 하나, enum 값 하나만 달라도 parser는 실패합니다. 제가 보는 선택지는 세 가지입니다.

    • 문자열 후처리: 빠르지만 취약합니다. 데모나 내부 도구에만 제한적으로 씁니다.
    • Output Parser: 프롬프트에 형식 지시를 넣고 파서로 검증합니다. 실패 시 raw output 저장이 중요합니다.
    • 구조화 출력: 모델 호출 단계에서 스키마를 강제합니다. 지원 모델과 provider를 확인해야 하지만 운영 안정성은 대체로 이쪽이 낫습니다.
    from typing import Literal
    from pydantic import BaseModel, Field
    from langchain_openai import ChatOpenAI
    
    class Ticket(BaseModel):
        title: str = Field(description='장애 제목')
        severity: Literal['low', 'medium', 'high'] = Field(description='장애 심각도')
        summary: str = Field(description='장애 요약')
    
    model = ChatOpenAI(model='gpt-4o-mini', temperature=0, timeout=30)
    structured_model = model.with_structured_output(Ticket)
    
    result = structured_model.invoke('결제 API가 간헐적으로 실패하고 있습니다. 영향 범위가 넓어 보입니다.')
    print(result)
    print(type(result))

    Literal을 쓴 이유는 단순합니다. severity가 critical, urgent, 높음처럼 제멋대로 늘어나면 downstream 시스템에서 다시 분기 오류가 납니다. 스키마를 좁게 잡으면 validation 실패는 늘 수 있지만, 잘못된 값이 조용히 DB에 저장되는 위험은 줄어듭니다. 운영에서는 둘 중 무엇이 더 비싼 장애인지 판단해야 합니다.

    from pydantic import ValidationError
    
    try:
        ticket = structured_model.invoke('DB 연결이 실패해서 로그인 API가 실패합니다.')
    except ValidationError as exc:
        print('[schema validation failed]')
        print(exc)
        # 운영에서는 원문 입력, raw 응답, trace_id를 함께 저장하는 쪽이 좋습니다.
        raise

    반대로 간단한 블로그 요약, 내부 메모 생성처럼 사람이 읽고 끝나는 작업이라면 엄격한 Pydantic 스키마가 오히려 과할 수 있습니다. 이럴 땐 StrOutputParser로 충분합니다. 기준은 “사람이 읽을 텍스트인가, 시스템이 소비할 데이터인가”입니다. 시스템이 소비한다면 구조화 출력이나 검증 레이어를 빼지 않는 게 맞습니다.

    8. RAG 오류는 모델보다 검색 결과부터 의심하세요

    문서 검색 챗봇을 만들 때 가장 많이 속는 부분이 RAG 품질 문제입니다. 답변은 매끄러운데 사실관계가 묘하게 틀릴 때가 있거든요. 처음엔 모델을 바꿔야 하나 싶지만, trace를 보면 retriever가 질문과 관련 없는 문서를 가져오는 경우가 꽤 많습니다. 모델은 받은 근거 안에서 열심히 답했을 뿐입니다.

    RAG에서 “틀린 답변”은 최소 세 종류로 나눠야 합니다. 첫째, 관련 문서를 못 찾은 검색 실패입니다. 둘째, 관련 문서는 찾았지만 청크가 잘려 핵심 문맥이 빠진 경우입니다. 셋째, 문서는 맞는데 프롬프트가 근거 밖 추론을 허용한 경우입니다. 이 셋은 대응이 다릅니다.

    def debug_documents(docs, limit: int = 3) -> None:
        for i, doc in enumerate(docs[:limit], start=1):
            source = doc.metadata.get('source', 'unknown')
            title = doc.metadata.get('title', 'no-title')
            text = doc.page_content.replace('\n', ' ')[:500]
            print(f'\n[doc {i}] source={source} title={title}')
            print(text)
    
    query = 'FastAPI에서 LangChain 체인이 timeout 날 때 어디를 봐야 하나요?'
    docs = retriever.invoke(query)
    debug_documents(docs)

    위 출력에서 질문과 상관없는 문서가 계속 나온다면 모델 파라미터를 만지기 전에 retriever 설정을 봐야 합니다. top_k를 늘리면 관련 문서를 포함할 가능성은 올라가지만, 무관한 문서도 같이 들어와 토큰 사용량과 혼선을 늘릴 수 있습니다. chunk size를 키우면 문맥은 보존되지만 검색 단위가 둔해질 수 있고, 너무 작게 자르면 답변에 필요한 전후 맥락이 사라질 수 있습니다. 그래서 실패 질문을 모아 회귀 테스트처럼 돌리는 게 낫습니다.

    증상 먼저 의심할 곳 확인 방법 추천 대응
    답변이 유창하지만 근거가 틀림 Retriever 검색된 문서 제목·본문 일부를 출력 쿼리 재작성, metadata filter, top_k 조정
    문서는 맞는데 답이 반쪽 Chunking 원문에서 앞뒤 문맥이 잘렸는지 비교 chunk size, overlap, 문서 분할 기준 재검토
    근거 밖 추측이 섞임 Prompt 프롬프트가 모르면 모른다고 하게 만드는지 확인 근거 기반 답변 규칙과 citation 요구 추가
    요청마다 품질 편차가 큼 모델 설정·검색 후보 같은 질문을 여러 번 실행해 raw context 비교 temperature 낮추기, 검색 결과 고정 테스트 작성

    9. 재시도와 timeout은 비용 증폭 장치이기도 합니다

    외부 모델 API를 쓰면 timeout, rate limit, 일시적인 네트워크 오류를 피할 수 없습니다. 그래서 max_retries를 켜는 건 합리적입니다. 다만 재시도는 공짜가 아닙니다. 실패 요청이 많을 때 retry가 겹치면 지연이 늘고, 일부 실패 모드에서는 비용도 커질 수 있습니다.

    환경 timeout retry 이유
    로컬 디버깅 짧게 낮게 빨리 실패해야 원인 확인이 쉬움
    사용자-facing API 제품 SLA에 맞춤 제한적으로 사용자 대기 시간과 성공률 사이 균형 필요
    배치 작업 상대적으로 길게 조금 더 허용 실시간 응답보다 완료율이 중요할 수 있음
    장애 재현 테스트 짧게 0 또는 낮게 재시도가 원래 오류를 가리지 않게 해야 함
    from langchain_openai import ChatOpenAI
    
    # 장애 재현용: 빨리 실패시키고 원인을 숨기지 않습니다.
    debug_model = ChatOpenAI(model='gpt-4o-mini', temperature=0, timeout=10, max_retries=0)
    
    # 일반 API용: 일시적 실패를 약간 흡수합니다.
    api_model = ChatOpenAI(model='gpt-4o-mini', temperature=0, timeout=30, max_retries=2)

    핵심은 모든 환경에 같은 모델 객체를 쓰지 않는 것입니다. 디버깅 모드에서는 오류를 선명하게 보고, 운영 모드에서는 사용자 경험을 보호해야 합니다. 같은 코드베이스라도 목적이 다르면 timeout과 retry 정책도 달라져야 합니다.

    10. 실패 입력은 테스트로 남겨야 다시 안 밟습니다

    LangChain 트러블슈팅을 하다 보면 그 자리에서 고치고 넘어가기 쉽습니다. 하지만 실패 입력을 테스트로 남기지 않으면 프롬프트를 조금 바꾼 날 같은 문제가 다시 돌아옵니다. 최소한 프롬프트 변수 검증, parser validation, retriever 결과 확인은 작은 테스트로 남겨두세요.

    # tests/test_prompt_contract.py
    import pytest
    from langchain_core.prompts import ChatPromptTemplate
    
    prompt = ChatPromptTemplate.from_template('{question}에 대해 {tone} 말투로 답해줘')
    
    def validate_prompt_payload(prompt, payload: dict) -> None:
        missing = set(prompt.input_variables) - set(payload.keys())
        if missing:
            raise ValueError(f'Missing prompt variables: {sorted(missing)}')
    
    def test_prompt_payload_requires_tone():
        with pytest.raises(ValueError):
            validate_prompt_payload(prompt, {'question': 'LangChain 오류'})
    
    def test_prompt_payload_accepts_required_keys():
        validate_prompt_payload(prompt, {'question': 'LangChain 오류', 'tone': '차분한'})
    python -m pytest -q tests/test_prompt_contract.py -s

    모델 호출까지 포함한 테스트는 더 신중해야 합니다. 외부 API 상태, rate limit, 비용, 모델 응답 변동성이 끼어들기 때문입니다. 계약 테스트는 로컬에서 빠르게 돌리고, 실제 모델 품질 평가는 별도 eval이나 스테이징 파이프라인으로 분리하는 편이 관리하기 쉽습니다.
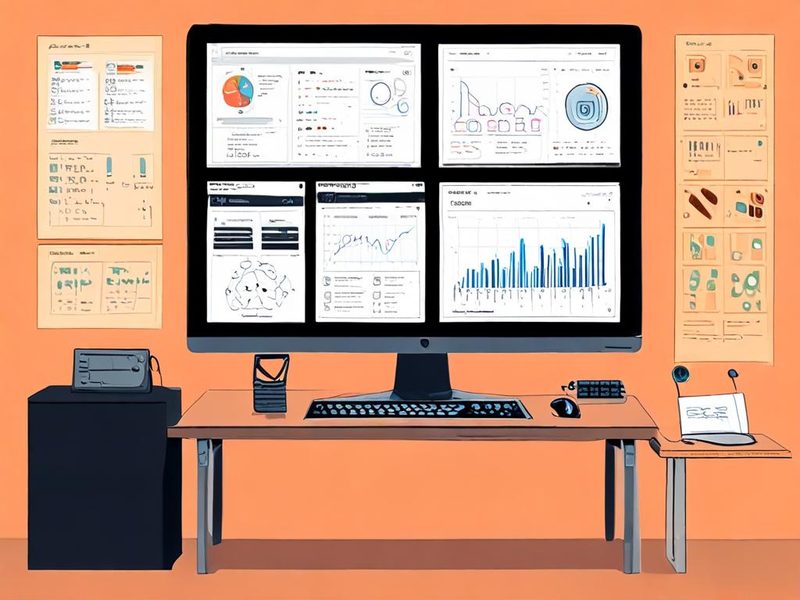
    LangChain 오류 분석을 위한 LangSmith 추적 대시보드 예시

    요청별 trace, 체인 단계, 오류 발생 지점을 한눈에 확인하는 대시보드 예시입니다.

    11. LangChain 트러블슈팅 순서

    아래 순서는 장애를 볼 때 거의 습관처럼 쓰는 흐름입니다. 중요한 건 모델 호출을 맨 앞에 두지 않는 겁니다. 입력과 검색 결과가 깨진 상태에서 모델을 바꿔봐야 문제만 흐려집니다.

    1. 실패 입력을 고정합니다. 사용자 질문, request body, trace ID, 환경 이름을 한 묶음으로 저장합니다.
    2. 패키지와 import를 확인합니다. pip show, pip check, Python 버전을 비교합니다.
    3. 프롬프트 계약을 봅니다. prompt.input_variables와 payload 키를 비교합니다.
    4. LCEL 체인을 끊습니다. prompt.invoke, model.invoke, parser.invoke를 따로 실행합니다.
    5. RAG라면 검색 결과를 출력합니다. 문서 제목, source, 본문 앞부분을 직접 봅니다.
    6. raw output을 저장합니다. parser가 실패했다면 모델 원문 응답 없이는 원인 분석이 어렵습니다.
    7. timeout과 retry를 확인합니다. 재현 테스트에서는 retry를 낮춰 원래 오류를 가리지 않게 합니다.
    8. 고친 뒤 테스트를 남깁니다. 실패 payload를 최소 재현 케이스로 바꿔 회귀를 막습니다.

    이 순서대로 보면 “LangChain이 이상하다”는 막연한 느낌이 “프롬프트 변수 누락”, “retriever 후보 품질 문제”, “JSON schema validation 실패”처럼 처리 가능한 단위로 바뀝니다. 디버깅은 결국 이름 붙이기 싸움입니다.

    12. 자주 묻는 질문: LLM 앱 개발 문제 해결

    Q. LangChain 오류가 나면 가장 먼저 뭘 봐야 하나요?

    A. 에러 메시지 마지막 줄만 보지 말고 실패 단계를 먼저 나누세요. Prompt, Model, Parser, Retriever 중 어디서 깨졌는지 확인하면 해결 속도가 빨라집니다. 제일 빠른 방법은 LCEL 체인을 끊어서 각 단계의 입력·출력 타입을 출력하는 것입니다.

    Q. 버전 문제는 어떻게 줄이나요?

    A. 설치 직후 requirements.lock.txt를 남기고, 로컬·서버에서 python -m pip show langchain langchain-core langchain-openai langsmith 결과를 비교하세요. 오래된 블로그 예제의 import 경로를 그대로 쓰면 현재 패키지 구조와 맞지 않을 수 있습니다.

    Q. JSON 파싱 오류는 프롬프트를 고치면 충분한가요?

    A. 사람이 읽는 데모라면 프롬프트 보강으로도 버틸 수 있습니다. 하지만 시스템이 JSON을 소비한다면 Pydantic 스키마나 구조화 출력을 우선 검토하세요. 프롬프트만으로 형식을 강제하면 모델 응답 변동에 약합니다.

    Q. LangSmith는 언제 붙이는 게 좋나요?

    A. 개인 실험 단계에서는 필수는 아닙니다. API 서버로 여러 요청을 받거나 팀에서 장애를 같이 봐야 한다면 붙이는 편이 좋습니다. 단, trace에 민감 데이터가 남을 수 있으니 로깅 정책을 먼저 정해야 합니다.

    Q. RAG 답변이 이상하면 모델을 바꾸는 게 먼저인가요?

    A. 보통은 아닙니다. 검색된 문서가 질문과 관련 있는지 먼저 확인하세요. retriever가 엉뚱한 문서를 가져오면 좋은 모델도 그 문서 안에서 그럴듯한 오답을 만들 수 있습니다.

    13. 상황별 추천: 이럴 땐 이렇게 가세요

    LangChain 오류를 줄이는 핵심은 전체 체인을 한 번에 믿지 않는 것입니다. 단계별 계약을 확인하고, 실패 입력을 저장하고, 고친 뒤 테스트로 남기면 같은 문제를 반복해서 밟을 가능성이 확 줄어듭니다. 관련 구현 예제가 더 필요하다면 블로그의 RAG 구축 글, FastAPI 배포 글, LLM 관측성 글을 함께 연결해 내부 링크로 안내하면 좋습니다.

    • 처음 개발 중이라면: print + 단계별 invoke로 충분합니다. 복잡한 도구보다 빠른 재현이 우선입니다.
    • 프롬프트 오류가 잦다면: payload 검증 함수를 모델 호출 전에 두세요. 누락 키를 조기에 실패시키는 게 비용과 시간을 아낍니다.
    • API 서버로 운영한다면: timeout, retry, trace ID, LangSmith tracing을 같이 설계하세요. 관측성 없이 운영하면 장애 때 감으로 뒤지게 됩니다.
    • JSON 결과가 중요하다면: 문자열 파싱보다 구조화 출력 또는 Pydantic 검증을 우선하세요. 시스템이 소비하는 데이터는 느슨하게 두면 나중에 더 비싸게 터집니다.
    • RAG 품질이 문제라면: 모델 교체 전에 retriever 결과와 청크 전략을 확인하세요. 검색이 틀리면 생성도 흔들립니다.
    • 장애 재현 중이라면: retry를 낮추고 temperature를 낮춰 오류를 선명하게 보세요. 운영 안정화 설정과 디버깅 설정은 달라도 됩니다.

    기본값은 단순합니다. 개인 개발은 빠르게 재현하고, 팀 운영은 관측 가능하게 만들고, 시스템 연동은 스키마를 엄격하게 가져가세요. LangChain은 체인을 빠르게 만들게 해주지만, 안정적인 LLM 앱은 결국 각 단계의 입력과 출력을 얼마나 차분하게 검증하느냐에 달려 있습니다.
    LangChain 트러블슈팅과 디버깅 전략 요약 인포그래픽

    입력, 체인, 모델, 파서, 관측성 기준으로 디버깅 우선순위를 요약한 이미지입니다.
    참고한 공식 문서

  • [AI] LangChain RAG 오류: 임베딩 문제와 해결 전략

    [AI] LangChain RAG 오류: 임베딩 문제와 해결 전략

    LangChain RAG 오류: 임베딩 문제와 해결 전략

    LangChain RAG 오류를 처음 겪으면 꽤 당황스럽습니다. 문서는 분명 들어갔는데 검색 결과가 엉뚱하게 나오고, 어떤 날은 벡터 저장소에서 차원 불일치 에러가 터지고, 또 어떤 날은 임베딩 단계에서 조용히 일부 문서만 빠지기도 하거든요. 저도 문서 검색용 RAG(Retrieval-Augmented Generation, 검색 증강 생성) 파이프라인을 여러 번 손보면서 같은 문제를 반복해서 봤는데, 막상 파고 들어가 보니 원인은 모델 하나가 아니라 문서 전처리, 청크(chunk, 문서 분할 단위), 메타데이터, 패키지 구성, 임베딩 모델 선택이 얽혀 있더라고요.

    이번 글에서는 LangChain RAG 오류 중에서도 특히 자주 마주치는 LangChain 임베딩 문제를 중심으로, 실제 디버깅할 때 먼저 보는 체크포인트와 해결 전략을 정리해보겠습니다. 단순히 따라 하는 설정이 아니라 왜 이런 문제가 생기는지까지 같이 보면, 이후 LLM 애플리케이션 개발에서도 훨씬 덜 헤매게 됩니다.

    LangChain RAG 오류 흐름과 임베딩 문제 지점을 보여주는 아키텍처 다이어그램

    문서 로더, 텍스트 분할기, 임베딩 모델, 벡터 저장소, 검색기, LLM 응답 생성까지 이어지는 흐름과 오류가 자주 발생하는 지점을 설명하는 이미지입니다.

    왜 LangChain RAG 오류가 임베딩 단계에서 자주 생길까요?

    쉽게 말해 임베딩(Embedding, 텍스트를 숫자 벡터로 바꾸는 과정)은 RAG의 바닥 공사입니다. 여기서 조금만 어긋나도 이후 검색 품질이 크게 흔들립니다. 생성 모델은 멀쩡한데 답변이 이상한 경우, 의외로 원인은 검색 단계 이전인 임베딩 쪽에 있는 경우가 많더라고요.

    제가 직접 겪어보니 특히 아래 네 가지가 반복적으로 문제를 만들었습니다.

    • 임베딩 모델을 바꿨는데 기존 벡터 저장소를 그대로 재사용한 경우
    • 문서 청크가 비어 있거나 너무 짧거나 너무 긴 경우
    • 질문과 문서의 언어 특성이 다른데 모델 특성을 고려하지 않은 경우
    • 배치 처리(batch processing)와 API 제한 때문에 중간에 누락이 생기는 경우

    여기서 중요한 포인트가 하나 있습니다. 오류가 눈에 보이게 터지면 오히려 낫습니다. 진짜 까다로운 건 에러 없이 검색 품질만 나빠지는 상황입니다. 이건 로그만 봐서는 잘 안 보여서, 검증 루틴을 따로 만들어두는 게 진짜 편하더라고요.

    LangChain RAG 오류를 이해하는 핵심 개념

    임베딩 벡터 차원(Dimension, 벡터 길이)

    각 임베딩 모델은 고정된 형태의 벡터를 만듭니다. 벡터 저장소는 이 차원 정보를 기준으로 데이터를 저장하는데, 나중에 다른 임베딩 모델로 바꾸면서 기존 인덱스를 그대로 읽어오면 차원 불일치가 발생할 수 있습니다. 같은 텍스트라도 숫자 표현 방식 자체가 다르기 때문에, 서로 다른 모델에서 만든 벡터를 같은 인덱스에 섞어 쓰면 안 됩니다.

    청크 전략(Chunking Strategy, 문서 분할 방식)

    RAG 디버깅을 하다 보면 임베딩 모델보다 청크 전략이 더 큰 영향을 주는 경우가 많습니다. 문서를 너무 크게 자르면 검색 결과가 뭉뚱그려지고, 너무 잘게 자르면 문맥이 끊깁니다. 특히 FAQ, 기술 문서, 설정 가이드처럼 구조가 뚜렷한 문서는 헤더 기준 분할이 꽤 중요합니다.

    검색 품질과 임베딩 모델 선택

    임베딩 모델 선택은 단순히 성능 좋은 모델을 고르는 문제가 아닙니다. 문서 언어, 도메인, 비용, 지연 시간, 운영 방식까지 같이 봐야 합니다. 예를 들어 한국어 문서 비중이 높은데 영어 중심 평가만 믿고 가면 검색 적중률이 기대보다 낮게 나올 수 있습니다. 반대로 내부 문서가 짧은 영어 설정 파일 위주라면 과한 모델이 꼭 필요한 것도 아니고요.

    실전 구현: 안정적인 LangChain RAG 기본 골격

    아래 예시는 가장 기본적인 구조입니다. 현재 LangChain 생태계는 패키지가 분리되어 있어서, 문서 로더는 <code>langchain-community, OpenAI 임베딩은 langchain-openai, 텍스트 분할기는 langchain-text-splitters를 함께 설치하는 쪽이 안전합니다. 핵심 흐름은 문서를 읽고, 청크를 만들고, 임베딩한 뒤, 벡터 저장소에 넣고, 검색기로 바로 검증하는 겁니다.

    1. 문서를 로드합니다.
    2. 청크 크기와 겹침(overlap)을 정합니다.
    3. 임베딩 모델명을 명시적으로 고정합니다.
    4. 벡터 저장소를 새로 생성하거나, 메타데이터와 함께 관리합니다.
    5. 질문 샘플로 검색 결과를 직접 검증합니다.
    python -m venv .venv
    source .venv/bin/activate
    pip install -U langchain langchain-community langchain-openai langchain-text-splitters faiss-cpu pypdf

    환경 변수도 먼저 분리해두는 게 좋습니다. 운영하다 보면 테스트 키와 운영 키가 섞여서 엉뚱한 장애를 만들기도 하거든요.

    export OPENAI_API_KEY="your_api_key"
    export SOURCE_DOCS_DIR="./docs"
    export VECTOR_DIR="./vector_store"

    이 코드는 PDF 문서를 로드해 청크를 나누고, 빈 청크를 제거한 뒤, 임베딩을 생성해 FAISS 인덱스로 저장하는 예시입니다. 실무에서는 OpenAIEmbeddings()를 기본값으로 두기보다 모델명을 명시해두는 편이 추적하기 쉽습니다.

    import os
    from pathlib import Path
    
    from langchain_community.document_loaders import PyPDFDirectoryLoader
    from langchain_community.vectorstores import FAISS
    from langchain_openai import OpenAIEmbeddings
    from langchain_text_splitters import RecursiveCharacterTextSplitter
    
    DOCS_DIR = Path(os.environ.get("SOURCE_DOCS_DIR", "./docs"))
    VECTOR_DIR = os.environ.get("VECTOR_DIR", "./vector_store")
    
    loader = PyPDFDirectoryLoader(str(DOCS_DIR))
    docs = loader.load()
    
    splitter = RecursiveCharacterTextSplitter(
        chunk_size=800,
        chunk_overlap=120,
        separators=["\n\n", "\n", ". ", " ", ""]
    )
    chunks = splitter.split_documents(docs)
    chunks = [chunk for chunk in chunks if chunk.page_content and chunk.page_content.strip()]
    
    embeddings = OpenAIEmbeddings(model="text-embedding-3-large")
    vectorstore = FAISS.from_documents(chunks, embeddings)
    vectorstore.save_local(VECTOR_DIR)
    
    print(f"documents={len(docs)}")
    print(f"chunks={len(chunks)}")

    여기서 제가 꼭 넣는 줄이 있습니다. 바로 빈 청크 제거입니다. 이거 하나만 넣어도 나중에 검색 이상 현상이 생겼을 때 원인 추적이 훨씬 쉬워집니다.

    LangChain 임베딩 문제를 줄이기 위한 문서 로딩과 청크 분할 구성 다이어그램

    실전 구현 단계에서 어떤 순서로 데이터가 이동하는지, 그리고 어느 단계에서 검증 로그를 남겨야 하는지 시각적으로 보여주는 이미지입니다.

    LangChain RAG 오류를 줄이는 검증 코드

    RAG 디버깅은 “만들었다”로 끝나지 않습니다. 인덱스를 만든 직후 검색 결과를 바로 확인해야 합니다. 저는 보통 아래처럼 샘플 질의를 몇 개 정해서 바로 돌려봅니다.

    한 가지 주의할 점도 있습니다. FAISS.load_local(..., allow_dangerous_deserialization=True)는 로컬에 저장한 신뢰 가능한 인덱스를 다시 읽을 때만 쓰는 옵션입니다. 외부에서 받은 인덱스 파일에 이 옵션을 켜는 건 위험합니다.

    from langchain_community.vectorstores import FAISS
    from langchain_openai import OpenAIEmbeddings
    
    embeddings = OpenAIEmbeddings(model="text-embedding-3-large")
    vectorstore = FAISS.load_local(
        "./vector_store",
        embeddings,
        allow_dangerous_deserialization=True
    )
    
    queries = [
        "이 문서는 어떤 시스템 구성에 대한 설명인가?",
        "장애 대응 절차는 어떻게 정리되어 있나?",
        "설정 파일 경로와 관련된 설명을 찾아줘"
    ]
    
    for query in queries:
        print(f"\n[QUERY] {query}")
        results = vectorstore.similarity_search(query, k=3)
        for idx, doc in enumerate(results, start=1):
            preview = doc.page_content[:180].replace("\n", " ")
            print(f"{idx}. {preview}")

    이 검증을 해보면 생각보다 빨리 감이 옵니다. 질문은 맞는데 본문 일부가 계속 헛나오면 청크 문제일 가능성이 높고, 전혀 다른 문서가 튀어나오면 임베딩 모델 적합성이나 메타데이터 필터 조건을 먼저 의심해보면 됩니다.

    LangChain 임베딩 문제, 이런 식으로 터집니다

    이 섹션이 핵심입니다. 실제로 많이 마주치는 증상과 원인을 표로 먼저 정리해보겠습니다.

    증상 가능한 원인 우선 조치
    차원 불일치 오류 기존 인덱스를 다른 임베딩 모델로 재사용 벡터 저장소를 새로 생성
    에러는 없는데 검색 품질이 낮음 청크 전략 부적절, 언어 특성 불일치 청크 크기/겹침 조정, 샘플 질의 검증
    임베딩 중간 실패 또는 누락 배치 크기 과다, API 제한, 재시도 부족 배치 축소, 로깅 추가, 재시도 적용
    유사도 검색 결과가 비어 있음 문서 로드 실패, 빈 청크 저장 문서 수와 청크 수를 먼저 출력

    1. 임베딩 모델을 바꿨는데 기존 인덱스를 그대로 쓴 경우

    이건 정말 자주 나옵니다. 테스트 단계에서는 모델을 자주 바꿔보게 되거든요. 그런데 FAISS 같은 벡터 저장소는 기존 벡터 차원을 기준으로 인덱스를 유지하므로, 모델을 바꿨다면 거의 항상 재생성이 안전합니다.

    해결 전략은 단순합니다. 벡터 저장소 디렉터리에 메타 파일을 두고, 어떤 임베딩 모델과 청크 설정으로 생성했는지 기록하세요.

    import json
    from pathlib import Path
    
    meta = {
        "embedding_provider": "openai",
        "embedding_model": "text-embedding-3-large",
        "chunk_size": 800,
        "chunk_overlap": 120,
    }
    
    Path("./vector_store").mkdir(exist_ok=True)
    Path("./vector_store/index_meta.json").write_text(
        json.dumps(meta, ensure_ascii=False, indent=2),
        encoding="utf-8"
    )

    2. 문서는 들어갔는데 검색이 너무 엉뚱한 경우

    처음엔 이게 뭔가 싶었는데, 실제로는 청크 설계 문제가 원인인 경우가 많았습니다. 설정 문서와 장애 대응 문서를 한 덩어리로 넣으면 질문 의도와 상관없이 공통 단어에 끌려가더라고요. 특히 한국어 문서는 줄바꿈, 제목, 코드 블록이 의미 단위를 나누는 데 중요해서, 무작정 문자 수만 기준으로 자르면 손해를 보기 쉽습니다.

    해결 전략은 아래 순서로 잡으면 편합니다.

    • 문서 유형별로 분리합니다. 예: 매뉴얼, 장애일지, 설정 예제
    • 헤더 단위 분할을 우선 고려합니다.
    • 청크 미리보기 로그를 남깁니다.
    • 질문 5개 정도를 고정해 회귀 테스트처럼 돌립니다.

    3. 임베딩 호출은 되는데 일부 문서가 빠지는 경우

    이건 조용히 지나가는 경우가 있어서 더 위험합니다. 배치 처리 중 일부 실패, 비정상 문서 인코딩, 너무 긴 텍스트 같은 이유로 누락될 수 있습니다. 저도 나중에 청크 개수와 저장 결과를 대조하다가 발견한 적이 있었는데, 그때 로그가 없었으면 원인 찾는 데 훨씬 오래 걸렸을 겁니다.

    해결 전략은 임베딩 전후 카운트를 반드시 비교하는 겁니다.

    expected_chunks = len(chunks)
    vectorstore = FAISS.from_documents(chunks, embeddings)
    
    print(f"expected_chunks={expected_chunks}")
    print("index build completed")

    단순해 보여도 이 출력 하나가 삽질 시간을 꽤 줄여줍니다.

    4. 한국어 문서 검색이 유독 약한 경우

    여기서는 문서와 질문의 언어 분포를 먼저 봐야 합니다. 내부 문서는 한국어인데 질의 테스트를 영어 예문으로만 돌리면 평가가 왜곡됩니다. 반대로 영어 설정 파일을 한국어로만 묻는 상황도 마찬가지고요. 결국 임베딩 모델 선택은 데이터 특성과 함께 봐야 합니다.

    저는 보통 아래 기준으로 판단합니다.

    • 문서 언어가 한국어 중심인지
    • 질의 언어가 문서와 같은지
    • 코드, 로그, 설정 키가 많은지
    • 짧은 답을 찾는지, 긴 문맥을 찾는지
    LangChain RAG 오류 대표 사례와 임베딩 문제 해결 도식

    실무에서 자주 겪는 임베딩 오류 유형과 각각의 원인, 우선 확인해야 할 체크포인트를 한눈에 정리한 이미지입니다.

    운영 관점에서 추천하는 LangChain RAG 오류 디버깅 체크리스트

    RAG 디버깅은 감으로 하면 오래 갑니다. 체크리스트로 고정해두면 훨씬 수월합니다.

    1. 문서 수와 청크 수를 출력합니다.
    2. 청크 샘플 3~5개를 직접 눈으로 봅니다.
    3. 사용한 임베딩 모델 정보와 청크 설정을 메타데이터로 남깁니다.
    4. 인덱스 생성 직후 고정 질의 세트를 돌립니다.
    5. 검색 결과 상위 3개를 로그로 저장합니다.
    6. 임베딩 모델 변경 시 기존 인덱스를 재사용하지 않습니다.
    7. 문서 인코딩과 특수문자 깨짐 여부를 확인합니다.

    이 정도만 지켜도 대부분의 LangChain RAG 오류는 꽤 빨리 좁혀집니다. 특히 4번과 5번은 꼭 해보세요. 검색 결과를 눈으로 안 보면, 문제를 LLM 탓으로 착각하기 쉽습니다.

    검증 결과는 어떻게 봐야 할까요?

    검증 단계에서는 정답 문장 하나를 맞췄는지보다, 관련 있는 문서를 안정적으로 가져오느냐를 먼저 봐야 합니다. RAG는 1차 검색이 맞아야 2차 생성도 좋아집니다. 저는 보통 아래 기준으로 확인합니다.

    • 같은 질문을 여러 번 해도 상위 결과가 크게 흔들리지 않는지
    • 문서 제목 또는 섹션 단위로 관련성이 보이는지
    • 질문 표현을 조금 바꿔도 비슷한 결과가 나오는지
    • 한국어 질의와 영어 키워드 혼합 질의에서 성능 차이가 과한지

    상위 3개 문서가 납득 가능한 수준으로 꾸준히 나오기 시작하면, 그다음부터는 프롬프트(prompt, 모델 지시문) 튜닝으로 넘어가면 됩니다. 이 지점이 오면 한숨 돌려도 됩니다. 이거 진짜 체감이 확 오더라고요.

    LangChain RAG 오류 검증을 위한 검색 결과 대시보드와 RAG 디버깅 시각화

    샘플 질의를 기준으로 검색 결과의 일관성과 관련성을 확인하는 검증 화면을 표현한 이미지입니다.

    임베딩 모델 선택 시 현실적인 기준

    모델 이름만 비교하면 판단이 오히려 어려워집니다. 운영 조건까지 같이 적어두면 의사결정이 훨씬 쉬워집니다.

    기준 질문 판단 포인트
    언어 한국어 문서 비중이 높은가? 다국어 대응 여부를 우선 확인
    문서 형태 코드/로그/설정 파일이 많은가? 토큰 분포와 특수문자 처리 성향 확인
    운영 비용 대량 재색인이 자주 필요한가? 배치 처리 비용과 속도 고려
    지연 시간 실시간 임베딩이 필요한가? 오프라인 색인과 온라인 질의 경로 분리

    모델을 바꾸면 다 해결될 줄 알았는데, 실제 원인은 청크 설정이었던 경우가 생각보다 많습니다. 저도 처음엔 모델만 계속 갈아타다가 시간을 꽤 썼습니다. 운영에서는 좋은 모델 하나보다 일관된 파이프라인이 더 중요하더라고요.

    이전 글에서 다룬 문서 청크 설계 글도 함께 읽어보시면 흐름이 더 잘 잡힙니다. 내부 링크를 걸어두면 독자 입장에서도 다음 액션이 분명해서 체류 시간 관리에 도움이 됩니다.

    정리: LangChain 임베딩 문제는 로그와 검증 루틴으로 잡아야 합니다

    오늘 내용만 딱 정리하면 이렇습니다.

    • 차원 불일치가 보이면 임베딩 모델 변경 여부부터 확인합니다.
    • 검색 품질 저하는 청크 전략과 문서 구조를 먼저 봅니다.
    • 조용한 실패를 막으려면 문서 수, 청크 수, 샘플 질의 결과를 반드시 기록합니다.
    • 임베딩 모델 선택은 언어, 문서 유형, 운영 비용까지 같이 판단합니다.

    다음 글에서는 RAG 디버깅을 좀 더 확장해서, 재순위화(Reranking, 검색 결과 재정렬)와 하이브리드 검색(Hybrid Search, 키워드+벡터 검색 결합) 기준도 다뤄볼 예정입니다. 이전 글의 문서 청크 설계 내용과 함께 보면 이해가 더 빨라집니다.

    문서 로딩, 청크 분할, 임베딩 생성, 인덱스 재생성, 검색 검증까지의 해결 흐름을 한 장으로 요약한 이미지입니다.

    자주 묻는 질문

    Q1. 에러가 없는데도 답변 품질이 낮으면 어디부터 봐야 하나요?

    A. LLM보다 먼저 검색 결과를 보셔야 합니다. 상위 문서 3개가 질문과 관련이 없으면, 거의 항상 임베딩이나 청크 쪽 문제입니다.

    Q2. 벡터 저장소는 언제 다시 만들어야 하나요?

    A. 임베딩 모델을 바꿨거나, 청크 전략을 크게 바꿨거나, 문서 구조가 크게 바뀌었다면 재생성이 안전합니다.

    Q3. RAG 디버깅에서 가장 먼저 자동화할 것은 뭔가요?

    A. 고정 질의 세트 기반의 회귀 테스트입니다. 같은 질문에 대한 검색 결과를 저장해두면 변경 영향이 바로 보입니다.

  • [AI] LlamaIndex RAG 시스템 구축 실패 사례: 흔한 문제와 디버깅 전략

    [AI] LlamaIndex RAG 시스템 구축 실패 사례: 흔한 문제와 디버깅 전략

    [AI/LLM] LlamaIndex RAG 시스템 구축 실패 사례: 흔한 문제와 디버깅 전략

    LlamaIndex RAG 시스템을 처음 붙일 때 많은 분들이 비슷한 지점에서 막히시더라고요. 문서는 잘 넣은 것 같은데 답이 엉뚱하게 나오고, 로그를 봐도 어디서 망가졌는지 감이 안 오고, 심지어 AI 에이전트(Agent) 문제인 줄 알았는데 알고 보니 검색 단계가 이미 틀어져 있던 경우도 많습니다. 저도 홈랩에서 이것저것 붙여 보면서 삽질 좀 했습니다 ㅎㅎ 처음엔 모델 탓인가 싶었는데, 실제로는 데이터 적재(Ingestion, 문서 수집 및 변환), 청킹(Chunking, 문서 분할), 검색(Retrieval, 관련 문맥 찾기), 응답 합성(Response Synthesis, 답변 생성) 중 하나가 어긋난 경우가 대부분이었습니다.

    이번 글은 제품 홍보나 멋진 데모가 아니라, LlamaIndex RAG를 구성하다가 망했던 패턴을 정리한 실패 사례 중심 글입니다. 특히 RAG 시스템 문제, LlamaIndex 오류, RAG 디버깅, AI 에이전트 실패를 한 번에 점검할 수 있는 흐름으로 정리해 보겠습니다. 혹시 “문서는 넣었는데 왜 이렇게 못 찾지?” 같은 경험 있으신가요? 그거 생각보다 정상입니다. 중요한 건 감으로 고치는 게 아니라, 단계별로 끊어서 확인하는 겁니다.

    LlamaIndex RAG 전체 아키텍처를 보여주는 홈랩 다이어그램

    문서 수집부터 청킹, 벡터 저장, 검색, 응답 생성까지 흐름을 한눈에 보는 개요 이미지입니다.

    LlamaIndex RAG를 쉽게 말하면 어디서 망가질까요?

    쉽게 말해 RAG(Retrieval-Augmented Generation, 검색 증강 생성)는 “모델이 원래 알고 있는 것”에만 기대지 않고, 질문이 들어오면 관련 문서를 먼저 찾아서 그 문맥을 바탕으로 답하게 만드는 구조입니다. LlamaIndex는 이 과정을 구성하기 쉽게 만들어 주는 프레임워크 쪽에 가깝고요.

    제가 직접 해보니, 실패 지점은 생각보다 단순했습니다.

    • 문서 적재 단계: 파일은 읽었는데 내용이 이상하게 잘렸습니다.
    • 인덱싱(Indexing, 검색용 구조화): 벡터 저장은 됐는데 실제 검색 품질이 낮았습니다.
    • 리트리버(Retriever, 관련 문맥 검색기): 질문과 맞는 조각을 못 가져왔습니다.
    • 응답 합성: 검색은 맞았는데 모델이 답변을 엉성하게 만들었습니다.
    • 영속화(Persistence, 디스크 저장): 재시작 후 이전 상태가 사라지거나 오래된 인덱스를 계속 읽었습니다.

    여기서 중요한 포인트! LlamaIndex RAG는 한 덩어리처럼 보이지만, 실제 디버깅은 단계별 분리 진단이 핵심입니다. 검색이 틀렸는데 프롬프트만 계속 고치면 시간만 날립니다.

    실패를 줄이는 기본 설계: 먼저 관측 가능한 구조로 만드세요

    저는 예전엔 일단 돌아가게만 만들고 나중에 로그를 붙였었는데요, 그 방식은 RAG에서 진짜 비효율적이더라고요. 처음부터 “문서가 어떻게 잘렸는지”, “질문에 대해 어떤 노드(Node, 검색 가능한 문서 조각)가 선택됐는지”, “최종 답변이 어떤 근거를 썼는지”가 보여야 합니다.

    구간 자주 보이는 증상 실제 원인 후보 우선 확인할 것
    문서 로딩 파일은 읽히는데 답변이 비어 있음 본문 추출 실패, 인코딩 문제, 예상과 다른 폴더 로드된 문서 수와 본문 샘플
    청킹 검색 결과가 너무 짧거나 문맥이 끊김 chunk_size 과소, overlap 부족 분할된 노드 샘플
    검색 관련 없는 문서가 자주 나옴 질문-문서 표현 불일치, 메타데이터 필터 오류 retriever 결과 목록
    응답 생성 찾아놓고도 엉뚱한 답변 프롬프트 제약, 컨텍스트 과다/과소 source nodes와 최종 응답 비교
    저장/재로딩 재실행 후 결과가 달라짐 인메모리 상태 의존, persist 누락 저장 경로와 로딩 경로

    LlamaIndex RAG 실전 구현: 최소 구성부터 시작하기

    처음부터 벡터 DB(Vector Database, 벡터 저장소)까지 크게 벌이지 말고, 최소한의 로컬 흐름으로 시작하는 걸 추천드립니다. 이유는 간단합니다. 실패 지점을 줄여야 하거든요.

    1. 문서를 읽는다.
    2. 인덱스를 만든다.
    3. 리트리버와 쿼리 엔진을 분리해서 테스트한다.
    4. 결과가 괜찮으면 그다음에 영속화와 외부 저장소를 붙인다.

    1. 설치와 기본 실행

    python -m venv .venv
    source .venv/bin/activate
    pip install llama-index
    

    여기서는 버전 핀을 일부러 박지 않았습니다. 글의 목적이 특정 릴리스 사용기가 아니라, 디버깅 흐름 자체에 있기 때문입니다.

    2. 가장 단순한 인덱스 생성

    from llama_index.core import SimpleDirectoryReader, VectorStoreIndex
    
    # data/ 폴더 아래 문서를 읽습니다.
    documents = SimpleDirectoryReader("data").load_data()
    
    # 가장 단순한 형태의 인덱스를 만듭니다.
    index = VectorStoreIndex.from_documents(documents)
    
    # 검색과 응답 생성을 분리해서 확인할 수 있도록 둘 다 만듭니다.
    retriever = index.as_retriever()
    query_engine = index.as_query_engine()
    
    question = "장애 대응 절차를 요약해줘"
    retrieved_nodes = retriever.retrieve(question)
    response = query_engine.query(question)
    
    print("[RETRIEVED NODES]")
    for i, node in enumerate(retrieved_nodes, start=1):
        print(f"--- node {i} ---")
        print(node.text[:300])
    
    print("[FINAL RESPONSE]")
    print(response)
    

    이 코드에서 핵심은 retriever와 query_engine을 따로 본다는 점입니다. 처음엔 이게 뭔가 싶었는데, 실제로 써보니까 이 분리가 디버깅 시간을 확 줄여주더라고요.

    3. 청킹을 직접 통제하는 적재 파이프라인

    from llama_index.core import Document
    from llama_index.core.ingestion import IngestionPipeline
    from llama_index.core.node_parser import SentenceSplitter
    from llama_index.core.extractors import TitleExtractor
    
    sample_docs = [
        Document(text="장애 조치 문서 예시입니다. 원인 분석, 임시 조치, 영구 조치가 포함됩니다."),
    ]
    
    pipeline = IngestionPipeline(
        transformations=[
            SentenceSplitter(chunk_size=256, chunk_overlap=32),
            TitleExtractor(),
        ]
    )
    
    nodes = pipeline.run(documents=sample_docs)
    
    for i, node in enumerate(nodes, start=1):
        print(f"NODE {i}")
        print(node.text)
        print(node.metadata)
    

    청킹은 진짜 중요합니다. 저는 처음에 chunk_size를 너무 작게 잡아서 문서 문맥이 다 잘려 나갔었는데, 검색 결과는 그럴듯하게 보여도 실제 답변은 자꾸 뜬구름 잡더라고요.

    LlamaIndex RAG 문서 청킹과 리트리버 동작을 설명하는 이미지

    문서가 여러 조각으로 분할되고 질문에 따라 관련 노드가 선택되는 구조를 설명하는 이미지입니다.

    4. 캐시와 저장 경로를 명시하기

    from llama_index.core import StorageContext, load_index_from_storage
    
    # 인덱스를 저장합니다.
    index.storage_context.persist(persist_dir="./storage")
    
    # 저장된 인덱스를 다시 로드합니다.
    storage_context = StorageContext.from_defaults(persist_dir="./storage")
    loaded_index = load_index_from_storage(storage_context)
    
    loaded_query_engine = loaded_index.as_query_engine()
    print(loaded_query_engine.query("장애 대응 절차를 요약해줘"))
    

    여기서 많이 터집니다. LlamaIndex는 기본적으로 인메모리(in-memory, 메모리 상주) 상태를 많이 쓰기 때문에, 재시작 후에도 같은 동작을 기대한다면 저장과 로딩 경로를 명확히 관리해야 합니다.

    ⚠️ 흔한 LlamaIndex 오류와 RAG 디버깅 전략

    이제부터는 제가 실제로 자주 밟았던 실패 패턴입니다. 증상만 보면 비슷한데 원인은 꽤 다릅니다.

    문제 1. 문서는 읽었는데 답변이 너무 일반적입니다

    이 경우 많은 분이 모델 성능부터 의심하시는데요, 사실은 검색 단계에서 충분한 근거가 안 들어간 경우가 많습니다.

    • 문서가 너무 잘게 쪼개져 핵심 문맥이 끊겼는지 봅니다.
    • 질문과 문서 표현이 다르면 검색 품질이 확 떨어집니다.
    • 리트리버가 뽑은 노드 본문을 직접 읽어 봅니다.

    제가 직접 해보니, 최종 답변보다 retrieved_nodes 출력을 먼저 보는 습관이 정말 중요했습니다. 답이 이상하면 먼저 “뭘 찾았는가”를 봐야 합니다.

    문제 2. 재색인했는데 결과가 안 바뀝니다

    이건 캐시나 저장 디렉터리 때문에 생기는 경우가 많습니다. 특히 테스트하면서 같은 경로를 계속 재사용하면 오래된 데이터가 남아 있을 수 있습니다.

    rm -rf ./storage
    rm -rf ./pipeline_storage
    

    물론 운영 환경에서는 이렇게 단순 삭제하면 안 됩니다. 다만 로컬 검증 단계에서는 “정말 새로 인덱싱된 게 맞나?”를 확인하는 용도로 한 번쯤 초기화가 필요하더라고요.

    문제 3. 검색은 맞는데 최종 답변이 엉뚱합니다

    이건 응답 합성 단계 문제일 가능성이 높습니다. 쉽게 말해 모델이 가져온 컨텍스트를 잘 못 쓰는 거죠.

    • 너무 많은 컨텍스트를 넣어 핵심이 묻히지 않았는지 봅니다.
    • 프롬프트에서 근거 기반 답변을 강하게 요구하는지 봅니다.
    • 답변과 함께 source nodes를 출력해 비교합니다.

    근데 여기서 중요한 포인트가 하나 있습니다. 검색 품질이 80인데 생성 품질이 20이면 프롬프트 손봐야 하고, 검색 품질이 20인데 생성만 만지면 계속 헛바퀴 돕니다.

    문제 4. AI 에이전트 실패처럼 보이는데 사실 RAG 실패입니다

    도구 호출(Tool Calling, 외부 기능 호출)이나 에이전트 라우팅이 문제인 줄 알았는데, 막상 까보면 검색된 문맥이 비어 있는 경우가 있습니다. 저도 처음엔 에이전트 흐름도를 한참 봤었는데요, 결국 원인은 리트리버였습니다. 그래서 저는 에이전트를 붙이기 전에 항상 아래 순서로 검증합니다.

    1. retriever.retrieve() 결과를 먼저 확인
    2. query_engine.query() 결과와 비교
    3. 그 다음에만 agent/tool 레이어 확인

    문제 5. 운영 환경에서만 이상합니다

    개발 환경에서는 한글 문서가 잘 검색됐는데 운영에서만 품질이 달라지는 경우도 있었습니다. 이런 건 대개 데이터셋 차이, 적재 타이밍 차이, 저장소 경로 차이, 혹은 문서 전처리 차이로 이어집니다. 이럴 때는 “운영 모델이 다르다” 같은 큰 가설보다, 실제로 어떤 문서가 들어갔는지를 먼저 비교하는 게 낫습니다.

    검증 방법: 정답률보다 먼저 파이프라인을 눈으로 확인하세요

    저는 RAG를 검증할 때 처음부터 화려한 평가 지표를 붙이지 않습니다. 물론 평가(Evaluation, 성능 측정)는 중요하지만, 초기에는 육안 검증이 훨씬 빠릅니다.

    1. 질문 10개를 만든다.
    2. 각 질문마다 검색된 노드 상위 결과를 저장한다.
    3. 최종 답변과 근거 문장을 같이 본다.
    4. 틀린 답변은 검색 실패인지 생성 실패인지 분류한다.
    test_questions = [
        "장애 보고 절차는 어떻게 되나요?",
        "임시 조치와 영구 조치의 차이는 무엇인가요?",
        "점검 창구는 어디인가요?",
    ]
    
    for question in test_questions:
        nodes = retriever.retrieve(question)
        answer = query_engine.query(question)
    
        print("=" * 40)
        print("Q:", question)
        print("[TOP NODES]")
        for node in nodes[:3]:
            print(node.text[:200])
        print("[ANSWER]")
        print(answer)
    

    실제로 써보니까, 이 정도만 해도 어디가 문제인지 금방 보입니다. 드디어 됐다! 싶은 순간도 보통 여기서 오더라고요.

    LlamaIndex RAG 검증 과정에서 검색 노드와 답변을 비교하는 대시보드 이미지

    질문, 검색된 문서 조각, 최종 응답을 나란히 놓고 비교하는 검증 화면 예시입니다.

    실패를 줄이는 운영 체크리스트

    LlamaIndex RAG를 조금 오래 운영하다 보면, 결국 반복 확인 항목이 정해집니다. 저는 아래 체크리스트를 배포 전 마지막 관문처럼 씁니다.

    • 문서 수와 예상 파일 수가 맞는가
    • 청크 샘플을 3개 이상 직접 읽어 봤는가
    • 검색 결과 상위 노드가 질문 의도와 맞는가
    • 재시작 후에도 같은 인덱스를 로드하는가
    • 캐시와 저장 디렉터리 충돌이 없는가
    • 에이전트 문제로 보기 전에 검색 결과를 확인했는가
    실패 유형 대응 우선순위 빠른 처방
    답변이 너무 일반적 높음 청킹과 검색 결과부터 확인
    재색인 후 결과 동일 높음 persist 경로와 캐시 정리 확인
    운영에서만 품질 저하 중간 실제 적재 문서와 경로 비교
    AI 에이전트 실패처럼 보임 높음 agent 이전에 retriever 단독 테스트

    자주 묻는 질문: RAG 시스템 문제를 어디서부터 봐야 하나요?

    Q1. LlamaIndex 오류가 나지 않아도 시스템이 틀릴 수 있나요?

    네, 그게 더 흔합니다. 에러 없이도 잘못된 문맥을 검색하면 결과는 충분히 틀릴 수 있습니다. 그래서 RAG 디버깅은 예외 메시지보다 중간 산출물 확인이 더 중요합니다.

    Q2. 청킹만 잘하면 해결되나요?

    아닙니다. 청킹은 출발점일 뿐이고, 메타데이터, 저장 경로, 검색기 설정, 응답 합성까지 같이 봐야 합니다.

    Q3. AI 에이전트 실패와 RAG 실패는 어떻게 구분하나요?

    에이전트를 떼고 retriever와 query_engine을 각각 테스트해 보시면 됩니다. 에이전트를 제거했는데도 답이 틀리면 대개 RAG 쪽입니다.

    마무리: 화려한 튜닝보다 관측 가능한 구조가 먼저입니다

    이번 글에서 말씀드리고 싶었던 건 딱 하나입니다. LlamaIndex RAG는 잘 만들면 강력하지만, 실패했을 때는 “어디서 틀어졌는지 보이게” 설계해야 한다는 점입니다. 저도 처음엔 모델만 계속 바꿔 봤었는데, 결국 해결은 대부분 로그, 노드 출력, 저장 경로 확인에서 나왔습니다. 사실 이런 건 멋이 없거든요. 근데 운영에서는 이런 기본기가 제일 셉니다.

    다음 글에서는 검색 품질이 낮을 때 메타데이터 필터링과 질문 정규화 전략을 어떻게 붙이는지 다뤄볼 예정입니다. 이전 글 참고 형식으로 이어서 보시면 흐름 잡기 편하실 겁니다.

    LlamaIndex RAG 디버깅 체크리스트와 실패 유형 요약 이미지

    실패 유형별 점검 순서와 대응 우선순위를 한 장으로 정리한 요약 이미지입니다.

    참고한 공식 문서