목차
- Sentry 비용 최적화가 중요한 이유
- Sentry에서 비용에 직접 영향을 주는 요소
- Sentry 사용 후기: 1년 써보니 드러난 예상치 못한 비용
- Sentry 비용 최적화를 위한 기본 원칙
- 실전 구현: 제가 적용한 Sentry 효율 개선 단계
- 1. 환경별 수집 정책 분리
- 2. 애플리케이션 레벨에서 불필요한 예외 제외
- 3. 샘플링으로 이벤트 볼륨 제어
- 4. 알림 정책 다시 설계
- 5. 소스맵과 릴리스 정리
- ⚠️ 트러블슈팅: 실제로 겪었던 문제와 해결법
- 검증과 결과: Sentry 효율이 좋아졌는지 어떻게 확인했나
- 운영 체크리스트: Sentry 비용 최적화할 때 꼭 보는 것
- 자주 묻는 질문
- Sentry 비용 최적화는 결국 샘플링만 하면 되나요?
- Sentry 사용 후기에서 가장 체감 큰 개선은 무엇이었나요?
- 에러 모니터링 비용을 줄이면 장애 대응력이 떨어지지 않나요?
- 마무리: Sentry 효율은 도구 설정이 아니라 운영 습관에서 결정됩니다
[인프라] Sentry 비용 최적화, 1년 운영 회고로 정리한 현실 전략
Sentry 비용 최적화 이야기는 막상 운영을 시작하고 나서야 절실해지더라고요. 처음엔 에러 모니터링만 잘 되면 된다고 생각했는데, 실제로 1년 정도 굴려보니 비용 구조와 운영 습관이 생각보다 강하게 연결돼 있었습니다. 저도 처음엔 “에러를 잘 모으는 게 무조건 좋은 거 아닌가?” 싶었는데요. 실제로 써보니까 많이 모으는 것보다 의미 있게 남기는 것이 훨씬 중요했습니다. 이번 글에서는 제가 겪은 Sentry 사용 후기와 함께, 예상치 못한 비용 포인트, 클라우드 비용 관리 관점에서의 판단 기준, 그리고 에러 모니터링 비용을 줄이면서도 운영 효율을 유지한 방법을 정리해보겠습니다.
특히 팀에서 이미 Sentry를 쓰고 있는데 월말마다 이벤트가 급증하거나, 알림이 너무 많아서 정작 중요한 장애를 놓치고 있다면 이 글이 꽤 도움이 될 겁니다. 혹시 이런 경험 있으신가요? 대시보드는 꽉 차 있는데, 남는 건 피로감뿐인 상황이요. 저도 딱 그랬습니다 ㅎㅎ
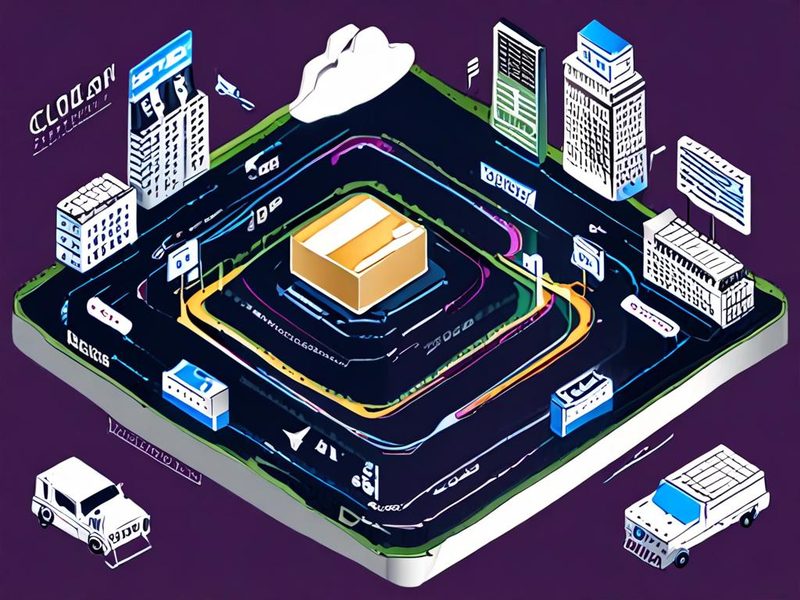
Sentry 비용 최적화 관점에서 보면, 애플리케이션에서 발생한 이벤트가 SDK, 릴레이, 프로젝트, 알림, 대시보드로 이어지는 흐름 전체를 한 번에 보는 게 중요합니다.
Sentry 비용 최적화가 중요한 이유
쉽게 말해 Sentry는 문제를 빨리 찾게 해주는 도구입니다. 그런데 운영이 길어질수록 “문제를 빨리 찾는 비용”도 같이 봐야 하거든요. 에러 모니터링 비용은 단순히 청구서 숫자만의 문제가 아닙니다. 너무 많은 이벤트는 분석 시간을 늘리고, 너무 많은 알림은 팀의 집중력을 깎습니다. 그래서 비용 최적화는 돈 절약이 아니라 운영 신호 대 잡음비를 올리는 작업에 가깝습니다.
제가 1년 동안 운영하면서 가장 크게 느낀 점은 이거였어요. 비용이 늘어나는 순간은 장애가 커질 때보다, 쓸데없는 이벤트가 조용히 쌓일 때가 더 많았습니다. 배포 직후 반복되는 프런트엔드 에러, 이미 알고 있는 봇 요청, 의미 없는 health check 실패 로그, 중복 알림. 이런 것들이 눈에 안 띄게 쌓이다가 어느 순간 “왜 이렇게 많이 쓰고 있지?”가 되더라고요.
Sentry에서 비용에 직접 영향을 주는 요소
- 이벤트 볼륨: 동일 원인의 반복 에러도 건수는 그대로 쌓입니다.
- 환경 분리: production, staging, dev를 무분별하게 넣으면 분석 난이도와 노이즈가 같이 증가합니다.
- 릴리스 태깅: 배포 단위 구분이 안 되면 원인 파악 시간이 길어집니다.
- 알림 정책: 중요하지 않은 이벤트까지 모두 알리면 대응 체계가 무너집니다.
- 샘플링: 전부 수집하는 습관은 초반엔 편하지만, 장기 운영에서는 비효율로 돌아오는 경우가 많습니다.
Sentry 사용 후기: 1년 써보니 드러난 예상치 못한 비용
제가 처음 놓쳤던 부분은 “에러 건수”와 “운영 가치”가 비례하지 않는다는 점이었습니다. 처음엔 많이 잡히면 좋은 줄 알았거든요. 근데 여기서 문제가 생깁니다. 예를 들어 이미 원인을 알고 있고 우선순위가 낮은 에러가 계속 들어오면, 그건 모니터링 강화가 아니라 비용과 피로도만 늘리는 요소가 돼버립니다.
실제로 써보니까 예상치 못한 비용 포인트는 대체로 아래 네 가지였어요.
- 배포 직후 반복 에러: 특정 버전에서 같은 오류가 급증하면 이벤트가 짧은 시간에 몰립니다.
- 봇/크롤러 유입: 정상 사용자가 아닌 요청에서 발생한 예외도 그대로 쌓이더라고요.
- 개발/테스트 환경 혼입: staging이나 로컬 테스트 이벤트가 production 분석을 방해했습니다.
- 소유자 없는 알림: 누구도 처리하지 않는 알림이 계속 발행되면 시스템만 시끄러워집니다.
여기서 중요한 포인트! Sentry 효율은 결국 “무엇을 버릴지 결정하는 능력”에서 많이 갈립니다. 모든 걸 저장하는 게 정답은 아니었어요.
Sentry 비용 최적화를 위한 기본 원칙
저는 중간에 운영 원칙을 아예 다시 세웠습니다. 기준이 생기니까 그다음부터는 훨씬 편하더라고요.
| 항목 | 처음 운영할 때 실수 | 지금 적용하는 기준 |
|---|---|---|
| 이벤트 수집 | 전부 수집 | 중요도 기준으로 샘플링 |
| 환경 구분 | production/staging/dev 혼합 | production 중심, 나머지는 제한 수집 |
| 알림 | 모든 에러 알림 | 사용자 영향 큰 이슈만 즉시 알림 |
| 태그 관리 | 태그 난립 | 서비스, 릴리스, 환경, 고객군 중심 최소화 |
| 리뷰 주기 | 문제 생길 때만 확인 | 주간 리뷰로 노이즈 제거 |
쉽게 말해 기준은 단순합니다. 장애 대응에 도움 되는 데이터는 남기고, 나머지는 과감히 줄인다. 이 원칙 하나로 Sentry 비용 최적화 방향이 꽤 명확해졌습니다.
실전 구현: 제가 적용한 Sentry 효율 개선 단계
이제부터는 실제로 어떻게 손봤는지 정리해보겠습니다. 팀마다 스택은 다르겠지만, 접근 방식은 꽤 공통적입니다.
1. 환경별 수집 정책 분리
가장 먼저 한 일은 production과 staging을 완전히 다르게 다루는 것이었습니다. 운영 환경은 놓치면 안 되니까 보수적으로 가져가고, 테스트 환경은 필요한 범위만 남겼습니다.
export SENTRY_ENVIRONMENT=production
export SENTRY_RELEASE=webapp-2026-08-13
export SENTRY_TRACES_SAMPLE_RATE=0.2
이 정도만 해도 기준이 생깁니다. 릴리스와 환경을 분리해두면, 나중에 어떤 배포에서 에러가 급증했는지 확인하기 훨씬 쉬워집니다.
2. 애플리케이션 레벨에서 불필요한 예외 제외
여기서 삽질을 좀 했습니다. 처음엔 서버에서 발생한 예외를 거의 다 보내도록 해놨었는데요. 실제로 운영하면서 보니 이미 알고 있는 사용자 취소, 봇 요청, 연결 종료 같은 케이스까지 다 들어오고 있더라고요. 이건 운영 정보가 아니라 노이즈에 가깝습니다.
import sentry_sdk

IGNORED_EXCEPTIONS = {
    "ClientDisconnected",
    "HealthcheckTimeout",
    "BotRequestError",
}

def before_send(event, hint):
    exc_info = hint.get("exc_info")
    if exc_info:
        exc_type = exc_info[0]
        if exc_type and exc_type.__name__ in IGNORED_EXCEPTIONS:
            return None

    request = event.get("request", {})
    headers = request.get("headers", {})
    user_agent = str(headers.get("User-Agent", "")).lower()
    if "bot" in user_agent or "crawler" in user_agent:
        return None

    return event

sentry_sdk.init(
    dsn="YOUR_DSN",
    environment="production",
    release="webapp-2026-08-13",
    before_send=before_send,
)
이런 식으로 before_send 단계에서 걸러주면 꽤 효과가 있습니다. 물론 너무 공격적으로 제외하면 진짜 문제를 놓칠 수 있으니, 처음에는 로그를 같이 보면서 한두 주 정도 검증하는 게 좋습니다.
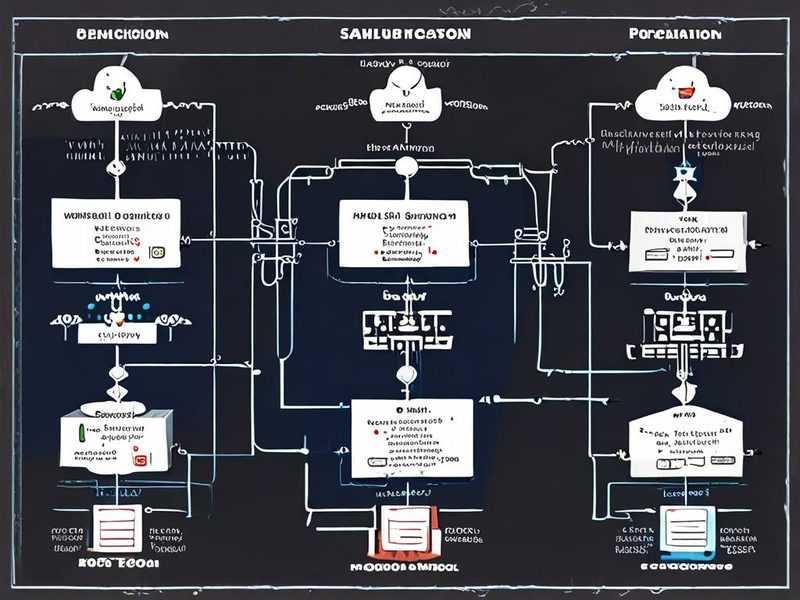
프로덕션과 스테이징 분리, 봇 요청 제외, 예외 필터링을 하나의 흐름으로 시각화한 이미지가 있으면 팀 내 공유가 훨씬 쉬워집니다.
3. 샘플링으로 이벤트 볼륨 제어
샘플링은 처음엔 좀 불안했습니다. “혹시 중요한 걸 놓치면 어떡하지?” 하는 생각이 들거든요. 저도 그랬어요. 근데 실제로는 전부 수집해서 못 보는 것보다 중요한 걸 선별해서 제대로 보는 것이 훨씬 낫더라고요.
sentry_sdk.init(
    dsn="YOUR_DSN",
    environment="production",
    release="webapp-2026-08-13",
    traces_sample_rate=0.2,
)
트래픽이 많은 서비스라면 일괄 비율 샘플링보다, 특정 엔드포인트나 특정 고객군만 더 촘촘히 보는 방식도 고려할 만합니다. 다만 여기서는 수치보다 원칙이 중요해요. 사용자 영향이 큰 경로는 더 자세히, 반복적이고 가치가 낮은 구간은 더 가볍게 가져가시면 됩니다.
4. 알림 정책 다시 설계
제가 체감상 가장 크게 개선된 부분은 알림 정책이었습니다. 에러가 생길 때마다 메신저로 다 쏘면 처음엔 든든해 보이는데요. 한 달만 지나면 아무도 안 봅니다. 이건 진짜입니다. 알림은 많을수록 안전한 게 아니라, 신뢰도가 높을수록 안전하더라고요.
- 새로운 이슈 중 production만 즉시 알림
- 같은 에러라도 일정 시간 내 반복 급증 시 우선 알림
- 이미 확인된 낮은 우선순위 이슈는 일일 요약으로 전환
- 담당 서비스 태그가 없는 이벤트는 우선 분류 작업부터 수행
이렇게 바꾸고 나서부터는 Sentry 사용 후기가 팀 내에서도 확실히 좋아졌습니다. “시끄러운 도구”에서 “필요할 때 믿고 보는 도구”로 바뀐 느낌이었거든요.
5. 소스맵과 릴리스 정리
프런트엔드 운영하시는 분들은 이거 꼭 챙기셔야 합니다. 소스맵이 꼬이면 에러는 들어오는데 분석 시간이 확 늘어납니다. 비용 문제는 단지 이벤트 수만이 아니라, 사람의 조사 시간에서도 생기거든요.
export SENTRY_RELEASE=webapp-2026-08-13
sentry-cli releases new "$SENTRY_RELEASE"
sentry-cli releases finalize "$SENTRY_RELEASE"
릴리스 정리가 잘 되면 배포 이후 특정 에러가 어느 버전부터 발생했는지 빠르게 추적할 수 있어요. 이건 직접 해보니 진짜 편하더라고요.
⚠️ 트러블슈팅: 실제로 겪었던 문제와 해결법
운영하면서 제일 많이 부딪힌 건 “줄였더니 놓치는 것 아닐까”에 대한 불안이었습니다. 그래서 저는 한 번에 확 줄이지 않고, 단계적으로 조정했습니다.
- 문제: 필터를 너무 넓게 잡아 중요한 이벤트가 빠질까 걱정됨
해결: 먼저 로그와 함께 병행 관찰하고, 제외 규칙은 소규모부터 적용했습니다. - 문제: staging 이벤트가 production 분석을 방해함
해결: 환경 태그를 강제하고, production 외 환경은 수집량을 제한했습니다. - 문제: 봇 요청이 에러를 과도하게 만듦
해결: User-Agent 기반 1차 필터링과 라우트 단위 예외 처리를 병행했습니다. - 문제: 알림이 너무 많아 아무도 보지 않음
해결: 긴급 알림, 일일 요약, 리뷰 대상 이슈를 분리했습니다.
특히 봇 요청은 진짜 골칫거리였습니다. 처음엔 애플리케이션 문제인 줄 알고 한참 들여다봤는데, 알고 보니 이상한 경로를 두드리는 외부 요청이더라고요. 그때 깨달았어요. 모든 에러가 제품 문제는 아니다. 운영에서는 이 구분이 정말 중요합니다.
검증과 결과: Sentry 효율이 좋아졌는지 어떻게 확인했나
최적화는 느낌으로 하면 안 됩니다. 저는 아래 네 가지를 기준으로 봤어요.
- 주간 신규 이슈 수가 줄었는가
- 반복성 높은 동일 에러 비중이 줄었는가
- 알림 확인 후 실제 대응으로 이어지는 비율이 높아졌는가
- 배포 후 원인 파악 시간이 짧아졌는가
정확한 수치를 여기서 단정적으로 적진 않겠습니다. 서비스마다 너무 다르더라고요. 다만 제가 직접 해보니, 이벤트 총량이 줄어든 것보다 분석 시간이 줄어든 효과가 더 크게 체감됐습니다. 월말 비용 체감도 덜했고, 무엇보다 팀이 대시보드를 다시 신뢰하기 시작했어요. 이건 숫자 이상으로 중요하더라고요.
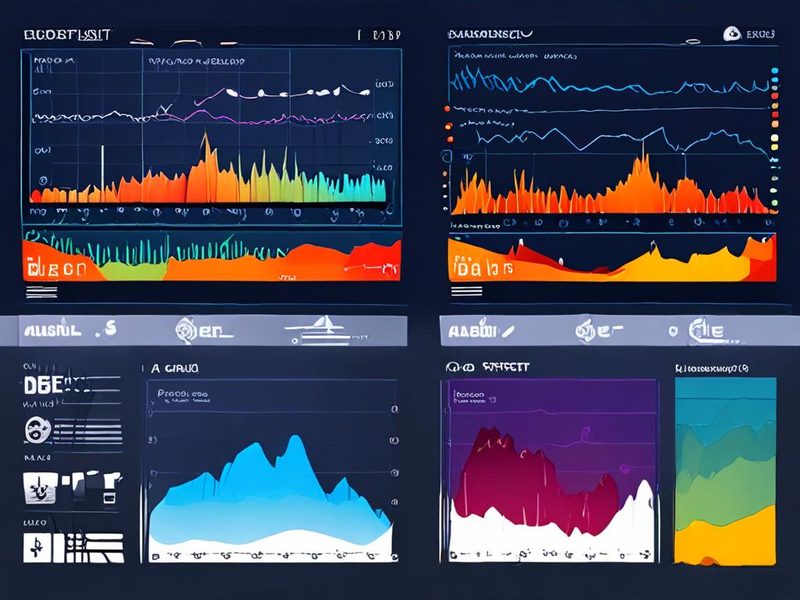
최적화 전후 지표를 대시보드로 비교하면 Sentry 효율 개선이 비용 절감뿐 아니라 대응 속도 향상으로 이어졌는지 한눈에 확인할 수 있습니다.
| 검증 항목 | 최적화 전 상태 | 최적화 후 기대 상태 |
|---|---|---|
| 이벤트 품질 | 중복/잡음 많음 | 핵심 이슈 중심 |
| 알림 신뢰도 | 무시되는 알림 많음 | 실제 대응 비율 상승 |
| 원인 분석 속도 | 버전 추적 어려움 | 릴리스 기준 추적 가능 |
| 클라우드 비용 관리 | 월말 체감 증가 | 예측 가능성 향상 |
운영 체크리스트: Sentry 비용 최적화할 때 꼭 보는 것
- production 외 환경이 과도하게 들어오지 않는가
- 반복성 높은 저가치 예외를 제외했는가
- 릴리스와 환경 태그가 일관되게 붙는가
- 알림 정책이 실제 대응 체계와 맞는가
- 주간 단위로 노이즈 이벤트를 리뷰하는가
이 체크리스트만 꾸준히 돌려도 에러 모니터링 비용은 꽤 안정됩니다. 그리고 클라우드 비용 관리 관점에서도 “나중에 한꺼번에 정리”보다 “조금씩 자주 정리”가 훨씬 덜 힘듭니다.
자주 묻는 질문
Sentry 비용 최적화는 결국 샘플링만 하면 되나요?
아닙니다. 샘플링은 한 축일 뿐입니다. 환경 분리, 예외 제외, 릴리스 정리, 알림 정책 재설계가 같이 가야 효과가 나요.
Sentry 사용 후기에서 가장 체감 큰 개선은 무엇이었나요?
저는 알림 정책 재설계가 가장 컸습니다. 이벤트 수가 조금 줄어드는 것보다, 정말 중요한 알림만 보이게 만든 효과가 훨씬 크더라고요.
에러 모니터링 비용을 줄이면 장애 대응력이 떨어지지 않나요?
무조건 줄이면 그럴 수 있습니다. 그래서 핵심은 삭제가 아니라 선별입니다. 사용자 영향이 큰 이벤트는 더 잘 보고, 가치가 낮은 반복 이벤트는 과감히 줄이는 쪽이 맞아요.
운영 원칙, 검증 지표, 알림 설계 기준을 한 장으로 정리한 요약 이미지는 팀 온보딩 자료로도 꽤 유용합니다.
마무리: Sentry 효율은 도구 설정이 아니라 운영 습관에서 결정됩니다
1년 정도 운영해보니 결론은 분명했어요. Sentry 비용 최적화는 옵션 몇 개 바꾼다고 끝나는 일이 아니었습니다. 이벤트를 어떻게 정의할지, 어떤 알림만 살아남게 할지, 어떤 데이터가 실제로 팀에 도움이 되는지 계속 다듬는 과정이더라고요.
저도 처음엔 “많이 수집하면 안전하다”고 생각했었는데, 실제로 써보니까 잘 버리는 팀이 결국 더 빨리 대응했습니다. 이거 꽤 역설적이죠. 하지만 운영은 원래 그렇더라고요. 많이 쌓는 것보다, 필요한 걸 바로 찾는 게 더 중요합니다.
다음 글에서는 이번 내용과 이어서 Sentry 알림 정책 설계를 조금 더 깊게 다뤄볼 예정입니다. 어떤 이슈를 즉시 알림으로 보내고, 어떤 건 요약으로 돌릴지 기준을 잡는 방법이요. 이전 글에서 다룬 로그 집계와 메트릭 분리 전략도 함께 보시면 전체 운영 그림을 잡는 데 도움이 될 겁니다.
혹시 지금 Sentry를 쓰고 있는데 비용은 늘고 효율은 애매하다고 느끼신다면, 오늘 바로 해볼 수 있는 건 하나입니다. 최근 7일 이슈 중 반복 건수만 많고 조치 가치가 낮은 이벤트를 골라 제외 후보 목록부터 만들어보세요. 여기서부터 진짜 최적화가 시작됩니다. 드디어 감이 잡히실 겁니다 🎉