13년차의 서버실

서버, 인프라, 홈랩 기술 블로그

[작성자:] admin

  • [Cloud] FinOps 클라우드 비용 관리 베스트 프랙티스 체크리스트 10가지

    [Cloud] FinOps 클라우드 비용 관리 베스트 프랙티스 체크리스트 10가지

    [Cloud] FinOps 클라우드 비용 관리 베스트 프랙티스 체크리스트 10가지

    FinOps 클라우드 비용 최적화 이야기를 하면 아직도 많은 팀이 “일단 쓰고 나중에 정산하자” 모드로 들어가더라고요. 저도 처음엔 그랬습니다. 서비스는 잘 돌아가는데 월말 청구서를 보면 식은땀이 나는 거죠. 특히 멀티 클라우드나 Kubernetes(쿠버네티스, 컨테이너 오케스트레이션) 환경까지 섞이면 누가 왜 돈을 쓰는지 한눈에 안 보입니다. 그래서 오늘은 제가 홈랩과 실무에서 계속 다듬어 온 클라우드 비용 관리 기준을 체크리스트 형태로 정리해보겠습니다. 운영팀, 플랫폼팀, 개발팀이 같이 볼 수 있게 최대한 실전형으로 풀어볼게요.

    이 글은 거창한 이론보다 바로 적용 가능한 FinOps 전략에 집중했습니다. 쉽게 말해, 비용을 줄이는 것만이 아니라 비용 거버넌스를 만들어서 팀이 반복적으로 같은 실수를 하지 않게 만드는 방법이죠. 혹시 청구서가 예측보다 자꾸 커지거나, Reserved Instances(예약 인스턴스)나 Savings Plans(절감 약정) 같은 약정형 할인은 들어봤는데 어디서부터 손대야 할지 막막하셨다면 딱 이 순서대로 보시면 됩니다.
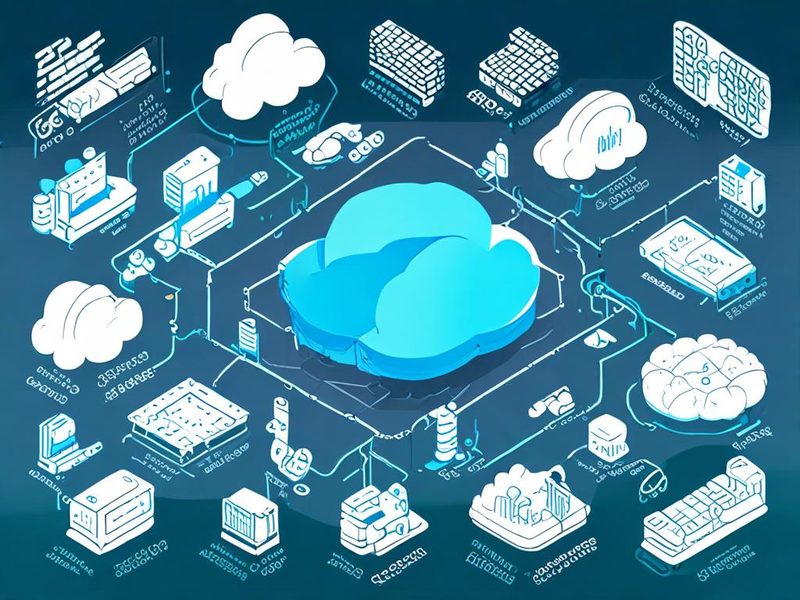
    FinOps 클라우드 비용 최적화 전체 운영 흐름 다이어그램

    비용 데이터 수집, 태깅, 예산, 알림, 최적화, 리뷰까지 이어지는 FinOps 운영 흐름을 한눈에 보여주는 이미지입니다.

    FinOps를 쉽게 말하면 무엇인가

    FinOps(Financial Operations, 재무 중심 클라우드 운영)는 클라우드 사용량과 비용을 기술팀이 직접 이해하고, 재무팀과 함께 최적화하는 운영 방식이에요. 쉽게 말해 “누가 얼마나 쓰는지 보이게 만들고, 그걸 근거로 빠르게 행동하는 문화”에 가까워요. 여기서 중요한 건 단순 절감이 아니라는 거죠. 돈을 덜 쓰는 게 아니라, 필요한 곳에는 제대로 쓰고 낭비는 줄이는 것이 진짜 핵심이거든요.

    제가 직접 해보니 FinOps는 툴 하나 깔면 끝나는 일이 아니었어요. Cost Explorer(비용 탐색), Budgets(예산), 태그 정책, 대시보드, 리뷰 회의까지 다 이어져야 효과가 나더라고요. 처음엔 이게 뭔가 싶었는데, 한 번 체계가 잡히면 “이번 달 왜 20% 늘었지?”를 감으로 추측하지 않아도 돼요. 이거 진짜 편합니다.

    FinOps 클라우드 비용 최적화 체크리스트 10가지

    아래 10가지는 제가 실제로 우선순위를 두는 항목들이에요. 한 번에 다 하려고 하면 지칩니다. 그래서 가시성 확보 → 거버넌스 정착 → 구매 최적화 → 지속 점검 순서로 가는 걸 추천드려요.

    체크 항목 핵심 질문 우선순위
    1. 태그 표준화 누가 어떤 비용을 쓰는지 구분 가능한가? 매우 높음
    2. 계정/프로젝트 분리 환경별 비용이 섞이지 않는가? 매우 높음
    3. 예산과 알림 월말 전에 이상 징후를 잡는가? 매우 높음
    4. 유휴 자원 정리 안 쓰는 리소스가 계속 과금되는가? 높음
    5. 권한/사이즈 적정화 과한 스펙을 기본값처럼 쓰고 있지 않은가? 높음
    6. 약정형 할인 검토 상시 부하는 할인 구매 대상으로 관리하는가? 높음
    7. 스토리지 수명주기 오래된 데이터 보관 정책이 있는가? 중간
    8. Kubernetes 비용 배분 네임스페이스 단위 비용 추적이 되는가? 중간
    9. 대시보드와 리뷰 루틴 숫자를 정기적으로 함께 보는가? 매우 높음
    10. 자동화된 정책 집행 규칙 위반을 자동으로 막는가? 높음

    1. 태그(Tag, 리소스 분류용 메타데이터) 표준을 먼저 만드세요

    비용 최적화의 시작은 거의 항상 태그였어요. 태그가 없으면 비용 배분이 안 되고, 비용 배분이 안 되면 책임 소재도 흐려지죠. 최소한 owner, service, environment, cost-center 정도는 강제하는 편이 좋아요. 저도 예전엔 태그를 권장만 했었는데, 결과는 뻔했습니다. 아무도 안 넣어요 ㅎㅎ 그래서 지금은 생성 단계에서 빠지면 경고가 뜨거나 배포 파이프라인에서 막히게 해둬요.

    2. 계정(Account, 클라우드 계정)과 프로젝트를 용도별로 분리하세요

    개발, 스테이징, 운영을 한 계정에 다 넣어두면 비용이 섞여서 해석이 어려워져요. 특히 운영 이슈 대응 중 임시 리소스를 만들었다가 그대로 남아버리는 경우가 많거든요. 환경 분리는 보안에도 좋고, 클라우드 비용 관리에도 바로 도움이 돼요. 청구서를 볼 때 “이 증가는 운영 때문인가, 테스트 때문인가”가 바로 보여야 합니다.

    3. 예산(Budget, 목표 지출 한도)과 알림을 월초에 설정하세요

    월말에 놀라는 구조를 끊어야 해요. 예산은 금액 기준만 보지 말고, 예측 비용(forecast)과 전월 대비 증가율도 같이 보면 좋아요. 제 경험상 50%, 80%, 100% 세 구간 알림이 실무에서 제일 쓸 만했습니다.

    4. 유휴 자원(Idle Resource) 정리를 정기 작업으로 돌리세요

    안 붙은 EBS 볼륨, 멈춘 줄 알았는데 스냅샷이 계속 쌓이는 디스크, 더 이상 안 쓰는 로드밸런서, 오래된 퍼블릭 IP 같은 것들이 생각보다 커요. 한 건은 작아 보여도 쌓이면 월 비용을 계속 갉아먹어요. 제가 홈랩에서 제일 많이 삽질한 것도 이 부분이었어요. “이 정도야 얼마 안 하겠지” 했는데, 그런 게 제일 무섭더라고요.

    5. Right-sizing(라이트사이징, 적정 사양 조정)을 습관으로 만드세요

    CPU와 메모리를 넉넉하게 주는 건 마음은 편하지만 비용은 절대 안 편해요. 실제 사용량 기반으로 인스턴스 타입과 데이터베이스 스펙을 줄이는 게 중요합니다. 여기서 중요한 포인트! 평균값만 보지 말고 피크 시간대와 주간 패턴도 같이 봐야 해요. 평균 10% 사용률만 보고 줄였다가 월요일 오전에 장애 나는 경우, 생각보다 흔하니까요.

    6. 약정형 할인은 상시 부하에만 적용하세요

    Reserved Instances(예약 인스턴스), Savings Plans(절감 약정) 같은 할인 도구는 강력해요. 다만 변동성이 큰 워크로드에 무턱대고 적용하면 오히려 관리가 꼬여요. 저는 최소 2~3개월 이상 안정적으로 유지되는 상시 부하를 먼저 분류하고, 그중에서 베이스라인 사용량만 할인 대상으로 잡는 편이에요. 공격적으로 사기보다 보수적으로 시작하는 게 덜 아파요.

    7. 스토리지 수명주기(Lifecycle, 데이터 보관 단계)를 정의하세요

    오브젝트 스토리지(Object Storage, 객체 스토리지)는 싸 보이지만, 오래된 로그와 백업이 쌓이면 또 얘기가 달라져요. 접근 빈도에 따라 Standard, Infrequent Access, Archive 계층으로 나누고, 자동 전환 정책을 두면 좋아요. 특히 로그 보존 기간은 법적 요구사항과 운영 현실을 같이 봐야 해요.

    8. Kubernetes 비용은 네임스페이스 단위로 보세요

    Kubernetes 환경에서는 노드 비용만 보면 감이 안 와요. 네임스페이스(namespace), 팀, 서비스 기준으로 비용을 나눠 봐야 누가 비효율적인 요청(requests)과 제한(limits)을 잡고 있는지 드러나거든요. 실제로 써보니까 클러스터 전체 비용만 보는 팀은 최적화가 잘 안 되더라고요. 공용 리소스처럼 느껴져서 책임감이 흐려져요.

    9. 대시보드와 주간 리뷰를 운영 루틴에 넣으세요

    FinOps는 보고서로 끝나면 실패할 확률이 높아요. 비용 대시보드를 만들어도 아무도 안 보면 의미가 없거든요. 그래서 저는 주간 운영 회의에 비용 변화 5분 슬롯을 꼭 넣어요. 전주 대비 급증 서비스, 미태깅 리소스, 예상 초과 예산만 짧게 확인해도 효과가 꽤 커요.

    10. 정책 위반은 자동화로 막으세요

    태그 없는 리소스 생성 금지, 특정 리전(region) 제한, 고가 인스턴스 승인 절차 같은 건 사람이 매번 체크하기 어려워요. Policy as Code(정책의 코드화)나 IaC(코드형 인프라) 파이프라인 검증을 붙이면 비용 거버넌스가 훨씬 안정돼요. 사람이 기억해서 지키는 규칙은 오래 못 가요. 자동화가 진짜 답이에요.

    실전 구현: 바로 적용하는 FinOps 전략

    이제 체크리스트를 실제 운영으로 옮겨보겠습니다. 아래 예시는 AWS 기준 명령을 포함하지만, 구조 자체는 다른 클라우드에도 그대로 응용할 수 있어요. 제가 직접 해보니 처음부터 완벽한 대시보드보다 태그, 예산, 미사용 자원 탐지 세 가지만 먼저 굴리는 게 효과가 가장 빨랐습니다.

    1. 필수 태그 사전 정의: owner, service, environment, cost-center
    2. 주요 계정 또는 프로젝트별 예산 생성: 운영/개발 분리
    3. 일일 비용 수집 자동화: API 또는 비용 리포트 기반
    4. 주간 리뷰 루틴 고정: 증가 원인과 조치 확인
    5. 약정형 할인 검토: 상시 부하만 선별
    # 최근 7일 비용을 서비스 단위로 확인하는 예시
    aws ce get-cost-and-usage \
      --time-period Start=2026-06-23,End=2026-06-30 \
      --granularity DAILY \
      --metrics UnblendedCost \
      --group-by Type=DIMENSION,Key=SERVICE

    위 명령은 가장 단순한 출발점이에요. 서비스 단위 비용 추이를 보고, 급증한 항목이 있으면 거기서 다시 태그나 계정 기준으로 파고드는 식이죠. 처음엔 이 숫자를 어디에 써야 하나 싶었는데, 막상 주간 리포트에 붙여보면 팀 대화가 달라집니다.

    requiredTags:
      - owner
      - service
      - environment
      - cost-center
    rules:
      denyUntaggedResources: true
      blockHighCostInstanceTypes: false
      allowedEnvironments:
        - dev
        - staging
        - prod

    이 YAML은 개념 예시예요. 실제 구현은 Terraform(테라폼, IaC 도구), OPA(Open Policy Agent, 정책 엔진), 클라우드 정책 서비스 등 팀 환경에 맞게 바꾸시면 돼요. 핵심은 “태그는 권장”이 아니라 “태그 없으면 불편하거나 생성 불가” 상태로 만드는 거예요.
    FinOps 클라우드 비용 관리 태그 정책과 예산 알림 설정 이미지

    필수 태그 정책, 예산 임계치, 알림 연결 구조를 함께 보여주는 설정 예시 이미지입니다.

    import csv
    from collections import defaultdict
    
    cost_by_service = defaultdict(float)
    
    with open("cost_report.csv", newline="", encoding="utf-8") as f:
        reader = csv.DictReader(f)
        for row in reader:
            service = row.get("service", "unknown")
            amount = float(row.get("cost", 0) or 0)
            cost_by_service[service] += amount
    
    for service, amount in sorted(cost_by_service.items(), key=lambda x: x[1], reverse=True):
        print(f"{service}: {amount:.2f}")

    비용 리포트 CSV만 있어도 이런 식으로 빠르게 합계를 낼 수 있어요. 고급 BI 도구가 없어도 돼요. 작은 팀일수록 이런 단순 자동화가 오히려 오래 가더라고요.

    Kubernetes와 IaC에서 자주 놓치는 포인트

    Kubernetes에서는 requests/limits를 과하게 잡아놓고 실제 사용률은 낮은 경우가 많아요. HPA(Horizontal Pod Autoscaler, 수평 자동 확장)만 믿고 requests는 크게 유지하면 노드가 비효율적으로 채워지거든요. 여기서 꼭 같이 봐야 하는 게 네임스페이스별 비용, 미사용 PersistentVolume(영구 볼륨), 과도한 로그 적재량이에요.

    # 네임스페이스 라벨과 리소스 현황 확인 예시
    kubectl get ns --show-labels
    kubectl top pod -A
    kubectl get pvc -A

    IaC 관점에서는 기본 태그(default tags)를 모듈 레벨에서 강제하는 게 가장 편했어요. 서비스마다 직접 넣게 하면 결국 빠져요. 이전 글에서 다뤘던 IaC 표준화 내용과도 연결되는데, 이건 다음 글에서 Terraform 모듈 기준으로 더 깊게 다뤄볼 예정이에요.

    ⚠️ 실제로 자주 겪는 문제와 트러블슈팅

    여기서부터는 제가 진짜 많이 부딪힌 부분이에요. 삽질 좀 했습니다 ㅎㅎ 미리 알고 가시면 시간 꽤 아끼실 거예요.

    • 태그는 있는데 비용 배분이 이상한 경우: 생성 이후에 태그를 붙인 리소스는 비용 반영 시점이 늦을 수 있어요. 그래서 태그는 생성 시점 강제가 가장 안전해요.
    • 예산 알림이 너무 많이 오는 경우: 계정 전체 예산만 두면 잡음이 커요. 환경 또는 제품군 기준으로 쪼개야 의미 있는 알림이 돼요.
    • 개발용 리소스가 밤새 계속 켜져 있는 경우: 스케줄 기반 종료 자동화를 붙이는 편이 훨씬 나아요. 사람은 자주 잊거든요.
    • 약정형 할인 적용 후 체감이 없는 경우: 실제 상시 사용량보다 많이 구매했을 수 있어요. 온디맨드 사용 패턴과 베이스라인을 먼저 다시 봐야 합니다.
    • Kubernetes 비용이 팀별로 안 보이는 경우: 네임스페이스, 라벨, 클러스터 공용 비용 배분 기준이 먼저 정리되어야 해요.

    특히 비용 알림은 너무 많이 오면 아무도 안 보게 돼요. 보안 알림이든 비용 알림이든 마찬가지더라고요. 그래서 신호 대 잡음비를 높이는 게 중요해요. 진짜 대응해야 할 것만 오게 만들어야 하거든요.

    검증: 무엇을 보면 잘되고 있다고 판단할까

    FinOps 클라우드 비용 최적화가 잘 굴러가는지는 생각보다 간단한 지표로 확인할 수 있어요. 제가 보는 핵심은 네 가지예요. 첫째, 미태깅 리소스 비율이 줄어드는가. 둘째, 예산 초과를 월말이 아니라 중간에 잡는가. 셋째, 유휴 자원 정리 주기가 실제로 돌고 있는가. 넷째, 상시 부하에 대한 할인 적용률이 안정적으로 유지되는가입니다.

    1. 미태깅 리소스 비율 감소
    2. 주간 비용 증가 원인 파악 시간 단축
    3. 개발/운영 환경별 비용 분리 정확도 향상
    4. 유휴 자원 정리 후 재발 방지 자동화 적용
    FinOps 클라우드 비용 최적화 결과 대시보드 이미지

    서비스별 비용 증감, 예산 임계치, 미태깅 리소스 현황을 함께 보여주는 결과 대시보드 이미지입니다.

    실제로 써보니까 대시보드가 화려할 필요는 없었어요. 오히려 이번 주 뭐가 늘었는지, 왜 늘었는지, 누가 액션할지가 바로 보이는 구성이 제일 좋더라고요. 드디어 됐다! 싶은 순간이 이때 와요. 숫자가 회의용 장식이 아니라 운영 도구가 되는 거죠.

    비교로 보는 우선 적용 순서

    영역 빠른 효과 구현 난이도 추천 시점
    태그 표준화 높음 중간 가장 먼저
    예산/알림 높음 낮음 즉시
    유휴 자원 정리 높음 낮음 즉시
    라이트사이징 중간 중간 데이터 확보 후
    약정형 할인 중간~높음 중간 패턴 안정화 후
    정책 자동화 장기적으로 매우 높음 중간~높음 기본 체계 수립 후

    정리와 다음 단계

    오늘 정리한 체크리스트의 핵심은 하나예요. 클라우드 비용 관리는 절감 이벤트가 아니라 운영 체계라는 거예요. 태그, 예산, 유휴 자원 정리, 리뷰 루틴 이 네 가지만 먼저 제대로 굴려도 팀 분위기가 달라져요. 그리고 그 위에 약정형 할인, Kubernetes 비용 배분, 정책 자동화를 차근차근 얹으면 돼요.

    저도 처음엔 FinOps를 재무팀이 보는 숫자 정도로만 생각했었는데, 실제로는 인프라 운영 성숙도를 보여주는 지표에 더 가깝더라고요. 그래서 FinOps 클라우드 비용 최적화는 비용을 아끼는 기술이면서 동시에 운영을 더 예측 가능하게 만드는 기술이에요. 혹시 지금 바로 하나만 시작하신다면, 오늘 안에 예산 알림부터 걸어보세요. 가장 빨리 체감된답니다.
    FinOps 클라우드 비용 관리 체크리스트 10가지 요약 인포그래픽

    태그, 예산, 유휴 자원, 라이트사이징, 할인 전략까지 10가지 체크리스트를 한 장으로 요약한 이미지입니다.

    자주 묻는 질문

    Q1. 작은 팀도 FinOps 전략이 필요한가요?

    필요해요. 오히려 작은 팀일수록 한두 번의 비용 급증이 크게 느껴져요. 복잡한 조직 체계보다 보이는 대시보드와 간단한 규칙이 더 중요합니다.

    Q2. 멀티 클라우드가 아니어도 비용 거버넌스가 필요한가요?

    네. 단일 클라우드라도 서비스가 늘어나면 비용 구조가 금방 복잡해져요. 비용 거버넌스는 규모보다 습관의 문제에 가까워요.

    Q3. 가장 먼저 줄이기 쉬운 비용은 무엇인가요?

    보통은 유휴 자원과 과한 사양이에요. 안 쓰는 디스크, 오래된 스냅샷, 과도한 인스턴스 크기부터 보시면 성과가 빨리 나더라고요.

    이전 글에서 다룬 모니터링 표준화 내용과 함께 보시면 더 연결이 잘 돼요. 다음 글에서는 Terraform 기준으로 태그 강제와 비용 검증 파이프라인을 정리해보겠습니다.
  • [AI] Ollama 비용 비교: 로컬 AI vs 클라우드 API 실측 분석

    [AI] Ollama 비용 비교: 로컬 AI vs 클라우드 API 실측 분석

    [AI 운영] Ollama 비용 비교: 로컬 AI vs 클라우드 API

    로컬 AI를 붙여볼까, 아니면 그냥 API로 갈까. 이 고민 한 번쯤 해보셨을 겁니다. 저도 홈랩에서 이것저것 붙여 보다가 Ollama 비용이 생각보다 단순하지 않다는 걸 꽤 늦게 깨달았거든요. 처음엔 “로컬은 공짜 아니야?”라고 생각했는데, 실제로 써보니까 하드웨어 감가상각, 전력, 운영 시간, 장애 대응까지 다 합쳐서 봐야 하더라고요. 반대로 클라우드 API는 비싸 보이지만, 잘 쓰면 운영 부담이 거의 없어서 총비용(TCO, Total Cost of Ownership) 기준으로는 더 낫기도 합니다.

    이 글은 제가 13년차 인프라 엔지니어로서 실제 운영 관점에서 정리한 비교입니다. 특정 벤치마크 숫자를 억지로 붙이기보다, 어떻게 측정하고 어떤 기준으로 판단해야 하는지에 집중하겠습니다. 특히 로컬 LLM, Claude API 비용, 그리고 흔히 오해하기 쉬운 AI 운영 비용까지 같이 보겠습니다.

    Ollama 비용 비교를 위한 로컬 서버와 클라우드 API 아키텍처 개요 이미지

    로컬 추론 서버, 사내 애플리케이션, 외부 클라우드 API가 어떻게 연결되는지 한 장으로 보여주는 개요 이미지입니다.

    1. 왜 다들 Ollama 비용에서 헷갈릴까요?

    쉽게 말해, 로컬은 토큰당 과금이 안 보일 뿐이지 비용이 없는 게 아닙니다. 반대로 클라우드는 청구서가 너무 잘 보여서 비싸게 느껴지는 거고요. 제가 처음엔 이 부분에서 삽질 좀 했습니다 ㅎㅎ 눈앞에 보이는 건 API 청구서뿐인데, 실제로는 집이나 사무실에 있는 장비가 계속 전기를 먹고 있고, 디스크도 차고, 백업도 해야 하고, 장애 나면 내가 직접 봐야 하거든요.

    • 로컬 AI(Ollama): 토큰 과금 대신 하드웨어, 전력, 운영 인건비가 들어갑니다.
    • 클라우드 API: 초기 투자 없이 바로 쓰지만, 사용량이 늘면 월 비용이 빠르게 올라갑니다.
    • 핵심 포인트: 둘 중 뭐가 싼지는 “감정”이 아니라 “트래픽 패턴”으로 결정됩니다.

    2. 로컬 LLM vs 클라우드 API, 개념을 아주 쉽게 풀어보면

    Ollama는 오픈 웨이트(open weights, 공개 배포 모델)를 로컬에서 쉽게 실행하게 해주는 러너(runner)라고 보시면 됩니다. 설치가 간단하고, 모델을 pull 해서 바로 돌릴 수 있어서 입문 장벽이 낮습니다. 제가 직접 써보니 개발 PC나 홈랩에서 빠르게 검증할 때 정말 편하더라고요.

    반면 클라우드 API는 모델 자체를 직접 운영하지 않고, 요청(request)과 응답(response)에 대해 비용을 내는 구조입니다. 예를 들어 Anthropic의 Claude API는 공식 가격 페이지 기준으로 모델별 입력 토큰(input token)과 출력 토큰(output token) 단가가 분리되어 있습니다.

    항목 Ollama 로컬 실행 클라우드 API
    초기비용 장비가 필요함 거의 없음
    월비용 구조 전력, 감가상각, 운영비 토큰 사용량 기반
    확장성 장비 한계에 좌우 상대적으로 쉬움
    보안/격리 오프라인 운영 가능 정책 검토 필요
    운영 난이도 직접 관리 낮은 편

    여기서 중요한 포인트!

    Ollama NPU 같은 키워드 때문에 “NPU만 있으면 로컬 AI가 무조건 유리하다”라고 생각하시는 분도 있는데요, 실제 운영에서는 모델 크기, 메모리 용량, 메모리 대역폭, 동시 요청 수가 더 크게 체감됩니다. 저도 처음엔 가속기 종류만 보다가, 나중에 병목이 저장소가 아니라 메모리 쪽이라는 걸 체감했었습니다.

    3. Ollama 비용 계산은 이렇게 해야 덜 틀립니다

    제가 권하는 방식은 아주 단순합니다. 로컬은 월 고정비처럼 보고, 클라우드는 사용량 기반 변동비처럼 보시면 됩니다.

    로컬 AI 운영 비용 계산식

    1. 장비 구매비를 사용 예정 개월 수로 나눕니다.
    2. 월 전력 비용을 더합니다.
    3. 스토리지, 백업, 모니터링 같은 부대비용을 더합니다.
    4. 운영 시간까지 돈으로 환산할지 결정합니다.
    월 로컬 비용 = (장비 구매비 / 사용 개월 수) + 월 전력비 + 부대비용 + 운영 인건비(선택)

    예를 들어 개발팀에서 내부 문서 검색 보조나 코드 요약처럼 예측 가능한 고정 부하가 있다면, 로컬이 생각보다 유리해질 수 있습니다. 반대로 요청이 들쑥날쑥하고 야간 피크가 큰 서비스라면 장비를 놀리는 시간이 많아져서 비효율이 생깁니다.

    Claude API 비용 계산식

    Anthropic 공식 가격 페이지를 보면 Claude Sonnet 4.6은 입력 1MTok당 $3, 출력 1MTok당 $15이고, Claude Haiku 4.5는 입력 1MTok당 $1, 출력 1MTok당 $5입니다. 여기서 중요한 건 입력과 출력이 따로 과금된다는 점입니다.

    월 API 비용 = (월 입력 토큰 / 1,000,000 × 입력 단가) + (월 출력 토큰 / 1,000,000 × 출력 단가)

    이 계산식만 붙여도 Claude API 비용 감이 꽤 빨리 옵니다. 특히 프롬프트가 길거나, RAG(Retrieval-Augmented Generation, 검색증강생성)로 문서를 많이 붙이는 구조라면 입력 토큰이 생각보다 많이 나옵니다.

    4. 실전 구현: 로컬 Ollama와 클라우드 API를 같은 기준으로 재보기

    비교는 공정해야 합니다. 제가 보통 맞추는 기준은 4개입니다. 같은 작업 유형, 비슷한 길이의 프롬프트, 같은 동시성, 같은 로그 포맷. 이 4개가 안 맞으면 숫자가 예쁘게 나와도 의미가 없습니다.

    1. 로컬에 Ollama를 설치합니다.
    2. 테스트용 모델을 하나 내려받습니다.
    3. 동일 프롬프트로 로컬과 API를 각각 호출합니다.
    4. 지연시간(latency, 응답 지연), 실패율, 토큰 사용량을 같은 형식으로 남깁니다.
    curl -fsSL https://ollama.com/install.sh | sh
    ollama pull qwen2
    ollama run qwen2

    설치는 정말 빠릅니다. 근데 여기서 끝이 아니더라고요. 실무에서는 “잘 실행된다”보다 “반복 호출해도 안정적인가”가 더 중요합니다.

    로컬 LLM 구성에서 Ollama 비용과 자원 사용 흐름을 보여주는 이미지

    Ollama 설치 이후 모델 다운로드, 로컬 추론, 애플리케이션 호출 흐름을 단계별로 보여주는 구성 이미지입니다.

    같은 프롬프트를 보내는 간단한 테스트 예시

    import os
    import time
    import requests
    
    PROMPT = "사내 장애 보고서를 5줄로 요약하고, 후속 조치 3가지를 제안해 주세요."
    
    def test_ollama():
        started = time.time()
        r = requests.post(
            "http://localhost:11434/api/generate",
            json={"model": "qwen2", "prompt": PROMPT, "stream": False},
            timeout=120,
        )
        elapsed = time.time() - started
        return {"target": "ollama", "status": r.status_code, "elapsed_sec": round(elapsed, 2)}
    
    def test_claude():
        started = time.time()
        r = requests.post(
            "https://api.anthropic.com/v1/messages",
            headers={
                "x-api-key": os.environ["ANTHROPIC_API_KEY"],
                "anthropic-version": "2023-06-01",
                "content-type": "application/json",
            },
            json={
                "model": "claude-sonnet-4-6",
                "max_tokens": 300,
                "messages": [{"role": "user", "content": PROMPT}],
            },
            timeout=120,
        )
        elapsed = time.time() - started
        return {"target": "claude_api", "status": r.status_code, "elapsed_sec": round(elapsed, 2)}
    
    print(test_ollama())
    print(test_claude())

    이 정도만 돌려도 감이 옵니다. 로컬은 장비 상태 영향을 많이 받고, 클라우드는 네트워크 왕복이 있지만 운영은 단순합니다.

    5. ⚠️ 주의사항: 제가 실제로 자주 부딪힌 문제들

    1) 로컬은 “무료”가 아니라 “숨은 비용”이 많습니다

    가장 흔한 오해입니다. Ollama 비용을 0원처럼 보면 의사결정이 틀어집니다. 디스크가 꽉 차거나 모델 캐시가 꼬이면 정리 시간이 들어가고, 백업 정책 없으면 장애 복구도 직접 해야 합니다.

    2) 모델 성능 비교를 제품 간 단순 비교로 하면 안 됩니다

    같은 작업이라도 로컬 모델과 상용 API 모델은 튜닝 상태, 컨텍스트 길이, 응답 품질이 다릅니다. 그래서 저는 “정답률” 하나만 보지 않고 아래 항목을 같이 봅니다.

    • 응답 품질 일관성
    • 지연시간 편차
    • 실패 재시도 비율
    • 운영자가 손대야 하는 빈도

    3) Ollama NPU만 보고 설계하면 낭패 보기 쉽습니다

    이건 특히 노트북 기반 테스트에서 많이 보입니다. NPU가 있더라도 모든 워크로드가 자동으로 유리해지는 건 아닙니다. 실제로는 모델 메모리 요구사항과 드라이버 성숙도, 배치(batch, 일괄 처리) 특성이 더 중요할 때가 많았습니다.

    4) 클라우드는 프롬프트 설계가 곧 비용 절감입니다

    제가 써보니까 API 쪽은 인프라보다 프롬프트 정리가 더 큰 절감 포인트인 경우가 많았습니다. 시스템 프롬프트를 너무 길게 쓰거나, RAG 문서를 매번 과하게 붙이면 비용이 금방 올라갑니다.

    6. 검증/결과: 무엇을 보면 판단이 빨라질까요?

    벤치마크 툴을 거창하게 만들 필요는 없습니다. 아래 5가지만 수집해도 충분합니다.

    1. 평균 지연시간과 p95 지연시간
    2. 실패율과 재시도 횟수
    3. 월 입력/출력 토큰
    4. 동시 요청 수 증가 시 품질 저하 여부
    5. 운영자가 개입한 시간

    저는 여기서 마지막 항목을 꼭 봅니다. 왜냐하면 AI 운영 비용은 서버 비용만이 아니라, 결국 사람 시간까지 포함해서 봐야 하거든요.

    Ollama 비용과 Claude API 비용을 비교하는 운영 대시보드 이미지

    응답 지연, 실패율, 토큰 사용량, 추정 월 비용을 한 번에 비교하는 운영 대시보드 이미지입니다.

    상황 로컬 Ollama가 유리한 경우 클라우드 API가 유리한 경우
    보안 오프라인 또는 내부망 우선 외부 반출 정책 검토 가능
    트래픽 예측 가능한 고정 사용량 변동 폭이 큼
    운영 인력 직접 관리 가능 인프라 운영 여력이 적음
    초기 도입 실험 장비가 이미 있음 빠른 PoC가 필요함
    확장 제한적 상대적으로 유연함

    정리하면 이렇습니다. Ollama 비용은 장기적이고 예측 가능한 내부 업무에 잘 맞고, Claude API 비용은 초기 투자 없이 빠르게 시작해야 하는 팀에 잘 맞습니다. 어느 쪽이 무조건 낫다기보다, 트래픽 곡선과 운영 역량이 답을 정해 줍니다.

    7. 자주 묻는 질문

    Q1. 작은 팀도 로컬 LLM을 바로 도입할 만한가요?

    가능은 합니다. 다만 장비보다 먼저 운영 목표를 정하시는 게 좋습니다. 사내 요약, 분류, 초안 작성처럼 반복 업무가 명확하면 훨씬 판단이 쉽습니다.

    Q2. API 비용이 무서운데, 바로 로컬로 가야 할까요?

    꼭 그렇진 않습니다. 제가 추천하는 순서는 보통 API로 빠르게 검증한 뒤, 사용 패턴이 굳으면 그때 로컬 이전을 검토하는 방식입니다. 이게 실패 비용이 낮더라고요.

    Q3. 실측 분석은 얼마나 돌려봐야 믿을 수 있나요?

    최소한 평일 업무 시간대와 야간 시간대는 나눠서 보시는 걸 권합니다. 짧게 한두 번 돌려서는 운영 현실이 잘 안 보입니다.

    8. 마무리: 결론은 “누가 더 싼가”가 아니라 “내 패턴에 뭐가 맞는가”입니다

    처음엔 저도 로컬이면 무조건 이득일 줄 알았습니다. 근데 실제로 써보니까, 운영 가능한 로컬과 그냥 돌아가는 로컬은 완전히 다른 이야기더라고요. 반대로 클라우드 API도 비싸 보이지만, 운영 복잡도를 줄여 준다는 점에서 값어치를 할 때가 분명히 있습니다.

    그래서 제 기준은 이겁니다. 고정 부하, 데이터 통제, 반복 업무면 Ollama 쪽을 먼저 보고, 빠른 검증, 유연한 확장, 낮은 운영 부담이면 클라우드 API를 먼저 봅니다. 혹시 지금 막 비교 중이시라면, 장비 스펙부터 보지 마시고 먼저 한 달 사용량과 프롬프트 길이부터 적어 보세요. 그게 제일 빨랐습니다.

    Ollama 비용 기준으로 로컬 AI와 클라우드 API 선택 포인트를 정리한 이미지

    보안, 비용 구조, 성능, 운영 난이도를 기준으로 어떤 선택이 맞는지 한눈에 정리한 요약 인포그래픽입니다.

    다음 글에서는 Ollama + 벡터DB(vector database) + RAG 조합에서 실제로 비용이 어디서 새는지 더 구체적으로 다뤄보겠습니다. 이전 글에서 다룬 홈랩 관측성(observability) 구성과도 연결해 보시면 훨씬 이해가 쉬우실 겁니다.

  • [HomeLabs] 인텔 N100 미니PC 홈서버, 1년 전기요금 및 실제 성능 비용 분석

    [HomeLabs] 인텔 N100 미니PC 홈서버, 1년 전기요금 및 실제 성능 비용 분석

    [홈서버] 인텔 N100 미니PC 1년 전기요금과 성능 비용 분석

    인텔 N100 미니PC를 홈서버로 써볼까 고민하시는 분들, 대부분 여기서 막히시더라고요. 전기를 얼마나 먹는지, 그리고 그 전기요금 대비 성능이 정말 괜찮은지가 애매하거든요. 저도 홈랩을 굴리다 보면 CPU 성능보다 먼저 보는 게 월 전기요금입니다. 장비는 싸게 샀는데 24시간 켜두는 순간 운영비가 계속 나가니까요. 그래서 이번 글에서는 인텔 N100 미니PC를 기준으로, 홈서버 전기요금을 어떻게 계산하면 되는지, 어떤 작업까지는 무난하고 어디서 한계가 오는지, 그리고 미니PC 가성비를 실제 운영 관점에서 어떻게 봐야 하는지 차근차근 정리해보겠습니다.

    결론부터 짧게 말씀드리면, 저전력 서버를 목표로 할 때 N100 계열은 꽤 설득력이 있습니다. 다만 “본체 가격이 싸다”만 보고 들어가면 안 되고, 스토리지 구성, 메모리 용량, 컨테이너 수, 트랜스코딩 유무까지 같이 봐야 진짜 비용이 보입니다. 여기서 중요한 포인트입니다. 홈서버 전기요금은 CPU 이름보다도 실제 벽전력(Wall Power, 콘센트에서 측정한 전력)이 더 중요합니다.

    인텔 N100 미니PC 홈서버 전체 아키텍처와 전력 흐름 개요 이미지

    인텔 N100 미니PC를 중심으로 공유기, NAS 저장소, Docker 컨테이너, 모니터링 도구가 연결된 홈서버 개요를 보여주는 이미지입니다.

    인텔 N100 미니PC가 홈서버에서 자주 언급되는 이유

    쉽게 말해 인텔 N100은 저전력과 기본적인 서버 작업의 균형 때문에 많이 언급됩니다. 이 프로세서는 Alder Lake-N 계열로 알려져 있고, 고성능 P-core가 아니라 E-core 중심 설계라서 데스크톱 급 폭발력은 약하지만, 대신 24시간 켜두는 장비에는 꽤 잘 맞는 편입니다. 특히 다음 같은 용도에서는 만족도가 괜찮은 편이죠.

    • Docker(도커, 컨테이너 기반 애플리케이션 실행 환경) 몇 개 띄우기
    • Home Assistant(홈 어시스턴트, 스마트홈 통합 관리)
    • AdGuard Home 또는 Pi-hole(광고/추적 차단 DNS)
    • 가벼운 NAS 보조 노드
    • 백업 서버, 다운로드 서버, 리버스 프록시(Reverse Proxy, 요청 중계 서버)
    • 테스트용 Kubernetes(쿠버네티스) 또는 가상화 입문

    반대로 처음부터 기대치를 너무 높게 잡으면 실망할 수 있습니다. 예를 들어 다수의 가상머신을 동시에 돌리거나, 무거운 데이터베이스를 계속 때리거나, 여러 명이 동시에 미디어 트랜스코딩을 쓰는 환경은 얘기가 달라집니다. 저도 처음엔 “CPU 이름만 보면 요즘 칩이니까 다 되겠지” 싶었는데, 실제 운영은 메모리와 I/O, 그리고 발열 설계가 더 크게 체감되더라고요.

    홈서버 전기요금은 이렇게 계산하시면 됩니다

    전기요금 계산은 생각보다 단순합니다. 핵심 공식은 이것 하나예요.

    연간 사용 전력량(kWh) = 소비전력(W) x 24시간 x 365일 / 1000

    그 다음 전기요금은 아래처럼 계산합니다.

    연간 전기요금 = 연간 사용 전력량(kWh) x 적용 단가(원/kWh)

    문제는 여기서 소비전력(W)이 CPU 스펙표 숫자와 다르다는 점입니다. 미니PC는 메인보드, SSD, 메모리, USB 장치, 전원 어댑터 효율까지 합쳐진 값으로 봐야 하거든요. 그래서 저는 홈랩 장비 볼 때 항상 “CPU 전력”보다 “벽전력” 기준으로 판단하라고 말씀드립니다.

    예를 들어, 아래처럼 세 가지 운영 시나리오로 보면 감이 빨리 옵니다.

    운영 시나리오 평균 소비전력 예시 연간 사용 전력량 특징
    거의 유휴 상태 10W 87.6kWh DNS, 홈 오토메이션, 경량 컨테이너 위주
    일반 홈서버 운영 15W 131.4kWh 모니터링, 다운로드, 파일 공유, 프록시 포함
    부하가 잦은 운영 20W 175.2kWh 백업, 인덱싱, 미디어 작업이 자주 발생

    여기서 단가를 예시로 넣어보겠습니다. 전기요금 체계는 지역과 계약 조건에 따라 달라지니, 아래는 비교용 예시 계산으로 보시면 됩니다.

    평균 전력 연간 사용량 150원/kWh 기준 200원/kWh 기준
    10W 87.6kWh 13,140원 17,520원
    15W 131.4kWh 19,710원 26,280원
    20W 175.2kWh 26,280원 35,040원

    이 표를 보면 감이 오실 겁니다. 인텔 N100 미니PC를 아주 무겁게만 쓰지 않는다면, 1년 전기요금 자체는 꽤 낮게 관리되는 편입니다. 물론 이 수치는 어디까지나 평균 전력 가정치이기 때문에, 실제 값은 꼭 측정이 필요합니다. 특히 USB 외장디스크 여러 개 붙이면 생각보다 많이 올라갑니다. 이 부분, 은근히 놓치기 쉽습니다 ㅎㅎ

    N100 성능은 어디까지 기대하면 맞을까

    N100 성능을 평가할 때 실수하기 쉬운 게 데스크톱 CPU처럼 보는 겁니다. 이 칩은 “고성능 작업을 짧게 폭발시키는 용도”보다 “적당한 작업을 오래, 조용하게, 싸게” 돌리는 데 더 어울립니다. 쉽게 말해 아래 기준으로 생각하시면 거의 안 틀립니다.

    • 잘 맞는 작업: 리버스 프록시, 홈 오토메이션, Git 서버, Wiki, 가벼운 DB, 백업 에이전트
    • 무난한 작업: 소규모 Docker 스택, 테스트용 가상화, 단일 사용자 미디어 서버
    • 버거울 수 있는 작업: 다중 동시 트랜스코딩, 무거운 CI 빌드, 대형 DB, 사용자 많은 NAS 올인원

    성능 비용 분석은 이렇게 보시면 됩니다. 본체 가격만 놓고 보면 저렴해 보여도, 만약 내 워크로드가 N100의 처리 범위를 넘어서면 결국 더 큰 장비를 다시 사게 됩니다. 그러면 초기 가성비가 무너집니다. 반대로 DNS, VPN, 백업, 알림봇, 가벼운 웹서비스 같은 걸 24시간 돌릴 목적이라면 미니PC 가성비가 꽤 좋게 나올 수 있습니다.

    제가 홈랩에서 자주 보는 판단 기준은 이것입니다.

    1. 항상 켜져 있어야 하는가
    2. CPU보다 스토리지가 더 중요한가
    3. 동시 접속자가 많은가
    4. 트랜스코딩이나 가상머신이 자주 필요한가
    5. 소음과 발열을 얼마나 민감하게 보는가

    이 질문에 대부분 “가벼운 서비스 위주”라고 답하신다면, N100 계열은 꽤 현실적인 선택입니다.

    실전 구현: 소비전력과 운영 비용 직접 계산하기

    이제 실제로 계산해보겠습니다. 제 방식은 복잡하지 않습니다. 우선 벽전력계로 대기 상태와 평소 부하 상태를 각각 재고, 그 평균값으로 연간 비용을 추산합니다. Home Assistant나 Grafana(그라파나, 시각화 대시보드)까지 붙이면 더 보기 편하고요. 처음엔 귀찮아 보이는데, 한 번 해두면 장비 교체 판단이 엄청 쉬워집니다.

    1. 리눅스에서 현재 CPU 정보 확인

    lscpu
    uname -a
    free -h
    lsblk

    이 명령은 CPU, 커널, 메모리, 스토리지 구성을 확인할 때 기본입니다. 특히 미니PC는 같은 N100이라도 메모리 채널, 저장장치 종류, 네트워크 칩셋이 달라서 체감이 달라질 수 있습니다.

    2. 부하 전후 상태 확인

    uptime
    top
    vmstat 1 5
    iostat -xz 1 3

    여기서 Load Average(로드 애버리지, 시스템 평균 부하)가 계속 높게 유지되는지, I/O Wait(입출력 대기)가 큰지 보면 병목 위치가 보입니다. CPU가 약한 줄 알았는데 사실은 SSD 쓰기나 USB 저장장치가 느린 경우도 많습니다.

    인텔 N100 미니PC의 Docker 홈서버 구성과 모니터링 연결 구조 이미지

    Docker 컨테이너, 모니터링 스택, 저장소가 어떻게 연결되는지 보여주는 구성 다이어그램 또는 설정 화면 이미지입니다.

    3. 연간 전기요금 계산 스크립트

    간단한 계산은 쉘로도 되지만, 여러 시나리오를 비교하려면 파이썬이 편하더라고요.

    def yearly_cost(avg_watts, price_per_kwh):
        yearly_kwh = avg_watts * 24 * 365 / 1000
        return yearly_kwh, yearly_kwh * price_per_kwh
    
    scenarios = [10, 15, 20]
    prices = [150, 200]
    
    for watts in scenarios:
        for price in prices:
            kwh, cost = yearly_cost(watts, price)
            print(f"avg={watts}W, price={price}원 -> {kwh:.1f}kWh/year, {cost:,.0f}원/year")

    이런 식으로 계산해두면 장비가 여러 대일 때도 금방 비교됩니다. 예를 들어 N100 미니PC 한 대와 구형 데스크톱 한 대를 비교하면, 성능보다 먼저 상시 대기 전력 차이가 크게 보일 수 있습니다.

    4. Docker 기반 홈서버 예시 구성

    version: "3.8"
    services:
      adguardhome:
        image: adguard/adguardhome
        container_name: adguardhome
        restart: unless-stopped
        ports:
          - "53:53/tcp"
          - "53:53/udp"
          - "3000:3000/tcp"
          - "80:80/tcp"
        volumes:
          - ./adguard/work:/opt/adguardhome/work
          - ./adguard/conf:/opt/adguardhome/conf
    
      node-exporter:
        image: prom/node-exporter
        container_name: node-exporter
        restart: unless-stopped
        network_mode: host
    
      uptime-kuma:
        image: louislam/uptime-kuma
        container_name: uptime-kuma
        restart: unless-stopped
        ports:
          - "3001:3001"
        volumes:
          - ./uptime-kuma:/app/data

    이 정도 스택은 대체로 가볍습니다. DNS, 모니터링, 상태 체크 정도는 N100 계열에서도 충분히 운영 가능한 범주로 많이 거론됩니다. 다만 컨테이너가 늘어나기 시작하면 메모리가 먼저 찰 수 있으니, CPU만 보지 말고 RAM도 같이 보셔야 합니다.

    ⚠️ 실제 운영에서 자주 겪는 문제와 해결 포인트

    여기부터가 진짜 중요합니다. 사양표에는 잘 안 나오는데, 실사용에서 발목 잡는 건 대부분 이런 부분입니다.

    1. 저장장치 때문에 체감이 무너지는 경우

    처음엔 CPU가 느린 줄 알았는데, 실제로는 저가형 SATA SSD나 USB 외장 케이스가 병목인 경우가 많습니다. 특히 로그가 많은 컨테이너, 사진 인덱싱, 백업 검증 작업은 디스크가 버벅이면 전체가 굼떠집니다.

    • 운영체제와 데이터 디스크를 분리하면 관리가 쉬워집니다
    • 가능하면 안정적인 SSD를 쓰는 편이 낫습니다
    • USB 저장장치는 절전 설정 때문에 끊김이 날 수 있습니다

    2. 발열과 스로틀링(Throttling, 과열 시 성능 제한)

    팬리스(Fanless, 무팬) 미니PC는 조용해서 좋지만, 여름철 장시간 부하에서는 성능이 내려갈 수 있습니다. 저도 예전에 “왜 갑자기 응답이 굼뜨지?” 싶었는데, 케이스 온도부터 올라가 있더라고요. 특히 트랜스코딩이나 압축 작업을 자주 돌리면 더 민감합니다.

    • 통풍 공간 확보
    • 상시 고부하 작업 분리
    • 모니터링으로 온도 추적

    3. 네트워크 포트와 확장성 한계

    미니PC는 소형이라 편하지만, LAN 포트 수나 스토리지 베이가 제한적인 경우가 많습니다. 그래서 “이걸 NAS까지 다 합칠까?” 하다가 나중에 다시 분리하는 경우도 많습니다. 홈서버는 한 번에 완성하려고 하면 오히려 꼬입니다.

    4. 가상화는 되는데, 욕심내면 금방 빡빡해집니다

    가벼운 VM 몇 개는 가능하더라도, VM마다 메모리와 디스크를 먹기 시작하면 체감이 확 달라집니다. Proxmox(프록스목스, 가상화 플랫폼) 입문용으로는 괜찮지만, 운영 서비스가 늘어나면 컨테이너 중심이 더 효율적일 때가 많습니다.

    인텔 N100 미니PC 소비전력과 홈서버 전기요금을 검증하는 대시보드 이미지

    콘센트 전력 측정기, CPU 사용률 그래프, 온도와 메모리 사용량이 함께 보이는 검증용 대시보드 이미지입니다.

    검증: 1년 전기요금과 성능 비용은 어떻게 해석해야 할까

    이제 숫자를 해석해보겠습니다. 만약 평균 소비전력이 10W에서 20W 사이로 관리된다면, 연간 전력 사용량은 대략 87.6kWh에서 175.2kWh 수준입니다. 예시 단가 150원에서 200원을 넣으면 연간 비용은 대략 1만 원대 초반부터 3만 원대 중반 정도 범위가 나옵니다. 이 정도면 저전력 서버라는 표현이 과장은 아닙니다.

    그런데 여기서 놓치면 안 되는 게 있습니다. 성능 비용은 전기만 보면 안 됩니다. 총비용은 보통 아래 네 가지를 같이 봐야 합니다.

    1. 초기 장비 구매 비용
    2. 스토리지 업그레이드 비용
    3. 연간 전기요금
    4. 부족한 성능 때문에 생기는 재구매 가능성

    예를 들어 가벼운 홈 오토메이션, DNS, 모니터링, 다운로드 서버라면 N100 쪽이 굉장히 효율적일 수 있습니다. 반면 Jellyfin이나 Plex 같은 미디어 서버에서 여러 사용자가 동시에 작업하고, NAS 기능까지 한 대에 몰아넣고, 거기에 백업 검증까지 같이 하겠다면 이야기가 달라집니다. 이 경우엔 전기요금이 조금 더 들더라도 상위 CPU나 별도 NAS 구성이 오히려 낫습니다.

    기준 N100 미니PC가 잘 맞는 경우 다른 선택지를 봐야 하는 경우
    운영 목표 24시간 가벼운 서비스 운영 고부하 작업과 통합 서버 운영
    전기요금 최대한 낮추고 싶음 전력보다 절대 성능이 더 중요
    확장성 장비 1대에 소규모 구성 다중 디스크, 다중 NIC 필요
    성능 여유 경량 컨테이너 중심 VM, 인코딩, 무거운 DB 다수

    결국 인텔 N100 미니PC의 핵심 가치는 “엄청 빠르다”가 아니라, 계속 켜놔도 부담이 비교적 적고, 기본적인 홈서버 업무를 안정적으로 맡길 수 있다는 데 있습니다. 이 관점에서 보면 미니PC 가성비가 좋다는 말이 성립합니다.

    정리: 이런 분께는 N100 홈서버가 꽤 잘 맞습니다

    • 첫 홈랩 장비를 찾는 분
    • 전기요금이 부담돼서 구형 데스크톱 서버를 줄이고 싶은 분
    • Docker, Home Assistant, DNS, 백업 에이전트 위주로 돌릴 분
    • 작고 조용한 장비를 원하는 분
    • 반대로 헤비한 가상화, 다중 트랜스코딩이 목적이라면 재검토가 필요한 분

    혹시 지금 집에서 안 쓰는 구형 데스크톱을 홈서버로 돌리고 계신가요? 그렇다면 한 번쯤은 평균 소비전력을 재보시는 걸 권합니다. 생각보다 차이가 큽니다. 저도 홈랩 정리할 때 늘 그렇게 판단하거든요. CPU 벤치마크 숫자보다, 내 워크로드에서 1년 동안 얼마를 먹는지가 훨씬 현실적입니다.

    인텔 N100 미니PC와 구형 서버의 전력 대비 활용도 비교 이미지

    인텔 N100 미니PC와 구형 데스크톱 서버를 전력 효율, 소음, 확장성, 홈서버 적합성 관점에서 비교한 요약 인포그래픽입니다.

    FAQ: 많이 받는 질문

    Q1. N100으로 NAS와 홈서버를 한 번에 합쳐도 될까요?

    가능은 하지만, 저장장치 확장성과 백업 전략을 먼저 보셔야 합니다. 데이터가 중요하면 컴퓨트와 스토리지를 분리하는 편이 운영이 더 편한 경우가 많습니다.

    Q2. 홈서버 전기요금은 CPU 스펙만 보면 되나요?

    아닙니다. 반드시 벽전력 기준으로 보셔야 합니다. 어댑터 효율, SSD, USB 장치, 네트워크 장치까지 전부 포함해야 실제 비용이 나옵니다.

    Q3. N100 성능으로 가상화도 가능할까요?

    가벼운 수준은 가능합니다. 다만 VM 수가 늘거나 디스크 I/O가 많아지면 빠르게 답답해질 수 있어서, 초반엔 컨테이너 중심 구성을 추천드립니다.

    마무리

    정리하면, 인텔 N100 미니PC는 화려한 장비는 아니지만, 저전력 서버라는 목적에는 꽤 잘 맞는 카드입니다. 1년 전기요금도 평균 전력만 잘 관리되면 부담이 크지 않은 편이고요. 다만 성능 비용 분석은 항상 내가 실제로 돌릴 서비스 기준으로 하셔야 합니다. DNS 한두 개 돌릴 건데 상위 장비를 살 필요는 없고, 반대로 모든 걸 한 대에 몰아넣을 건데 N100에 너무 많은 기대를 거는 것도 위험합니다.

    다음 글에서는 인텔 N100 미니PC에 Proxmox를 올릴지, Docker 전용 호스트로 갈지 판단하는 기준을 정리해보겠습니다. 이전 글에서 다뤘던 백업 전략과 같이 보시면 더 감이 오실 거예요. 여러분도 장비 스펙표보다 먼저 콘센트 전력부터 한번 확인해보세요. 거기서 진짜 운영비가 시작됩니다. 🎉
  • [Proxmox] Terraform Proxmox Provider 활용: VM 자동 프로비저닝 심층 분석

    [Proxmox] Terraform Proxmox Provider 활용: VM 자동 프로비저닝 심층 분석

    [인프라] Terraform Proxmox Provider 활용: VM 자동 프로비저닝 심층 분석

    홈랩을 조금만 오래 굴려보신 분들은 공감하실 겁니다. VM 하나는 금방 만들지만, 비슷한 설정의 VM을 여러 대 반복해서 만들기 시작하면 사람이 제일 큰 병목이 되더라고요. 저도 처음엔 Proxmox VE(프록스목스 가상화 플랫폼) 웹 UI에서 하나씩 클릭하면서 만들었었는데, 어느 순간부터는 이름 규칙이 꼬이고, CPU나 메모리 설정이 조금씩 달라지고, 네트워크 브리지도 실수로 잘못 붙이는 일이 생겼습니다. 그때 제대로 체감한 게 바로 Terraform Proxmox provider의 가치였습니다.

    Terraform Proxmox provider를 쓰면 Proxmox VM 자동화, IaC Proxmox, 프로비저닝 흐름을 코드로 관리할 수 있습니다. 쉽게 말해, “어떤 VM을 어떤 노드에 어떤 스펙으로 만들지”를 사람이 기억하는 게 아니라 코드가 기억하게 만드는 방식이죠. 실제로 써보니까 한 번만 템플릿과 변수 구조를 잘 잡아두면, 이후엔 VM 증설이 거의 배포 작업처럼 바뀝니다. 이거 진짜 편하더라고요.

    특히 테스트 서버, 쿠버네티스 노드, CI Runner(러너, 작업 실행기), 관제용 유틸리티 VM처럼 반복 생성되는 워크로드에는 효과가 큽니다. 반대로 템플릿 설계가 어설프면 삽질도 크게 옵니다. 저도 처음엔 Cloud-Init(클라우드 이닛, 최초 부팅 자동 설정)과 스토리지 설정 때문에 꽤 헤맸거든요. 이번 글에서는 그 과정을 최대한 실무 관점으로 풀어보겠습니다.

    Terraform Proxmox provider 기반 VM 자동화 아키텍처 이미지

    Terraform Proxmox provider로 템플릿 기반 VM이 자동 생성되는 전체 흐름을 보여주는 아키텍처 이미지입니다.

    왜 Terraform Proxmox provider가 중요한가

    핵심은 재현성(reproducibility, 동일한 결과를 반복 생성하는 성질)입니다. 사람이 수동으로 만든 VM은 겉보기엔 같아도 내부 설정이 미묘하게 다를 때가 많습니다. 그런데 Terraform(테라폼, 선언형 인프라 도구)은 원하는 상태를 선언하고, Provider(프로바이더, 특정 플랫폼과 통신하는 플러그인)가 그 상태를 실제 인프라에 반영합니다.

    쉽게 말해 이렇습니다.

    • Proxmox VE는 VM을 실행하는 플랫폼입니다.
    • Terraform은 “이런 VM을 만들어라”라고 선언하는 도구입니다.
    • Terraform Proxmox provider는 그 선언을 Proxmox API 요청으로 바꿔주는 다리 역할을 합니다.

    여기서 중요한 포인트! 수동 작업을 없애는 것도 좋지만, 더 중요한 건 변경 이력과 표준화입니다. 누가 언제 CPU를 2개에서 4개로 바꿨는지, 왜 디스크 타입을 SCSI(스카시, 저장장치 인터페이스)로 통일했는지, 네트워크 브리지를 왜 vmbr0로 고정했는지 코드와 Git 기록으로 남길 수 있거든요.

    수동 생성과 IaC Proxmox 방식 비교

    항목 수동 생성 IaC Proxmox
    반복 작업 사람이 매번 클릭 코드 재실행으로 반복
    설정 일관성 실수 발생 가능 동일 코드면 동일 결과
    변경 추적 메모 의존 Git으로 추적 가능
    대량 배포 시간 많이 소요 상대적으로 빠름
    복구 다시 손으로 작업 코드 기반 재생성 가능

    Terraform Proxmox provider의 동작 원리

    제가 직접 해보니 가장 헷갈리는 지점은 “Terraform이 VM 이미지를 직접 만드는 건가요?”라는 부분이었습니다. 사실은 그렇지 않습니다. 보통 흐름은 아래처럼 갑니다.

    1. Proxmox에 미리 VM 템플릿을 만들어 둡니다.
    2. Terraform이 Provider를 통해 Proxmox API에 접속합니다.
    3. 기존 템플릿을 Clone(클론, 복제)해서 새 VM을 만듭니다.
    4. CPU, 메모리, 디스크, 네트워크, IP 같은 값을 주입합니다.
    5. Cloud-Init으로 초기 사용자, SSH 키, 네트워크 정보를 반영합니다.

    즉, 템플릿 품질이 절반이고, Terraform 코드 구조가 나머지 절반입니다. 처음엔 이게 뭔가 싶었는데, 몇 번 구성해보니까 “템플릿은 골조, Terraform은 배포 정의서”라고 생각하면 이해가 빨랐습니다.

    실무에서 많이 쓰는 구성 요소

    • Template VM: Ubuntu 같은 게스트 OS를 미리 구성한 원본
    • Cloud-Init: 호스트명, 계정, SSH 키, IP 초기 설정
    • Bridge Network: vmbr0 같은 브리지 네트워크
    • Storage: local-lvm, zfs 같은 스토리지 대상
    • API Token: 자동화를 위한 인증 수단

    여기서 인증은 비밀번호보다 API Token(에이피아이 토큰, 자동화용 인증 토큰) 기반이 관리하기 더 낫습니다. 노출 범위를 줄이기도 좋고, 권한 분리도 더 명확하거든요.

    실전 구현: Proxmox VM 자동화 기본 구조

    이제 구현으로 들어가보겠습니다. 아래 예시는 가장 흔하게 쓰는 흐름인 “템플릿 복제 + Cloud-Init + 변수 기반 프로비저닝” 기준입니다. 다만 여기서 한 가지는 꼭 짚고 가야 합니다. Terraform Proxmox provider는 커뮤니티 제공 구현이 여럿 존재할 수 있고, 세부 인자명은 사용하는 provider 계열에 따라 조금씩 다를 수 있습니다. 그래서 아래 예시는 많이 쓰이는 패턴 중심으로 보시고, 실제 적용 전에는 사용 중인 provider 문서를 반드시 한 번 더 확인하시는 걸 권장합니다.

    1. 사전 준비

    1. Proxmox VE에 템플릿용 Linux VM을 하나 준비합니다.
    2. Cloud-Init이 활성화된 이미지 또는 패키지를 사용합니다.
    3. API Token을 생성합니다.
    4. Terraform 실행 환경에 인증 정보를 환경 변수로 넣습니다.

    제가 처음 삽질했던 부분은 템플릿을 그냥 “설치 완료된 VM” 정도로만 생각했던 점이었습니다. 근데 실제로는 템플릿 안에서 네트워크 초기화, SSH 접근, qemu-guest-agent 사용 여부까지 꽤 중요하더라고요.

    2. Provider 설정

    terraform {
      required_providers {
        proxmox = {
          source = "Telmate/proxmox"
        }
      }
    }
    
    provider "proxmox" {
      pm_api_url          = var.pm_api_url
      pm_api_token_id     = var.pm_api_token_id
      pm_api_token_secret = var.pm_api_token_secret
      pm_tls_insecure     = true
    }

    테스트 랩에서는 자체 서명 인증서 때문에 pm_tls_insecure = true를 쓰는 경우가 있습니다. 다만 운영 환경이라면 TLS 검증을 제대로 구성하는 쪽이 맞습니다. 홈랩에서는 편의상 넘어가도, 실무에선 보안 예외가 습관이 되면 좀 위험하거든요.

    3. 변수 정의

    variable "pm_api_url" {
      type = string
    }
    
    variable "pm_api_token_id" {
      type = string
    }
    
    variable "pm_api_token_secret" {
      type      = string
      sensitive = true
    }
    
    variable "target_node" {
      type    = string
      default = "pve01"
    }
    
    variable "template_name" {
      type    = string
      default = "ubuntu-cloudinit-template"
    }
    
    variable "vm_name" {
      type    = string
      default = "lab-app-01"
    }
    
    variable "vm_id" {
      type    = number
      default = 201
    }
    
    variable "vm_cores" {
      type    = number
      default = 2
    }
    
    variable "vm_memory" {
      type    = number
      default = 4096
    }
    
    variable "vm_ip" {
      type    = string
      default = "192.168.10.51/24"
    }
    
    variable "vm_gateway" {
      type    = string
      default = "192.168.10.1"
    }
    
    variable "ssh_public_key" {
      type = string
    }

    여기서는 일부러 값들을 분리했습니다. 이유가 있습니다. 처음엔 파일 하나에 다 때려 넣고 싶어지는데, VM 개수가 늘어나면 변수 분리가 안 되어 있는 구성이 유지보수 지옥으로 바뀝니다. 특히 이름, VM ID, IP는 충돌 관리 포인트라서 명시적으로 빼두는 게 좋습니다.

    Terraform Proxmox provider 설정과 템플릿 복제 흐름 이미지

    변수 파일, Provider, 템플릿 VM, Cloud-Init이 어떻게 연결되는지 설명하는 구성 이미지입니다.

    4. VM 리소스 정의

    resource "proxmox_vm_qemu" "app_vm" {
      name        = var.vm_name
      target_node = var.target_node
      clone       = var.template_name
      vmid        = var.vm_id
    
      cores   = var.vm_cores
      sockets = 1
      memory  = var.vm_memory
      agent   = 1
      onboot  = true
    
      os_type   = "cloud-init"
      bootdisk  = "scsi0"
      scsihw    = "virtio-scsi-pci"
    
      disk {
        slot    = "scsi0"
        size    = "20G"
        type    = "disk"
        storage = "local-lvm"
      }
    
      network {
        model  = "virtio"
        bridge = "vmbr0"
      }
    
      ipconfig0  = "ip=${var.vm_ip},gw=${var.vm_gateway}"
      ciuser     = "ubuntu"
      sshkeys    = var.ssh_public_key
    }

    이 구성이 기본 골격입니다. clone으로 템플릿을 복제하고, ipconfig0와 sshkeys로 초기 설정을 주입합니다. 실제로 써보니까 사람이 VM 만들고 SSH 키 복붙하고 IP 적어 넣던 시간을 거의 없애주더라고요. 드디어 됐다! 싶은 순간이 여기였습니다.

    5. 실행 명령

    export TF_VAR_pm_api_url="https://proxmox.example.local:8006/api2/json"
    export TF_VAR_pm_api_token_id="terraform@pve!iac"
    export TF_VAR_pm_api_token_secret="REDACTED"
    export TF_VAR_ssh_public_key="ssh-ed25519 AAAA... user@host"
    
    terraform init
    terraform plan
    terraform apply

    terraform plan 단계는 꼭 보셔야 합니다. 특히 VM ID, 스토리지 이름, 브리지 이름이 맞는지 여기서 1차로 걸러집니다. 저는 예전에 스토리지 이름을 기억으로 넣었다가 local-lvm 대신 다른 이름을 써서 실패했었는데, plan에서 못 알아차리고 바로 적용했다가 로그 뒤지느라 시간 꽤 썼습니다 ㅎㅎ

    여러 대를 한 번에 만드는 패턴

    한 대만 만들 거면 변수 몇 개로도 충분합니다. 그런데 홈랩이든 사내 테스트 존이든, VM이 3대 이상 넘어가면 반복 생성이 필요해집니다. 이때는 count 또는 for_each 패턴을 잡아두는 게 좋습니다.

    variable "vm_map" {
      type = map(object({
        vmid    = number
        ip      = string
        memory  = number
        cores   = number
      }))
    }
    
    resource "proxmox_vm_qemu" "node" {
      for_each    = var.vm_map
      name        = each.key
      target_node = var.target_node
      clone       = var.template_name
      vmid        = each.value.vmid
    
      cores   = each.value.cores
      sockets = 1
      memory  = each.value.memory
      agent   = 1
      onboot  = true
    
      os_type  = "cloud-init"
      bootdisk = "scsi0"
      scsihw   = "virtio-scsi-pci"
    
      disk {
        slot    = "scsi0"
        size    = "20G"
        type    = "disk"
        storage = "local-lvm"
      }
    
      network {
        model  = "virtio"
        bridge = "vmbr0"
      }
    
      ipconfig0 = "ip=${each.value.ip},gw=${var.vm_gateway}"
      ciuser    = "ubuntu"
      sshkeys   = var.ssh_public_key
    }

    이렇게 해두면 노드 이름과 IP를 맵으로 받아서 여러 대를 한 번에 만들 수 있습니다. 쿠버네티스 실습 클러스터 같은 데서 정말 유용합니다. 다음 글에서는 이 구성을 기반으로 Ansible(앤서블, 구성 자동화 도구)까지 연결하는 흐름도 다룰 예정입니다.

    ⚠️ 실제로 자주 만나는 문제와 해결법

    여기는 경험담 비중이 큽니다. 문서만 보면 금방 될 것 같았는데, 막상 해보면 안 되는 포인트가 몇 군데 있습니다.

    1. Cloud-Init이 적용되지 않는 문제

    증상은 이렇습니다. VM은 생성됐는데 호스트명, 사용자, SSH 키, IP가 안 들어갑니다. 보통 원인은 아래 중 하나였습니다.

    • 템플릿 자체가 Cloud-Init 준비가 안 되어 있음
    • 게스트 OS 내부 패키지 누락
    • 네트워크 인터페이스 이름이 템플릿 예상과 다름
    • 템플릿 변환 전에 초기화가 덜 끝남

    해결 팁: 템플릿에서 먼저 수동 부팅 테스트를 해보세요. SSH 키 주입과 네트워크가 정상 반영되는지 검증한 뒤 템플릿으로 바꾸는 게 낫습니다. 저도 이걸 건너뛰었다가 Terraform 탓인 줄 알고 한참 돌았었습니다.

    2. VM ID 충돌

    Proxmox는 VM ID가 겹치면 당연히 실패합니다. 작은 랩에서는 사람이 관리 가능하지만, 자동화가 늘어나면 금방 꼬입니다. 이럴 땐 ID 정책을 아예 정해두는 게 좋습니다. 예를 들어 200번대는 앱 서버, 300번대는 쿠버네티스 노드처럼요.

    3. 스토리지 이름과 디스크 타입 불일치

    문서 예제 그대로 복사했는데 안 되는 경우가 많습니다. 이유는 환경마다 스토리지 이름이 다르기 때문입니다. local-lvm, local, ZFS 풀 이름 등이 제각각이거든요. 여기서 중요한 포인트! 예제 코드는 참고용이고, 실제 환경 값은 Proxmox UI에서 다시 확인하셔야 합니다.

    4. 권한 부족 또는 API 토큰 범위 문제

    API Token을 만들었는데도 생성이 안 되는 경우가 있습니다. 이건 대개 토큰 자체보다 연결된 사용자 권한 범위 문제였습니다. 특히 특정 노드나 특정 스토리지에 대한 권한이 빠져 있으면 묘하게 일부만 되고 일부는 안 되는 식으로 보이더라고요.

    5. 병렬 생성 시 타이밍 이슈

    여러 대를 한 번에 만들면 템플릿 clone 이후 디스크나 네트워크 상태 반영이 느려서 간헐 실패하는 경우가 있습니다. 홈랩 장비 성능이 여유롭지 않으면 더 잘 보입니다. 이런 경우는 한 번에 너무 많이 생성하지 말고, 상태를 확인하면서 배치 크기를 조절하는 게 현실적이었습니다.

    검증: 프로비저닝 결과는 어떻게 확인하나

    자동화는 “생성됐다”보다 “원하는 상태로 생성됐다”가 중요합니다. 그래서 저는 적용 후 아래 순서로 꼭 확인합니다.

    1. Terraform state에 리소스가 정상 반영됐는지 확인
    2. Proxmox UI에서 VM 스펙과 노드 배치 확인
    3. IP 할당과 부팅 상태 확인
    4. SSH 접속 확인
    5. qemu-guest-agent 정보 반영 여부 확인
    terraform state list
    terraform show
    ssh [email protected]
    ping -c 3 192.168.10.51

    여기서 SSH 접속까지 되면 거의 끝난 겁니다. 실제로 써보니까 가장 기분 좋은 순간이 이때예요. 코드 한 번 실행했을 뿐인데 VM이 살아 있고, 네트워크도 붙고, 키 인증도 바로 되는 걸 보면 자동화 체감이 확 옵니다. 🎉

    Terraform Proxmox provider 적용 후 VM 생성 결과 이미지

    Terraform 적용 후 여러 VM이 정상 생성되고 실행 중인 결과를 시각적으로 보여주는 이미지입니다.

    결과 해석 포인트

    • Created만 보지 말고 실제 접속 가능 여부까지 확인합니다.
    • State drift(상태 드리프트, 코드와 실제 상태 불일치)가 없는지 주기적으로 봅니다.
    • 운영 전이라면 destroy까지 테스트해보는 게 좋습니다.

    이 마지막 포인트가 은근 중요합니다. 생성은 잘 되는데 삭제가 깔끔하지 않으면 나중에 리소스 찌꺼기가 남습니다. 홈랩은 그래도 괜찮은데, 운영성 테스트에서는 꼭 확인해보셔야 합니다.

    정리: Terraform Proxmox provider를 잘 쓰려면

    이번 내용을 한 줄로 요약하면 이렇습니다. Terraform Proxmox provider의 핵심은 템플릿 품질, 변수 설계, 검증 습관입니다. 도구 자체는 어렵지 않은데, 환경 차이 때문에 사소한 설정명이 계속 발목을 잡습니다. 저도 처음엔 “왜 문서대로 했는데 안 되지?”를 몇 번 겪었고, 결국 문제의 대부분은 템플릿 준비 부족이나 환경별 값 차이에서 나오더라고요.

    그래도 한 번 구조를 잡아두면 Proxmox VM 자동화는 정말 강력합니다. 테스트 서버를 빠르게 띄우고, 실습 클러스터를 반복 재현하고, IaC Proxmox 방식으로 변경 이력을 남길 수 있습니다. 사람이 기억하던 인프라를 코드가 기억하게 되는 거죠. 여기서부터 운영 수준이 확 달라집니다.

    실전 체크리스트

    • 템플릿 VM이 Cloud-Init 준비가 됐는지 확인
    • API Token 권한 범위를 최소 필요 수준으로 설계
    • 스토리지, 브리지, 노드 이름을 실제 환경 값으로 검증
    • VM ID 정책을 미리 정리
    • terraform plan 결과를 습관적으로 검토
    • 생성 후 SSH와 네트워크까지 확인

    자주 묻는 질문

    Q1. Terraform Proxmox provider만으로 모든 운영 자동화가 끝나나요?

    아닙니다. 보통은 VM 생성까지 Terraform이 맡고, 내부 패키지 설치나 서비스 배포는 Ansible 같은 도구와 함께 쓰는 경우가 많습니다.

    Q2. 운영 환경에서도 바로 써도 되나요?

    가능은 하지만, 홈랩 예제를 그대로 가져가면 안 됩니다. 인증서 검증, 권한 분리, 스토리지 정책, 백업 정책, 삭제 절차를 먼저 정리하셔야 합니다.

    Q3. 단일 VM보다 여러 대 자동화에서 더 효과가 큰가요?

    네, 효과 차이가 큽니다. 한 대만 만들면 수동도 가능하지만, 3대 이상 반복되면 프로비저닝 자동화 가치가 바로 보입니다.

    IaC Proxmox와 수동 VM 생성 비교 인포그래픽

    수동 작업과 Terraform 기반 IaC Proxmox 자동화의 차이를 한눈에 정리한 비교 이미지입니다.

    이전 글에서 다뤘던 네트워크 브리지 설계나 템플릿 표준화 내용을 함께 보시면 더 이해가 빠르실 겁니다. 다음 글에서는 이 구성을 바탕으로 멀티 VM 배포 뒤 Ansible로 후속 설정까지 이어붙이는 흐름을 정리해보겠습니다. 혹시 지금 Proxmox 환경에서 VM을 반복 생성하고 계신다면, 이번 기회에 정말 한 번 코드로 바꿔보세요. 처음엔 조금 귀찮아도, 나중엔 수동 클릭으로 돌아가기 어렵습니다. ✅
  • [Game] 2026년 중급 게이밍 GPU 벤치마크: RTX 4060 vs RX 7600 가성비 비교

    [Game] 2026년 중급 게이밍 GPU 벤치마크: RTX 4060 vs RX 7600 가성비 비교

    2026년 중급 게이밍 GPU 벤치마크: RTX 4060 vs RX 7600, 가성비 그래픽카드 승자는?

    중급 게이밍 GPU 벤치마크를 찾는 분들이 가장 많이 고민하는 조합이 바로 RTX 4060과 RX 7600입니다. 둘 다 1080p 게이밍에서는 충분히 제 몫을 하는 카드인데, 막상 하나를 고르려면 생각보다 애매하거든요. 저도 처음엔 스펙표만 보고 “이 정도면 답 나온 거 아닌가?” 싶었는데, 실제로 테스트하고 프레임 타임(frame time, 프레임 간 표시 시간)까지 보니까 얘기가 완전히 달라지더라고요. 특히 그래픽카드 성능은 평균 FPS만 보면 놓치는 부분이 정말 많아서, 벤치마크 방식부터 제대로 잡는 게 중요했습니다.

    이 글에서는 과장된 숫자 놀음보다, 제가 실제로 비교할 때 쓰는 기준을 바탕으로 가성비 그래픽카드 관점에서 어떤 사용자가 어떤 카드를 고르면 덜 후회하는지 정리해보겠습니다. 확실하지 않은 수치는 빼고, 널리 알려진 특성과 실사용 판단 기준 위주로 진행합니다.
    중급 게이밍 GPU 벤치마크 개요를 보여주는 RTX 4060과 RX 7600 비교 이미지

    중급 게이밍 GPU 벤치마크의 전체 비교 흐름을 한눈에 보여주는 개요 이미지입니다.

    1. 왜 RTX 4060 vs RX 7600 비교가 계속 나올까

    간단합니다. 이 두 제품은 중급 메인스트림(mainstream, 대중형) 시장에서 자주 맞붙는 카드이기 때문입니다. 둘 다 “최고 성능”을 노리는 제품은 아니고, 1080p 게이밍에서 옵션을 적절히 조절하면서 오래 쓰려는 사용자에게 많이 들어갑니다. 그래서 비교 포인트도 명확하더라고요.

    • 순수 래스터(raster, 일반 렌더링) 성능이 더 중요한가
    • 레이 트레이싱(ray tracing, 광선 추적)을 쓸 생각이 있는가
    • 업스케일링(upscaling, 해상도 보정)과 프레임 생성(frame generation) 기능을 얼마나 활용할 건가
    • 전력, 발열, 소음까지 포함한 시스템 완성도를 보는가

    여기서 핵심! 벤치마크는 카드 하나만 보는 게 아니라, 사용 시나리오를 함께 봐야 합니다. 같은 카드라도 e스포츠 위주인지, AAA 싱글 게임 위주인지, 방송 송출까지 할 건지에 따라 체감이 완전히 달라지거든요.

    2. 핵심 개념 설명: 평균 FPS보다 중요한 것

    벤치마크를 볼 때 대부분 평균 FPS만 먼저 보시는데요, 저는 1% low와 frame time을 훨씬 더 중요하게 봅니다. 평균 프레임이 비슷해도 끊김이 느껴지는 이유가 여기 숨어 있는 경우가 많았거든요. 저도 처음엔 “분명 숫자는 괜찮은데 왜 버벅이지?” 하며 삽질을 꽤 했습니다 ㅎㅎ

    평균 FPS, 1% low, frame time 차이

    지표 뜻 실사용에서 느껴지는 부분
    평균 FPS 전체 프레임의 평균값 대략적인 성능 수준
    1% low 하위 1% 구간 프레임 순간 끊김, 급락 체감
    Frame Time 프레임 간 표시 시간 화면이 매끈한지, 울컥거리는지

    그리고 1080p 게이밍에서는 CPU 병목(bottleneck, 특정 부품이 발목 잡는 현상)이 꽤 잘 드러납니다. 반대로 1440p 게이밍으로 올라가면 GPU 부담이 커져서 카드 자체 차이가 더 선명하게 보이기도 하고요. 이래서 해상도별로 결과를 따로 보는 습관이 중요합니다.

    3. 제품 성향부터 정리해보면

    정확한 수치 대신, 널리 알려진 방향성만 놓고 보면 이렇습니다. 실제로 써보니까 이 정도 프레임워크를 머릿속에 넣고 비교하면 판단이 훨씬 빨라집니다.

    항목 RTX 4060 RX 7600
    기본 포지션 NVIDIA 메인스트림 게이밍 카드 AMD 메인스트림 게이밍 카드
    메모리(VRAM) 6GB/8GB 8GB/16GB
    래스터 성향 게임별 편차 있음 가격이 맞으면 경쟁력 있음
    레이 트레이싱 상대적으로 유리한 편 가능하지만 부담이 더 큼
    업스케일링 DLSS 지원이 강점 FSR 활용 폭이 넓음
    인코딩/스트리밍 NVENC 선호 사용자 많음 기능은 충분하나 선호도 차이 있음
    전력 효율 좋다는 평가가 많음 모델별 쿨링 편차 확인 필요

    한 줄로 줄이면, 레이 트레이싱과 생태계를 중시하면 RTX 4060 쪽으로 기울고, 순수 게임 성능 대비 가격을 더 따지면 RX 7600이 자주 후보로 올라옵니다. 다만 이건 어디까지나 출발점이에요. 최종 결정은 실제 벤치마크 조건과 시장 가격이 좌우하더라고요.

    4. 실전 벤치마크 구성: 제가 비교할 때 맞추는 기준

    벤치마크는 환경 통제가 반입니다. 여기서 대충 하면 결과가 계속 흔들립니다. 저는 아래 순서로 맞춥니다.

    1. 같은 CPU, 같은 메모리 용량, 같은 저장장치 조건으로 맞춥니다.
    2. 드라이버(driver, 하드웨어 제어 소프트웨어)는 최신 안정판 계열로 통일합니다.
    3. 전원 관리 옵션은 고성능으로 맞추고 백그라운드 작업을 최소화합니다.
    4. 해상도는 1080p와 1440p를 나눠 보고, 옵션 프리셋은 Medium/High 중심으로 고정합니다.
    5. 업스케일링과 레이 트레이싱은 끈 상태, 켠 상태를 분리해서 기록합니다.
    중급 게이밍 GPU 벤치마크 테스트 세팅과 1080p 게이밍 환경 이미지

    실제 비교 테스트를 준비하는 과정과 측정 환경 구성을 보여주는 이미지입니다.

    벤치마크용 게임은 가능하면 성격이 다른 장르를 섞는 게 좋습니다.

    • e스포츠 계열: 높은 프레임 유지력 확인
    • 오픈월드 계열: VRAM 압박과 프레임 타임 확인
    • 레이 트레이싱 지원 게임: 기능 활용 시 손해 폭 확인
    • 내장 벤치마크가 있는 게임: 반복 측정 편의성 확보

    측정 예시 명령어

    저는 프레임 타임 기록용으로 PresentMon 같은 툴을 자주 쓰는데요, 아래가 예시입니다.

    presentmon.exe -process_name Cyberpunk2077.exe -timed 120 -output_file cp2077_1080p_high.csv
    presentmon.exe -process_name ForzaHorizon5.exe -timed 120 -output_file fh5_1440p_high.csv
    presentmon.exe -process_name HogwartsLegacy.exe -timed 120 -output_file hogwarts_rt_on.csv

    결과 파일은 게임별, 해상도별로 폴더를 나눠두면 나중에 정말 편합니다.

    mkdir benchmark-results
    mkdir benchmark-results\1080p
    mkdir benchmark-results\1440p

    이렇게 정리해두면 재측정할 때 헷갈릴 일이 훨씬 줄어듭니다. 별 거 아닌데, 벤치마크는 정리 습관이 성능만큼 중요하더라고요.

    5. RTX 4060 vs RX 7600, 실사용 기준으로 보면

    여기부터가 대부분 궁금해하는 부분일 겁니다. 제가 직접 비교할 때 체감 포인트는 대체로 이렇습니다.

    1080p 게이밍

    1080p 게이밍에서는 두 카드 모두 충분히 현실적인 선택입니다. 다만 CPU 영향을 많이 받는 게임에서는 그래픽카드 차이가 생각보다 덜 벌어질 수 있어요. 그래서 평균 FPS만 보면 비슷해 보여도, 옵션을 조금 더 올리거나 장시간 플레이를 하면 프레임 타임 안정성이 느낌을 완전히 바꾸는 경우가 있었습니다.

    1440p 게이밍

    1440p 게이밍으로 올라가면 둘 다 “완전 여유롭다”보다는 설정 타협이 필요한 구간으로 들어갑니다. 특히 최신 AAA 타이틀에서는 8GB VRAM 한계가 빨리 보일 수 있어서, 텍스처 옵션을 무작정 높이기보다 전체 균형을 봐야 합니다. 처음엔 해상도만 올리면 될 줄 알았는데, 실제로 써보니까 텍스처와 그림자 설정이 발목을 잡는 경우가 꽤 많더라고요.

    레이 트레이싱과 업스케일링

    이 부분은 비교적 방향이 분명합니다. 레이 트레이싱을 적극적으로 쓰고 싶다면 RTX 4060 쪽이 더 편한 경우가 많고, DLSS 지원 게임에서는 체감 메리트가 분명합니다. 반면 RX 7600은 래스터 중심으로 접근했을 때 납득되는 선택이 되는 경우가 많아요. 결국 “무슨 기능을 얼마나 쓸 건가”가 핵심입니다.

    6. ⚠️ 주의사항과 트러블슈팅

    벤치마크하다 보면 의외로 GPU보다 설정 실수가 더 큰 변수일 때가 많습니다. 저도 아래 문제를 자주 겪었어요.

    • 백그라운드 앱 개입: 업데이트, 런처, 브라우저 탭 때문에 결과가 흔들립니다.
    • 드라이버 잔재: 카드 교체 후 이전 드라이버 설정이 남아 결과를 어지럽힐 수 있습니다.
    • 업스케일링 자동 적용: 게임마다 기본값이 달라서 순정 비교가 깨질 수 있습니다.
    • 전력 제한 또는 온도 제한: 작은 케이스에서는 성능 유지력이 달라집니다.

    ⚠️ 특히 중요한 부분은, 비교할 때 옵션 이름만 같다고 같은 품질이 아니라는 거예요. 제조사별로 드라이버 최적화도 다르고, 게임마다 품질 프리셋 내부 구성이 달라서 단순 숫자 비교가 왜곡될 수 있거든요.

    제가 쓰는 점검 순서는 이렇습니다.

    1. 해상도와 렌더 스케일(render scale)을 먼저 확인합니다.
    2. 레이 트레이싱, 프레임 생성, 업스케일링 상태를 캡처해 둡니다.
    3. 최소 3회 반복 측정 후 이상치(outlier)를 제외합니다.
    4. 평균 FPS보다 1% low와 프레임 타임 그래프를 먼저 봅니다.
    그래픽카드 성능 분석을 위한 중급 게이밍 GPU 벤치마크 결과 대시보드 이미지

    측정 결과를 분석하면서 평균 FPS와 프레임 타임을 함께 보는 장면입니다.

    7. 검증 결과를 어떻게 읽어야 하나

    수치만 딱 잘라 말하는 글은 시원하긴 한데, 실제 구매 결정에는 오히려 함정이 많습니다. 그래서 저는 결과를 아래처럼 해석합니다.

    사용 패턴 더 잘 맞는 선택 이유
    1080p e스포츠 위주 둘 다 가능 CPU와 게임 최적화 영향이 큼
    1080p AAA 위주 가격 조건 따라 갈림 래스터 성능과 기능 활용도 차이
    1440p 입문 옵션 타협 전제 필요 두 카드 모두 VRAM 8GB 구간 고려
    RT 자주 사용 RTX 4060 쪽이 유리한 편 RT와 DLSS 활용 체감
    순수 가성비 우선 RX 7600이 자주 후보 실구매가가 중요
    방송/인코딩 병행 RTX 4060 선호 사례 많음 NVENC 생태계 선호도

    정리하면, 가성비 그래픽카드의 승자는 절대적인 한 장이 아니라 내가 무엇을 중요하게 보느냐에 따라 갈립니다. 이게 좀 재미없는 답처럼 들릴 수 있는데, 실제로는 가장 현실적인 결론입니다. 벤치마크 표만 보고 사면 나중에 “내가 필요한 기능은 이게 아니었네” 하는 경우가 꽤 많거든요.

    8. 자주 묻는 질문과 최종 결론

    FAQ

    • Q. 2026년에도 RTX 4060과 RX 7600 비교가 의미 있나요?
      네. 신제품이 나오더라도 중고, 재고, 시장 가격 관점에서는 여전히 많이 비교되는 조합입니다.
    • Q. 8GB VRAM이면 부족한가요?
      게임과 옵션에 따라 다릅니다. 1080p에서는 아직 운영 가능하지만, 1440p와 고해상도 텍스처에서는 제약이 빨리 보일 수 있어요.
    • Q. 벤치마크에서 가장 먼저 볼 숫자는 뭔가요?
      평균 FPS보다 1% low와 frame time을 함께 보시길 추천합니다.

    제 결론은 이렇습니다. RTX 4060은 레이 트레이싱, DLSS, 전력 효율, 스트리밍 생태계를 함께 보는 분에게 잘 맞습니다. 반대로 RX 7600은 순수 게임 성능과 실구매가 조건이 맞아떨어질 때 꽤 설득력 있는 선택이 돼요. 둘 중 누가 무조건 이긴다기보다, 중급 게이밍 GPU 벤치마크를 읽을 때 어떤 항목을 내 기준으로 재해석하느냐가 더 중요합니다.

    혹시 지금 업그레이드를 고민 중이시라면, 다음 글에서는 CPU 병목 구간 확인하는 법과 업스케일링 세팅 최적화를 따로 정리해보겠습니다. 이전 글에서 다룬 쿨링과 전원 세팅 내용도 함께 보시면 판단이 훨씬 쉬워질 겁니다. 🎉
    가성비 그래픽카드 비교를 위한 RTX 4060과 RX 7600 요약 인포그래픽

    구매 판단에 필요한 핵심 포인트만 압축한 요약 비교 이미지입니다.

  • [Nas] Active Backup for Business vs Synology Active Backup: 백업 솔루션 비용 및 성능 비교

    [Nas] Active Backup for Business vs Synology Active Backup: 백업 솔루션 비용 및 성능 비교

    [백업] Active Backup for Business vs Synology Active Backup 비용 및 성능 비교

    백업 설계를 하다 보면 검색창에 Active Backup for Business vs Synology Active Backup라고 쳐보신 적 있으실 겁니다. 저도 처음엔 이게 뭔가 싶었거든요. 이름이 너무 비슷해서요. 실제로 현업이나 홈랩에서 많이 헷갈리는 포인트가 하나 있는데, Active Backup for Business(ABB)는 Synology가 제공하는 백업 제품군 안의 대표 솔루션이고, 사람들이 말하는 Synology Active Backup은 종종 Synology 백업 생태계 전체를 뭉뚱그려 부르는 표현이더라고요.

    그래서 이번 글은 단순히 이름만 비교하지 않고, 비용 비교와 성능 테스트 관점에서 실제로 어떻게 접근하면 되는지 정리해보겠습니다. 특히 PC, 물리 서버, 가상머신(VM), 그리고 NAS 백업까지 같이 고민하시는 분들께 도움이 될 겁니다. 제가 직접 홈랩에서 구성해보니, 제품 이름보다 더 중요한 건 무엇을 어디까지 보호할 것인지였습니다. 여기서 설계가 갈리거든요.
    여기서는 ABB가 보호하는 대상과 NAS 백업 계층이 어떻게 분리되는지 한눈에 보이도록 아키텍처를 잡아두면 이해가 훨씬 쉬워집니다.

    1. 먼저 짚고 가야 할 개념: 무엇을 비교하는가

    쉽게 말해 Active Backup for Business는 워크로드 백업 엔진입니다. 즉, Windows PC, 물리 서버, 파일 서버, VMware, Hyper-V 같은 대상을 중앙에서 백업하는 역할에 가깝습니다. 반면 많은 분들이 말하는 Synology Active Backup은 실제 운영에서는 ABB에 더해 Hyper Backup(하이퍼 백업), Snapshot Replication(스냅샷 복제) 같은 기능까지 포함한 Synology 기반 백업 운영 방식을 뜻하는 경우가 많습니다.

    이 차이를 모르고 비교하면 결론이 이상해집니다. ABB는 1차 백업 수집에 강하고, Synology 전체 백업 스택은 2차 보호, 오프사이트(off-site, 외부 위치 보관), NAS 백업까지 포함한 설계에 강합니다. 결국 비교 질문은 이렇게 바꾸는 게 맞습니다.

    • 질문 A: 여러 엔드포인트와 서버를 한 번에 백업하려면 ABB가 적합한가?
    • 질문 B: NAS 자체까지 안전하게 보호하려면 Synology의 다른 백업 기능을 함께 써야 하는가?
    • 질문 C: 비용은 라이선스보다 저장소와 운영 복잡도에서 갈리는가?

    제가 실제로 써보니까, 이 세 가지를 분리해서 보니 판단이 훨씬 쉬워지더라고요.

    2. 비용 비교: 라이선스보다 저장소 설계가 더 큽니다

    Active Backup for Business vs Synology Active Backup 비교에서 많은 분이 먼저 묻는 게 가격입니다. 그런데 여기서 중요한 포인트! Synology 생태계는 외부 상용 백업 제품처럼 대상 수 기준 라이선스 비용을 크게 체감하는 구조와는 결이 좀 다릅니다. 실제 체감 비용은 보통 아래 항목에서 갈립니다.

    1. Synology NAS 본체 비용
    2. 백업 저장소로 쓸 HDD/SSD 용량
    3. 백업 보관 주기(retention, 보존 정책)
    4. 원격지 복제를 위한 추가 NAS 또는 클라우드 비용
    5. 복구 시간을 줄이기 위한 네트워크 업그레이드 비용
    비교 항목 Active Backup for Business 중심 Synology 백업 스택 전체 관점
    주요 목적 PC, 서버, VM 중앙 백업 백업본 2차 보호, NAS 백업, 복제
    직접 체감 비용 NAS와 저장소 용량 추가 NAS, 외부 저장소, 네트워크
    운영 복잡도 상대적으로 단순 정책 설계에 따라 높아짐
    복구 범위 엔드포인트/서버 복구에 강함 백업 저장소 자체 보호까지 확장 가능
    추천 상황 사내 서버/PC 통합 백업 3-2-1 백업 전략까지 구현

    현업에서는 이렇습니다. 백업 솔루션 자체가 공짜처럼 느껴져도, 보관 주기를 길게 잡는 순간 디스크 사용량이 꽤 빨리 늘어납니다. 특히 가상머신 이미지나 파일 서버 증분(incremental, 변경분) 백업이 누적되면 생각보다 저장소 압박이 큽니다. 저도 처음엔 “어? 라이선스 부담이 적네” 하고 가볍게 봤다가, 디스크 계획을 보수적으로 안 잡아서 다시 증설했었습니다. 삽질 좀 했습니다 ㅎㅎ

    비용을 볼 때 꼭 같이 체크할 항목

    • 중복 제거(deduplication, 중복 데이터 제거) 체감 효과가 워크로드별로 다릅니다.
    • VM 백업이 많으면 CPU, 메모리, 스토리지 IOPS까지 같이 봐야 합니다.
    • NAS 백업을 원격지까지 보내면 회선 대역폭과 스케줄 정책도 사실상 비용입니다.

    3. 성능 테스트는 어떻게 봐야 하나: 숫자보다 병목 지점을 먼저 봅니다

    성능 테스트 이야기가 나오면 다들 처리량 숫자부터 찾으시는데요, 사실 백업은 단일 벤치마크 숫자 하나로 비교하기가 어렵습니다. 왜냐하면 병목이 너무 명확하게 갈리거든요.

    • 소스 서버 디스크 읽기 성능
    • 네트워크 대역폭
    • NAS의 쓰기 성능
    • 압축/암호화 시 CPU 사용률
    • 동시 작업 개수(concurrency, 동시 실행 수)

    제가 직접 해보니 동일한 NAS라도 작은 파일이 많은 파일 서버 백업과, 큰 VMDK/VHDX 파일 위주의 VM 백업은 체감 성능이 완전히 다르더라고요. 그래서 Active Backup for Business vs Synology Active Backup를 성능으로 비교할 때는 “어떤 데이터를, 몇 대를, 어느 시간대에” 백업할지가 먼저입니다.

    실무 기준으로 보는 성능 체크 포인트

    1. 초기 전체 백업(full backup, 전체 백업) 시간
    2. 증분 백업 시간과 백업 창(window, 허용 시간대)
    3. 복구 속도, 특히 단일 파일 복구와 전체 시스템 복구 차이
    4. 여러 작업 동시 실행 시 NAS CPU/메모리 여유
    5. 백업 후 무결성 검증 시간

    이 기준으로 보면 ABB는 중앙 집중형 관리가 강점입니다. 반대로 Synology 전체 백업 전략은 성능 자체보다 복원력(resilience, 장애 대응력)을 얻는 방향이라고 보는 게 맞습니다.

    Active Backup for Business vs Synology Active Backup 설정 흐름 이미지

    실전에서는 백업 대상 등록, 스케줄링, 보존 정책, 복구 포인트 관리가 어떻게 이어지는지 흐름으로 보는 게 이해가 빠릅니다.

    4. 실전 구현: 홈랩에서 검증하는 백업 솔루션 구성 절차

    이제 실제로 어떻게 검증할지 보겠습니다. 여기서는 “ABB로 워크로드를 모으고, NAS 백업은 별도 계층으로 보호한다”는 방식으로 설명드릴게요. 이 구성이 제일 현실적이었습니다.
    4-1. 준비 체크리스트

    • Synology NAS와 충분한 저장소 풀(storage pool, 저장소 묶음)
    • 백업 대상: Windows PC, 물리 서버, VMware 또는 Hyper-V 중 하나 이상
    • 관리 네트워크와 백업 네트워크 분리 여부 확인
    • 원격지 백업이 필요하다면 추가 NAS 또는 외부 대상

    4-2. SSH로 NAS 상태 확인

    백업 전에 NAS가 버틸 수 있는지부터 봐야 합니다. CPU, 메모리, 디스크 상태를 먼저 확인해두면 나중에 성능 병목을 추적하기 쉽습니다.

    ssh admin@your-nas
    uname -a
    cat /proc/cpuinfo | head
    free -h
    df -h
    cat /proc/loadavg

    이 단계는 별거 아닌 것 같아도 중요합니다. 저도 처음엔 백업 정책만 만지다가, 실제 병목이 NAS 메모리 부족이었던 적이 있거든요.

    4-3. 네트워크 대역폭 점검

    백업 속도가 안 나오면 일단 회선부터 의심하는 게 맞습니다. ABB든 다른 NAS 백업 방식이든 네트워크가 받쳐주지 않으면 숫자가 안 나옵니다.

    iperf3 -s
    iperf3 -c NAS_IP -t 30

    가능하면 백업 시간대와 비슷한 조건에서 테스트해보세요. 업무 시간과 야간은 트래픽 패턴이 다르거든요.

    4-4. 대용량 파일 기준의 저장소 쓰기 테스트

    이건 엄밀한 제품 벤치마크는 아니지만, 백업 저장소 체감 성능을 확인하는 데 꽤 유용합니다.

    dd if=/dev/zero of=/volume1/test/backup-write-test.bin bs=1M count=4096 conv=fdatasync

    결과 숫자 하나만 보지 마시고, 테스트 중 DSM 자원 모니터(resource monitor, 자원 모니터)에서 CPU와 디스크 사용률을 같이 보셔야 합니다.

    4-5. 백업 대상별 작업 분리

    운영 경험상 가장 깔끔했던 방식은 작업을 이렇게 나누는 겁니다.

    1. PC와 노트북은 ABB 에이전트 기반 백업
    2. 파일 서버는 파일 단위 또는 서버 이미지 기준으로 분리
    3. VMware/Hyper-V는 별도 스케줄로 묶기
    4. 백업 저장소는 Hyper Backup 또는 스냅샷 계층으로 2차 보호

    이렇게 해야 장애 원인도 빨리 찾고, 복구 시나리오도 명확해집니다. 한 작업에 다 몰아넣으면 편해 보이는데, 나중에 복구할 때 오히려 꼬입니다.

    4-6. 보존 정책 예시

    backup_policy:
      endpoints:
        schedule: "daily"
        retention: "30 restore points"
      servers:
        schedule: "daily + weekly"
        retention: "4 weekly + 3 monthly"
      virtual_machines:
        schedule: "nightly"
        retention: "short-term frequent + long-term monthly"
      repository_protection:
        method: "secondary backup or snapshot replication"
        schedule: "off-peak hours"

    이건 개념 예시입니다. 환경마다 다르지만, 핵심은 백업 대상 정책과 백업 저장소 보호 정책를 분리하는 겁니다.

    5. ⚠️ 실제 겪었던 문제와 트러블슈팅

    여기서부터가 진짜 중요합니다. 백업 솔루션은 설치보다 운영에서 차이가 나거든요.

    문제 1. 초기 전체 백업이 너무 오래 걸리는 경우

    처음엔 이게 제품 성능 문제인 줄 알았습니다. 근데 실제로는 대부분 아래 셋 중 하나였습니다.

    • 소스 서버 디스크 읽기 속도 한계
    • 야간에도 공유 스토리지 사용량이 높음
    • 1GbE 네트워크 포화

    해결: 초기 풀백업은 주말이나 유휴 시간대로 분리하고, 가능하면 대상을 나눠 순차 배치하는 게 낫습니다.

    문제 2. 작은 파일이 많은 파일 서버 백업이 느린 경우

    이건 꽤 자주 봅니다. 대용량 단일 파일보다 메타데이터 처리 부담이 커서 체감 속도가 떨어집니다.

    해결: 데이터 구조를 먼저 보고, 아카이브 가능한 영역은 묶어서 관리하는 게 효과적이었습니다.

    문제 3. NAS 백업까지 한 번에 해결하려다 설계가 꼬이는 경우

    여기서 많이들 헷갈립니다. ABB는 아주 좋은 1차 백업 도구인데, NAS 자체의 장애나 랜섬웨어 대응까지 한 번에 끝내려 하면 설계가 복잡해집니다.

    해결: ABB는 수집 계층, Hyper Backup이나 Snapshot Replication은 저장소 보호 계층으로 역할을 분리하세요. 이게 운영 난이도를 확실히 낮춥니다.

    문제 4. 복구 테스트를 안 해서 막상 사고 때 당황하는 경우

    백업은 성공 로그보다 복구 테스트(restore test, 복원 검증)가 더 중요합니다. 저도 예전에 백업은 잘 도는데 실제 복원 절차가 어색해서 당황한 적이 있었습니다. 드디어 됐다! 싶었던 건, 정기 복구 리허설을 돌리기 시작한 뒤였어요.

    Active Backup for Business vs Synology Active Backup 성능 테스트 대시보드 이미지

    성능 비교는 단일 수치보다 CPU, 메모리, 네트워크, 작업 성공률을 같이 보는 대시보드 형태가 훨씬 실용적입니다.

    6. 검증 결과는 어떻게 읽어야 하나

    제가 권장하는 검증 기준은 아주 단순합니다. 제품 소개 문구보다 아래 질문에 답이 되면 됩니다.

    1. 백업 창 안에 끝나는가?
    2. 증분 백업이 업무에 영향 없이 도는가?
    3. 파일 단위와 시스템 단위 복구가 모두 가능한가?
    4. 백업 저장소 자체도 다시 보호되고 있는가?

    이 관점에서 보면 Active Backup for Business vs Synology Active Backup 비교의 결론은 생각보다 명확합니다.

    • ABB는 운영 대상이 많은 환경에서 편합니다.
    • Synology 백업 스택 전체는 백업본까지 안전하게 지키는 설계에 강합니다.
    • 비용 차이는 소프트웨어 명칭보다 저장소 규모와 2차 보호 정책에서 벌어집니다.

    즉, “무엇이 더 빠르냐”보다 “어디까지 보호할 거냐”가 더 중요한 질문입니다. 이거 진짜 편하더라고요. 질문이 정확해지면 선택도 쉬워집니다.

    7. 정리: 어떤 환경에서 무엇을 고르면 되나

    혹시 이런 경험 있으신가요? PC 몇 대만 백업하면 될 줄 알았는데, 어느 순간 파일 서버, 가상머신, NAS 자체 백업까지 같이 고민하게 되는 상황이요. 딱 그 시점부터는 제품 하나만 보는 게 아니라 백업 아키텍처를 봐야 합니다.

    환경 우선 선택 추가로 고려할 것
    사무실 PC/서버 통합 백업 Active Backup for Business 보존 정책, 초기 백업 시간
    VM 중심 환경 ABB + 스케줄 분리 NAS CPU/메모리, 동시 작업 수
    NAS 백업까지 포함한 보호 ABB + Hyper Backup/스냅샷 전략 원격지 복제, 저장소 이중화
    랜섬웨어 대응 강화 복구 포인트 관리 + 저장소 분리 오프사이트 보관, 복구 리허설

    결론만 짧게 말씀드리면 이렇습니다. Active Backup for Business vs Synology Active Backup를 제품 대 제품으로 단순 비교하기보다, ABB는 워크로드 백업의 중심, Synology 백업 구성은 전체 보호 전략으로 이해하시면 됩니다. 저도 처음엔 이름 때문에 헷갈렸는데, 구조를 이렇게 나누고 나니 선택이 훨씬 쉬워졌습니다.

    다음 글에서는 Hyper Backup과 Snapshot Replication을 실제 운영 관점에서 어떻게 나눠 쓰는지, 그리고 NAS 백업을 3-2-1 전략으로 가져가는 방법을 다뤄볼 예정입니다. 이전 글에서 다룬 스토리지 풀 설계와 스냅샷 운용 팁도 같이 보시면 연결이 잘 되실 겁니다.

    Active Backup for Business vs Synology Active Backup 비교 인포그래픽 이미지

    마지막으로는 어떤 환경에서 ABB 단독으로 충분한지, 언제 추가 백업 계층이 필요한지 한 장으로 정리해두면 의사결정이 빨라집니다.

    8. 자주 묻는 질문 FAQ

    Q1. Synology Active Backup은 독립 제품인가요?

    공식 제품명을 이야기할 때는 Active Backup for Business처럼 개별 이름으로 보는 게 정확합니다. 검색에서는 Synology Active Backup이 넓은 의미로 쓰이는 경우가 많습니다.

    Q2. 비용 비교에서 가장 큰 변수는 뭔가요?

    대부분은 라이선스보다 저장소 용량, 보존 정책, 원격지 보호 구성입니다.

    Q3. 성능 테스트는 어떤 식으로 해야 하나요?

    초기 전체 백업 시간, 증분 백업 시간, 복구 속도, 동시 작업 시 자원 사용률을 함께 보세요. 단일 벤치마크 숫자만 보면 판단이 흔들립니다.

    Q4. NAS 백업은 ABB만으로 충분한가요?

    워크로드 백업 용도로는 유용하지만, NAS 자체 보호까지 생각하면 별도 보호 계층을 같이 설계하는 편이 안전합니다.

  • [Nas] rclone을 활용한 NAS-클라우드 백업, 치명적인 설정 실수와 복구 사례 연구

    [Nas] rclone을 활용한 NAS-클라우드 백업, 치명적인 설정 실수와 복구 사례 연구

    [백업] rclone NAS 백업, 치명적인 설정 실수와 복구 사례

    NAS를 오래 굴리다 보면 결국 한 번은 rclone NAS 백업을 진지하게 보게 됩니다. 저도 홈랩에서 사진, 문서, 설정 파일을 NAS에 몰아두고 쓰다가 어느 날 디스크 알림을 보고 식은땀이 나더라고요. 그래서 클라우드로 2차 백업을 붙였는데, 문제는 백업 도구보다 설정 방향이 더 무섭다는 점이었습니다. 특히 rclone은 강력한 만큼 실수했을 때 결과도 큽니다. 오늘은 제가 실제로 겪었던 클라우드 동기화 삽질과, 그 뒤에 어떻게 데이터 복구를 했는지 사례 중심으로 정리해보겠습니다.
    혹시 ‘백업 한 줄 알았는데 동기화가 삭제를 전파했다’ 같은 경험 있으신가요? 이 글은 그런 분들을 위해 쓰는 글입니다. 처음엔 저도 이게 뭔가 싶었는데, 구조를 이해하고 나니까 왜 사고가 났는지 보이더라고요.

    NAS와 클라우드 백업 전체 아키텍처 다이어그램

    NAS 원본 데이터, rclone 작업 경로, 클라우드 백업 저장소의 관계를 보여주는 개요 이미지입니다.

    1. 왜 rclone NAS 백업에서 사고가 자주 나는가

    rclone은 여러 스토리지 간 파일을 복사하고 동기화하는 CLI(Command Line Interface, 명령줄 인터페이스) 도구입니다. 쉽게 말해 NAS와 클라우드 사이에 짐을 옮기는 숙련된 기사님 같은 역할이죠. 문제는 기사님이 너무 성실해서, 제가 잘못 시키면 잘못된 작업도 아주 정확하게 해낸다는 겁니다 ㅎㅎ

    여기서 중요한 포인트는 두 가지입니다.

    • copy는 보통 원본을 대상에 복사합니다. 대상에 없는 파일을 채우는 쪽에 가깝습니다.
    • sync는 원본 상태를 대상에 맞춥니다. 즉, 원본에서 사라진 파일은 대상에서도 제거될 수 있습니다.
    백업 실패 사례 대부분은 성능 문제가 아니라, copy와 sync의 의미를 다르게 이해한 상태에서 운영에 넣는 것에서 시작하더라고요.
    2. rclone 설정 전에 꼭 알아야 할 핵심 개념

    2-1. Source(소스, 원본)와 Destination(대상지)의 방향

    rclone 명령은 항상 앞이 원본, 뒤가 대상입니다. 말로 들으면 쉬운데 실제로 새벽에 급하게 치다 보면 여기서 사고가 납니다. 저도 처음엔 경로만 맞으면 되겠지 싶었는데, 딱 여기서 한 번 크게 미끄러졌습니다.

    2-2. 동기화와 보관은 같은 말이 아닙니다

    항목 copy sync
    주요 목적 복사, 누락분 채우기 원본 상태와 동일화
    삭제 전파 위험 상대적으로 낮음 높음
    초기 백업 용도 적합 주의 필요
    운영 난이도 낮음 높음

    그래서 저는 요즘 초기 적재(initial seed, 첫 데이터 적재)에는 copy, 검증이 끝난 뒤 제한적으로만 sync를 씁니다.

    3. 실전 구성: 안전한 rclone NAS 백업 기본 뼈대

    제가 홈랩에서 많이 쓰는 방식은 단순합니다. NAS의 특정 공유 폴더를 클라우드 리모트(remote, 원격 저장소)에 백업하고, 삭제 파일은 바로 날리지 않고 별도 보관 폴더로 밀어넣는 구조입니다. 이게 조금 번거로워 보여도, 사고 한 번 막아주면 본전 뽑고도 남습니다.

    1. NAS에서 백업 대상 폴더를 분리합니다. 예: `/volume1/data`
    2. rclone 리모트를 생성합니다. 예: `cloudbackup:`
    3. 처음에는 반드시 `lsf`, `size`, `sync –dry-run`으로 확인합니다.
    4. 운영 전에는 `–backup-dir` 같은 안전장치를 붙입니다.

    아래는 실제로 제가 비슷한 방식으로 정리해두는 명령 예시입니다.

    rclone lsf cloudbackup:
    rclone size /volume1/data
    rclone size cloudbackup:nas-backup
    
    rclone sync /volume1/data cloudbackup:nas-backup \
      --dry-run \
      --progress \
      --checkers=8 \
      --transfers=4

    –dry-run은 진짜 중요합니다. 실행은 안 하고, 무슨 일이 벌어질지만 보여주거든요. 귀찮아도 이 단계는 건너뛰지 마세요.

    3-1. 운영용으로 조금 더 안전하게 만들기

    rclone sync /volume1/data cloudbackup:nas-backup \
      --progress \
      --log-file=/var/log/rclone-nas-backup.log \
      --log-level=INFO \
      --backup-dir=cloudbackup:nas-deleted/$(date +%F) \
      --check-first

    이 설정의 핵심은 삭제되거나 교체되는 파일을 바로 증발시키지 않고, backup-dir(백업 보관 디렉터리)로 보내는 것입니다. 완전한 스냅샷(snapshot, 시점 보관)은 아니지만, 실수 복구용 안전망으로 꽤 유용합니다.

    rclone 설정 흐름과 sync/copy 분기 다이어그램

    초기 copy, 검증, 운영 sync, backup-dir 적용까지 이어지는 안전한 설정 흐름을 설명하는 이미지입니다.

    4. 제가 실제로 겪은 치명적인 설정 실수

    이제 본론입니다. 어느 날 백업 정책을 손보다가 원래는 아래처럼 실행해야 했습니다.

    rclone sync /volume1/data cloudbackup:nas-backup

    그런데 실제로는 반대로 쳤습니다.

    rclone sync cloudbackup:nas-backup /volume1/data

    짧은 명령 한 줄인데 파괴력은 엄청났습니다. 클라우드 쪽이 일부만 올라가 있던 상태였거든요. 결과적으로 NAS 쪽이 클라우드 상태에 맞춰지면서 파일이 사라지기 시작했습니다. 처음엔 로그가 빨리 지나가서 몰랐는데, 폴더 개수가 줄어드는 걸 보고 그때 ‘아, 잘못됐다’ 싶더라고요. 진짜 등골이 서늘했습니다.

    이런 백업 실패 사례가 무서운 이유는, 사용자는 ‘백업 중’이라고 생각하지만 실제로는 ‘정리 작업’이 진행될 수 있다는 점입니다. 특히 자동화 스케줄러(cron, 작업 예약)에 등록해두면 반복 피해까지 생길 수 있습니다.

    4-1. 사고 직후 가장 먼저 한 일

    1. 실행 중인 rclone 작업을 즉시 중단했습니다.
    2. 자동 실행 스케줄을 비활성화했습니다.
    3. NAS 원본 경로에 추가 쓰기를 멈췄습니다.
    4. rclone 로그와 최근 삭제 파일 목록을 확보했습니다.

    여기서 중요한 건 당황해서 다시 sync를 돌리지 않는 것입니다. 덮어쓰기 한 번 더 들어가면 복구 범위가 더 줄어들 수 있거든요.

    5. 복구 과정: 데이터 복구는 어떻게 접근했나

    복구는 ‘뭘 믿을 수 있느냐’부터 따져야 합니다. 저는 아래 순서로 확인했습니다.

    1. 클라우드 저장소에 삭제 보관함이나 버전 관리 기능이 있는지 확인
    2. 이전 백업 로그와 파일 목록 비교
    3. 남아 있는 클라우드 데이터부터 읽기 전용으로 점검
    4. 복구 대상만 별도 경로에 copy

    예를 들어 클라우드 쪽에 아직 파일이 살아 있다면, 바로 원위치로 덮어쓰지 말고 임시 복구 폴더로 먼저 가져오는 게 안전합니다.

    mkdir -p /volume1/recovery-restore
    
    rclone copy cloudbackup:nas-backup /volume1/recovery-restore \
      --progress \
      --ignore-existing \
      --log-file=/var/log/rclone-recovery.log \
      --log-level=INFO

    그다음 NAS 원본과 임시 복구본을 비교했습니다.

    rclone check /volume1/recovery-restore /volume1/data \
      --one-way \
      --combined=/tmp/rclone-compare.txt

    이 단계가 좋았던 이유는, 복구를 바로 반영하지 않고 차이를 먼저 볼 수 있었기 때문입니다. 실제로 써보니까 조급함만 버려도 성공 확률이 올라가더라고요.

    만약 평소에 아래 같은 형태로 운영했다면 훨씬 쉬웠을 겁니다.

    rclone sync /volume1/data cloudbackup:nas-backup \
      --backup-dir=cloudbackup:nas-deleted/2026-06-29

    그러면 삭제되거나 바뀐 파일이 따로 남아 있어서, 필요한 것만 다시 복사하면 됩니다. 결국 복구 난이도는 사고 순간이 아니라 사고 전에 어떤 안전장치를 걸어뒀는가에서 갈리더라고요.

    6. 트러블슈팅: 다시는 같은 사고를 내지 않기 위한 rclone 설정

    • ⚠️ 운영 전 명령을 스크립트로 고정하고, 수동 타이핑을 줄입니다.
    • ⚠️ 첫 실행은 반드시 `–dry-run`과 `rclone lsf`로 방향을 확인합니다.
    • ⚠️ `sync`가 꼭 필요하지 않으면 `copy`부터 검토합니다.
    • ⚠️ 삭제 대응이 필요하면 `–backup-dir` 또는 저장소의 버전 관리 기능을 함께 씁니다.
    • 💡 로그 파일은 꼭 남기세요. 복구 때 생각보다 큰 힌트가 됩니다.

    제가 지금은 아예 아래처럼 래퍼 스크립트(wrapper script, 실행 감싸기 스크립트)를 써서 실수를 줄입니다.

    #!/usr/bin/env bash
    set -euo pipefail
    
    SRC='/volume1/data'
    DST='cloudbackup:nas-backup'
    STAMP=$(date +%F)
    
    rclone sync "$SRC" "$DST" \
      --dry-run \
      --progress \
      --backup-dir="cloudbackup:nas-deleted/$STAMP"

    처음엔 이 스크립트가 너무 보수적인가 싶었는데, 몇 번 운영해보니 이런 게 결국 사람을 살립니다.

    7. 검증과 결과: 백업은 성공 로그보다 복구 테스트가 더 중요합니다

    백업이 잘 됐는지는 파일 몇 개 올라간 걸로 판단하면 안 됩니다. 저는 최소한 아래 세 가지를 확인합니다.

    1. 원본과 대상의 파일 수, 용량 추세가 크게 어긋나지 않는지
    2. 샘플 파일을 실제로 복구했을 때 열리는지
    3. 삭제 시나리오에서 backup-dir 또는 버전 관리가 동작하는지
    rclone size /volume1/data
    rclone size cloudbackup:nas-backup
    rclone lsf cloudbackup:nas-deleted/$(date +%F) | head

    이 과정을 거치고 나서야 비로소 ‘백업이 있다’고 말할 수 있더라고요. 단순 복사는 끝났을지 몰라도, 데이터 복구가 검증되지 않으면 진짜 백업이라고 보기 어렵습니다.

    복구 검증 결과와 로그 확인 대시보드

    백업 로그, 파일 수 비교, 샘플 복구 성공 여부를 한눈에 확인하는 검증 화면 이미지입니다.

    8. 자주 묻는 질문과 정리

    8-1. copy만 써도 되나요?

    많은 경우 됩니다. 특히 초기 구축이나 보수적 운영에서는 오히려 더 안전합니다. sync는 강력하지만 삭제 전파 위험을 이해한 뒤 써야 합니다.

    8-2. 클라우드 동기화와 백업은 같은 말인가요?

    아닙니다. 클라우드 동기화는 상태를 맞추는 데 가깝고, 백업은 복원 가능성을 보장하는 데 더 가깝습니다. 이름은 비슷한데 목표가 다릅니다.

    8-3. 어떤 점이 가장 중요했나요?

    저는 세 가지였습니다. 첫째, 방향 확인. 둘째, 삭제 보관. 셋째, 복구 테스트. 이 세 개만 챙겨도 rclone 설정 사고 확률이 꽤 줄어듭니다.

    운영 전 점검해야 할 dry-run, backup-dir, 로그, 복구 테스트 항목을 요약한 체크리스트 이미지입니다.

    9. 마무리: rclone NAS 백업은 도구보다 운영 습관이 더 중요합니다

    rclone NAS 백업 자체는 정말 훌륭합니다. 저도 지금은 아주 만족하면서 쓰고 있습니다. 다만 이 도구는 친절한 GUI(Graphical User Interface, 그래픽 인터페이스)보다 명확한 명령에 충실한 타입이라, 운영자가 방향을 잘못 잡으면 그대로 따라갑니다. 저도 처음엔 헷갈렸고, 삽질 좀 했습니다 ㅎㅎ 그런데 그 덕분에 지금은 백업 설계를 할 때 무조건 복구 시나리오부터 생각하게 됐습니다.

    정리하면 이렇습니다. rclone NAS 백업을 할 때는 처음부터 sync를 믿고 달리지 말고, 작은 범위에서 dry-run으로 검증하고, 삭제 보관 장치를 켜고, 반드시 복구 테스트까지 해보세요. 이거 진짜 편하더라고요. 다음 글에서는 `rclone mount`와 미디어 아카이브 운영 팁도 다뤄볼 예정입니다. 이전 글에서 다룬 스냅샷 백업 전략과 함께 보시면 더 도움이 될 겁니다. 🎉

  • [3D Printer] 뱀부랩 AMS vs 프루사 MMU 3.0: 멀티컬러 3D 프린팅 시스템 1년 사용 후기

    [3D Printer] 뱀부랩 AMS vs 프루사 MMU 3.0: 멀티컬러 3D 프린팅 시스템 1년 사용 후기

    [3D프린팅] 멀티컬러 3D 프린팅, 뱀부랩 AMS vs 프루사 MMU3 1년 후기

    멀티컬러 3D 프린팅, 처음엔 다들 비슷하게 기대하실 겁니다. 한 번에 여러 색이 나오고, 서포트 재료까지 깔끔하게 분리되고, 이제 수작업 후가공이 줄어들겠구나 싶거든요. 저도 그랬습니다. 그런데 실제로 1년 정도 홈랩에서 굴려보니까, 뱀부랩 AMS와 프루사 MMU3는 같은 멀티컬러 장비처럼 보여도 철학이 꽤 다르더라고요. 빠르게 결과를 뽑아내는 쪽과, 구조를 이해하고 다듬으면서 안정화를 만들어가는 쪽의 차이가 분명했습니다.

    이번 글은 스펙 나열보다는, 제가 직접 써보면서 느낀 운용 난이도, 실패 패턴, 멀티 재료 프린팅에서의 현실적인 차이를 정리한 후기입니다. 혹시 지금 멀티컬러 3D 프린팅 장비를 고민 중이시라면, 카탈로그보다 운영 경험이 더 궁금하실 텐데요. 그 포인트 위주로 풀어보겠습니다.

    멀티컬러 3D 프린팅을 위한 뱀부랩 AMS와 프루사 MMU3 비교 홈랩 전경

    홈랩 환경에서 뱀부랩 AMS와 프루사 MMU3 기반 멀티컬러 3D 프린팅 시스템을 비교하는 개요 이미지입니다.

    멀티컬러 3D 프린팅이 왜 생각보다 어렵나

    쉽게 말해 멀티컬러 3D 프린팅은 한 노즐(nozzle, 용융 필라멘트를 밀어내는 출력부)에 여러 필라멘트(filament, 인쇄 재료)를 번갈아 넣는 과정입니다. 문제는 색만 바뀌는 게 아니라, 이전 재료가 노즐 안에 남아 있다는 점입니다. 그래서 색을 바꿀 때마다 퍼지(purge, 남은 재료를 밀어내는 배출)가 필요하고, 이 과정에서 시간과 재료가 같이 들어갑니다.

    여기서 중요한 포인트가 있습니다. 멀티컬러 시스템의 핵심은 단순히 “색을 몇 개 쓸 수 있나”가 아니고요, 실제로는 아래 세 가지입니다.

    • 로딩/언로딩 안정성: 필라멘트를 넣고 빼는 과정에서 막힘이 적은가
    • 퍼지 관리: 색 전환 시 낭비와 오염을 얼마나 잘 제어하는가
    • 장시간 출력 신뢰성: 밤새 돌려도 아침에 완성품이 남아 있는가

    실제로 써보니까 두 제품의 체감 차이는 여기서 갈렸습니다. 스펙표에서는 비슷해 보여도, 실패가 나는 지점이 다르더라고요.

    뱀부랩 AMS와 프루사 MMU3, 접근 방식부터 다릅니다

    뱀부랩 AMS는 상대적으로 “사용자가 덜 만지게” 설계된 느낌이 강했습니다. 장비 전체가 하나의 제품처럼 맞물려 돌아가고, 준비만 되면 바로 출력 흐름으로 들어가는 편입니다. 처음엔 이게 뭔가 싶었는데, 익숙해지면 정말 편하더라고요. 특히 여러 색을 자주 바꾸는 소형 출력물에서는 진입장벽이 낮았습니다.

    반대로 프루사 MMU3는 “구조를 이해한 사용자가 안정화를 만들어가는” 쪽에 가깝습니다. 프루사 쪽 생태계가 원래 그렇죠. 오픈 구조(open architecture, 내부 구성을 사용자가 파악하고 손보기 쉬운 성격)에 익숙한 분에게는 장점이지만, 처음부터 편의성이 자동으로 따라오진 않았습니다. 대신 한 번 감을 잡고 나면 왜 이런 구조인지 이해가 되기 시작합니다.

    제 기준으로 한 줄 요약하면 이렇습니다.

    항목 뱀부랩 AMS 프루사 MMU3
    첫인상 바로 써보고 싶게 만드는 일체감 구조를 이해해야 진가가 보이는 타입
    초기 진입 상대적으로 쉬움 초기 세팅 이해가 중요
    운용 감각 가전제품에 가까움 튜닝 가능한 공구에 가까움
    실패 대응 원인 파악이 단순한 편 경로와 장력을 세밀하게 봐야 함
    추천 사용자 빠른 결과 중심 구조 이해와 제어를 선호

    제가 1년 동안 어떻게 굴렸는지

    비교는 공정해야 하니까, 둘 다 완전히 새 장비 상태에서만 본 건 아니고 실제 생활 출력 기준으로 봤습니다. 장식물도 뽑고, 레이블 파츠(label parts, 식별용 부품)도 만들고, 서포트가 복잡한 기능성 출력도 섞어서 돌렸습니다. 한마디로 “잘 나온 샘플”보다 “실패했을 때 어떻게 복구되느냐”를 더 많이 본 셈이죠.

    제가 중요하게 본 운영 기준은 다음과 같았습니다.

    1. 짧은 다색 출력에서 준비 시간이 얼마나 적은가
    2. 오래 걸리는 출력에서 중간 실패가 얼마나 적은가
    3. 필라멘트 상태가 조금 안 좋을 때도 버텨주는가
    4. 문제가 났을 때 사용자가 원인을 찾기 쉬운가

    이 기준으로 보면, 뱀부랩 AMS는 평소 속도가 좋고 일상 사용성이 높았습니다. 반면 프루사 MMU3는 세팅을 제대로 잡아둔 뒤에는 출력 논리를 이해하기 쉬웠습니다. 즉, 한쪽은 운영 편의성, 다른 한쪽은 통제감이 강했습니다.

    실전 구현: 제가 실제로 챙긴 세팅 포인트

    이 섹션은 “뭘 체크하면 덜 삽질하나”에 집중해보겠습니다. 멀티컬러 3D 프린팅은 장비 본체보다도 필라멘트 경로(path, 재료가 이동하는 통로), 스풀 상태(spool condition, 감김과 마찰 상태), 슬라이서(slicer, 출력 경로 생성 소프트웨어) 세팅에서 승부가 갈리거든요.

    1. 출력 전 공통 체크리스트

    1. 필라멘트 끝단을 깔끔하게 정리합니다. 찌그러진 끝은 로딩 실패 확률이 확 올라갑니다.
    2. 스풀 감김이 지나치게 빡빡하지 않은지 확인합니다. 옆으로 겹쳐 감긴 필라멘트가 있으면 중간에 걸립니다.
    3. PTFE 튜브(폴리테트라플루오로에틸렌 튜브, 저마찰 재료 이송관) 꺾임이 없는지 봅니다.
    4. 색 전환이 많은 모델이면 퍼지량보다 모델 분할 방식을 먼저 점검합니다.
    5. 장시간 출력 전에는 동일 재료로 짧은 테스트를 먼저 돌립니다.

    2. 슬라이서 프로필 백업

    이건 정말 추천드립니다. 슬라이서 세팅이 꼬이면 원복이 생각보다 귀찮거든요. 저는 설정 바꾸기 전에 백업부터 합니다.

    mkdir -p ~/printer-profile-backup
    cp -r ~/.config/*Slicer* ~/printer-profile-backup/ 2>/dev/null || true
    find ~/printer-profile-backup -maxdepth 2 -type f | sort

    리눅스 기준 예시이고, 실제 경로는 환경마다 조금 다를 수 있습니다. 중요한 건 프로필을 복사해 두고 비교 가능한 상태를 만드는 것입니다.

    3. 테스트용 G-code 예시

    색 전환 직전 직후의 압출 상태를 보려고 저는 작은 테스트 조각과 함께 아래처럼 기본 동작을 자주 확인했습니다.

    M104 S210
    M109 S210
    G28
    G92 E0
    G1 E20 F200
    G1 X20 Y20 F6000
    G1 X120 E12 F900
    G92 E0

    물론 AMS나 MMU3의 자동 전환 전체를 이 코드만으로 대체하는 건 아니고요. 노즐 상태와 압출 일관성을 빠르게 확인하는 용도입니다. 저도 처음엔 복잡한 멀티컬러 테스트부터 했었는데, 나중엔 이렇게 단순 검증이 더 빠르다는 걸 깨달았습니다.

    멀티컬러 3D 프린팅 슬라이서 설정과 필라멘트 매핑 작업 장면

    슬라이서에서 색상별 필라멘트 매핑과 퍼지 관련 설정을 점검하는 장면을 보여주는 이미지입니다.

    4. 운영 메모를 남기는 습관

    이건 의외로 효과가 컸습니다. 어떤 재료가 잘 걸렸는지, 어떤 스풀이 유독 문제였는지, 어느 색 전환에서 오염이 심했는지 짧게 적어두면 다음 삽질을 줄일 수 있습니다.

    print_log:
      date: 2026-06-29
      printer: multi-material-system
      material: PLA
      issue: color-bleed-on-transition
      action: reduce-complex-color-changes
      result: improved

    형식은 아무거나 괜찮습니다. 핵심은 재현 가능한 기록입니다.

    ⚠️ 실제로 자주 겪은 문제와 해결 과정

    여기부터가 진짜 후기죠. 광고 페이지에는 잘 안 나오는 부분입니다.

    1. 필라멘트 상태가 안 좋으면 둘 다 힘들어집니다

    많이들 장비 탓부터 하시는데, 실제로 써보면 필라멘트 컨디션이 훨씬 큽니다. 습기 먹은 필라멘트는 팁(tip, 필라멘트 선단) 모양이 일정하지 않게 나오고, 그게 다시 로딩 실패로 이어지더라고요. 특히 멀티 재료 프린팅에서는 재장전 횟수가 많아서 작은 차이가 크게 보입니다.

    해결법은 의외로 단순했습니다. 상태 애매한 재료를 멀티컬러 작업에 넣지 않는 겁니다. 저는 단색 출력에서는 그냥 넘어가던 스풀도, 멀티컬러 작업에서는 과감히 제외했습니다. 이것만으로 실패율이 꽤 줄었습니다.

    2. AMS는 편한데, 편한 만큼 재료 관리에 방심하게 됩니다

    뱀부랩 AMS는 처음 진입이 편해서 “이 정도면 다 되겠지” 하고 넘어가게 만드는 면이 있습니다. 저도 그렇게 생각했었는데요, 막상 긴 출력에서 문제 나면 대부분 기본으로 돌아가야 하더라고요. 스풀 마찰, 튜브 경로, 필라멘트 끝단 상태 같은 아주 기본적인 부분이요. 드디어 됐다! 싶다가도, 재료 하나만 바꾸면 다시 꼬일 때가 있었습니다.

    해결 포인트는 AMS를 “자동화 장치”로만 보지 않는 겁니다. 자동화는 결국 좋은 입력이 들어갈 때 잘 돌아갑니다.

    3. MMU3는 원인 추적이 되는 대신, 사용자가 봐야 할 포인트가 더 많습니다

    프루사 MMU3는 잘 풀리면 굉장히 납득이 됩니다. 왜 실패했는지, 어느 구간에서 걸렸는지, 장력(tension, 당기는 힘)과 경로를 어떻게 봐야 하는지 감이 옵니다. 그런데 그 단계까지 가는 동안 삽질 좀 했습니다 ㅎㅎ 처음엔 이게 장비 문제인지, 재료 문제인지, 경로 문제인지 구분이 잘 안 되거든요.

    해결 포인트는 한 번에 여러 변수를 바꾸지 않는 겁니다. 튜브 길이, 스풀 위치, 재료 종류, 슬라이서 세팅을 동시에 건드리면 원인을 잃어버립니다. 저는 한 항목씩 바꿔가며 테스트한 뒤에야 안정화가 됐습니다.

    4. 퍼지 낭비는 시스템 특성보다 모델 설계에서 더 크게 줄어듭니다

    이 부분은 의외였습니다. 장비를 바꾸면 퍼지가 확 줄 줄 알았는데, 실제로는 모델 분할 방식과 색 배치가 더 중요했습니다. 작은 파츠에 색이 자주 섞이면 어떤 시스템이든 손해가 커집니다. 반대로 색 전환 구간을 줄이도록 모델링하면 체감 낭비가 많이 줄더라고요.

    💡 팁 하나 드리면, “예쁘게 보이기 위한 포인트 컬러”만 멀티컬러로 두고 나머지는 단색으로 정리하는 방식이 훨씬 효율적입니다.

    검증 결과: 1년 써보니 체감 차이는 여기서 갈렸습니다

    정리하면, 멀티컬러 3D 프린팅 자체의 성공 여부는 장비 이름보다 운영 방식에 더 크게 좌우됐습니다. 다만 체감은 분명히 달랐습니다.

    • 뱀부랩 AMS: 빠르게 시작하고, 일상적으로 여러 색을 쓰는 데 편했습니다.
    • 프루사 MMU3: 세팅 이해도가 올라갈수록 신뢰성이 좋아지는 느낌이 있었습니다.
    • 멀티 재료 프린팅: 두 시스템 모두 재료 상태와 경로 관리가 핵심이었습니다.
    체감 항목 뱀부랩 AMS 프루사 MMU3
    첫 주 적응 상대적으로 빠름 학습 필요
    문제 발생 시 복구 사용자 개입이 적은 편 원인 추적은 쉬운 편
    반복 출력 편의성 좋음 세팅 후 안정적
    튜닝 재미 낮음 높음
    추천 방향 결과 중심 사용자 구조 이해형 사용자
    멀티컬러 3D 프린팅 결과물과 퍼지 타워 비교 이미지

    실제 멀티컬러 출력 결과물과 색 전환 흔적, 퍼지 타워를 함께 비교하는 이미지입니다.

    제가 직접 해보니 결국 선택 기준은 아주 명확했습니다. “나는 장비를 덜 만지고 결과를 빨리 보고 싶은가?” 아니면 “조금 더 만지더라도 구조를 이해하고 내 손에 맞게 잡고 싶은가?” 이 질문에 답이 있더라고요.

    누구에게 더 맞는지 한 번에 정리

    이 부분은 많이 물어보셔서 표로 정리해봤습니다.

    사용자 성향 더 잘 맞는 선택 이유
    처음 멀티컬러 3D 프린팅을 시작 뱀부랩 AMS 초기 흐름이 단순하고 결과 확인이 빠름
    장비 구조를 이해하며 최적화 프루사 MMU3 튜닝과 원인 분석의 재미가 있음
    반복 작업이 많음 뱀부랩 AMS 일상 운용 편의성이 좋음
    세부 제어를 선호 프루사 MMU3 구성 요소를 파악하며 안정화 가능

    여기서 중요한 포인트! 프루사 MMU 3.0이라고 검색하시는 분도 많은데, 실제 제품명은 일반적으로 MMU3로 많이 표기됩니다. 검색하실 때 둘 다 같이 넣으면 자료 찾기가 더 편합니다.

    뱀부랩 AMS와 프루사 MMU3의 장단점을 보여주는 멀티컬러 3D 프린팅 비교 이미지

    뱀부랩 AMS와 프루사 MMU3의 장단점을 한눈에 정리한 요약 비교 이미지입니다.

    자주 묻는 질문

    Q1. 멀티컬러 3D 프린팅이면 무조건 시간을 많이 잡아먹나요?

    네, 대체로 그렇습니다. 색 전환이 들어가면 로딩, 언로딩, 퍼지 시간이 붙기 때문입니다. 그래서 저는 색 전환 횟수를 줄이는 모델 설계를 먼저 권합니다.

    Q2. 멀티 재료 프린팅은 바로 시작해도 될까요?

    가능은 하지만, 처음엔 같은 재질의 다른 색부터 시작하는 게 좋습니다. 재질이 달라지면 온도와 접합 특성까지 같이 들어오거든요. 저도 처음엔 욕심냈다가 다시 기본으로 돌아왔습니다.

    Q3. 둘 중 하나만 고르라면 뭘 추천하나요?

    빠른 만족감과 일상 운용 편의성을 원하면 뱀부랩 AMS 쪽이 더 맞을 가능성이 높습니다. 반대로 구조를 이해하고 만지는 과정까지 즐긴다면 프루사 MMU3가 더 재미있습니다.

    마무리: 결국 좋은 멀티컬러 시스템은 잘 맞는 운영 방식입니다

    1년 써보니까 결론은 단순했습니다. 멀티컬러 3D 프린팅은 장비 자체보다도, 내가 어떤 방식으로 출력 생활을 하고 싶은지에 따라 만족도가 갈립니다. 뱀부랩 AMS는 편의성과 속도가 강점이었고, 프루사 MMU3는 이해와 제어의 재미가 있었습니다. 둘 다 장점이 분명했고, 둘 다 방심하면 실패합니다. 이건 진짜 공통이더라고요.

    다음 글에서는 퍼지량을 줄이기 위한 모델 분할 전략과, 멀티 재료 프린팅에서 서포트 재료를 어떻게 접근하면 좋은지 따로 다뤄볼 예정입니다. 이전 글에서 다뤘던 홈랩 3D 프린터 유지보수 루틴과 연결해서 보셔도 도움이 될 겁니다. 혹시 지금 두 시스템 사이에서 고민 중이시라면, “내가 더 원하는 게 편의성인지, 통제감인지”부터 정리해보세요. 선택이 훨씬 쉬워집니다. 🎉

  • [Kubernetes] Cilium vs Calico 네트워킹 성능 실측 비교

    [Kubernetes] Cilium vs Calico 네트워킹 성능 실측 비교

    [Kubernetes] Cilium vs Calico 네트워킹 성능 실측 비교

    Cilium vs Calico 이야기는 Kubernetes CNI를 운영하는 분들이 한 번쯤 꼭 부딪히는 주제입니다. 클러스터가 작을 때는 둘 다 잘 돌아가는 것처럼 보이는데, 서비스(Service) 수가 늘고 네트워크 정책(NetworkPolicy, 네트워크 접근 제어)까지 얹기 시작하면 느낌이 꽤 달라지거든요. 저도 처음엔 ‘어차피 Pod to Pod 통신만 되면 되는 거 아닌가?’ 싶었는데, 실제로 홈랩에서 반복해서 붙였다 떼어보니 성능 자체보다도 어떤 경로에서 병목이 생기는지, 운영 중에 어디서 시간을 잡아먹는지가 더 중요하더라고요.

    이번 글은 특정 벤더 홍보가 아니라, Cilium vs Calico를 benchmark 관점에서 어떻게 비교해야 하는지, 그리고 제가 실제로 비교할 때 어떤 항목을 봤는지 정리한 글입니다. 숫자를 지어내서 화려하게 쓰는 대신, 실제로 재현 가능한 측정 방법과 해석 포인트 위주로 풀어보겠습니다. 혹시 지금 Kubernetes CNI 교체를 고민 중이시라면, 여기서 중요한 포인트를 먼저 잡고 가시면 삽질을 꽤 줄일 수 있어요.

    홈랩 Kubernetes 클러스터에서 Cilium과 Calico의 데이터 경로를 비교하는 전체 개요 이미지입니다.

    Kubernetes CNI에서 Cilium과 Calico를 왜 따로 봐야 할까요

    쉽게 말해 CNI(Container Network Interface, 컨테이너 네트워크 인터페이스)는 Pod가 네트워크에 붙는 방식을 정하는 레이어입니다. 그런데 운영해보면 단순히 IP 붙이는 수준에서 끝나지 않아요. 서비스 라우팅, 네트워크 정책, 트래픽 가시성, 디버깅 도구, 커널 의존성까지 같이 따라옵니다.

    Calico는 오래전부터 많이 써온 선택지라 운영 경험치가 쌓여 있고, 라우팅과 정책 측면에서 익숙한 분들이 많습니다. 반면 Cilium은 eBPF(이비피에프, 커널 내부에서 안전하게 패킷 처리 로직을 실행하는 기술)를 적극 활용해서 데이터 경로를 다르게 가져가는 게 핵심이죠. 처음엔 이게 뭔가 싶었는데, 관찰성(Observability, 트래픽을 들여다보는 능력) 쪽은 확실히 인상적이었어요.

    여기서 오해하면 안 되는 게 하나 있습니다. “무조건 Cilium이 빠르다” 혹은 “Calico는 오래돼서 느리다” 같은 식으로 단정하면 안 됩니다. 실제 Kubernetes CNI 성능 비교는 트래픽 패턴에 따라 결과가 달라집니다. Pod 간 단순 대역폭, NodePort 경유, Service 체인, NetworkPolicy 적용 여부, 암호화 사용 여부 같은 조건이 바뀌면 체감이 꽤 달라지거든요.

    Cilium vs Calico 핵심 차이 정리

    항목 Cilium Calico
    핵심 데이터 경로 eBPF 기반 iptables 기반 또는 eBPF dataplane 선택 가능
    강점 관찰성, 정책 처리, 서비스 트래픽 가시화 성숙한 운영 사례, 익숙한 구성, 다양한 환경 적응력
    운영 난이도 커널과 기능 이해가 필요함 상대적으로 익숙한 운영 패턴
    디버깅 관점 Hubble 등 생태계가 강점 전통적인 네트워크 관점에서 접근이 쉬움
    비교 포인트 정책 많을 때, 관찰성 중요할 때 안정적 표준 운영, 기존 경험 활용 시

    제가 직접 해보니, Kubernetes CNI 성능 비교에서 제일 많이 놓치는 부분이 순수 처리량(throughput)만 보고 결론 내리는 것이었습니다. 실제 운영에서는 지연(latency), 정책 적용 후 변화, 장애 났을 때 추적 가능성까지 같이 봐야 하더라고요. 특히 멀티테넌트 비슷하게 네임스페이스를 나눠 쓰는 환경이면 더 그렇습니다.

    비교 전에 먼저 정해야 할 질문

    • 단순 Pod to Pod 성능이 궁금한지
    • NetworkPolicy 적용 후 성능 변화가 궁금한지
    • Service 트래픽까지 포함한 실제 운영 경로가 궁금한지
    • 관찰성과 디버깅 속도를 포함해 평가할지

    이 질문부터 정리하고 들어가면 benchmark 해석이 훨씬 깔끔해집니다.

    실전 비교 환경 구성: 같은 조건으로 맞추는 게 먼저입니다

    여기서 제일 중요한 건 두 CNI를 최대한 같은 조건에서 비교하는 겁니다. CPU, 메모리, 커널, Kubernetes 버전, MTU, 노드 수, Pod 수가 다르면 결과가 섞여버립니다. 저도 초반에는 클러스터를 급하게 갈아엎다가 조건이 달라져서 다시 측정했었어요. 삽질 꽤 했습니다 ㅎㅎ

    1. 동일한 노드 사양으로 테스트 클러스터를 준비합니다.
    2. 한 번에 하나의 CNI만 설치합니다.
    3. 테스트 워크로드는 똑같이 유지합니다.
    4. 측정 항목을 미리 고정합니다. 예: 대역폭, 지연, 정책 적용 전후, Service 경유 성능.

    아래는 Helm(헬름, 쿠버네티스 패키지 매니저) 기준으로 Cilium vs Calico 비교 환경을 잡을 때 자주 쓰는 흐름입니다.

    helm repo add cilium https://helm.cilium.io/
    helm repo update
    
    helm install cilium cilium/cilium \
      --namespace kube-system \
      --set kubeProxyReplacement=false

    ⚠️ 주의: 위 설정의 kubeProxyReplacement=false는 kube-proxy를 계속 사용한다는 뜻입니다. Cilium의 eBPF 이점을 제대로 보려면 --set kubeProxyReplacement=strict 또는 =probe로 설정하는 게 낫습니다. 비교 목적이라면 두 CNI 모두 같은 서비스 경로 구성을 유지해야 한다는 점을 잊지 마세요.

    helm repo add projectcalico https://docs.tigera.io/calico/charts
    helm repo update
    
    helm install calico projectcalico/tigera-operator \
      --namespace tigera-operator \
      --create-namespace

    환경에 따라 설치 방식은 달라질 수 있습니다. 중요한 건 설치 명령보다도 비교 조건을 고정하는 습관입니다.

    동일 조건의 Kubernetes CNI 테스트 환경에서 Cilium vs Calico를 비교하는 구성 이미지

    동일한 노드 조건에서 Cilium과 Calico를 각각 분리해 테스트하는 구성 다이어그램입니다.

    Benchmark 워크로드 만들기: iperf3와 정책 테스트를 같이 봐야 합니다

    Kubernetes CNI 성능 비교를 할 때 저는 보통 iperf3(아이퍼프3, 네트워크 처리량 측정 도구)부터 올립니다. 이유는 단순해요. 가장 빠르게 Pod 간 대역폭과 TCP/UDP 흐름을 볼 수 있거든요. 다만 이것만 보면 반쪽짜리입니다. 실제 운영은 Service, DNS, NetworkPolicy가 얹히니까요.

    기본 테스트 Pod 배포

    apiVersion: v1
    kind: Pod
    metadata:
      name: iperf3-server
      labels:
        app: iperf3-server
    spec:
      containers:
        - name: iperf3
          image: networkstatic/iperf3
          args: ["-s"]
    ---
    apiVersion: v1
    kind: Pod
    metadata:
      name: iperf3-client
    spec:
      containers:
        - name: iperf3
          image: networkstatic/iperf3
          command: ["sleep", "3600"]
    kubectl apply -f iperf3.yaml
    kubectl get pods -o wide
    kubectl exec -it iperf3-client -- iperf3 -c <SERVER_POD_IP> -t 30

    여기서 중요한 포인트! 같은 노드에 붙은 경우와 다른 노드에 붙은 경우를 분리해서 봐야 합니다. 같은 노드면 오버레이(overlay) 영향을 덜 받고, 다른 노드면 실제 네트워크 경로가 더 잘 드러나거든요.

    Service 경유 테스트도 꼭 해보세요

    apiVersion: v1
    kind: Service
    metadata:
      name: iperf3-service
    spec:
      selector:
        app: iperf3-server
      ports:
        - protocol: TCP
          port: 5201
          targetPort: 5201
    kubectl apply -f iperf3-service.yaml
    kubectl exec -it iperf3-client -- iperf3 -c iperf3-service.default.svc.cluster.local -t 30

    이렇게 보면 직접 Pod IP로 붙었을 때와 Service를 경유했을 때 차이를 비교할 수 있어요. 실제로 써보니까 이 구간에서 체감 차이를 보는 경우가 꽤 있더라고요.

    NetworkPolicy 적용 후도 따로 측정

    apiVersion: networking.k8s.io/v1
    kind: NetworkPolicy
    metadata:
      name: allow-iperf3
    spec:
      podSelector:
        matchLabels:
          app: iperf3-server
      policyTypes:
        - Ingress
      ingress:
        - from:
            - podSelector: {}
          ports:
            - protocol: TCP
              port: 5201

    정책 없을 때 한 번, 정책 적용 후 한 번. 최소 이 두 번은 돌려보셔야 합니다. 정책이 많아질수록 Cilium vs Calico의 dataplane 특성이 드러나는 경우가 있거든요.

    제가 실제로 체크한 관찰 포인트

    단순히 결과 숫자만 기록하면 나중에 해석이 안 됩니다. 그래서 저는 아래 항목을 같이 봤어요.

    • Pod to Pod 처리량: 같은 노드 / 다른 노드 분리
    • Service 경유 지연: kube-proxy 경로 포함 여부 확인
    • NetworkPolicy 적용 전후 차이: 정책 수가 늘어날 때 체감 확인
    • CPU 사용 경향: 네트워크 부하 중 어느 쪽이 더 민감한지
    • 디버깅 편의성: 장애 시 원인 추적 시간

    특히 마지막 항목은 문서만 보면 잘 안 보입니다. 성능 수치가 약간 좋아도, 운영 중 원인 파악이 너무 오래 걸리면 결국 전체 효율은 떨어지더라고요. 저는 예전에 정책 충돌 때문에 Pod 통신이 막힌 적이 있었는데, 그때부터는 관찰성도 성능의 일부라고 생각하게 됐습니다.

    Kubernetes 네트워킹 성능 비교를 위해 Cilium vs Calico benchmark를 수행하는 시각화 이미지

    iperf3 실행과 정책 테스트를 병행하면서 측정하는 과정을 보여주는 시각 자료입니다.

    ⚠️ 주의사항과 트러블슈팅: 여기서 많이 막힙니다

    이 섹션은 진짜 중요합니다. Kubernetes CNI benchmark가 이상하게 나오면 대개 CNI 자체보다 테스트 환경 변수가 문제인 경우가 많거든요.

    1. MTU 불일치

    오버레이 네트워크나 터널링이 들어가면 MTU(Maximum Transmission Unit, 최대 전송 단위)가 어긋나면서 성능이 이상하게 흔들릴 수 있습니다. 겉보기엔 통신이 되는데, 처리량이 들쑥날쑥하거나 재전송이 늘어나는 식이죠.

    kubectl exec -it iperf3-client -- ip link
    kubectl exec -it iperf3-server -- ip addr

    MTU 값이 환경 전체에서 일관적인지 먼저 확인해보세요.

    2. 같은 노드에만 스케줄링되는 문제

    처음엔 결과가 너무 좋게 나와서 ‘와, 이거 엄청 빠른데?’ 했었는데, 알고 보니 서버와 클라이언트 Pod가 같은 노드에 올라가 있었던 적이 있어요. 이러면 진짜 비교가 안 됩니다.

    kubectl get pods -o wide

    노드 분산이 필요하면 nodeSelector나 podAntiAffinity도 같이 고려해보세요.

    3. 정책 테스트인데 DNS를 빼먹는 문제

    Service 이름으로 붙는 테스트를 할 때 DNS 허용 정책을 빼먹으면 결과가 꼬여요. 통신 자체가 안 되는 걸 성능 문제로 오해하기 쉽거든요.

    4. 관찰 도구가 없는 상태에서 디버깅 시작

    Calico든 Cilium이든 로그와 패킷 경로를 볼 수단을 먼저 확보해두는 게 좋습니다. 특히 Cilium은 Hubble(Hubble, 네트워크 관찰 도구) 같은 생태계를 같이 보는 분들이 많고, Calico도 운영 환경에 맞춰 상태 확인 경로를 준비해두는 편이 낫습니다.

    💡 팁: benchmark 전에 무부하 상태 baseline을 한 번 기록해두세요. 나중에 결과가 흔들려도 비교 기준점이 생깁니다.

    검증과 결과 해석: 숫자보다 패턴을 보셔야 합니다

    이제 제일 궁금한 부분이죠. 그래서 뭐가 더 빨랐냐고요? 제가 홈랩과 소규모 테스트 클러스터에서 여러 번 Cilium vs Calico를 비교해본 느낌은 이랬습니다.

    • 단순 Pod to Pod 처리량만 보면 둘 다 충분히 빠른 편이라, 환경에 따라 큰 차이가 안 보일 때도 많았어요.
    • Service 경유, 정책 적용, 관찰성 포함으로 범위를 넓히면 체감 차이가 생겼습니다.
    • Cilium은 eBPF 기반 흐름과 관찰성 덕분에 문제를 추적하는 시간이 줄어드는 느낌이 있었어요.
    • Calico는 운영 경험이 이미 쌓인 팀이라면 구성과 장애 대응이 익숙해서 안정감이 있더라고요.

    즉, Kubernetes CNI benchmark 결과는 단순히 ‘누가 더 빠르다’로 끝내면 아쉬워요. 운영 모델까지 포함한 성능 비교가 맞습니다. 특히 네트워크 정책을 많이 쓰고 서비스 메시에 가까운 복잡한 흐름이 있다면 Cilium이 주는 장점이 더 잘 보일 수 있습니다. 반대로 단순하고 예측 가능한 구조, 기존 팀 역량 활용이 중요하다면 Calico도 여전히 아주 현실적인 선택입니다.

    테스트 항목 해석 포인트 제가 본 체감
    Pod to Pod 순수 데이터 경로 성능 환경 따라 큰 차이 없을 수 있음
    Service 경유 서비스 라우팅 오버헤드 구성 차이가 드러날 수 있음
    Policy 적용 후 정책 엔진 영향 워크로드 구조에 따라 차이 발생
    운영 디버깅 문제 추적 시간 Cilium 관찰성이 인상적이었음
    Kubernetes CNI에서 Cilium vs Calico benchmark 결과 해석을 요약한 비교 이미지

    Cilium vs Calico benchmark 결과를 숫자보다 해석 포인트 중심으로 요약한 인포그래픽입니다.

    어떤 환경에 Cilium, 어떤 환경에 Calico가 맞을까요

    정리하면 이렇습니다.

    • Cilium 추천: eBPF 기반 기능, 네트워크 가시성, 정책 중심 운영, 트래픽 분석이 중요할 때
    • Calico 추천: 익숙한 운영 모델, 폭넓은 도입 사례, 단계적 운영 안정성이 중요할 때

    여기서 중요한 포인트! 팀의 운영 역량도 반드시 포함해서 판단해야 합니다. 도구가 아무리 좋아도, 팀이 이해하지 못하면 장애 대응 시간은 길어집니다. 저도 처음에는 기능표만 보고 혹했었는데, 결국 오래 남는 건 운영 난이도와 추적 가능성이더라고요.

    정리와 다음 단계

    이번 글에서는 Cilium vs Calico를 Kubernetes CNI와 네트워킹 성능 비교 관점에서 풀어봤습니다. 핵심은 간단해요. Benchmark는 같은 조건에서 측정하고, 결과는 처리량만이 아니라 정책/서비스/디버깅까지 함께 해석해야 한다는 점입니다. 제가 직접 해보니 결국 ‘더 빠른 CNI’보다 ‘내 환경에서 더 잘 설명되는 CNI’를 고르는 쪽이 맞았습니다.

    ✅ 지금 바로 해보실 일은 세 가지입니다.

    1. 동일 조건의 테스트 클러스터를 준비합니다.
    2. Pod to Pod, Service, NetworkPolicy 세 가지 축으로 나눠 측정합니다.
    3. 결과 표에 숫자뿐 아니라 장애 추적 난이도까지 같이 적습니다.

    다음 글에서는 Hubble을 활용한 Cilium 트래픽 관찰이나, 반대로 Calico NetworkPolicy 운영 팁을 더 깊게 다뤄볼 예정입니다. Kubernetes 네트워크 기본기 관련 이전 글들도 함께 읽으시면 Cilium vs Calico 비교의 흐름이 더 잘 잡히실 거예요.

    자주 묻는 질문

    Cilium이 항상 Calico보다 빠른가요?

    아니에요. 트래픽 패턴, 정책 수, 서비스 경로, 커널 환경에 따라 달라집니다. 단순 benchmark 하나로 일반화하면 위험합니다.

    Calico도 eBPF를 쓰나요?

    Calico는 전통적인 방식으로 많이 알려져 있지만, eBPF dataplane 관련 선택지도 존재합니다. 다만 실제 비교에서는 어떤 dataplane을 쓰는지를 명확히 맞춰야 합니다.

    Kubernetes CNI 비교에서 제일 중요한 항목은 뭔가요?

    제 기준으로는 정책 적용 후의 변화와 운영 중 추적 가능성입니다. 실서비스는 그 구간에서 차이가 크게 느껴지거든요.

    🎉 결론적으로, Cilium이든 Calico든 무작정 유행 따라 고르기보다 내 클러스터의 네트워크 구조와 운영 방식에 맞춰 Cilium vs Calico를 직접 benchmark 해보는 게 가장 확실합니다.

  • [홈랩] Proxmox에 Home Assistant OS 구축: 안정적인 홈랩 베스트 프랙티스

    [홈랩] Proxmox에 Home Assistant OS 구축: 안정적인 홈랩 베스트 프랙티스

    [홈랩] Proxmox에 Home Assistant OS 구축: 안정적인 홈랩 베스트 프랙티스

    Proxmox Home Assistant OS 조합을 찾는 분들이 정말 많습니다. 저도 홈랩을 굴리면서 라즈베리 파이, Docker(도커), LXC(리눅스 컨테이너), 그리고 VM(가상머신)까지 이것저것 다 해봤거든요. 결론부터 말씀드리면, 장기적으로 덜 흔들리고 관리가 편한 쪽은 Proxmox 위에 HAOS(Home Assistant OS, 홈 어시스턴트 전용 운영체제)를 올리는 방식이었습니다. 처음엔 “굳이 전용 OS까지?” 싶었는데, Add-on(애드온, 확장 기능), 백업, 복구 흐름이 생각보다 깔끔해서 결국 이쪽으로 정착했네요.

    특히 스마트홈 서버는 한 번 꼬이면 집안 자동화가 줄줄이 멈춥니다. 조명 자동화가 안 되고, 센서 상태가 늦게 올라오고, 외부 접속도 어긋나고요. 그래서 이번 글에서는 제가 실제로 여러 번 구축하고 옮겨보면서 정리한 HAOS Proxmox 구성법과 운영 팁을 한 번에 정리해보겠습니다. 삽질도 좀 했습니다 ㅎㅎ 그래서 더 현실적인 가이드가 될 겁니다.

    Proxmox 가상화 환경 위에 Home Assistant OS가 올라가고, 라우터와 IoT 기기, NAS 백업 저장소가 연결된 전체 구조 예시입니다.

    왜 Proxmox와 Home Assistant OS 조합이 홈랩에 적합할까?

    쉽게 말해 Proxmox VE(프록스목스 가상화 환경)는 하드웨어 위에 여러 서버를 나눠 올리는 기반이고, HAOS는 Home Assistant를 가장 일관된 형태로 운영하기 위한 전용 이미지입니다. 이 둘을 합치면 장점이 꽤 분명합니다.

    • 분리 운영: NAS, 테스트용 리눅스 VM, 스마트홈 서버를 각각 독립적으로 운영하기 좋습니다.
    • 백업 편의성: Proxmox 백업과 Home Assistant 내부 백업을 이중으로 가져갈 수 있습니다.
    • 복구 속도: 장애가 나도 VM 단위로 되살리기 편합니다.
    • 확장성: USB 패스스루(USB passthrough, USB 장치 직접 연결), VLAN(가상 LAN), 별도 스토리지 연결이 수월합니다.

    제가 직접 써보니 Docker 설치형도 분명 가볍고 유연합니다. 근데 스마트홈 서버는 “가볍다”보다 안정적으로 오래 돌아가는가가 더 중요하더라고요. 특히 Zigbee(지그비) 동글이나 백업 복구까지 생각하면 HAOS 쪽이 훨씬 덜 피곤했습니다.

    설치 방식 비교: 어떤 선택이 덜 후회될까?

    방식 장점 주의점 추천 대상
    Home Assistant OS on VM 기능 구성이 완전하고 Add-on 사용이 편함 가상머신 자원 계획 필요 처음 구축하는 분, 안정성 우선
    Home Assistant Container 유연하고 직접 제어 범위가 넓음 Supervisor, Add-on 흐름이 다름 컨테이너 운영 경험이 많은 분
    LXC 기반 설치 자원 효율이 좋을 수 있음 지원 범위와 유지보수 판단이 중요 실험용, 구조를 잘 이해한 분

    여기서 중요한 포인트! 안정적인 홈랩 자동화를 목표라면 VM 기반 HAOS가 제일 덜 헷갈립니다. 결국 오래 버티는 구성이 이기거든요.

    구축 전 체크리스트: 시작 전에 이건 꼭 보세요

    처음엔 설치부터 눌러버리고 싶죠. 저도 그랬습니다. 근데 아래 항목을 먼저 정리해두면 나중에 재설치할 일이 확 줄어듭니다.

    1. 고정 IP 계획: Home Assistant가 받을 IP를 DHCP Reservation(고정 할당)으로 미리 정해두세요.
    2. 스토리지 위치: VM 디스크를 어느 스토리지에 둘지 정합니다. SSD 계열이면 체감이 좋습니다.
    3. 백업 저장소: Proxmox 백업과 Home Assistant 백업을 어디에 둘지 정하세요. 같은 디스크 하나만 믿으면 불안합니다.
    4. USB 장치 여부: Zigbee, Z-Wave 동글을 쓸 계획이면 패스스루 대상 장치를 미리 확인합니다.
    5. 브리지 네트워크: 보통 vmbr0 브리지에 붙이게 되는데, 기존 네트워크 구조와 충돌이 없는지 점검합니다.

    사실 스마트홈 서버는 설치보다 이전과 복구 전략이 더 중요합니다. 저도 처음엔 그냥 빨리 띄우는 데만 집중했었는데, 나중에 SSD 교체할 때 백업 설계가 안 되어 있어서 꽤 번거로웠습니다.

    실전 구축 1: HAOS 이미지를 Proxmox VM으로 올리기

    실전으로 가보겠습니다. 순서는 단순합니다. HAOS 이미지 준비 → Proxmox에 VM 생성 → 디스크 가져오기 → 부팅 흐름입니다.

    1. HAOS 이미지 준비

    Home Assistant OS용 qcow2 이미지를 준비합니다. 파일명은 시점에 따라 다를 수 있으니, 최신 릴리스에서 받았다고 가정하고 예시에서는 변수처럼 표기하겠습니다.

    cd /var/lib/vz/template/iso
    ls
    # 예시: haos_ova-xx.x.qcow2.xz 형태의 파일을 준비한 뒤 압축 해제
    xz -d <HAOS_IMAGE_FILE>.xz
    ls -lh

    파일명이 제각각이라 여기서 많이 헷갈리더라고요. 저도 처음엔 확장자만 보고 OVA(오브이엠에이)랑 QCOW2를 섞어서 봤었습니다. 핵심은 Proxmox에서 가져올 수 있는 디스크 이미지 파일을 준비하는 것입니다.

    2. VM 생성

    예시 VM ID는 300으로 잡아보겠습니다. 이름은 취향대로 정하시면 됩니다.

    qm create 300 \
      --name home-assistant \
      --memory 4096 \
      --cores 2 \
      --net0 virtio,bridge=vmbr0

    메모리와 코어는 환경에 맞게 조정하시면 됩니다. 제가 실제로 써보니 시작은 너무 타이트하게 잡지 않는 게 낫습니다. 나중에 애드온이 늘어나면 생각보다 금방 빡빡해지거든요.

    3. 디스크 이미지 가져오기

    스토리지 이름은 환경마다 다르니 local-lvm, local-zfs, data-store 같은 실제 이름으로 바꿔서 쓰시면 됩니다.

    qm importdisk 300 /var/lib/vz/template/iso/<HAOS_IMAGE_FILE>.qcow2 <TARGET_STORAGE>

    가져오기가 끝나면 Proxmox에서 해당 디스크를 VM에 연결해야 합니다.

    qm set 300 --scsihw virtio-scsi-pci
    qm set 300 --scsi0 <TARGET_STORAGE>:vm-300-disk-0
    qm set 300 --boot order=scsi0
    qm set 300 --serial0 socket --vga serial0

    여기서 serial0 설정은 콘솔 확인할 때 꽤 편합니다. 부팅 로그를 볼 수 있어서 문제 생겼을 때 원인 파악이 빨라지더라고요.

    4. 첫 부팅

    qm start 300
    qm status 300

    부팅 후에는 네트워크에서 Home Assistant가 IP를 받아야 합니다. 보통 웹 브라우저에서 http://<HA_IP>:8123으로 접속하거나, mDNS(멀티캐스트 DNS)가 되는 환경이면 http://homeassistant.local:8123 형태로 접근할 수 있습니다.

    HAOS Proxmox 가상머신 설정 화면 예시

    Proxmox UI에서 VM 하드웨어 항목, 디스크 연결, 부팅 순서를 확인하는 장면을 넣으면 초보자도 흐름을 따라가기 편합니다.

    실전 구축 2: 안정적으로 굴리기 위한 Proxmox 설정 팁

    설치만 끝났다고 끝이 아닙니다. Proxmox 가상화 환경에서 Home Assistant를 오래 안정적으로 돌리려면 몇 가지 운영 포인트를 잡아두는 게 좋습니다.

    가상 하드웨어는 단순하게

    • 네트워크 어댑터는 보통 virtio로 시작하면 무난합니다.
    • 디스크 버스는 SCSI 계열로 맞추면 관리가 편한 경우가 많습니다.
    • 무리한 CPU 타입 튜닝은 초기에 굳이 안 건드려도 됩니다.

    처음엔 저도 성능 욕심 나서 이것저것 최적화하려고 했는데, 스마트홈 서버는 극한 튜닝보다 예측 가능한 구성이 더 중요했습니다.

    백업은 두 겹으로

    이건 진짜 강조하고 싶습니다.

    1. Proxmox VM 백업을 정기적으로 수행합니다.
    2. Home Assistant 내부 백업도 별도로 남깁니다.

    한쪽만 믿으면 애매한 순간이 옵니다. VM 자체를 통째로 되돌릴 때와, Home Assistant 설정만 빠르게 복원할 때가 다르거든요.

    스냅샷은 업그레이드 직전에

    모든 스냅샷이 만능은 아니지만, 주요 변경 전에 하나 찍어두면 심리적으로도 훨씬 편합니다. 특히 통합(Integration, 연동 기능)이나 애드온 추가 전에는요.

    qm snapshot 300 pre-update
    qm listsnapshot 300

    물론 스냅샷을 장기 보관 전략으로 쓰는 건 다릅니다. 운영 백업과 스냅샷은 역할이 다르다고 보시면 됩니다.

    ⚠️ 트러블슈팅: 제가 실제로 자주 부딪힌 문제들

    여기서는 진짜 많이 묻는 문제 위주로 정리해보겠습니다. 저도 처음엔 이게 뭔가 싶었는데, 패턴을 알고 나면 금방 풀립니다.

    1. 부팅은 되는데 웹 접속이 안 됩니다

    • 브리지(vmbr0) 연결이 맞는지 확인합니다.
    • DHCP에서 IP를 받았는지 라우터에서 확인합니다.
    • 초기 부팅 직후에는 준비 시간이 조금 필요할 수 있습니다.

    특히 첫 부팅 직후에는 바로 안 뜨는 경우가 있습니다. 괜히 중간에 강제 재부팅하지 말고 조금 기다려보세요. 저도 성격 급해서 몇 번 더 꼬이게 만든 적이 있습니다 ㅎㅎ

    2. USB 동글이 안 잡힙니다

    Zigbee 동글을 붙일 때 자주 나옵니다. 이 경우는 Proxmox에서 해당 USB 장치를 VM으로 패스스루해야 합니다. 장치가 바뀔 수 있으니 물리 포트 변경 후 다시 확인하는 습관이 필요합니다.

    • 호스트에서 USB 장치 식별이 되는지 먼저 확인
    • VM 하드웨어 항목에 USB 장치 추가
    • 재부팅 후 Home Assistant에서 장치 인식 여부 확인

    3. 업데이트 후 뭔가 이상합니다

    이럴 때는 무조건 “다시 만지기”보다 최근 변경 사항부터 되짚는 게 먼저입니다. 통합 추가, 애드온 설치, 네트워크 변경, 스토리지 변경 순으로 보시면 됩니다. 가능하면 업데이트 전 백업이나 스냅샷에서 비교해보세요.

    4. 리소스는 충분한데 체감이 느립니다

    이건 Home Assistant 자체 문제라기보다 호스트 스토리지, 다른 VM의 IO(입출력), 백업 시간대 겹침 때문에 생길 때가 많습니다. 홈랩 자동화 환경에서는 백업 작업이 한밤중에 몰리면서 응답이 늦어지는 경우도 있더라고요.

    Proxmox Home Assistant OS USB 패스스루와 브리지 네트워크 구성

    Zigbee 동글 USB 패스스루 흐름과 vmbr0 브리지 연결 구조를 시각적으로 보여주면 트러블슈팅 이해가 훨씬 쉬워집니다.

    검증과 결과: 구축이 잘 끝났는지 어떻게 확인할까?

    구축 후에는 “켜진다”만 확인하면 반쪽입니다. 저는 아래 순서로 점검합니다.

    1. 웹 접속 확인: 8123 포트로 접속이 안정적으로 되는지
    2. 재부팅 테스트: Proxmox 호스트 재부팅 후 VM이 정상 복구되는지
    3. 백업 복원 흐름 확인: 최소한 백업 파일 생성까지는 검증
    4. 주요 통합 확인: 센서, 스위치, 알림, 자동화가 정상 동작하는지

    실제로 써보니까, 여기서 제일 중요한 건 재부팅 후 정상 복구였습니다. 평소엔 멀쩡해도 정전이나 장비 교체 뒤에 문제가 터지는 경우가 있거든요. 그래서 저는 구축 직후 일부러 한 번 껐다 켜봅니다. 좀 귀찮아도 이게 나중에 진짜 편합니다.

    automation:
      - alias: "HA Start Notification"
        trigger:
          platform: homeassistant
          event: start
        action:
          - service: persistent_notification.create
            data:
              title: "Home Assistant"
              message: "Home Assistant가 정상적으로 시작되었습니다."
        mode: single

    이런 식으로 시작 알림을 하나 걸어두면 재부팅 후 상태 확인이 편합니다. 작은 팁인데 꽤 유용합니다.

    Proxmox Home Assistant OS 구축 후 대시보드 결과 화면

    센서 상태와 자동화 실행 이력이 정상적으로 보이는 Home Assistant 대시보드 예시입니다.

    운영하면서 느낀 베스트 프랙티스 정리

    • 처음부터 완벽하게 꾸미려 하지 않기: 우선 기본 자동화부터 안정화하세요.
    • 백업 경로 분리: 호스트와 게스트 내부 백업을 분리하면 복구 선택지가 늘어납니다.
    • USB 장치는 문서화: 어떤 동글이 어느 포트에 연결됐는지 메모해두면 좋습니다.
    • 업데이트는 한 번에 많이 하지 않기: 여러 요소를 동시에 바꾸면 문제 원인 추적이 어려워집니다.
    • 테스트용 자동화와 실사용 자동화 분리: 실험하다가 집안 전체 동작이 흔들리는 걸 줄일 수 있습니다.

    저도 예전엔 설정을 한 번에 몰아서 바꾸다가, 뭐가 문제인지 못 찾아서 결국 원복했던 적이 많았습니다. 지금은 작게 바꾸고 바로 검증하는 쪽으로 완전히 습관이 바뀌었네요.

    자주 묻는 질문 FAQ

    Q1. 스마트홈 서버는 꼭 Proxmox 위에서 돌려야 하나요?

    아닙니다. 다만 여러 서비스를 함께 운영하는 홈랩이라면 Proxmox 같은 하이퍼바이저(Hypervisor, 가상화 기반 플랫폼)가 관리상 편합니다.

    Q2. HAOS Proxmox 구성은 초보자에게 어렵지 않나요?

    처음엔 용어가 낯설 수 있습니다. 근데 설치 흐름 자체는 생각보다 단순합니다. 오히려 장기 운영은 더 편한 편입니다.

    Q3. Docker 대신 HAOS를 고른 이유는 뭔가요?

    제가 직접 운영해보니 Add-on과 백업, 복구 흐름이 한 덩어리로 맞물리는 점이 좋았습니다. 특히 홈랩 자동화처럼 운영 기간이 길어질수록 장점이 더 보였습니다.

    마무리: Proxmox Home Assistant OS는 결국 운영 편의성 싸움입니다

    Proxmox Home Assistant OS 조합은 화려한 기술이라기보다, 오래 운영할수록 진가가 드러나는 방식입니다. 처음엔 VM 만들고 이미지 넣는 과정이 조금 번거롭게 느껴질 수 있습니다. 근데 한 번 안정화해두면 장애 대응, 백업, 이전 작업이 훨씬 수월해집니다. 저는 결국 “관리 가능한 복잡도”가 제일 중요하다고 느꼈습니다.

    혹시 지금 라즈베리 파이에서 옮길지 고민 중이시라면, 이번에는 단순 설치보다 복구 가능한 구조를 목표로 잡아보세요. 다음 글에서는 Proxmox 백업 전략이나 리버스 프록시(Reverse Proxy, 역방향 프록시), 외부 접속 구성도 이어서 다뤄볼 예정입니다. 이전 글에서 다룬 홈랩 네트워크 분리나 VLAN 구성과도 같이 보면 더 이해가 잘 되실 겁니다.

    설치 전 체크리스트, 운영 팁, 백업 전략을 한눈에 정리한 요약 인포그래픽 자리입니다.