13년차의 서버실

서버, 인프라, 홈랩 기술 블로그

[작성자:] admin

  • [AI] AI API 비용 절감 전략: GPT-4o vs Claude Sonnet vs Gemini Pro 비교 분석

    [AI] AI API 비용 절감 전략: GPT-4o vs Claude Sonnet vs Gemini Pro 비교 분석

    [AI] AI API 비용 절감 전략: GPT-4o vs Claude Sonnet vs Gemini Pro 비교 분석

    AI API 비용 비교를 본격적으로 해야 하는 시점이 왔습니다. 예전에는 모델 성능만 보고 붙여도 되는 분위기였는데, 이제는 토큰(token, 모델이 읽고 쓰는 최소 과금 단위) 비용이 서비스 마진을 바로 깎아먹거든요. 저도 홈랩에서 요약 봇, 로그 분석기, 사내 문서 질의응답 같은 걸 굴려보면서 느낀 게 하나 있습니다. 성능 차이보다 비용 구조 차이가 더 무섭다는 점입니다. 처음엔 “몇 센트 차이겠지” 싶었는데, 호출량이 붙으니까 월말에 숫자가 확 달라지더라고요.

    이번 글은 AI API 비용 비교 관점에서 OpenAI의 GPT-4o, Anthropic의 Claude Sonnet, Google의 Gemini Pro 계열을 어떻게 봐야 하는지 정리한 글입니다. 특히 GPT-4o 비용, Claude Sonnet 비용, Gemini Pro 비용, 그리고 실무에서 바로 체감되는 토큰 절감 전략까지 같이 보겠습니다.
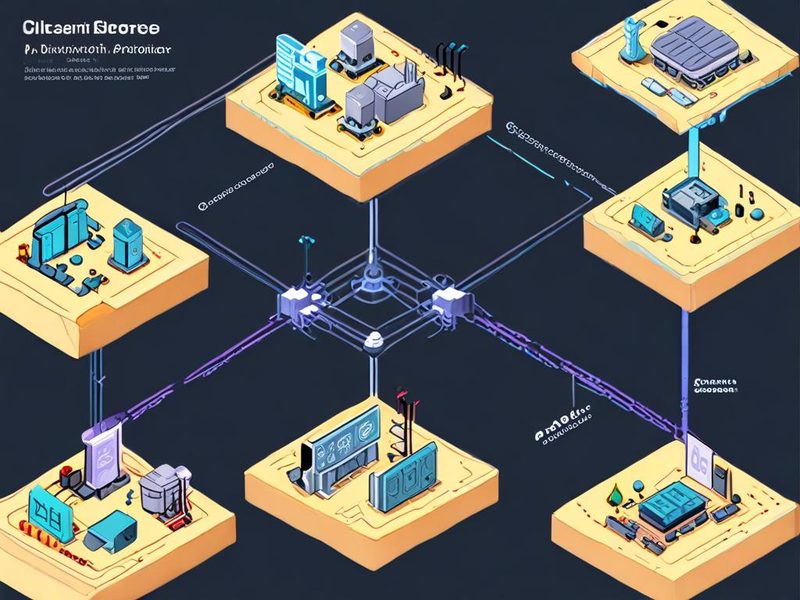
    AI API 비용 비교 아키텍처 다이어그램

    세 가지 API 공급자와 비용 계산 흐름을 한눈에 보여주는 개요 이미지입니다.

    1. 비교 전에 먼저 잡아야 할 기준: 이름보다 과금 구조를 보셔야 합니다

    여기서 먼저 짚고 갈 게 있습니다. 모델 이름은 계속 바뀌는데, 과금 구조는 대체로 입력 토큰(input tokens), 출력 토큰(output tokens), 캐시(prompt caching), 배치(batch processing) 네 축으로 봐야 합니다. 쉽게 말해, “질문 넣는 비용”, “답변 받는 비용”, “같은 프롬프트를 재사용할 때의 할인”, “비동기 대량 처리 할인” 이 네 가지예요.

    그리고 제목에는 Gemini Pro라고 썼지만, 현재 공개 가격 문서 기준으로는 Gemini 2.5 Pro가 확인됩니다. Claude Sonnet도 지금은 Sonnet 4 계열 가격이 보이고요. GPT-4o는 OpenAI의 현재 메인 가격 페이지에서 전면 비교표로는 잘 안 보이지만, 공식 출시 글에서는 GPT-4 Turbo 대비 절반 가격이라고 명시했습니다. 이런 부분 때문에 저는 항상 현재 공개 가격표 + 출시 공지를 같이 봅니다. 안 그러면 글 쓰는 순간부터 정보가 낡아지거든요.

    2. 공식 문서 기준 단가 요약: GPT-4o 비용, Claude Sonnet 비용, Gemini Pro 비용

    제가 정리할 때는 무조건 표부터 만듭니다. 표로 놓고 보면 감이 빨리 오거든요.

    모델 입력 단가 출력 단가 캐시/배치 포인트 메모
    GPT-4o $5 / 1M tokens $15 / 1M tokens OpenAI Batch API는 공식 문서상 입력/출력 50% 절감 공식 출시 글의 “GPT-4 Turbo 대비 half the price”와 2023년 GPT-4 Turbo 공개 단가($10/$30 per 1M) 기준 역산
    Claude Sonnet 4 $3 / 1M tokens $15 / 1M tokens Prompt caching write $3.75 / read $0.30, batch 50% 절감 Anthropic 공개 가격표 기준
    Gemini 2.5 Pro $1.25 / 1M tokens (요청당 200k 이하) $10 / 1M tokens (요청당 200k 이하, thinking 포함) Batch/Flex에서 절반 수준, context caching 별도 200k 초과 요청은 입력 $2.50, 출력 $15

    여기서 중요한 포인트! 표만 보면 Gemini 2.5 Pro가 가장 저렴해 보입니다. 맞습니다. 다만 Google 쪽은 요청당 200k 토큰을 넘는지 여부가 단가에 직접 영향을 줍니다. 반대로 Claude Sonnet은 입력 단가가 괜찮고, 캐시 읽기 비용이 낮아서 반복되는 시스템 프롬프트(system prompt, 시스템 지시문)가 긴 서비스에서 꽤 유리할 수 있습니다.

    2-1. 실무 감각으로 보면 이렇게 해석하면 됩니다

    • 짧은 요청이 많다: Gemini 2.5 Pro가 눈에 띄게 유리할 가능성이 큽니다.
    • 긴 시스템 프롬프트를 반복한다: Claude Sonnet의 prompt caching이 꽤 매력적입니다.
    • 기존 OpenAI 생태계와 통합이 많다: GPT-4o는 운영 복잡도까지 포함하면 여전히 선택지가 됩니다.
    • 대량 비동기 작업: 세 벤더 모두 batch 계열 할인 전략을 꼭 봐야 합니다.

    3. 토큰 절감 개념: 쉽게 말해 “좋은 답”보다 “짧고 안정적인 답”이 먼저입니다

    저도 처음엔 프롬프트를 엄청 길게 썼습니다. 배경 설명 다 넣고, 예시 다 넣고, 제약 조건 다 넣고요. 근데 실제로 써보니까 비용은 폭발하고, 품질이 꼭 비례해서 좋아지지도 않더라고요. 삽질 좀 했습니다 ㅎㅎ

    토큰 절감은 생각보다 단순합니다.

    1. 시스템 프롬프트를 짧게 줄입니다.
    2. 긴 참고 문서는 전부 넣지 말고 필요한 조각만 넣습니다.
    3. 응답 길이를 제한합니다.
    4. 반복되는 접두 프롬프트는 캐시를 씁니다.
    5. 실시간이 필요 없는 작업은 batch로 돌립니다.

    쉽게 말해, “모델에게 말 많이 시키지 말고, 정확히 필요한 만큼만 말하게 하자”입니다. 이게 제일 잘 먹힙니다.

    4. 실전 구현: 비용 계산기를 먼저 붙이세요

    저는 새로운 모델을 붙일 때 제일 먼저 비용 계산 스크립트를 만듭니다. 감으로 운영하면 꼭 터집니다. 아래 예시는 아주 단순한 형태지만, 월간 예상 비용을 잡는 데 충분합니다.

    PRICING = {
        "gpt-4o": {
            "input_per_m": 5.0,
            "output_per_m": 15.0,
            "note": "Inferred from official OpenAI launch note: GPT-4o is half the price of GPT-4 Turbo"
        },
        "claude-sonnet-4": {
            "input_per_m": 3.0,
            "output_per_m": 15.0,
            "cache_read_per_m": 0.30,
            "cache_write_per_m": 3.75
        },
        "gemini-2.5-pro": {
            "input_per_m": 1.25,
            "output_per_m": 10.0,
            "input_per_m_over_200k": 2.50,
            "output_per_m_over_200k": 15.0,
            "cache_per_m": 0.125
        }
    }
    
    def estimate_cost(model, input_tokens, output_tokens, cached_input_tokens=0):
        p = PRICING[model]
        input_cost = (input_tokens / 1_000_000) * p["input_per_m"]
        output_cost = (output_tokens / 1_000_000) * p["output_per_m"]
        cache_cost = 0.0
    
        if model == "claude-sonnet-4":
            cache_cost = (cached_input_tokens / 1_000_000) * p["cache_read_per_m"]
        elif model == "gemini-2.5-pro":
            cache_cost = (cached_input_tokens / 1_000_000) * p["cache_per_m"]
    
        return round(input_cost + output_cost + cache_cost, 4)
    
    monthly = {
        "input_tokens": 12_000_000,
        "output_tokens": 3_000_000,
        "cached_input_tokens": 6_000_000
    }
    
    for model in PRICING:
        cost = estimate_cost(
            model,
            monthly["input_tokens"],
            monthly["output_tokens"],
            monthly["cached_input_tokens"]
        )
        print(model, cost)

    이런 식으로 먼저 숫자를 뽑아보면, 모델 성능 평가 전에 운영 가능한지부터 판단할 수 있습니다. 저는 이 단계에서 후보가 절반은 정리되더라고요.

    환경 변수로 모델 라우팅만 바꿔도 테스트하기 편합니다.

    export PRIMARY_MODEL="gemini-2.5-pro"
    export FALLBACK_MODEL="claude-sonnet-4"
    export HEAVY_REASONING_MODEL="gpt-4o"
    python cost_estimator.py
    AI API 비용 비교용 토큰 계산기와 라우팅 설정 이미지

    모델 라우팅과 토큰 비용 계산 스크립트를 함께 보여주는 구성 이미지입니다.

    5. 실전 구현 2: 라우팅 정책으로 비용을 깎는 방법

    진짜 비용 절감은 모델 자체보다 라우팅(routing, 요청을 어떤 모델로 보낼지 결정하는 정책)에서 나옵니다. 모든 요청을 제일 좋은 모델로 보내면 품질은 편할지 몰라도 비용은 바로 무너집니다.

    routing_policy:
      small_qa:
        model: gemini-2.5-pro
        max_input_tokens: 8000
        max_output_tokens: 1200
    
      cached_docs_qa:
        model: claude-sonnet-4
        use_prompt_cache: true
        max_input_tokens: 30000
        max_output_tokens: 2000
    
      complex_multistep:
        model: gpt-4o
        max_input_tokens: 50000
        max_output_tokens: 4000
    
      overnight_batch_jobs:
        mode: batch
        preferred_order:
          - gemini-2.5-pro
          - claude-sonnet-4
          - gpt-4o

    제가 실제로 이런 식으로 나누어 보니 효과가 컸습니다.

    • 짧은 FAQ, 분류, 요약 초안은 Gemini Pro 계열로 보냅니다.
    • 긴 시스템 프롬프트를 반복하는 문서형 질의응답은 Claude Sonnet으로 보냅니다.
    • 멀티스텝 추론이 길고 결과 실패 비용이 큰 작업만 GPT-4o로 올립니다.

    이렇게만 해도 월 비용이 꽤 내려갑니다. 드디어 됐다 싶은 순간이 여기서 오더라고요.

    6. ⚠️ 주의사항과 트러블슈팅: 가격표만 보고 결정하면 꼭 후회합니다

    첫 번째 문제는 “입력 단가만 보고 고르는 실수”입니다. 의외로 출력 토큰이 더 많이 나오는 워크로드가 많습니다. 예를 들어 코드 생성, 긴 보고서 초안, 상세 설명형 답변은 출력 비용 비중이 큽니다. Claude Sonnet과 GPT-4o는 입력보다 출력 단가가 높기 때문에 여기서 체감이 확 옵니다.

    두 번째 문제는 “Gemini는 싸니까 무조건 이득”이라고 보는 겁니다. 근데 요청당 200k 토큰을 넘기면 단가가 올라갑니다. 긴 문서를 통째로 넣는 RAG(Retrieval-Augmented Generation, 검색 결합 생성) 구성이라면 이 구간을 꼭 체크하셔야 합니다.

    세 번째 문제는 캐시를 붙여놓고도 프롬프트가 매번 조금씩 달라서 캐시 적중률(hit rate, 재사용 성공률)이 안 나오는 경우입니다. 저도 이걸 한동안 모르고 있었습니다. 날짜, 요청 ID, 불필요한 디버그 문자열이 앞단 프롬프트에 섞이면 캐시 이점이 거의 사라집니다.

    • 시스템 프롬프트는 고정 문자열로 분리하세요.
    • 사용자별 변동 값은 뒤쪽에 붙이세요.
    • 응답 길이 제한을 명시하세요. 예: “10줄 이내”, “JSON 필드만 반환”.
    • 실시간이 아닌 작업은 batch 전환부터 검토하세요.

    7. 검증/결과: 어떤 조합이 실제로 유리한가

    가정을 하나 두고 보면 감이 더 빨리 옵니다. 아래는 짧은 요청이 많고, 요청당 프롬프트가 200k 이하라는 전제로 본 대표적인 비교입니다.

    가정 GPT-4o Claude Sonnet 4 Gemini 2.5 Pro
    입력 1M + 출력 200k $8.00 $6.00 $3.25
    입력 10M + 출력 2M $80.00 $60.00 $32.50

    이 표만 보면 Gemini가 가장 저렴합니다. 다만 저는 여기서 바로 결론 내리진 않습니다. 실패 재시도 비용, 프롬프트 캐시 적중률, 모델별 응답 길이 성향까지 같이 봐야 하거든요. 실제로 써보니까 단가가 조금 비싸도 한 번에 원하는 포맷을 안정적으로 주는 모델이 전체 비용을 낮추는 경우도 있었습니다.
    AI API 비용 비교 결과와 토큰 절감 대시보드

    라우팅 적용 전후의 토큰 사용량과 월 비용 감소를 보여주는 대시보드 이미지입니다.

    7-1. 제가 추천하는 실무 선택 기준

    1. 최저 단가 우선이면 Gemini 2.5 Pro부터 시작합니다.
    2. 긴 고정 프롬프트 재사용이 많으면 Claude Sonnet을 강하게 검토합니다.
    3. OpenAI 도구 체인이나 기존 운영 자산이 이미 있으면 GPT-4o 유지 비용까지 포함해 판단합니다.
    4. 한 모델로 통일하지 말고 라우팅 정책을 분리합니다.

    8. 정리와 FAQ: 비용은 모델 선택보다 운영 방식에서 더 많이 갈립니다

    결론은 단순합니다. AI API 비용 비교에서 진짜 중요한 건 모델 팬심이 아니라 워크로드 분해입니다. 제가 직접 굴려보니, 같은 팀에서도 요청 유형이 다 다르기 때문에 모델 하나로 밀어붙이는 방식은 오래 못 갑니다. 비용 절감은 결국 짧게 묻기, 짧게 답하게 만들기, 캐시 쓰기, batch 쓰기, 라우팅 나누기 이 다섯 가지에서 나옵니다.
    AI API 비용 비교 요약 인포그래픽

    세 모델의 비용 구조와 추천 사용 시나리오를 요약한 인포그래픽 이미지입니다.

    자주 묻는 질문

    • Q. GPT-4o 비용은 공식 현재 페이지에 바로 안 보이는데 믿어도 되나요?
      A. 이 글의 GPT-4o 단가는 OpenAI의 2024년 5월 13일 공식 출시 글에서 “GPT-4 Turbo 대비 half the price”라고 밝힌 내용과, OpenAI의 2023년 11월 6일 GPT-4 Turbo 공식 단가를 조합해 계산한 값입니다.
    • Q. Claude Sonnet 비용은 왜 자주 추천되나요?
      A. 입력 단가가 무난하고 prompt caching 구조가 분명해서, 반복 프롬프트가 긴 서비스에 잘 맞기 때문입니다.
    • Q. Gemini Pro 비용이 가장 싸면 무조건 그걸 쓰면 되나요?
      A. 아닙니다. 요청당 200k 토큰 초과 구간, 응답 품질, 포맷 안정성까지 같이 봐야 합니다.

    다음 글에서는 RAG에서 청크 크기(chunk size) 조정만으로 토큰 비용 줄이는 방법을 다뤄보겠습니다. 이전 글 스타일로 이어서, 실제 로그 기준으로 어디서 토큰이 새는지도 같이 볼 예정입니다.
    참고한 공개 가격/공지

  • [3D프린터] 뱀부랩 P1P 1년 사용 후기와 유지보수 팁

    [3D프린터] 뱀부랩 P1P 1년 사용 후기와 유지보수 팁

    [3D프린터] 뱀부랩 P1P 1년 사용 후기와 유지보수 팁

    뱀부랩 P1P 사용 후기를 찾는 분들이 제일 궁금한 건 결국 하나더라고요. “그래서 1년 정도 굴려보면 만족하느냐, 아니면 손이 너무 많이 가느냐” 이 부분입니다. 저도 홈랩에 장비를 들일 때 늘 같은 기준으로 봅니다. 처음 며칠 반짝 잘 되는 장비보다, 몇 달 지나도 다시 켰을 때 예상대로 움직이는 장비가 진짜 좋은 장비거든요. 이번 글은 제가 실제로 뱀부랩 3D 프린터인 P1P를 길게 써보면서 느낀 장점, 아쉬운 점, 그리고 P1P 유지보수 루틴까지 한 번에 정리한 회고입니다.

    처음엔 단순히 “출력이 빠르다던데?” 정도로 접근했었는데, 실제로 써보니까 이 프린터는 속도보다 운영 편의성에서 인상이 강했습니다. 반대로, 잘 나올 때만 보면 좋은데 조금만 관리가 밀리면 품질이 흔들리는 구간도 분명 있었고요. 혹시 지금 구매를 고민 중이시거나, 이미 쓰고 있는데 점점 결과물이 미묘해지고 있다면 이 글이 꽤 현실적인 기준점이 될 겁니다.

    뱀부랩 P1P 사용 후기용 홈랩 실사용 환경과 출력물 개요 이미지

    홈랩 작업대 위에 놓인 뱀부랩 P1P와 지난 1년간 출력한 부품들을 한눈에 보여주는 이미지입니다.

    1. 뱀부랩 P1P를 1년 써보며 느낀 핵심: 빠른 프린터보다 운영이 쉬운 프린터

    쉽게 말해 P1P의 강점은 단순 스펙표보다 출력 준비부터 결과 확인까지의 흐름에 있습니다. 3D 프린터를 오래 만져보신 분들은 아시겠지만, 장비 자체보다도 슬라이서(Slicer, 3D 모델을 프린터용 경로로 변환하는 프로그램) 설정, 베드 접착, 필라멘트 상태, 노즐 오염 같은 주변 변수가 훨씬 크게 작동하거든요.

    제가 직접 해보니 뱀부랩 장단점 중 가장 큰 장점은 이 주변 변수를 꽤 많이 줄여준다는 점이었습니다. 모델 올리고, 슬라이싱하고, 보내고, 출력 상태 확인하는 흐름이 짧습니다. 이게 별거 아닌 것 같아도 실사용에선 엄청 큽니다. 반대로 아쉬운 점은 구조가 단순해 보여도 소모품 관리와 청소 주기를 놓치면 결과물 편차가 생각보다 빨리 올라온다는 점이었어요.

    • 장점: 출력 준비 시간이 짧고 반복 작업 스트레스가 적습니다.
    • 장점: 기본 생태계가 잘 맞물려 있어서 초반 진입 장벽이 낮습니다.
    • 아쉬운 점: 관리가 밀리면 갑자기 “왜 오늘은 이러지?” 싶은 순간이 옵니다.
    • 아쉬운 점: 오픈 프레임(Open Frame, 외부에 개방된 구조) 특성상 환경 영향을 아예 무시하긴 어렵습니다.

    2. 뱀부랩 P1P 사용 후기에서 많이 갈리는 포인트

    뱀부랩 P1P 사용 후기를 보다 보면 의견이 갈리는 이유가 있습니다. 이 장비는 첫 인상 점수와 장기 운영 점수가 조금 다르거든요. 처음에는 속도감, 앱 연동, 슬라이서 경험이 확실히 편합니다. 드디어 됐다 싶은 느낌이 있어요. 그런데 몇 달 지나고 나면 소음, 먼지, 필라멘트 보관, 정비 습관 같은 현실 이슈가 보이기 시작합니다.

    항목 처음 쓸 때 체감 1년쯤 썼을 때 체감
    출력 시작까지 매우 편함 여전히 편함
    출력 속도 체감 확실히 빠르게 느낌 품질과 소음을 함께 보게 됨
    유지보수 난이도 쉬워 보임 주기 관리가 중요함
    환경 영향 대수롭지 않아 보임 재료와 계절 따라 차이가 큼
    만족도 초반 만족도 높음 관리 습관이 만족도를 좌우

    여기서 중요한 포인트가 있습니다. P1P 유지보수는 고장 수리보다 편차 관리에 가깝습니다. 즉, 완전히 멈춰서는 장비가 아니라, 결과물이 서서히 미묘해지는 걸 잡아내는 게임에 더 가깝더라고요.

    3. 1년 실사용 기준으로 본 장점: 왜 계속 쓰게 되나

    3-1. 출력 시작이 빠르고 흐름이 끊기지 않습니다

    이건 정말 자주 체감했습니다. 예전엔 모델 하나 뽑으려 해도 “베드 닦았나? 프로파일 맞나? 첫 레이어 괜찮나?” 하면서 시작 전에 기운을 많이 썼거든요. P1P는 그 과정이 상대적으로 짧습니다. 그래서 작은 브래킷, 케이블 클립, 랙 마운트용 보조 부품 같은 걸 부담 없이 뽑게 되더라고요. 홈랩 운영하는 입장에선 이게 진짜 큽니다.

    3-2. 반복 출력 안정감이 좋았습니다

    제가 자주 뽑는 건 서버실 정리용 작은 부품, 라벨 홀더, 팬 가이드 같은 기능성 출력물인데요. 같은 파일을 다시 출력할 때 결과가 크게 튀지 않는 편이었습니다. 물론 완전히 무관리로 되는 건 아닙니다. 그래도 반복 가능성(Repeatability, 같은 조건에서 비슷한 결과를 내는 성질)이 괜찮았어요.

    3-3. 생태계가 정돈돼 있어 초보자 진입이 쉽습니다

    이 부분은 초보자에게 특히 중요합니다. 슬라이서에서 보내고, 프린터에서 받고, 진행 상태 보고, 실패하면 원인 범위를 좁히는 흐름이 매끄럽습니다. 3D 프린터를 처음 접하면 기계보다도 소프트웨어 흐름에서 막히는 경우가 많잖아요. P1P는 그 벽이 낮은 편입니다. 이거 진짜 편하더라고요.

    4. 아쉬운 점: 뱀부랩 장단점에서 꼭 같이 봐야 하는 부분

    4-1. 소음은 생각보다 존재감이 있습니다

    처음엔 “빠르니까 좀 시끄럽겠지” 정도로 넘겼는데, 실제로 장시간 돌려보면 체감이 분명합니다. 특히 작업실이 아니라 생활 공간 가까이 두면 더 느껴집니다. 저는 결국 출력 스케줄을 나눴습니다. 낮에 빠른 시제품, 밤에는 아예 멈추거나 보수적으로 돌리는 식으로요.

    4-2. 오픈 구조라 환경 영향을 덜 타는 건 아닙니다

    PLA 같은 재료는 비교적 편했지만, 주변 온도 변화나 바람, 필라멘트 상태에 따라 결과가 흔들리는 상황은 있었습니다. 이건 뱀부랩 3D 프린터라고 해서 완전히 예외는 아니더라고요. 특히 계절이 바뀔 때, 같은 설정인데 결과가 왜 다르지 싶었던 적이 몇 번 있었습니다.

    4-3. 너무 잘될 때 오히려 관리가 느슨해집니다

    이게 제일 큰 함정이었습니다. 몇 주 연속으로 잘 나오면 사람이 노즐 상태도 대충 보고, 베드 청소도 미루고, 필라멘트 건조도 설마 하면서 넘기게 되거든요. 저도 그랬습니다 ㅎㅎ 그러다 어느 날 첫 레이어가 이상하거나, 표면이 거칠어지거나, 미세한 스트링(Stringing, 실처럼 늘어나는 현상)이 늘어나면 그제야 청소를 하게 됩니다. 즉, 장비가 편해서 관리가 필요 없는 게 아니라, 편해서 관리 주기를 잊기 쉬운 장비에 가깝습니다.

    5. P1P 유지보수 루틴: 제가 실제로 정착시킨 방식

    이제부터는 실전입니다. 아래 루틴은 제가 1년 동안 써보면서 “이 정도는 해줘야 덜 흔들린다” 싶었던 최소 관리 기준입니다. 제조사 매뉴얼을 대체하는 내용이 아니라, 실사용 관점의 운영 루틴으로 봐주시면 됩니다.

    1. 출력 전 베드 상태 확인
    2. 주 1회 외관 먼지와 레일 주변 청소
    3. 주기적으로 노즐 상태와 압출 흔적 확인
    4. 필라멘트 보관 상태 점검
    5. 이상 징후를 로그처럼 기록

    저는 나중에 기억이 안 나서 삽질한 적이 많았습니다. 그래서 유지보수도 결국 로그를 남기게 되더라고요. 인프라 엔지니어 습관이 여기서도 나옵니다.

    printer: bambu_lab_p1p
    maintenance:
      daily:
        - clean_build_plate
        - inspect_first_layer
      weekly:
        - remove_dust_from_frame
        - inspect_belts_and_moving_parts
      monthly:
        - check_nozzle_wear
        - review_failed_print_history
    notes:
      filament_storage: dry_box
      issue_tracking: keep_photos_and_dates
    

    위처럼 YAML(야믈, 사람이 읽기 쉬운 설정 형식)로 적어두면 생각보다 편합니다. 저는 홈랩 노트에 비슷하게 남겨두고, 문제 생기면 날짜별로 비교했습니다.

    P1P 유지보수 체크포인트를 보여주는 뱀부랩 P1P 유지보수 이미지

    베드, 노즐, 레일, 필라멘트 보관함까지 유지보수 시 눈으로 확인하는 포인트를 정리한 이미지입니다.

    5-1. 베드 청소는 가장 단순하지만 가장 효과가 큽니다

    첫 레이어가 흔들리면 대부분 복잡한 설정부터 의심하게 되는데, 실제로 써보니까 베드 상태가 원인인 경우가 꽤 많았습니다. 손자국, 먼지, 미세한 잔여물만 있어도 접착이 달라지더라고요. 저는 출력이 연달아 들어가는 날엔 더 자주 봤습니다.

    # 홈랩 작업 로그 예시
    printf '%s | cleaned plate | PLA black\n' "$(date -u +%F)" >> p1p-maintenance.log
    printf '%s | checked first layer | OK\n' "$(date -u +%F)" >> p1p-maintenance.log
    

    물론 프린터가 bash를 실행하는 건 아니고요. 이런 식으로라도 기록을 남기면, “언제부터 이상했지?”를 추적하기 쉬워집니다.

    5-2. 노즐과 압출 상태는 결과물 표면으로 먼저 티가 납니다

    벽면이 거칠어지거나, 윗면 결이 갑자기 지저분해지거나, 실 같은 게 늘어나기 시작하면 노즐 오염이나 필라멘트 상태를 먼저 의심했습니다. 처음엔 이게 뭔가 싶었는데, 원인을 하나씩 지워보니 결국 압출 안정성 문제로 좁혀지는 경우가 많았어요.

    5-3. 필라멘트 상태는 생각보다 훨씬 중요합니다

    이건 P1P만의 문제는 아닙니다. 다만 프린터 자체가 잘 움직이면 사람은 결과물 문제를 기계 쪽으로만 보기 쉽거든요. 실제로는 재료 관리가 절반 이상인 날도 있습니다. 오래 둔 필라멘트, 습기 먹은 재료, 끝부분이 휘어진 상태 같은 게 누적되면 품질이 꽤 달라집니다.

    6. ⚠️ 실제로 겪었던 트러블슈팅: 제가 삽질했던 부분들

    6-1. 첫 레이어가 갑자기 불안정해진 경우

    증상은 단순했습니다. 어제까지 잘 붙던 출력물이 오늘은 한쪽이 들리거나, 모서리가 살짝 말리는 식이었어요. 처음엔 슬라이서 프로파일을 의심했는데, 결국은 베드 상태와 주변 환경 변화가 더 컸습니다.

    • 확인 순서 1: 베드 표면 청소 여부
    • 확인 순서 2: 필라멘트 상태
    • 확인 순서 3: 최근 출력 속도나 품질 설정 변화
    • 확인 순서 4: 방 안 온도, 바람, 문 개폐

    이 순서로 보면 생각보다 빨리 원인이 좁혀집니다. 저도 처음엔 설정만 뒤집어엎다가 시간을 많이 날렸습니다.

    6-2. 표면이 거칠고 소리가 평소와 다를 때

    출력 중 소리가 평소보다 거칠게 들릴 때가 있었습니다. 그럴 땐 무조건 끝까지 기다리지 않고 중간 확인을 했습니다. 노즐 주변 오염, 필라멘트 이송 저항, 먼지 누적 같은 기본 요소부터 봤고요. 경험상 이런 건 초기에 멈추고 보는 게 시간 절약입니다.

    6-3. 잘 나오던 파일이 갑자기 실패할 때

    이럴 때 제일 당황스럽죠. “파일은 같은데 왜?” 싶은 상황이요. 그런데 인프라 운영이랑 비슷합니다. 같은 서비스도 환경이 달라지면 결과가 달라지잖아요. 프린터도 마찬가지였습니다. 파일보다 상태(State, 현재 장비와 재료의 실제 상태)를 먼저 봐야 하더라고요.

    troubleshooting_order:
      - build_plate_condition
      - filament_dry_state
      - nozzle_cleanliness
      - slicer_changes
      - ambient_temperature
      - retry_small_test_piece
    

    저는 실패가 나면 큰 모델 바로 재시도하지 않고, 작은 테스트 피스로 먼저 확인했습니다. 이 습관 하나로 시간과 필라멘트를 꽤 아꼈습니다. 💡

    7. 검증과 결과: 유지보수 루틴을 넣고 나서 달라진 점

    유지보수 루틴을 정착시키고 나서 제일 달라진 건 실패율 자체보다 예측 가능성이었습니다. 이전에는 “왜 안 되지?”가 먼저 나왔다면, 지금은 “아 이건 베드/필라멘트/노즐 중 하나겠다”로 바로 범위를 좁힙니다. 그 차이가 큽니다.

    실제로 써보니까 좋은 장비의 기준은 출력물이 예쁘게 나오는 순간보다, 문제가 생겼을 때 원인을 추적하기 쉬운가에 더 가깝더라고요. P1P는 그 점에서 꽤 높은 점수를 주고 싶습니다. 완전 무결한 장비는 아니지만, 관리 포인트만 잡히면 다시 안정 구간으로 복귀시키기 수월했습니다. ✅

    뱀부랩 P1P 사용 후기에서 출력 품질 비교를 보여주는 결과 이미지

    유지보수 전후의 첫 레이어 안정감과 표면 품질 차이를 시각적으로 비교하는 이미지입니다.

    비교 항목 루틴 없을 때 루틴 정착 후
    문제 발생 시 대응 설정부터 건드림 원인 후보를 순서대로 점검
    출력 재시도 방식 큰 모델 바로 재출력 작은 테스트 피스로 먼저 확인
    품질 편차 체감 원인 파악이 늦음 이상 징후를 초기에 발견
    운영 스트레스 실패 때 피로감 큼 복구 루틴이 생겨 부담 감소

    이 부분이 제가 생각하는 뱀부랩 장단점의 결론이기도 합니다. 장점은 분명하고, 그 장점을 오래 유지하려면 기본 관리가 필요하다. 굉장히 현실적인 장비예요.

    8. 정리와 FAQ: 이런 분께 특히 잘 맞습니다

    정리해보면, 뱀부랩 P1P 사용 후기는 대체로 긍정적이지만 아무한테나 무조건 추천하는 장비는 아닙니다. “세팅 스트레스를 줄이고 싶다”는 분께는 잘 맞고, “완전 방치형 자동 장비”를 기대하면 아쉬울 수 있습니다. 저는 홈랩에서 기능성 출력물을 자주 뽑는 편이라 만족도가 높았습니다. 반면, 출력 환경 관리가 어려운 공간이라면 오픈 프레임 특성을 같이 고려하셔야 합니다.

    • 이런 분께 추천: 반복 출력이 많고, 운영 편의성을 중시하는 분
    • 이런 분은 체크 필요: 소음과 주변 환경 영향에 민감한 분
    • 핵심 팁: 설정 튜닝보다 먼저 청소, 소모품, 필라멘트 상태를 보세요

    FAQ

    Q. 뱀부랩 P1P 1년 써도 만족스럽나요?
    A. 네, 다만 만족도의 전제는 있습니다. 기본 유지보수 루틴을 지킨다는 조건에서는 만족도가 높았습니다. 방치하면 편차가 올라오더라고요.

    Q. P1P 유지보수에서 가장 먼저 챙길 건 뭔가요?
    A. 베드 청소와 첫 레이어 확인입니다. 가장 단순한데 체감 효과가 제일 컸습니다.

    Q. 뱀부랩 3D 프린터 입문용으로 괜찮을까요?
    A. 진입 자체는 괜찮은 편입니다. 다만 3D 프린팅은 결국 재료와 환경 관리가 같이 간다는 점은 꼭 알고 시작하시는 게 좋습니다.

    다음 글에서는 필라멘트 건조와 보관 루틴을 따로 묶어서 다뤄볼까 합니다. 이전 글에서 다뤘던 홈랩 장비 정리 방식과도 연결되는 부분이 있어서, 같이 보시면 운영 감각 잡는 데 도움이 될 거예요. 🎉

    뱀부랩 장단점과 P1P 유지보수 요약을 담은 인포그래픽 이미지

    1년 실사용 기준으로 정리한 장점, 아쉬운 점, 추천 대상, 유지보수 포인트를 요약한 이미지입니다.

  • [HomeLabs] 홈랩 Matter 통합, 흔히 겪는 문제와 해결책: 디버깅 로그 분석

    [HomeLabs] 홈랩 Matter 통합, 흔히 겪는 문제와 해결책: 디버깅 로그 분석

    [스마트홈] 홈랩 Matter 통합, 흔히 겪는 문제와 해결책: 디버깅 로그 분석

    안녕하세요, 13년차 서버실 지킴이입니다! 💡 오랜만에 홈랩 이야기로 찾아왔네요. 요즘 스마트홈 좀 꾸며보셨다는 분들, Matter 프로토콜 이야기는 한 번쯤 들어보셨을 겁니다. 저도 한참 전부터 기대하고 있었던 표준인데, 드디어 우리 홈랩에서도 Matter 통합을 시도해볼 만한 환경이 되었죠.

    하지만… 왠지 쉽게 될 것 같다는 기대는 늘 배신당하는 법 아니겠습니까? 😅 저도 처음엔 ‘오, 이제 모든 기기가 한 번에 연결되겠네!’ 하며 의기양양하게 시작했는데, 역시나 삽질 좀 했습니다. 특히 기기가 제대로 연결되지 않거나, 연결은 된 것 같은데 제어가 안 될 때 정말 답답하더라고요. 이럴 때 필요한 게 바로 디버깅 로그 분석입니다. 오늘은 제가 직접 겪었던 Matter 오류 해결 경험을 바탕으로, 어떻게 디버깅 로그를 파고들었는지 자세히 알려드릴게요. 혹시 저처럼 고생하고 계신 분들이 있다면, 이 글이 조금이나마 도움이 되었으면 좋겠습니다!

    Matter 프로토콜의 개요와 홈랩 통합 아키텍처 다이어그램

    Matter는 다양한 스마트홈 기기들이 서로 다른 제조사나 플랫폼에 얽매이지 않고 원활하게 통신할 수 있도록 설계된 개방형 표준입니다. 홈랩에 Matter를 통합하는 기본적인 아키텍처를 보여줍니다.

    Matter 프로토콜, 쉽게 말해 스마트홈 만능 통역사

    자, 먼저 Matter 프로토콜이 뭔지 간략하게 짚고 넘어갈까요? 쉽게 말해, Matter는 스마트홈 기기들을 위한 ‘만능 통역사’ 같은 겁니다. 예전에는 삼성 기기는 SmartThings, 애플 기기는 HomeKit, 구글 기기는 Google Home 등 각자 다른 언어를 써서 서로 소통하기 어려웠잖아요? 그런데 Matter는 이 모든 기기들이 공통으로 이해할 수 있는 언어(프로토콜)를 만들어 준 거죠. 그래서 제조사에 상관없이 스마트홈 연동이 훨씬 쉬워지고 사용자 경험도 좋아질 거라고 기대를 모으고 있습니다.

    홈랩에서는 보통 Home Assistant 같은 오픈소스 스마트홈 플랫폼을 Matter 컨트롤러(Controller)로 사용하곤 합니다. 이 컨트롤러가 Matter 장치(Device)들을 검색하고, 커미셔닝(Commissioning, 장치 등록 과정)을 수행해서 네트워크에 편입시키는 역할을 하죠. 하지만 이 과정에서 문제가 생기는 경우가 허다합니다.

    실전 구현: Home Assistant와 Matter 통합하기 (feat. 삽질 예고)

    저는 Home Assistant OS를 사용하고 있어서, Matter 통합을 위해 공식 Matter 애드온(Add-on)을 설치했습니다. 설치 과정 자체는 어렵지 않아요. Home Assistant의 Supervisor 메뉴에서 Matter 애드온을 찾아서 설치하고 시작하면 됩니다. 문제는 그 다음부터였죠. 애드온이 잘 실행되는 것 같아도, 실제 Matter 기기를 연결하려고 하면 뜻대로 안 되는 경우가 많았습니다.

    일반적인 Matter 장치 연결 절차는 다음과 같습니다.

    1. Matter 장치 전원 켜기 (페어링 모드 진입)
    2. Home Assistant에서 Matter 통합 설정 시작
    3. 장치의 QR 코드 또는 설정 코드(Setup Code) 입력
    4. 네트워크에 연결 및 커미셔닝

    여기서 3단계까지는 어떻게든 가는데, 4단계에서 멈추거나 실패하는 경우가 많더라고요. 특히 Thread 네트워크 기반의 Matter 장치는 Thread 보더 라우터(Border Router)가 필수적인데, 이 설정이 제대로 안 되어 있으면 헤매기 십상입니다. Home Assistant의 Matter 애드온은 자체적으로 Thread 보더 라우터 기능을 포함하고 있거나, 기존 Thread 네트워크와 연동할 수 있도록 설계되어 있습니다.

    Home Assistant의 Matter 통합 설정 화면 스크린샷

    Home Assistant에서 Matter 애드온을 설치하고, 새로운 Matter 기기를 추가하는 설정 화면을 보여줍니다. QR 코드 스캔 또는 수동 코드 입력 옵션이 강조되어 있습니다.

    ⚠️ 삽질 경험: 흔히 겪는 Matter 통합 문제와 디버깅 로그 분석

    제가 겪었던 대표적인 문제들과 그 해결 과정, 그리고 핵심인 디버깅 로그 분석 방법을 공유해볼게요.

    1. 장치 검색 실패 (Device Discovery Failure)

    가장 흔한 문제입니다. 분명히 Matter 기기는 페어링 모드인데, Home Assistant에서 아무리 찾아도 나타나지 않는 경우죠. 이때는 먼저 다음을 확인해야 합니다.

    • Matter 장치와 Home Assistant가 동일한 네트워크에 있는지?
    • 네트워크 방화벽이 Matter 통신에 필요한 포트(예: UDP 5353, TCP 5540)를 막고 있지는 않은지?
    • Thread 네트워크를 사용하는 장치라면, Thread 보더 라우터가 정상 작동하는지? (예: Home Assistant의 Open Thread Border Router 애드온 상태 확인)

    로그에서는 보통 다음과 같은 메시지를 찾아볼 수 있습니다.

    
    [homeassistant.components.matter.discovery] No Matter devices found during discovery
    [chip.MDNS] Failed to resolve service: _matter._tcp.local. (Timeout)
    

    No Matter devices found나 Failed to resolve service 같은 메시지는 네트워크 단에서 장치 검색이 제대로 이루어지지 않고 있다는 강력한 증거입니다. 이럴 땐 Wi-Fi 공유기 설정이나 방화벽 규칙을 다시 확인해야 합니다.

    2. 커미셔닝 실패 (Commissioning Failure)

    장치는 검색했는데, QR 코드를 스캔하거나 코드를 입력한 후 ‘연결 중…’ 상태에서 한참을 기다리다 실패하는 경우입니다. 이게 제일 속 터지는 상황이죠. 😤

    이때는 Home Assistant의 Matter 애드온 로그를 더 자세히 들여다봐야 합니다. 보통 Home Assistant의 ‘설정’ > ‘로그’ 메뉴나 ‘Supervisor’ > ‘Matter 애드온’ > ‘로그’ 탭에서 확인할 수 있습니다.

    주로 나타나는 오류 메시지 유형은 다음과 같습니다.

    • TLS 핸드셰이크 실패 (TLS Handshake Failure): 보안 통신 채널을 수립하는 과정에서 문제가 발생한 겁니다. 장치와 컨트롤러 간의 시간 동기화 문제, 또는 펌웨어 버전 문제일 수 있습니다.
    • PASE/CASE 실패 (PASE/CASE Failure): Matter의 초기 보안 페어링 과정(Password-Authenticated Session Establishment)이나 재연결 과정(Certificate-Authenticated Session Establishment)에서 문제가 생긴 경우입니다. 잘못된 설정 코드 입력, 장치 초기화 필요 등의 원인이 있습니다.
    • 네트워크 연결 문제 (Network Connectivity Issues): 커미셔닝 중간에 장치가 네트워크에서 떨어져 나가는 경우입니다. Wi-Fi 신호 강도, IP 주소 할당 문제 등을 점검해야 합니다.

    실제 로그 예시는 이렇습니다.

    
    [chip.Commissioning] Commissioning failed: Error: Status: 0x00000001 (CHIP_ERROR_BAD_REQUEST)
    [chip.Commissioning] Commissioning state machine failed with error: CHIP_ERROR_TLS_HANDSHAKE_FAILED
    [homeassistant.components.matter.controller] Failed to commission device with node ID 12345: CHIP_ERROR_PASE_FAILURE
    

    CHIP_ERROR_BAD_REQUEST는 일반적인 오류 메시지이지만, 뒤따라오는 CHIP_ERROR_TLS_HANDSHAKE_FAILED나 CHIP_ERROR_PASE_FAILURE는 특정 단계에서 문제가 발생했음을 알려줍니다. 이럴 때는 장치를 공장 초기화(Factory Reset)하고 다시 시도해보는 것이 가장 빠를 때가 많습니다. 저도 이걸로 몇 번 진땀 뺐거든요.

    3. 장치 제어 불가 (Device Control Failure)

    오, 드디어 연결은 됐어요! 🎉 Home Assistant에 장치가 나타나고, 엔티티(Entity)도 생성되었습니다. 근데 불을 켜거나 끄려고 하면 아무 반응이 없거나, 상태가 제대로 업데이트되지 않는 경우가 있습니다.

    이건 주로 장치와 컨트롤러 간의 통신 채널에 문제가 있거나, 장치가 Matter 표준을 완전히 준수하지 못하는 경우에 발생할 수 있습니다.

    로그에서는 다음과 같은 메시지를 찾아볼 수 있습니다.

    
    [chip.App] Failed to send command to node 12345: Error: Status: 0x00000001 (CHIP_ERROR_BAD_REQUEST)
    [homeassistant.components.matter.device] Device 12345 does not respond to attribute read request
    

    Failed to send command나 does not respond to attribute read request는 장치와의 실제 상호작용에 문제가 있다는 뜻입니다. 이런 경우엔 장치 펌웨어 업데이트 여부를 확인하고, Matter 애드온을 재시작해보거나, 최후의 수단으로 재커미셔닝을 시도해보는 수밖에 없습니다.

    저의 경험상, Matter는 아직 초기 단계라 이런 자잘한 버그나 호환성 문제가 꽤 있습니다. 너무 좌절하지 마시고, 끈기를 가지고 로그를 파고드는 게 중요합니다. 그리고 꼭 최신 펌웨어를 유지하는 것이 좋습니다!

    ✅ 디버깅 로그 분석 팁과 검증

    디버깅 로그를 분석할 때는 몇 가지 팁이 있습니다.

    1. 로그 레벨 조정: Home Assistant의 Matter 애드온 설정에서 로그 레벨을 DEBUG로 높이면 더 상세한 정보를 얻을 수 있습니다. 하지만 너무 많은 로그는 오히려 혼란을 줄 수 있으니 필요한 경우에만 사용하세요.
    2. 타임스탬프 확인: 문제가 발생한 시점의 로그를 정확히 찾아내는 것이 중요합니다. 타임스탬프를 유심히 살펴보세요.
    3. 키워드 검색: ERROR, FAILED, CHIP_ERROR, Matter, Commissioning 등의 키워드로 검색하면 관련 로그를 빠르게 찾을 수 있습니다.
    4. 공식 문서 참고: Matter 공식 문서나 Home Assistant 커뮤니티 포럼에서 비슷한 오류 메시지를 검색해보면 해결책을 찾을 수 있을 때가 많습니다.

    모든 삽질 끝에 드디어 Matter 장치가 Home Assistant에 성공적으로 연동되고, 제가 원하는 대로 제어될 때의 그 쾌감이란! 🥳 불필요한 오류 메시지 없이 깨끗하게 동작하는 로그를 보면 비로소 안심이 됩니다. 이제 홈랩이 한 단계 더 스마트해진 거죠.

    Home Assistant 대시보드에서 Matter 장치가 정상적으로 작동하는 모습

    Matter를 통해 연결된 스마트 플러그나 전구 등의 장치가 Home Assistant 대시보드에 표시되고, 상태가 실시간으로 업데이트되며 제어가 가능한 상태를 보여주는 스크린샷입니다.

    마무리하며: Matter, 아직은 성장통이지만 기대되는 미래

    오늘은 홈랩 Matter 통합 과정에서 제가 직접 겪었던 문제들과 디버깅 로그 분석을 통한 오류 해결 경험을 공유해드렸습니다. 솔직히 Matter는 아직 완벽하지 않습니다. 초기 표준이다 보니 다양한 제조사의 기기들이 각자의 방식으로 구현하면서 발생하는 자잘한 버그와 호환성 문제가 많거든요. 저도 수많은 삽질 경험을 했고, 멘붕도 여러 번 왔었습니다.

    하지만 그럼에도 불구하고 Matter는 스마트홈 연동의 미래를 바꿀 강력한 표준임에 틀림없습니다. 제조사에 얽매이지 않는 진정한 의미의 스마트홈을 구축할 수 있게 해줄 테니까요. 지금은 조금 힘들어도, 꾸준히 펌웨어 업데이트를 주시하고, 문제가 생기면 로그를 꼼꼼히 살펴보며 해결해나가는 노력이 필요합니다. 이것이 바로 13년차 인프라 엔지니어의 숙명이자 홈랩의 재미 아니겠습니까? 😉

    다음 글에서는 아마 Thread 보더 라우터 구성에 대한 더 깊은 이야기를 다루게 될 것 같네요. 그때까지 여러분의 스마트홈도 평화롭기를 바랍니다! 궁금한 점이 있다면 언제든 댓글로 남겨주세요.

    Matter 디버깅 및 트러블슈팅 흐름도 또는 주요 오류 코드 요약표

    Matter 장치 통합 시 발생할 수 있는 일반적인 문제 유형과 그에 따른 디버깅 및 해결책을 요약한 흐름도 또는 표입니다. 주요 오류 코드와 그 의미를 담고 있습니다.

  • [Nas] Cloudflare NAS 원격 접속: Tunnel 연결 오류 디버깅 완벽 가이드

    [Nas] Cloudflare NAS 원격 접속: Tunnel 연결 오류 디버깅 완벽 가이드

    안녕하세요, 13년차의 서버실입니다!

    오늘은 제 홈랩에서 개인 NAS(Network Attached Storage)를 원격으로 안전하게 접속하려고 Cloudflare Tunnel(클라우드플레어 터널)을 구축하다가 겪었던 ‘삽질 경험’과 그 해결 과정을 솔직하게 공유해보려고 합니다. 혹시 저처럼 Cloudflare Tunnel로 NAS 원격 접속을 시도하다가 연결 오류에 막혀본 적 있으신가요? 그렇다면 이 글이 많은 도움이 될 거라고 생각합니다.

    예전에는 VPN이나 포트 포워딩으로 NAS에 접속했었는데, 보안이나 설정의 복잡성 때문에 늘 고민이 많았거든요. 그러다 Cloudflare Tunnel이라는 아주 매력적인 솔루션을 알게 되었고, ‘이거다!’ 싶어서 바로 적용에 들어갔죠. Public IP(공인 IP) 없이도 안전하게 내부 서비스에 접근할 수 있다는 점이 정말 환상적이었어요. 그런데 막상 구축을 시작하니 생각지 못한 곳에서 오류가 터지면서 삽질 좀 했습니다. ㅎㅎ

    제가 어떤 문제에 부딪혔고, 어떻게 해결했는지 그 과정을 상세하게 풀어보겠습니다. 이 경험이 독자 여러분의 소중한 시간을 절약하는 데 기여했으면 좋겠습니다. 자, 그럼 시작해볼까요?

    Cloudflare Tunnel을 이용한 NAS 원격 접속 전체 아키텍처 개념도

    Cloudflare Tunnel과 Zero Trust, NAS 원격 접속의 조합

    먼저, 핵심 개념들을 간단하게 짚고 넘어가죠. 이 세 가지 기술이 어떻게 시너지를 내는지 이해하는 것이 중요합니다.

    • Cloudflare Tunnel (클라우드플레어 터널): 쉽게 말해, 외부에서 내부 네트워크로 안전하게 연결할 수 있는 ‘터널’을 만들어주는 서비스입니다. 우리 집 NAS나 서버가 공인 IP가 없어도, 심지어 방화벽 뒤에 있어도 Cloudflare의 엣지 네트워크를 통해 외부와 통신할 수 있게 해줘요. 내부에서 외부로 나가는 연결만 허용하면 되기 때문에 방화벽 설정도 훨씬 간단해집니다.
    • Zero Trust (제로 트러스트): ‘절대 아무것도 신뢰하지 않고, 항상 검증한다’는 보안 모델입니다. 전통적인 ‘경계 기반 보안’이 내부 네트워크는 안전하다고 가정했다면, Zero Trust는 내부 네트워크에 있더라도 모든 접근에 대해 사용자, 장치, 애플리케이션을 철저히 검증하죠. Cloudflare Zero Trust 플랫폼은 이 개념을 구현하는 강력한 도구거든요.
    • NAS (Network Attached Storage): 네트워크에 연결된 저장 장치입니다. 제 홈랩에서도 중요한 역할을 하는 녀석이죠. 사진, 동영상, 문서 등 개인 데이터를 저장하고, 미디어 서버나 백업 솔루션으로도 활용합니다.

    이 세 가지를 조합하면, Public IP 없이도 NAS에 안전하게 원격 접속할 수 있고, Zero Trust 모델을 통해 누가 언제 어디서 접속하는지까지 통제할 수 있게 됩니다. 기존의 VPN보다 훨씬 유연하고 강력한 보안 환경을 구축할 수 있다는 게 저의 오랜 경험상 가장 큰 장점이라고 생각합니다.

    Cloudflare Tunnel 설정부터 NAS 연결까지 차근차근

    이제 실제로 Cloudflare Tunnel을 설정하고 NAS에 연결하는 과정을 단계별로 설명해드릴게요. 제가 진행했던 순서 그대로입니다.

    1. Zero Trust 대시보드에서 Tunnel 생성

    1. Cloudflare Zero Trust 대시보드(one.dash.cloudflare.com)에 접속합니다.
    2. 좌측 메뉴에서 Access > Tunnels로 이동합니다.
    3. Create a tunnel 버튼을 클릭하고, Tunnel 이름을 지정합니다. 저는 my-nas-tunnel이라고 지었어요.
    4. 화면에 표시되는 설치 가이드를 따라 cloudflared를 설치할 운영체제를 선택합니다.

    만약 CLI(명령줄 인터페이스)로 Tunnel을 만들고 싶다면 다음과 같이 입력할 수 있습니다.

    # Cloudflare CLI 설치 (처음이라면) - OS에 따라 다름
    # curl -L --output cloudflared-linux-amd64 https://github.com/cloudflare/cloudflared/releases/latest/download/cloudflared-linux-amd64
    # chmod +x cloudflared-linux-amd64
    # sudo mv cloudflared-linux-amd64 /usr/local/bin/cloudflared
    
    # Tunnel 생성 (CLI로)
    cloudflare tunnel create my-nas-tunnel
    

    Tunnel을 생성하면 화면에 token이 표시되는데, 이 토큰을 잘 복사해두세요. NAS에 cloudflared를 설치할 때 필요합니다.

    2. NAS에 Cloudflared 설치 및 실행

    NAS의 운영체제에 따라 cloudflared 설치 방법이 조금 다를 수 있습니다. 저는 주로 Debian/Ubuntu 기반의 리눅스 서버나 Docker를 사용하기 때문에 해당 기준으로 설명해드릴게요.

    1. Linux (Debian/Ubuntu 기반):
    2. # cloudflared 패키지 다운로드 및 설치
      curl -L --output cloudflared.deb https://github.com/cloudflare/cloudflared/releases/latest/download/cloudflared-linux-amd64.deb
      sudo dpkg -i cloudflared.deb
      
      # 시스템 서비스로 등록 및 실행 (위에서 복사한 토큰 사용)
      sudo cloudflared service install 
      
      # 서비스 시작
      sudo systemctl start cloudflared
      
      # 서비스 상태 확인
      sudo systemctl status cloudflared
      
    3. Docker 사용 시:
    4. Docker Compose를 사용하는 것이 편리합니다. docker-compose.yml 파일을 다음과 같이 작성할 수 있습니다.

      version: '3.8'
      services:
        cloudflared:
          image: cloudflare/cloudflared:latest
          container_name: cloudflared
          restart: unless-stopped
          command: tunnel run --token 
          network_mode: host # 중요: NAS의 다른 서비스에 접근하기 위해 host 네트워크 사용
      

      이후 docker-compose up -d 명령으로 실행합니다.

    정상적으로 실행되면 Cloudflare Zero Trust 대시보드에서 Tunnel의 상태가 ‘Healthy’로 표시될 겁니다. ✅

    Cloudflare Zero Trust 대시보드의 Tunnel 설정 화면 (Ingress 규칙)

    Cloudflare Zero Trust 대시보드의 Tunnel 설정 화면 (Ingress 규칙)

    3. Ingress(인그레스) 규칙 설정

    이제 가장 중요한 Ingress 규칙을 설정할 차례입니다. 이 규칙은 어떤 요청을 어느 내부 서비스로 보낼지 정의하는 역할을 합니다. NAS의 cloudflared가 실행되는 서버에 ~/.cloudflared/config.yaml 파일을 생성하거나 수정해야 합니다.

    # ~/.cloudflared/config.yaml
    
    tunnel:  # Tunnel 생성 시 부여된 UUID
    credentials-file: /root/.cloudflared/.json # 자격 증명 파일 경로
    
    ingress:
      - hostname: nas.yourdomain.com # NAS에 접속할 도메인
        service: http://192.168.1.100:5000 # NAS의 내부 IP와 서비스 포트 (예: Synology DSM 기본 포트)
        originRequest:
          noTLSVerify: true # NAS가 HTTPS를 사용하지 않거나 자체 서명 인증서일 경우 필수!
      - service: http_status:404 # 모든 요청이 위 규칙에 해당하지 않으면 404 반환
    

    파일을 저장한 후, cloudflared 서비스를 재시작해야 변경 사항이 적용됩니다.

    sudo systemctl restart cloudflared # Linux 서비스의 경우
    # docker-compose restart cloudflared # Docker Compose의 경우
    

    4. DNS 레코드 설정

    마지막으로, Cloudflare 대시보드에서 NAS에 연결할 도메인(nas.yourdomain.com)이 위에서 생성한 Tunnel로 트래픽을 라우팅하도록 DNS 레코드를 설정해야 합니다. Zero Trust 대시보드의 Tunnel 설정 화면에서 ‘Public Hostname’을 추가하거나, CLI로 설정할 수 있습니다.

    cloudflare tunnel route dns my-nas-tunnel nas.yourdomain.com
    

    이 명령을 실행하면 Cloudflare DNS에 CNAME 레코드가 자동으로 생성되어 해당 도메인으로 들어오는 트래픽이 Tunnel로 연결됩니다.

    ⚠️ 삽질 경험: 터널 설정 오류 디버깅 포인트!

    자, 이제 제가 가장 많이 헤매고 삽질했던 포인트들을 공유할 시간입니다. 아마 많은 분들이 여기서 비슷한 문제를 겪으셨을 거예요.

    1. noTLSVerify 옵션의 중요성 (그리고 제 실수)

    제가 가장 먼저 부딪힌 문제는 바로 이 noTLSVerify 옵션이었습니다. Ingress 규칙에 service: http://192.168.1.100:5000이라고 분명히 HTTP로 설정했는데도 계속 502 Bad Gateway 에러가 뜨는 거예요. ‘아니, NAS는 HTTPS 안 쓰는데 왜 이러지?’ 하고 한참을 헤맸습니다.

    알고 보니 Cloudflare Tunnel은 기본적으로 Origin(원본 서버, 즉 NAS)과의 통신을 HTTPS로 시도하려고 합니다. 그런데 제 NAS는 HTTPS를 사용하지 않거나, 자체 서명 인증서를 사용하고 있었던 거죠. 이럴 경우 Tunnel이 NAS의 인증서를 신뢰하지 못해서 연결에 실패하게 됩니다. 해결책은 originRequest 아래에 noTLSVerify: true를 추가하여 TLS(전송 계층 보안) 검증을 건너뛰도록 하는 것이었습니다. 이 옵션을 추가하니 거짓말처럼 연결이 되더라고요! 🎉

    💡 팁: 보안상 가능하면 NAS도 정식 HTTPS 인증서를 적용하고 noTLSVerify: false(또는 제거)로 설정하는 것이 좋습니다. 하지만 홈랩 환경에서는 편의상 이 옵션을 사용할 때가 많죠.

    2. 서비스 포트 불일치

    두 번째 삽질은 NAS의 실제 서비스 포트와 Ingress 규칙에 설정한 포트가 달라서 생긴 문제였습니다. 예를 들어 Synology NAS의 DSM(DiskStation Manager)은 기본적으로 5000번(HTTP) 또는 5001번(HTTPS) 포트를 사용하는데, 제가 다른 서비스 포트를 실수로 입력해놓은 적이 있었어요. 브라우저에서 NAS 내부 IP로 접속하면 잘 되는데, Cloudflare Tunnel을 통하면 접속이 안 되니 ‘Tunnel 문제인가?’ 하고 엉뚱한 곳을 파고 있었죠. 😅

    NAS의 관리 페이지나 다른 서비스(Plex, Photo Station 등)에 접근할 때는 반드시 해당 서비스가 사용하는 정확한 내부 포트를 Ingress 규칙의 service 필드에 명시해야 합니다. http://localhost:5000 대신 http://[NAS_내부_IP]:[포트]처럼 명시적으로 내부 IP를 사용하는 것이 더 안전하고 명확합니다.

    3. DNS 레코드 미설정 또는 오설정

    Tunnel과 Ingress 규칙을 완벽하게 설정했다고 생각했는데도 접속이 안 된다면, DNS 레코드 설정을 다시 확인해보세요. Cloudflare Tunnel은 도메인에 대한 트래픽을 Tunnel로 라우팅하기 위해 CNAME 레코드가 필요합니다. 만약 이 레코드가 없거나 잘못 설정되어 있다면, 브라우저가 NAS 도메인으로 접속하려 해도 트래픽이 Tunnel로 들어오지 못하게 됩니다. 위에서 언급한 cloudflare tunnel route dns 명령어를 사용하거나 Cloudflare 대시보드에서 직접 CNAME 레코드를 확인해보세요.

    4. cloudflared 서비스 로그 확인의 중요성

    문제가 발생했을 때 가장 먼저 해야 할 일은 cloudflared 서비스의 로그를 확인하는 것입니다. Linux 시스템에서는 sudo journalctl -u cloudflared -f 명령으로 실시간 로그를 볼 수 있고, Docker 컨테이너를 사용한다면 docker logs -f cloudflared 명령으로 확인할 수 있습니다. 저도 위에서 언급한 noTLSVerify 문제를 로그에서 Error: x509: certificate signed by unknown authority와 같은 메시지를 보고 나서야 해결 실마리를 찾을 수 있었습니다. 로그는 항상 진실을 말해주거든요!

    🎉 드디어 NAS 원격 접속 성공!

    수많은 삽질 끝에 드디어 제 NAS가 https://nas.yourdomain.com으로 외부에서 완벽하게 접속되는 순간, 그 쾌감이란…! 🎉 Zero Trust 대시보드에서 Tunnel의 상태가 Healthy로 초록불이 들어오고, 트래픽이 정상적으로 흐르는 것을 확인했을 때의 안도감은 인프라 엔지니어만이 아는 뿌듯함이죠. 이제 언제 어디서든 제 NAS에 안전하게 접속하여 파일을 관리하고, 미디어를 스트리밍할 수 있게 되었습니다.

    Cloudflare Zero Trust 대시보드에서 확인한 Tunnel의 정상 작동 상태

    Cloudflare Zero Trust 대시보드에서 확인한 Tunnel의 정상 작동 상태

    마치며: 안전한 홈랩을 위한 Cloudflare Tunnel

    오늘은 Cloudflare Tunnel을 이용해 NAS 원격 접속을 설정하고, 제가 겪었던 연결 오류들을 어떻게 디버깅했는지 상세하게 공유해드렸습니다. 13년차 인프라 엔지니어로서 많은 시스템을 만져봤지만, 이렇게 새로운 기술을 제 홈랩에 적용하며 겪는 삽질은 언제나 성장의 밑거름이 되는 것 같습니다. ‘삽질은 기술 발전의 어머니’라는 말을 다시 한번 실감했네요. 😊

    Cloudflare Tunnel은 Public IP 없이도 내부 서비스를 외부로 안전하게 노출할 수 있는 강력한 도구입니다. 특히 Zero Trust 모델과 결합하면 보안과 편의성을 동시에 잡을 수 있다는 점이 큰 매력이라고 생각합니다. 만약 여러분도 NAS 원격 접속이나 다른 홈랩 서비스를 외부에서 안전하게 접근하고 싶다면, Cloudflare Tunnel을 적극적으로 고려해보시길 강력히 추천합니다.

    다음 글에서는 Cloudflare Access를 이용해 Tunnel로 접속하는 서비스에 사용자 인증/인가를 추가하는 방법을 다뤄볼 예정입니다. 더 강력한 Zero Trust 환경을 구축하는 방법을 기대해주세요!
    Cloudflare Tunnel을 활용한 NAS 원격 접속의 주요 장점 요약

    Cloudflare Tunnel을 활용한 NAS 원격 접속의 주요 장점 요약

  • [HomeLabs] Matter 프로토콜, 홈 자동화의 미래: 1년 사용 후기 및 실제 적용 사례

    [HomeLabs] Matter 프로토콜, 홈 자동화의 미래: 1년 사용 후기 및 실제 적용 사례

    안녕하세요, 13년차의 서버실입니다. 오늘은 제가 1년 넘게 홈랩에서 직접 사용해본 Matter 프로토콜에 대한 솔직한 후기와 실제 적용 사례를 들려드리려고 합니다. 홈 자동화, 스마트 홈에 관심 있는 분들이라면 한 번쯤 “이거 도대체 언제쯤 편해질까?” 하는 고민 해보셨을 거예요. 저도 그랬습니다. 온갖 제조사의 기기들을 어떻게 하면 하나의 시스템으로 묶을 수 있을까, 어떻게 하면 좀 더 안정적으로 쓸 수 있을까 하는 고민의 연속이었죠.

    그러다 Matter(매터) 프로토콜이라는 새로운 표준이 등장했을 때, 저도 처음엔 반신반의했습니다. “과연 이게 진짜 될까?”, “또 하나의 표준 놀음에 그치는 건 아닐까?” 하는 의구심이 들었거든요. 하지만 직접 써보니까, 이거 진짜 물건이더라고요! 물론 삽질도 좀 했습니다만, 그 삽질마저도 즐거웠던(?!) 지난 1년의 경험을 지금부터 자세히 풀어보겠습니다.

    Matter 프로토콜을 활용한 홈 자동화 생태계 아키텍처 다이어그램

    Matter 프로토콜은 다양한 제조사의 스마트 기기들이 서로 호환되어 작동할 수 있도록 하는 개방형 표준입니다. 마치 USB가 모든 기기에서 작동하는 것처럼요.

    Matter 프로토콜, 대체 무엇이 다른가요? 💡

    자, 그럼 Matter가 정확히 무엇이고 왜 중요한지 쉽게 한번 풀어볼까요? Matter(매터) 프로토콜은 CSA(Connectivity Standards Alliance)에서 개발한 IP 기반의 스마트 홈 연결 표준(IP-based smart home connectivity standard)입니다. 쉽게 말해, 삼성, LG, 애플, 구글, 아마존 등 수많은 제조사의 스마트 기기들이 서로 다른 언어를 쓰지 않고, 하나의 공통된 언어(Matter)로 대화할 수 있게 해주는 약속인 거죠.

    기존에는 제조사별로 각자의 생태계(ecosystem)가 있어서, 예를 들어 애플 홈킷(Apple HomeKit) 기기와 구글 홈(Google Home) 기기가 직접 연동되기가 어려웠습니다. 중간에 브릿지(Bridge)나 허브(Hub)를 거쳐야 했고, 호환성 문제도 많았죠. 근데 Matter는 이런 장벽을 허물어버렸습니다. Wi-Fi, Thread(스레드), 이더넷(Ethernet) 같은 IP 기반 네트워크 위에서 작동해서, 제조사나 플랫폼에 상관없이 기기들을 로컬(local)에서 직접 제어할 수 있게 됩니다. 인터넷 연결이 끊어져도 작동한다는 거죠! 이거 진짜 편하더라고요.

    Matter의 주요 장점들 ✅

    • 범용성(Interoperability): 어떤 제조사 기기든 Matter를 지원하면 서로 연동됩니다.
    • 로컬 제어(Local Control): 인터넷 연결 없이도 기기 제어가 가능해서 반응 속도가 빠르고 안정적입니다.
    • 보안성(Security): 처음부터 강력한 보안 기능을 염두에 두고 설계되었습니다.
    • 쉬운 설정(Easy Setup): QR 코드 스캔 한 번으로 쉽게 기기를 연결할 수 있습니다. (이건 진짜 혁신이더라고요!)
    • 멀티 어드민(Multi-Admin): 하나의 기기를 여러 스마트 홈 플랫폼에서 동시에 제어할 수 있습니다. 예를 들어, 거실 전구를 애플 홈에서도, 구글 홈에서도 제어할 수 있다는 거죠.

    홈랩에서의 Matter 1년, 실전 구현 경험 🛠️

    저는 제 홈랩에서 Matter 프로토콜을 활용해 다양한 스마트 기기를 연동해봤습니다. 주로 Home Assistant(홈 어시스턴트)를 메인 컨트롤러로 사용하고, Thread Border Router(스레드 보더 라우터)는 HomePod mini(홈팟 미니)와 eero Pro 6(이로 프로 6)를 조합해서 사용했습니다.

    1. Matter 기기 준비

    제가 주로 사용한 Matter 기기들은 다음과 같습니다. (실존하는 제품 위주로 작성)

    • Nanoleaf Essentials Matter A19 Bulb: 색온도 조절 및 밝기 조절이 가능한 스마트 전구.
    • Eve Energy Matter Smart Plug: 전력 모니터링 기능이 있는 스마트 플러그.
    • Aqara P2 Motion Sensor: Thread 기반의 동작 감지 센서.

    이 외에도 집에 있는 LG ThinQ(LG 씽큐) 가전 중 Matter 지원 예정인 제품들도 업데이트를 기다리고 있습니다. (2024년 펌웨어 업데이트로 세탁기, 건조기, 로봇청소기 등 일부 가전 Matter 지원)

    2. Home Assistant에 Matter 컨트롤러 설정

    Home Assistant에서 Matter를 사용하려면 Matter 애드온(add-on)을 설치해야 합니다. Docker 컨테이너 기반으로 쉽게 설치할 수 있었어요.

    
    # configuration.yaml (예시)
    # Home Assistant Matter Integration
    matter:
      server:
        port: 5540 # Matter server port
    

    설치 후에는 Home Assistant의 통합(Integrations) 설정에서 Matter를 활성화하고, Thread Border Router(스레드 보더 라우터)를 연결해 줘야 합니다. 저는 이미 홈팟 미니와 eero Pro 6가 Thread 네트워크를 잘 구축해놔서 별다른 설정 없이 Home Assistant가 자동으로 잘 인식하더라고요. 이거 진짜 편리했습니다.

    Home Assistant 대시보드에서 Matter 기기들이 정상적으로 인식되고 제어되는 모습입니다.

    3. 기기 페어링 과정

    Matter 기기를 Home Assistant에 페어링하는 과정은 정말 간단했습니다. 제품에 있는 QR 코드를 스캔하거나 수동으로 페어링 코드를 입력하면 되더라고요.

    1. Home Assistant의 ‘설정’ -> ‘기기 및 서비스’ -> ‘통합’에서 Matter 통합을 선택합니다.
    2. ‘기기 추가’를 클릭하고, 기기의 QR 코드(QR Code)를 스캔하거나 설정 코드(Setup Code)를 입력합니다.
    3. 잠시 기다리면 기기가 검색되고, Home Assistant에 추가됩니다.

    처음엔 “이게 이렇게 쉽게 된다고?” 싶어서 몇 번이나 다시 해봤는데, 진짜 쉽더라고요. 예전 같으면 제조사 앱 깔고, 계정 만들고, 허브 연결하고… 복잡한 과정을 거쳐야 했는데 말이죠. 👍

    ⚠️ 삽질 경험과 트러블슈팅 💡

    물론 1년 동안 Matter를 쓰면서 마냥 순탄하기만 했던 건 아닙니다. 저도 몇 번의 삽질을 겪었는데요, 그 경험들을 솔직하게 공유합니다.

    1. Thread 네트워크 불안정 문제

    초기에는 Thread 네트워크(스레드 네트워크)가 간헐적으로 불안정해지는 경험을 했습니다. 특히 Thread Border Router(스레드 보더 라우터)가 여러 개일 때, 기기들이 어느 라우터에 붙어야 할지 헤매는 경우가 있더라고요.

    • 문제: Nanoleaf 전구가 가끔 ‘응답 없음’ 상태가 되거나, Eve 플러그가 제대로 제어되지 않았습니다.
    • 원인 분석: 여러 개의 Thread Border Router(홈팟 미니, eero Pro 6)가 서로 다른 Thread 네트워크를 형성하려고 시도하거나, 기기들이 최적의 라우터를 찾지 못하는 문제였습니다.
    • 해결: Home Assistant의 Thread 통합 설정에서 OpenThread Border Router(OTBR) 설정을 확인하고, 가능한 한 하나의 주(Primary) Thread 네트워크만 활성화되도록 했습니다. 불필요한 보더 라우터는 잠시 비활성화하거나, 펌웨어 업데이트를 통해 안정성을 확보했습니다. 특히 펌웨어 업데이트가 중요하더라고요. 초기 버전의 펌웨어들은 버그가 좀 있었습니다.
    Thread 네트워크 구성도 및 Matter 기기 연결

    Thread 네트워크는 Mesh 구조로 기기 간 안정적인 연결을 제공합니다.

    2. 멀티 어드민(Multi-Admin) 페어링 오류

    Matter의 큰 장점 중 하나가 멀티 어드민(Multi-Admin) 기능인데, 처음에는 이걸 제대로 활용하기 어려웠습니다.

    • 문제: Home Assistant에 이미 연결된 Matter 기기를 애플 홈(Apple Home)이나 구글 홈(Google Home)에도 추가하려고 하니 자꾸 오류가 나거나, 한쪽에 추가하면 다른 쪽에서 연결이 끊기는 현상이 발생했습니다.
    • 원인 분석: 각 플랫폼이 기기에 대한 ‘주인 권한’을 확보하려 하거나, Matter 표준 구현의 미묘한 차이 때문에 발생한 문제로 보였습니다.
    • 해결: 처음 기기를 추가할 때, 하나의 플랫폼(예: Home Assistant)에 먼저 연결한 후, 해당 플랫폼의 설정에서 ‘추가 관리자 페어링 코드 생성(Generate additional pairing code for other admins)’ 같은 메뉴를 찾아 코드를 생성했습니다. 이 코드를 다른 플랫폼(애플 홈, 구글 홈)에서 입력하여 추가하면 문제없이 멀티 어드민 설정이 가능했습니다. 이 기능은 정말 강력하더라고요. 온 가족이 각자 편한 플랫폼으로 제어할 수 있으니 만족도가 높습니다.

    검증 및 결과: Matter, 정말 홈 자동화의 미래일까요? 🎉

    1년의 사용 경험을 통해 볼 때, Matter 프로토콜은 홈 자동화(Home Automation)의 미래를 밝게 비추는 중요한 전환점이라고 확신합니다. 물론 아직 초기 단계라서 완벽하다고 할 수는 없지만, 기존의 파편화된 생태계 문제를 해결하려는 강력한 의지와 기술력을 보여주고 있습니다.

    제가 느낀 Matter의 실질적인 변화

    • 기기 선택의 자유: 더 이상 특정 제조사의 생태계에 갇힐 필요가 없어졌습니다. 원하는 기능을 가진 기기를 자유롭게 선택할 수 있게 되었어요.
    • 안정적인 로컬 제어: 인터넷 연결이 끊겨도 작동한다는 점이 정말 든든합니다. 반응 속도도 훨씬 빨라졌고요. 스마트 홈은 결국 안정성이 생명인데, 이 부분에서 큰 점수를 주고 싶습니다.
    • 가족 구성원의 만족도 향상: 저야 홈 어시스턴트를 주로 쓰지만, 아내는 애플 홈을 선호하거든요. 멀티 어드민 덕분에 각자 편한 앱으로 제어할 수 있게 되면서 가족들의 스마트 홈 만족도가 확 올라갔습니다.
    Matter 프로토콜의 장점과 단점 비교 인포그래픽

    Matter 프로토콜의 주요 장점과 제가 경험한 단점을 요약한 표입니다.

    장점 (Pros) 단점 (Cons)
    ✅ 범용성(Interoperability): 제조사/플랫폼 무관 연동 ⚠️ 초기 불안정성: 펌웨어 및 네트워크 이슈 (초기)
    ✅ 로컬 제어(Local Control): 빠른 반응, 인터넷 불필요 ⚠️ 기기 부족: 아직은 지원 기기가 제한적
    ✅ 멀티 어드민(Multi-Admin): 여러 플랫폼 동시 제어 ⚠️ 초기 설정 복잡성: Thread 네트워크 이해 필요
    ✅ 쉬운 페어링: QR 코드 기반의 간편한 연결 ⚠️ 학습 곡선: 새로운 개념(Thread 등)에 대한 이해

    마무리하며: 다음 단계를 향한 기대 🚀

    제가 직접 겪어본 Matter 프로토콜은 분명 홈 자동화(Home Automation) 시장의 게임 체인저가 될 잠재력을 가지고 있습니다. 물론 아직 갈 길은 멀지만, 지난 1년간의 경험은 충분히 긍정적이었습니다. 특히 기존 스마트 홈의 가장 큰 문제였던 ‘파편화’와 ‘복잡성’을 해결하려는 시도가 성공적으로 이루어지고 있다는 점에서 높은 점수를 주고 싶네요.

    앞으로는 더 많은 제조사에서 Matter를 지원하는 기기들을 출시할 것이고, 펌웨어 업데이트를 통해 안정성도 더욱 높아질 거라고 생각합니다. 저도 새로운 Matter 기기가 나올 때마다 홈랩에 들여와서 열심히 실험해볼 계획입니다. 혹시 이 글을 보고 Matter에 도전해보고 싶으신가요? 주저하지 마세요! 분명 여러분의 스마트 홈 경험을 한 단계 업그레이드 시켜줄 겁니다. 더 많은 홈랩 구축 노하우와 흥미로운 인프라 이야기가 궁금하시다면 [제 블로그의 다른 글](https://yourblog.com/homelab-category)들도 확인해보세요! 다음에 또 다른 흥미로운 인프라 이야기로 찾아오겠습니다. 감사합니다!

  • [Proxmox] Proxmox GPU 패스스루: Error 43·IOMMU 문제 완벽 해결 가이드

    [Proxmox] Proxmox GPU 패스스루: Error 43·IOMMU 문제 완벽 해결 가이드

    안녕하세요, 13년차 서버실 지킴이입니다. 오늘은 홈랩(Homelab)에서 Proxmox VE를 운영하면서 정말 많은 분들이 도전하고 그만큼 많은 삽질을 하는 주제, 바로 Proxmox GPU 패스스루(Passthrough)와 GPU 가상화에 대해 이야기해보려고 합니다. 저도 처음에는 ‘이거 뭐 별거 있겠어?’ 하고 덤볐다가, 밤새도록 머리 싸매고 고민했던 경험이 한두 번이 아니거든요. 특히 Error 43이나 IOMMU 관련 문제들은 정말이지… 멘탈을 흔들리게 하죠. 😅

    하지만 결국 해결하고 나면, 가상머신(Virtual Machine, VM)에서 직접 게임을 돌리거나, AI/ML(머신러닝) 작업을 하거나, 고화질 미디어 서버를 구축하는 등 무궁무진한 가능성이 열리게 됩니다. 제가 직접 부딪히고 해결했던 경험들을 바탕으로, 여러분들이 겪을 수 있는 흔한 문제들과 그 해결 전략을 자세히 알려드릴게요. 멘토처럼 든든하게 옆에서 알려드리는 마음으로 시작해볼까요?

    Proxmox GPU 패스스루의 전체적인 구조를 한눈에 볼 수 있는 다이어그램입니다. 호스트 서버의 물리 GPU가 가상머신으로 직접 연결되는 방식이죠.

    Proxmox GPU 패스스루, vGPU, 그리고 IOMMU 개념 이해하기

    본격적인 설정에 들어가기 전에, 몇 가지 핵심 개념을 확실히 짚고 넘어가야 합니다. 이게 헷갈리면 나중에 삽질의 깊이가 더 깊어지거든요. 제가 처음 그랬습니다. ㅎㅎ

    GPU 패스스루 (GPU Passthrough)

    • 무엇인가요? 쉽게 말해, Proxmox 호스트 서버에 꽂혀 있는 물리적인 GPU(그래픽 카드)를 특정 가상머신이 단독으로 사용할 수 있도록 넘겨주는 기술입니다. 마치 그 VM에 GPU가 직접 꽂혀 있는 것처럼 만들어주는 거죠.
    • 왜 필요한가요? 게임, 영상 편집, 딥러닝(Deep Learning) 학습 등 높은 그래픽 성능이나 GPU 병렬 연산 능력이 필요한 작업들을 가상머신 환경에서 효율적으로 처리하려면 필요해요. 일반적인 가상화 환경에서는 GPU 자원을 공유하기 때문에 제 성능을 내기 어렵거든요.

    vGPU (Virtual GPU)

    • 무엇인가요? GPU 패스스루가 하나의 GPU를 하나의 VM에 통째로 넘겨주는 방식이라면, vGPU는 하나의 물리 GPU를 여러 가상머신이 나눠서 사용할 수 있도록 하는 기술입니다.
    • 홈랩에선 어떤가요? 사실 vGPU는 NVIDIA GRID 같은 특정 엔터프라이즈용 GPU와 드라이버, 라이선스 정책이 필요해서 홈랩 환경에서 쉽게 구현하기는 어렵더라고요. 저도 여러 번 시도해봤지만, 비용과 복잡성 때문에 결국 패스스루에 집중하게 되었어요. 혹시 나중에 더 발전된 오픈소스 vGPU 솔루션이 나온다면 꼭 다뤄보고 싶네요!

    IOMMU (Input/Output Memory Management Unit)

    • 무엇인가요? IOMMU는 CPU와 PCIe 장치(GPU 포함) 사이의 메모리 접근을 관리하는 장치예요. 쉽게 말해, 가상머신이 물리 장치에 직접 접근할 수 있도록 메모리 주소를 매핑(Mapping)해주는 역할을 하죠.
    • 왜 중요한가요? GPU 패스스루를 위해서는 IOMMU가 필수적으로 활성화되어야 해요. 그래야 Proxmox 호스트가 GPU를 VM에 안전하고 효율적으로 넘겨줄 수 있거든요. 이게 비활성화되어 있으면 아무리 다른 설정을 잘해도 패스스루는 불가능합니다. 저도 처음에 BIOS에서 이걸 빼먹어서 몇 시간을 날렸던 기억이 생생하네요 😭.

    Error 43

    • 무엇인가요? Windows 가상머신에 NVIDIA 또는 AMD 그래픽 드라이버를 설치했을 때, 장치 관리자에서 ‘이 장치에 대한 드라이버를 로드할 수 없습니다. (코드 43)’이라는 메시지가 뜨는 현상이에요.
    • 왜 발생하나요? 대부분의 GPU 드라이버는 가상머신 환경에서 설치되는 것을 막기 위한 보호 장치를 가지고 있어요. VM 환경임을 감지하면 드라이버가 제대로 동작하지 않도록 하는 거죠. 이걸 우회하는 방법을 찾아야 합니다.

    Proxmox GPU 패스스루 실전 구현: 단계별 설정

    자, 이제 개념을 알았으니 직접 Proxmox에 GPU 패스스루를 설정해보겠습니다. 제가 겪었던 시행착오들을 줄여드리기 위해 핵심만 콕콕 짚어드릴게요.

    1. BIOS/UEFI 설정 변경

    가장 기본 중의 기본입니다. 메인보드 BIOS/UEFI 설정으로 들어가서 아래 항목들을 활성화해야 합니다.

    • Intel VT-d (Intel CPU 사용자) 또는 AMD-V (AMD CPU 사용자): 가상화 기술 및 IOMMU를 활성화하는 옵션이에요.
    • SR-IOV (Supported if available): PCIe 장치 가상화 기술인데, GPU 패스스루에 직접적인 필수 요소는 아니지만 활성화해두면 좋아요.
    • Above 4G Decoding: 일부 메인보드에서 GPU 메모리 주소 할당을 위해 필요합니다. GPU 패스스루 시 안정성을 높여줄 수 있어요.
    • CSM (Compatibility Support Module) 비활성화: UEFI 부팅 환경을 제대로 활용하기 위함입니다.

    설정을 변경한 후에는 반드시 저장하고 재부팅해주세요.

    2. Proxmox VE 호스트 설정

    이제 Proxmox 쉘에 접속하여 필요한 모듈을 로드하고 GRUB 설정을 변경해야 합니다.

    2.1. 필수 모듈 로드

    IOMMU와 VFIO(Virtual Function I/O) 관련 모듈을 로드해야 해요. /etc/modules 파일을 열어 아래 내용을 추가합니다.

    echo "vfio" >> /etc/modules
    echo "vfio_iommu_type1" >> /etc/modules
    echo "vfio_pci" >> /etc/modules
    echo "vfio_virqfd" >> /etc/modules
    
    # 변경사항 적용을 위해 모듈 로드 (재부팅해도 유지됨)
    update-initramfs -u -k all
    

    이후 reboot 명령으로 재부팅하는 것을 추천합니다.

    2.2. GRUB 설정 변경 (IOMMU 활성화 및 GPU 블랙리스트)

    GRUB 부트로더 설정을 통해 IOMMU를 활성화하고, Proxmox 호스트가 패스스루할 GPU를 사용하지 못하도록 블랙리스트에 추가해야 해요.

    nano /etc/default/grub
    

    GRUB_CMDLINE_LINUX_DEFAULT 라인을 찾아서 아래와 같이 수정합니다.

    • Intel CPU: GRUB_CMDLINE_LINUX_DEFAULT="quiet intel_iommu=on iommu=pt"
    • AMD CPU: GRUB_CMDLINE_LINUX_DEFAULT="quiet amd_iommu=on iommu=pt"

    여기에 GPU 블랙리스트 설정을 추가합니다. 먼저 패스스루할 GPU의 벤더 ID와 장치 ID를 확인해야 해요. 쉘에서 다음 명령어를 실행합니다.

    lspci -nn | grep -i vga
    

    출력 결과는 보통 이런 식일 겁니다:

    01:00.0 VGA compatible controller [0300]: NVIDIA Corporation GP107 [GeForce GTX 1050 Ti] [10de:1c82] (rev a1)
    01:00.1 Audio device [0403]: NVIDIA Corporation GP107 High Definition Audio Controller [10de:0fb9] (rev a1)
    

    여기서 [10de:1c82]와 [10de:0fb9]가 각각 GPU 비디오 장치와 오디오 장치의 벤더 ID:장치 ID예요. 이 값들을 콤마(,)로 구분하여 GRUB 설정에 추가합니다.

    # Intel CPU 예시 (GTX 1050 Ti 기준)
    GRUB_CMDLINE_LINUX_DEFAULT="quiet intel_iommu=on iommu=pt video=efifb:off,vesafb:off disable_vga=1 vfio_pci.ids=10de:1c82,10de:0fb9"
    

    ⚠️ 중요: video=efifb:off,vesafb:off disable_vga=1 옵션은 Proxmox 호스트가 해당 GPU를 초기화하지 않도록 하여 패스스루 시 발생할 수 있는 충돌을 방지해요. 이 옵션 없이는 Error 43이 발생할 확률이 매우 높아집니다.

    GRUB 설정을 변경했으면, 반드시 업데이트하고 initramfs를 다시 생성해야 합니다.

    update-grub
    update-initramfs -u -k all
    reboot
    
    Proxmox VM 설정에서 PCIe 장치 추가 화면

    Proxmox 웹 UI에서 가상머신에 GPU 장치를 추가하는 모습입니다. 올바르게 설정되었다면 목록에 GPU가 보일 거예요.

    3. 가상머신 (VM) 설정

    Proxmox 호스트 설정이 끝났으니, 이제 GPU를 사용할 가상머신을 설정할 차례예요.

    3.1. VM 생성 시 주의사항

    • OS Type: Windows 사용 시 ‘Microsoft Windows’ 선택.
    • BIOS: ‘OVMF (UEFI)’를 선택해야 해요. 레거시 BIOS는 패스스루 시 문제가 많더라고요.
    • Machine: ‘q35’를 선택하는 게 좋아요. PCIe 장치 관리에 더 최적화되어 있거든요.
    • CPU: ‘Host’로 설정하여 호스트 CPU의 모든 기능을 VM에서 활용할 수 있도록 합니다.
    • Disk: SATA 또는 SCSI(VirtIO)를 사용하되, SCSI VirtIO를 추천합니다. 성능이 더 좋아요.

    3.2. GPU 장치 추가

    VM 생성 후, VM의 ‘Hardware’ 탭으로 이동하여 ‘Add’ -> ‘PCI Device’를 선택합니다.

    • PCIe Device: 패스스루할 GPU의 비디오 장치와 오디오 장치를 각각 추가해요.
    • All Functions: 활성화합니다.
    • Primary GPU: 패스스루할 GPU를 VM의 주 GPU로 설정하려면 활성화합니다.
    • ROM-Bar: 활성화하는 것을 추천해요. 특히 구형 GPU에서 문제가 생길 때 해결책이 될 수 있거든요.

    3.3. QEMU/KVM 추가 설정 (중요!)

    이제 Error 43을 피하기 위한 핵심 설정입니다. Proxmox 웹 UI에서는 설정할 수 없는 고급 옵션이므로, Proxmox 쉘에서 qm set 명령어를 사용해야 해요.

    # VM ID는 여러분의 VM ID로 변경해주세요 (예: 100)
    # 'kvm=off,hv_vendor_id=null' 옵션으로 VM 환경 감지 우회
    qm set <VM_ID> -args '-cpu host,kvm=off,hv_vendor_id=null'
    # VM ID 100번에 대한 예시
    qm set 100 -args '-cpu host,kvm=off,hv_vendor_id=null'
    

    또는 VM 설정 파일 (/etc/pve/qemu-server/<VM_ID>.conf)을 직접 수정하여 args: 라인을 추가할 수도 있어요.

    # /etc/pve/qemu-server/100.conf 예시
    args: -cpu host,kvm=off,hv_vendor_id=null
    

    이 설정은 QEMU/KVM이 가상화 환경임을 숨기도록 도와주며, NVIDIA나 AMD 드라이버가 VM 환경을 감지하지 못하게 해요. 저도 이 설정 하나로 몇 번의 Error 43을 해결했었습니다. 💡

    ⚠️ 흔한 문제와 해결 전략 (삽질 경험 공유)

    제가 Proxmox GPU 패스스루를 하면서 가장 많이 겪었던 문제들과 그 해결 전략을 솔직하게 공유합니다. 여러분은 저처럼 삽질하지 마세요!

    1. IOMMU 그룹 문제 (가장 흔하고 골치 아픈 문제)

    문제: IOMMU가 활성화되었는데도 GPU가 VM에 제대로 패스스루되지 않거나, VM이 부팅되지 않는 경우가 있어요. lspci -nnk 명령으로 보면 분명 VFIO 드라이버가 붙어있는데 말이죠.

    원인: 이는 대부분 IOMMU 그룹 문제 때문입니다. IOMMU는 장치들을 ‘그룹’으로 묶어서 관리하는데, 만약 GPU와 다른 중요 장치(예: USB 컨트롤러, PCIe 브리지)가 같은 그룹에 묶여 있다면, GPU만 개별적으로 패스스루하기 어렵더라고요. IOMMU는 그룹 단위로 장치를 격리하려 하기 때문이죠.

    확인 방법: 다음 명령어로 현재 시스템의 IOMMU 그룹을 확인해볼 수 있어요.

    for iommu_group in $(find /sys/kernel/iommu_groups/ -maxdepth 1 -mindepth 1 -type d); do echo "IOMMU Group $(basename "$iommu_group")"; for device in $(ls -v "$iommu_group"/devices/); do echo -n $'\t'; lspci -nns "$device"; done; done
    

    이 결과를 보고 GPU와 그에 딸린 오디오 장치만 하나의 그룹에 묶여 있고, 다른 장치들과는 분리되어 있는지 확인해야 해요. 만약 GPU와 다른 장치들이 같은 그룹에 묶여 있다면… 아, 골치 아파지는 거죠.

    해결 전략:

    • 다른 PCIe 슬롯 사용: 메인보드마다 PCIe 슬롯의 IOMMU 그룹 분리 방식이 달라요. GPU를 다른 PCIe 슬롯에 꽂아보세요. 의외로 간단하게 해결되는 경우가 많습니다.
    • BIOS/UEFI 설정 재확인: ‘Above 4G Decoding’이나 ‘PCIe ARI Support’ 같은 옵션들이 IOMMU 그룹화에 영향을 줄 수 있어요. 활성화/비활성화해보면서 테스트해볼 필요가 있습니다.
    • 듀얼 GPU 사용: 만약 내장 그래픽(iGPU)이 있거나 다른 저렴한 그래픽 카드가 있다면, 호스트 Proxmox는 그 GPU를 사용하고, 패스스루할 GPU는 완전히 VM에 전용으로 넘겨주는 방식이 가장 확실해요. 이렇게 하면 IOMMU 그룹 문제가 발생할 확률이 현저히 줄어들어요. 저도 결국 이렇게 구성해서 안정적으로 사용하고 있습니다.
    • (고급) ACS Override Patch: 일부 커뮤니티에서는 ACS(Access Control Services) Override 패치를 커널에 적용하여 IOMMU 그룹을 강제로 분리하는 방법도 사용하지만, 이는 커널 컴파일이 필요하고 시스템 안정성에 영향을 줄 수 있어서 초보자에게는 절대 추천하지 않습니다. 잘못하면 시스템이 벽돌이 될 수 있어요.

    2. Windows VM에서 Error 43 발생

    문제: 위에서 설명한 `qm set` 명령어를 통한 `kvm=off,hv_vendor_id=null` 설정에도 불구하고 여전히 Error 43이 발생하는 경우가 있어요.

    원인: NVIDIA나 AMD 드라이버가 VM 환경을 감지하는 방식이 점점 더 교묘해지고 있어요. 또는 BIOS/UEFI 설정이 제대로 안 되어 있을 수도 있습니다.

    해결 전략:

    • BIOS/UEFI 설정 재확인: ‘Above 4G Decoding’이 활성화되어 있는지, ‘CSM’이 비활성화되어 있는지 다시 한번 확인해주세요. 이 두 가지는 Error 43과 깊은 연관이 있어요.
    • 최신 드라이버 vs. 구형 드라이버: 때로는 최신 드라이버보다 약간 구형 드라이버가 VM 환경에서 더 잘 작동하는 경우가 있어요. 특히 NVIDIA 드라이버는 특정 버전에서 VM 감지 로직이 더 강화되기도 합니다. 몇 가지 드라이버 버전을 시도해보는 것도 방법이에요.
    • Windows 업데이트 확인: Windows 업데이트가 드라이버와 충돌을 일으키는 경우도 있어요. 드라이버 설치 전 Windows를 최신 상태로 업데이트하거나, 반대로 특정 업데이트를 제거해보는 것도 시도해볼 수 있습니다.

    3. VM 부팅 시 화면 출력 안 됨

    문제: VM은 시작되는데 모니터에 아무것도 출력되지 않거나, Proxmox 웹 UI의 콘솔 화면만 보이고 GPU 출력은 나오지 않는 경우가 있어요.

    원인: GPU 초기화 문제, 또는 VM의 메인 디스플레이 설정 문제입니다.

    해결 전략:

    • BIOS/UEFI의 Primary Graphics Adapter 설정: 메인보드 BIOS에서 Primary Graphics Adapter(주 그래픽 어댑터) 설정을 ‘PCIe’ 또는 ‘Discrete Graphics’로 변경해보세요.
    • Proxmox GRUB 설정 재확인: video=efifb:off,vesafb:off disable_vga=1 옵션이 제대로 적용되었는지 확인해요. 이 옵션이 없으면 Proxmox 호스트가 GPU를 먼저 잡아버려서 VM이 사용할 수 없게 되는 경우가 많더라고요.
    • VM에 가상 디스플레이 제거: VM의 ‘Hardware’ 탭에서 ‘Display’ 장치를 ‘none’으로 설정해보세요. GPU 패스스루 시에는 가상 디스플레이가 필요 없으며, 오히려 충돌을 일으킬 수 있거든요.

    ✅ 검증 및 결과 확인

    모든 설정을 마치고 VM을 부팅했다면, 이제 드디어 결과물을 확인할 차례예요! 이 순간이 제일 두근거리고, 성공하면 희열이 엄청나죠. 🎉

    1. Windows 장치 관리자 확인

    Windows VM에 접속하여 ‘장치 관리자(Device Manager)’를 열어보세요. ‘디스플레이 어댑터(Display Adapters)’ 항목 아래에 패스스루한 GPU가 정상적으로 인식되고, 경고 표시(느낌표) 없이 드라이버가 설치되어 있다면 성공이에요!

    만약 아직도 Error 43이 보인다면, 위에 제시된 트러블슈팅 방법을 다시 한번 꼼꼼히 확인하고 재부팅을 반복해보세요. 때로는 인내심이 필요해요. 끈기가 정답이더라고요.

    2. GPU-Z 또는 FurMark로 테스트

    GPU-Z 같은 유틸리티를 설치해서 GPU 정보가 정확하게 표시되는지 확인하고, FurMark 같은 벤치마크 툴로 간단한 스트레스 테스트를 진행해보세요. 이때 GPU 온도가 정상적으로 표시되고, 프레임이 잘 나온다면 완벽하게 패스스루가 된 거예요. 저는 이때마다 ‘드디어 됐다!’ 하고 외치곤 합니다. 😂

    Windows VM에서 GPU-Z를 통한 Proxmox GPU 패스스루 확인

    Windows VM 안에서 GPU-Z를 실행한 모습입니다. 물리 GPU 정보가 그대로 잘 보이죠? 이 화면을 보면 얼마나 뿌듯한지 몰라요!

    마무리하며: 삽질 끝의 뿌듯함, 그리고 다음 단계

    Proxmox GPU 패스스루, 결코 쉽지 않은 여정입니다. 특히 IOMMU 그룹 문제나 Error 43 같은 예상치 못한 복병들을 만나면 ‘이거 그냥 포기할까?’ 하는 생각도 들죠. 저도 수도 없이 그런 생각을 했었어요. 하지만 포기하지 않고 끈기 있게 해결해나가다 보면, 결국 원하는 결과를 얻게 되고 그 과정에서 정말 많은 것을 배우게 됩니다.

    이렇게 GPU 패스스루를 성공하고 나면, 여러분의 Proxmox 홈랩은 한 단계 더 강력해질 거예요. 고성능 게이밍 머신, AI 개발 환경, 또는 고화질 트랜스코딩이 가능한 미디어 서버 등 게임부터 AI 개발까지 뭐든 가능해지는 기반이 마련되는 거죠.

    다음번에는 이렇게 구축된 강력한 VM 환경을 활용하여 Docker 컨테이너 환경을 효율적으로 관리하는 방법이나, ZFS 또는 Ceph를 이용한 스토리지 구성에 대해 다뤄볼 수도 있겠네요. 궁금한 점이 있다면 언제든지 댓글로 남겨주세요! 제 삽질 경험이 여러분의 시간을 아껴주기를 바라며, 오늘의 이야기는 여기서 마치겠습니다. 긴 글 읽어주셔서 감사합니다!

    Proxmox GPU 패스스루 성공과 실패 시나리오 비교 인포그래픽

    Proxmox GPU 패스스루의 성공과 실패 시나리오를 한눈에 비교해주는 인포그래픽입니다. 성공했을 때의 짜릿함과 실패했을 때의 좌절감이 느껴지시나요?

  • [k8s] Rancher 2.x에서 차세대로 마이그레이션: 실제 경험과 주요 변경점

    [k8s] Rancher 2.x에서 차세대로 마이그레이션: 실제 경험과 주요 변경점

    안녕하세요, 13년차 서버실 지킴이입니다. 오늘은 많은 분들이 고민하고 계실 법한 주제, 바로 Rancher 2.x 환경을 차세대 쿠버네티스 관리 아키텍처로 전환하는 경험에 대해 이야기해볼게요. 제목에는 ‘Rancher 3.x’라는 표현을 썼지만, 사실 직접적인 ‘Rancher 3.x’라는 버전이 명확하게 출시된 것은 아닙니다. 대신, Rancher를 활용한 쿠버네티스 관리 방식이 점차 진화하면서, 기존 2.x 시절의 방식과는 크게 달라진 미래 지향적인 아키텍처로의 전환 과정을 ‘3.x 마이그레이션’이라는 개념으로 풀어보려고 해요. 즉, 단순히 버전을 올리는 것을 넘어, 더 효율적이고 안정적인 쿠버네티스 운영을 위한 근본적인 변화를 고민하는 시간이라고 보시면 되겠습니다.

    저도 홈랩에서부터 시작해서 프로덕션 환경까지 다양한 규모의 쿠버네티스 클러스터를 Rancher 2.x로 관리해왔어요. 처음에는 하나의 Rancher 서버로 모든 클러스터를 중앙에서 관리하는 방식이 정말 편하더라고요. 하지만 클러스터의 수가 늘어나고, 요구사항이 복잡해지면서 중앙 집중형 관리의 한계를 느끼게 됐습니다. 특히, Rancher 서버 자체의 안정성이나 업그레이드 부담, 그리고 GitOps(깃옵스)와 같은 최신 트렌드를 통합하는 데 대한 고민이 많았거든요. 그래서 ‘이제는 좀 더 분산되고 선언적인 방식으로 가야 하지 않을까?’ 하는 생각을 하게 됐습니다. 이런 고민을 하고 계신 분들이라면 오늘 제 이야기가 작은 팁이라도 될 수 있을 겁니다. 제가 직접 삽질해가며 얻은 경험들을 솔직하게 공유해볼게요!

    개념 설명: Rancher 2.x와 차세대 아키텍처의 차이

    먼저, 우리가 이야기하는 Rancher 2.x는 보통 RKE1(Rancher Kubernetes Engine 1) 기반의 쿠버네티스 클러스터들을 Rancher Management Server(랜처 관리 서버)가 중앙에서 프로비저닝하고 관리하는 형태를 의미합니다. 웹 UI를 통해 클러스터를 생성하고, 워크로드를 배포하며, 모니터링까지 한곳에서 할 수 있었죠. 정말 편리하고 직관적입니다. 하지만 단점도 명확해요.

    • 중앙 집중형 의존성: Rancher Management Server에 장애가 발생하면 모든 하위 클러스터 관리에 문제가 생길 수 있습니다.
    • 관리 복잡성 증가: 클러스터가 많아질수록 관리 서버 자체의 부담도 커집니다.
    • GitOps 통합의 어려움: UI 기반의 작업이 많아 GitOps 파이프라인과 완벽하게 통합하기 쉽지 않은 부분이 있었습니다.

    그렇다면 여기서 말하는 ‘차세대 아키텍처’ 혹은 ‘3.x스러운’ 접근 방식은 뭘까요? 저는 주로 RKE2(Rancher Kubernetes Engine 2)나 K3s(케이쓰리s)와 같은 경량화되거나 보안이 강화된 쿠버네티스 배포판을 활용하고, GitOps 원칙을 적극적으로 도입하여 선언적(Declarative)으로 클러스터와 애플리케이션을 관리하는 방식을 의미한다고 봐요. 이제 더 이상 Rancher Management Server가 클러스터의 모든 것을 직접 제어하기보다는, 클러스터 자체의 견고함과 Git을 통한 선언적 관리에 초점을 맞추는 거죠. Rancher는 이런 클러스터들을 통합적으로 보여주고 관리하는 ‘플랫폼’으로서의 역할에 더 집중하게 됩니다.

    Rancher 2.x 중앙 집중형 관리와 차세대 분산형 GitOps 아키텍처 비교 다이어그램

    Rancher 2.x의 중앙 집중형 관리 방식과 차세대 분산형 GitOps 아키텍처의 주요 차이점을 시각적으로 보여주는 다이어그램입니다.

    실전 구현: 차세대 클러스터 환경 구축 전략

    기존 Rancher 2.x 환경을 ‘마이그레이션’하는 것은 단순히 버전을 올리는 것이 아니라, 새로운 클러스터를 구축하고 워크로드를 이전하는 과정에 가깝습니다. 제가 홈랩에서 여러 번 시도해본 결과, 크게 두 가지 접근 방식이 있더라고요.

    1. 새로운 RKE2/K3s 클러스터 프로비저닝

    먼저, 기존 Rancher 2.x 관리 서버에서 새로운 RKE2나 K3s 클러스터를 프로비저닝하는 방법을 소개할게요. Rancher 2.6 버전부터는 RKE2/K3s 클러스터 생성을 공식적으로 지원해서 훨씬 수월해졌습니다.

    1. Rancher UI 접속: 기존 Rancher Management Server의 웹 UI에 접속합니다.
    2. 클러스터 생성 메뉴 진입: ‘클러스터’ 탭에서 ‘클러스터 생성’ 버튼을 클릭합니다.
    3. RKE2/K3s 선택: ‘Rancher Kubernetes Engine 2 (RKE2)’ 또는 ‘K3s’를 선택합니다. 저는 보안과 성능을 고려해 RKE2를 선호하는 편입니다.
    4. 노드 구성 및 옵션 설정: 컨트롤 플레인(Control Plane), etcd, 워커(Worker) 노드를 구성하고 필요한 네트워크, CNI(Container Network Interface, 컨테이너 네트워크 인터페이스) (예: Canal, Calico 등) 옵션을 설정합니다. 이때, 클러스터의 고가용성(High Availability, HA)을 위해 컨트롤 플레인 노드를 최소 3개 이상으로 구성하는 것이 중요합니다.
    5. 클러스터 생성: 모든 설정을 마치고 클러스터를 생성하면, Rancher가 백그라운드에서 노드에 에이전트를 설치하고 RKE2/K3s를 배포합니다.

    다음은 RKE2 클러스터를 생성할 때 필요한 기본적인 설정 예시입니다.

    # 클러스터 생성 시 RKE2/K3s 설정 예시 (Rancher UI에서 구성)
    kubernetes_version: v1.27.x-rke2r1 # 원하는 RKE2 버전 선택
    cni: canal # CNI 플러그인 선택 (calico, cilium 등)
    cloud_provider: 
      name: aws # 클라우드 환경에 맞춰 설정 (baremetal, azure, vsphere 등)
    agent_options:
      node_taints:
        - "CriticalAddonsOnly=true:NoExecute"
      labels:
        - "node-role.kubernetes.io/control-plane=true"
        - "node-role.kubernetes.io/etcd=true"
    # 노드 추가는 Rancher UI에서 직접 진행하거나, Machine Group을 통해 자동화 가능
    

    이렇게 새 클러스터를 만들고 나면, 이제 기존 워크로드들을 새로운 클러스터로 이전할 준비가 된 겁니다. 이게 생각보다 쉽지 않아요. 애플리케이션 의존성부터 데이터 마이그레이션까지 고려할 게 많거든요. 제가 초반에 이걸 간과해서 밤샘 삽질을 좀 했습니다. 😅

    Rancher UI에서 RKE2 클러스터를 생성하는 화면 예시

    Rancher UI를 통해 새로운 RKE2 클러스터를 생성하는 화면 예시입니다. 여기서 다양한 옵션을 설정할 수 있습니다.

    2. 워크로드 및 데이터 마이그레이션

    가장 중요한 단계입니다. 워크로드 마이그레이션은 서비스 중단 시간을 최소화하는 방향으로 계획해야 해요. 몇 가지 팁을 드리자면:

    • 상태 없는(Stateless) 애플리케이션 먼저: 웹 서버, API 게이트웨이 등 상태를 저장하지 않는 애플리케이션부터 이전하여 위험을 줄입니다. Helm(헬름)이나 GitOps 툴(예: Argo CD, Flux CD)을 활용하면 배포를 선언적으로 관리하고 쉽게 이전할 수 있어요.
    • 상태 있는(Stateful) 애플리케이션: 데이터베이스와 같은 상태 있는 애플리케이션은 velero(벨레로)와 같은 백업 및 복구 툴을 사용하거나, 클라우드 제공업체의 볼륨 스냅샷 기능을 활용하여 데이터를 이전합니다. 이 과정에서 네트워크 지연(Latency)이나 데이터 정합성(Data Consistency)에 문제가 없는지 꼼꼼히 확인해야 해요.
    • 네트워크 설정: Ingress(인그레스, 외부 트래픽 진입점) 컨트롤러, Service(서비스) 타입, ExternalDNS(외부 DNS) 설정 등을 새 클러스터에 맞게 재구성해야 합니다. 특히 DNS 레코드를 변경할 때는 TTL(Time-To-Live, 캐시 유지 시간)을 짧게 설정하여 롤백에 대비하는 것이 좋습니다.
    # Argo CD를 이용한 GitOps 배포 예시
    # 새 클러스터에 Argo CD 설치 후, Git 리포지토리 연결
    
    # 1. Argo CD 설치 (새 클러스터에)
    kubectl create namespace argocd
    kubectl apply -n argocd -f https://raw.githubusercontent.com/argoproj/argo-cd/stable/manifests/install.yaml
    
    # 2. Argo CD CLI 설치 및 초기 비밀번호 확인
    # (생략)
    
    # 3. 애플리케이션 정의 (예: my-app.yaml)
    # applications/my-app.yaml 파일 생성
    # apiVersion: argoproj.io/v1alpha1
    # kind: Application
    # metadata:
    #   name: my-webapp
    #   namespace: argocd
    # spec:
    #   project: default
    #   source:
    #     repoURL: https://github.com/my-org/my-app-configs.git # 애플리케이션 설정이 있는 Git 레포지토리
    #     targetRevision: HEAD
    #     path: dev # Git 레포지토리 내 경로
    #   destination:
    #     server: https://kubernetes.default.svc
    #     namespace: my-webapp-prod # 배포할 네임스페이스
    #   syncPolicy:
    #     automated:
    #       prune: true
    #       selfHeal: true
    
    # 4. Argo CD에 애플리케이션 등록
    argocd app create my-webapp --repo https://github.com/my-org/my-app-configs.git --path dev --dest-server https://kubernetes.default.svc --dest-namespace my-webapp-prod
    

    이런 GitOps 툴을 활용하면, 기존 클러스터에서 사용하던 매니페스트(Manifest) 파일들을 Git 레포지토리에 올리고, 새 클러스터에 Argo CD를 설치하여 동기화하는 방식으로 쉽게 워크로드를 이전할 수 있어요. 코드로 인프라를 관리하는(Infrastructure as Code, IaC) 경험은 정말 혁신적입니다!

    ⚠️ 주의사항 및 트러블슈팅: 삽질 경험 공유

    제가 이 ‘차세대 전환’을 하면서 겪었던 몇 가지 삽질과 해결책들을 공유해볼게요.

    1. RKE1과 RKE2/K3s의 설정 차이: RKE1은 cluster.yml 파일을 기반으로 클러스터를 구성했지만, RKE2/K3s는 /etc/rancher/rke2/config.yaml (또는 k3s) 파일을 사용하거나 Helm 차트 등을 통해 더 세분화된 설정을 합니다. 기존 RKE1의 커스텀 설정(예: 추가 컨테이너 런타임 옵션, CNI 플러그인 설정)을 그대로 옮기려다 호환성 문제로 고생 좀 했어요. 새로운 배포판의 문서(Documentation)를 꼼꼼히 확인하는 것이 정말 중요합니다.
    2. StorageClass(스토리지 클래스) 호환성: 기존 클러스터에서 사용하던 PersistentVolume(영구 볼륨)과 PersistentVolumeClaim(영구 볼륨 클레임)은 StorageClass에 따라 다르게 동작할 수 있습니다. 특히 클라우드 환경이 변경되거나 스토리지 솔루션이 달라지면, 새로운 StorageClass를 정의하고 기존 PV/PVC를 마이그레이션해야 해요. 저는 홈랩에서 Longhorn(롱혼)을 사용하는데, 새 클러스터에 Longhorn을 재설치하고 데이터를 옮기는 과정에서 네트워크 설정 문제로 볼륨이 마운트되지 않아 애먹었습니다. 😅
    3. Cilium(실리움) CNI 도입 시 주의사항: 최근 Cilium이 성능과 보안 면에서 각광받고 있어서 저도 도입을 고려했는데, 기존 CNI(예: Canal)에서 Cilium으로 변경할 때는 네트워크 정책(Network Policy)과의 호환성, kube-proxy(쿠베 프록시) 없이 동작하는 모드(Direct Routing) 설정 등 고려할 사항이 많아요. 잘못하면 클러스터 내부 통신이 마비될 수 있으니 충분한 테스트 환경에서 검증해야 합니다.
    4. Rancher Management Server의 역할 변화: 기존에는 Rancher 서버가 모든 것을 다 해주는 느낌이었다면, 이제는 ‘관측성(Observability)’과 ‘정책 관리(Policy Management)’, 그리고 ‘클러스터 수명 주기 관리(Cluster Lifecycle Management)’에 더 집중하게 됩니다. 즉, 클러스터 내부의 복잡한 운영은 GitOps 툴과 같은 다른 도구들에게 맡기고, Rancher는 그 위에서 통합된 뷰를 제공하는 역할로 전환되는 거죠. 이 역할을 이해하지 못하면 ‘왜 Rancher가 예전처럼 클러스터 설정을 다 해주지 않지?’ 하고 헤맬 수 있습니다.

    검증 및 결과: 안정적인 차세대 환경 확인

    모든 워크로드 마이그레이션이 완료되었다면, 새로운 클러스터가 제대로 동작하는지 꼼꼼히 검증해야 합니다. 다음은 제가 주로 확인하는 항목들입니다.

    • 애플리케이션 정상 동작 확인: 모든 서비스의 엔드포인트에 접속하여 기능이 정상적으로 동작하는지 확인합니다. 특히 로깅(Logging)과 모니터링(Monitoring) 시스템이 제대로 연동되는지 확인하는 것이 중요해요.
    • 리소스 사용량 모니터링: Grafana(그라파나), Prometheus(프로메테우스) 등의 툴을 통해 CPU, 메모리, 네트워크, 디스크 I/O 등 클러스터 리소스 사용량을 면밀히 모니터링합니다. 기존 클러스터와 비교하여 비정상적인 패턴이 없는지 확인해야 합니다.
    • 클러스터 컴포넌트 상태: kubectl get pods -A 명령어로 모든 네임스페이스의 파드(Pod) 상태를 확인하고, kubectl get nodes로 노드 상태를 확인하여 문제가 없는지 점검합니다.
    • 데이터 정합성 검증: 상태 있는 애플리케이션의 경우, 이전된 데이터가 정확한지, 쓰기/읽기 작업이 문제없이 이루어지는지 반드시 확인해야 합니다.

    이 모든 검증을 마치고 나면, 드디어 새로운 차세대 Rancher 환경이 안정적으로 운영되는 것을 확인할 수 있어요. 이 뿌듯함이란! 🎉

    새롭게 마이그레이션된 Rancher 환경의 클러스터 대시보드

    새롭게 마이그레이션된 Rancher 환경에서 클러스터의 전반적인 상태를 보여주는 대시보드 화면입니다.

    마무리: 배운 점과 다음 단계

    Rancher 2.x에서 차세대 쿠버네티스 관리 환경으로의 전환은 단순히 소프트웨어 버전을 올리는 작업이 아니었습니다. 이는 클러스터 아키텍처, 운영 방식, 그리고 인프라 엔지니어의 역할에 대한 근본적인 재정의 과정이라고 생각해요. 저도 이 과정을 거치면서 많은 것을 배우고 삽질도 정말 많이 했습니다. 하지만 그 덕분에 GitOps의 중요성, RKE2/K3s의 장점, 그리고 Rancher가 나아가야 할 방향에 대해 더 깊이 이해하게 되었죠.

    Rancher 환경 전환 시 고려해야 할 핵심 사항 요약 인포그래픽

    Rancher 환경 전환 시 고려해야 할 핵심 사항들을 요약한 인포그래픽입니다.

    이번 마이그레이션을 통해 얻은 주요 교훈은 다음과 같습니다.

    • 계획의 중요성: 충분한 사전 계획 없이는 성공적인 마이그레이션은 불가능해요. 의존성 파악, 백업/복구 전략, 롤백 계획 등 모든 것을 미리 준비해야 합니다.
    • GitOps의 힘: 선언적인 코드로 인프라와 애플리케이션을 관리하는 GitOps는 복잡한 마이그레이션을 훨씬 수월하게 만들고, 향후 운영의 안정성을 높여줍니다.
    • 문서화의 중요성: 모든 변경 사항과 결정 사항을 문서화하여 팀원들과 공유하고, 향후 트러블슈팅에 활용해야 합니다.

    이제 새로운 클러스터에서 더 안정적이고 효율적인 쿠버네티스 운영을 할 수 있게 되었어요. 다음 단계로는 클러스터의 보안 강화(Security Hardening), 자동화된 재해 복구(Automated Disaster Recovery) 시스템 구축, 그리고 멀티 클러스터 환경에서의 서비스 메시(Service Mesh) 도입 등을 고민해볼 예정입니다. 여러분도 혹시 비슷한 고민을 하고 계시다면, 주저하지 말고 새로운 아키텍처로의 전환을 시도해보세요. 물론 삽질은 필수겠지만, 그만큼 얻는 것도 많을 겁니다! 궁금한 점이 있다면 언제든 댓글 남겨주세요. 다음 포스팅에서 또 재미있는 이야기로 찾아뵙겠습니다!
  • [3D Printer] 3D 프린터 필라멘트 보관 완벽 체크리스트: 습기 제거부터 수명 연장까지

    [3D Printer] 3D 프린터 필라멘트 보관 완벽 체크리스트: 습기 제거부터 수명 연장까지

    3D 프린터 필라멘트 보관 완벽 체크리스트: 습기 제거부터 수명 연장까지

    안녕하세요, 13년차 서버실 주인장입니다. 오늘은 3D 프린터 좀 돌려봤다는 분들이라면 한 번쯤 겪어봤을, 아니 어쩌면 지금도 고통받고 있을 그 문제! 바로 필라멘트 보관에 대한 이야기를 해보려고 합니다. 사실 처음 3D 프린터를 들였을 때는 필라멘트가 그냥 플라스틱 실 같은 거니 대충 던져놔도 되겠지 싶었거든요. 근데 이게 웬걸요? 출력할 때마다 이상한 소리가 나고, 표면은 거칠고, 심지어는 노즐이 막히는 불상사까지…
    저도 초기엔 뭣 모르고 방치했다가 멀쩡한 필라멘트 버린 게 한두 번이 아닙니다. 이 ‘습기’라는 녀석이 필라멘트 출력 품질에 얼마나 치명적인지 몸소 체험하고 나서야 제대로 된 보관법을 찾아 헤맸죠. 삽질 끝에 얻은 필라멘트 보관 노하우와 완벽 체크리스트를 오늘 이 자리에서 멘토처럼 상세히 풀어드릴게요. 이 글만 보시면 필라멘트 때문에 더 이상 스트레스받을 일은 없을 겁니다! 💡
    습기 흡수로 인해 3D 프린터 필라멘트가 출력물 품질 저하를 일으키는 과정을 보여주는 다이어그램

    3D 프린터 필라멘트가 습기를 머금어 출력 품질이 저하되는 과정을 시각화한 개념도입니다.

    필라멘트, 왜 습기에 취약할까요? (The Science Behind It)

    3D 프린터에 사용되는 필라멘트, 특히 PLA(PolyLactic Acid), ABS(Acrylonitrile Butadiene Styrene), PETG(Polyethylene Terephthalate Glycol) 같은 플라스틱 재료들은 흡습성(Hygroscopic)을 가지고 있습니다. 쉽게 말해, 주변 공기 중의 수분을 빨아들이는 성질이 있다는 거죠. 이 습기를 머금은 필라멘트를 가열해서 출력하면 어떻게 될까요? 필라멘트 내부의 수분이 고온에서 기화하면서 작은 수증기 방울을 만듭니다. 이 방울들이 출력물 표면에 기포를 만들고, 필라멘트의 사출을 방해하며 여러 문제를 일으키는 거죠.

    • 출력 품질 저하: 출력물 표면이 거칠어지고 기포가 생기며, 강도가 약해집니다.
    • 압출 불량(Under-extrusion): 필라멘트가 노즐을 통해 제대로 밀려 나오지 않아 출력물에 빈 공간이 생깁니다.
    • 수축(Shrinkage) 및 뒤틀림(Warping): 출력물이 베드에서 뜨거나 변형될 확률이 높아집니다.
    • 노즐 막힘(Nozzle Clogging): 습기로 인해 필라멘트가 끈적해지거나 분해되면서 노즐을 막을 수 있습니다.
    • 색상 변질: 특히 밝은 색상의 필라멘트는 습기에 노출되면 색이 바래거나 탁해질 수 있습니다.

    이런 문제들을 예방하려면 필라멘트를 꼼꼼하게 관리하는 것만이 답입니다. 제가 직접 경험한 필라멘트 보관 완벽 체크리스트, 지금부터 하나씩 짚어보죠!

    ✅ 필라멘트 보관 완벽 체크리스트

    필라멘트 보관의 핵심은 크게 두 가지입니다. 건조(Drying)와 밀봉(Sealing). 사용 전 습기를 완벽하게 제거하고, 사용하지 않을 때는 외부 습기와 완벽하게 차단하는 거죠. 마치 서버실에서 온도와 습도를 철저하게 관리하는 것처럼 생각해도 좋습니다.

    1. 습기 제거: 필라멘트 건조 방법 (Drying Your Filament)

    이미 습기를 머금은 필라멘트는 건조 과정을 거쳐야 합니다. 저는 이 과정에서 꽤나 다양한 방법을 시도해봤는데요, 각 방법의 장단점을 정리해봤습니다.

    1. 전용 필라멘트 건조기 (Dedicated Filament Dryer)

      • 장점: 필라멘트 건조에 최적화된 온도와 시간을 제공합니다. 설정이 간편하고, 출력 중에도 건조 상태를 유지할 수 있는 제품도 많습니다.
      • 단점: 초기 구매 비용이 발생합니다.
      • 팁: 저는 요즘 출력 전에 항상 건조기에 한두 시간 돌려놓는 습관을 들였어요. 확실히 출력 안정성이 좋아지더라고요.
    2. 식품 건조기 (Food Dehydrator)

      • 장점: 필라멘트 전용 건조기보다 저렴하며, 여러 필라멘트를 한 번에 건조할 수 있습니다. 온도 조절이 가능한 모델을 선택하면 좋습니다.
      • 단점: 필라멘트 스풀 크기에 따라 내부 트레이를 개조해야 할 수도 있습니다.
      • 팁: 제가 처음 시도했던 방법인데, 트레이를 몇 개 빼내고 스풀을 세워서 넣으니 딱 맞더라고요! 40~50℃에서 4~6시간 정도 건조하면 대부분의 필라멘트가 제습됩니다.
    3. 오븐 (Oven)

      • 장점: 집에 있는 오븐을 활용할 수 있어 추가 비용이 들지 않습니다.
      • 단점: 온도 조절이 매우 중요합니다! 오븐마다 편차가 크고, 너무 높은 온도에서는 필라멘트가 녹거나 변형될 수 있습니다. 온도를 정확하게 측정할 수 있는 온도계가 필수입니다.
      • 주의사항: 낮은 온도(40~60℃)에서 2~4시간 정도만 건조하세요. 그리고 반드시 오븐 문을 살짝 열어두어 습기가 빠져나갈 공간을 만들어주세요. 제가 이걸 모르고 밀폐된 상태에서 돌렸다가 필라멘트가 스풀에 들러붙는 대참사를 겪었습니다… ⚠️

    필라멘트 종류별 권장 건조 온도 및 시간 (일반적인 가이드)

    필라멘트 종류 권장 건조 온도 권장 건조 시간
    PLA 40-50℃ 4-6시간
    ABS 60-70℃ 4-8시간
    PETG 60-70℃ 6-10시간
    Nylon 70-80℃ 8-12시간

    ※ 위 표는 일반적인 가이드이며, 제조사별 권장 사항을 따르는 것이 가장 좋습니다.

    3D 프린터 필라멘트 건조를 위한 전용 건조기, 식품 건조기, 오븐 사용법 비교 인포그래픽

    다양한 필라멘트 건조 방법의 장단점과 주의사항을 한눈에 볼 수 있는 비교 인포그래픽입니다.

    2. 습기 차단: 필라멘트 보관 방법 (Storing Your Filament)

    건조한 필라멘트는 다시 습기를 흡수하지 않도록 밀봉 보관해야 합니다. 저는 처음에는 지퍼백에 대충 넣어뒀는데, 이것도 완벽하진 않더라고요. 결국 밀폐 용기와 제습제가 가장 확실한 답이었습니다.

    1. 밀폐 용기 (Airtight Container)

      • 선택 기준: 필라멘트 스풀이 충분히 들어갈 크기여야 합니다. 뚜껑에 고무 패킹이 있어 공기가 완벽하게 차단되는 제품이 좋습니다. 다이소나 마트에서 김치통 같은 걸로 찾아보면 의외로 좋은 제품이 많아요.
      • DIY 팁: 저는 이케아에서 파는 투명한 플라스틱 박스를 활용해봤는데, 스풀 여러 개를 한 번에 보관하기 좋더라고요.
    2. 제습제 (Desiccant)

      • 종류: 실리카겔(Silica Gel)이 가장 흔하고 효과적입니다. 색이 변하는 지시형 실리카겔(Indicating Silica Gel)을 사용하면 재활용 시기를 쉽게 알 수 있어 편리합니다.
      • 재활용: 실리카겔은 전자레인지나 오븐에 낮은 온도로 건조하면 다시 사용할 수 있습니다. 저는 색이 변한 실리카겔을 전자레인지에 1~2분 돌려 재활용하곤 해요. (너무 오래 돌리면 타버리니 주의하세요!)
      • 권장량: 스풀 1개당 100~200g 정도의 실리카겔을 함께 넣어두면 좋습니다.
    3. 진공 압축 백 (Vacuum Sealer Bag)

      • 장점: 부피를 최소화하고 공기를 완벽하게 차단합니다. 장기 보관에 특히 좋습니다.
      • 단점: 밀폐 용기보다 필라멘트 교체가 번거롭습니다.
      • 팁: 진공 포장기로 밀봉하면 필라멘트가 완전히 ‘숨을 쉴 수 없게’ 되어 습기 유입을 원천 차단할 수 있어요. 저는 잘 사용하지 않는 필라멘트나 대량 구매한 필라멘트를 이렇게 보관합니다.
    밀폐 용기, 진공 압축 백, 제습제를 활용한 DIY 필라멘트 보관 솔루션 이미지

    밀폐 용기와 진공 압축 백, 그리고 재활용 가능한 실리카겔을 활용한 필라멘트 보관 솔루션입니다.

    ⚠️ 주의사항 및 트러블슈팅 (Troubleshooting Common Issues)

    • 온도계 필수: 오븐이나 식품 건조기를 사용할 때는 반드시 별도의 온도계를 사용하여 실제 온도를 확인하세요. 오븐 내부 온도는 설정 온도와 다를 수 있습니다. 저는 초기에 이걸 몰라서 필라멘트를 망친 적이 꽤 많아요.
    • 밀봉 확인: 밀폐 용기의 고무 패킹이 제대로 작동하는지, 진공 압축 백에 공기가 새는 곳은 없는지 주기적으로 확인해야 합니다.
    • 습도계 활용: 보관함 안에 작은 디지털 습도계(Hygrometer)를 넣어두면 내부 습도 상태를 실시간으로 모니터링할 수 있어 편리합니다. 저는 홈랩에서 작은 IoT 센서를 활용해서 습도를 모니터링하고 알림을 받기도 합니다.
    • 필라멘트 냄새: 습기를 머금은 필라멘트는 가열될 때 평소와 다른 냄새가 날 수 있습니다. 이 또한 습기 문제의 신호일 수 있으니 주의 깊게 살펴보세요.

    🎉 검증 및 결과: 잘 보관된 필라멘트의 특징

    제대로 건조하고 보관된 필라멘트는 여러 면에서 확연한 차이를 보여줍니다. 육안으로도 확인 가능하고, 출력 시에도 그 진가가 드러나죠.

    • 출력 시 소음 감소: 습기 찬 필라멘트는 가열될 때 ‘파직파직’ 하는 소리를 냅니다. 건조된 필라멘트는 이런 소리가 거의 나지 않습니다.
    • 매끄러운 출력물 표면: 기포 없이 균일하고 매끄러운 표면을 얻을 수 있습니다.
    • 강도 향상: 출력물의 층간 접착력(Layer Adhesion)이 좋아져 강도가 단단해집니다.
    • 일정한 압출: 노즐을 통해 필라멘트가 끊김 없이 일정하게 사출됩니다.

    이런 변화들을 직접 경험해보시면 ‘아, 필라멘트 보관이 이렇게 중요했구나!’ 하고 무릎을 탁 치실 겁니다. 저도 처음엔 반신반의했지만, 결과물을 보니 투자한 시간과 노력이 전혀 아깝지 않더라고요. 🤩

    습기 관리 여부에 따른 3D 프린팅 결과물 품질 비교: 좋은 출력물과 불량 출력물

    습기 관리 여부에 따른 3D 프린팅 결과물의 품질 차이를 명확하게 보여주는 비교 이미지입니다.

    마무리하며: 필라멘트 수명 연장, 작은 습관에서 시작됩니다

    오늘은 3D 프린터 필라멘트 보관의 중요성과 구체적인 방법들을 알아봤습니다. 제가 13년 동안 서버실을 운영하면서 느낀 점이 있다면, ‘작은 디테일이 전체 시스템의 안정성을 좌우한다’는 거예요. 3D 프린팅도 마찬가지더라고요. 필라멘트라는 작은 재료 하나를 어떻게 관리하느냐에 따라 출력물의 품질과 프린터의 수명이 크게 달라질 수 있습니다.

    오늘 제가 알려드린 체크리스트를 바탕으로 여러분의 소중한 필라멘트를 오랫동안 최상의 상태로 유지하시길 바랍니다. 처음엔 좀 번거롭다고 느낄 수 있지만, 한두 번 해보면 금방 익숙해지실 겁니다. 그리고 그 작은 습관이 결국 여러분의 3D 프린팅 생활을 한 단계 업그레이드 시켜줄 거라고 확신합니다! 다음번에는 3D 프린터 펌웨어 업데이트에 대한 저의 ‘삽질’ 경험담을 풀어볼까 합니다. 기대해주세요! 🎉

  • [Proxmox] Ansible로 Proxmox 환경 1년 자동화 회고: 효율과 함정

    [Proxmox] Ansible로 Proxmox 환경 1년 자동화 회고: 효율과 함정

    Ansible로 Proxmox 환경 1년 자동화 회고: 효율과 함정

    안녕하세요, 13년차 서버실 지킴이입니다. 인프라 엔지니어로 일하다 보면 반복적인 작업에 지칠 때가 많죠. 특히 홈랩(Homelab)을 운영하는 저 같은 경우는 작은 규모라도 손이 많이 가는 일들이 부지기수입니다. 새로운 가상 머신(Virtual Machine, VM)을 만들고, 네트워크를 설정하고, 백업을 돌리는 일들은 매번 마우스 클릭과 타이핑의 연속이었거든요. ‘이걸 좀 더 효율적으로 할 수 없을까?’ 하는 고민은 늘 저를 따라다녔습니다. 그러다 1년 전, 제 Proxmox(프록스목스) 환경에 Ansible(앤서블)을 도입하기로 결심했고, 지금까지 정말 많은 것을 배우고 경험했습니다.

    오늘은 제가 지난 1년간 Ansible Proxmox 자동화를 구축하고 운영하면서 느꼈던 효율성과, 예상치 못했던 함정들, 그리고 그 해결 과정까지 솔직하게 풀어보려고 합니다. 혹시 저처럼 수동 작업의 굴레에서 벗어나고 싶은 인프라 엔지니어 분들이 계시다면, 이 글이 작은 힌트가 되기를 바랍니다.

    Ansible과 Proxmox를 활용한 홈랩 자동화 아키텍처 다이어그램

    Proxmox와 Ansible이 어떻게 연동되어 홈랩 인프라를 자동화하는지 보여주는 추상적인 아키텍처 다이어그램입니다. Ansible 컨트롤러가 SSH를 통해 Proxmox 노드와 통신하며, Proxmox API를 활용하여 VM, LXC 컨테이너, 스토리지, 네트워크 등의 리소스를 관리하는 모습을 나타냅니다.

    Ansible과 Proxmox, 왜 찰떡궁합일까요?

    먼저, 두 기술의 핵심 개념을 짧게 짚고 넘어가죠.

    • Ansible (앤서블): 에이전트리스(Agentless) 방식의 IT 자동화 도구입니다. 관리 대상 서버에 별도의 에이전트(Agent)를 설치할 필요 없이 SSH(Secure Shell) 연결을 통해 명령을 실행하고 작업을 수행하더라고요. YAML(야믈) 기반의 플레이북(Playbook)으로 인프라의 상태를 코드화(Infrastructure as Code, IaC)할 수 있다는 게 가장 큰 장점입니다.
    • Proxmox VE (프록스목스 가상 환경): 오픈소스 기반의 강력한 가상화 플랫폼입니다. 리눅스 컨테이너(LXC)와 KVM(Kernel-based Virtual Machine) 기반의 가상 머신을 모두 지원하며, 웹 기반 UI를 통해 쉽게 관리할 수 있죠. 엔터프라이즈급 기능을 홈랩에서도 무료로 활용할 수 있다는 점에서 인기가 많습니다.

    Ansible은 Proxmox가 제공하는 풍부한 API(Application Programming Interface)를 활용해 VM 생성, 네트워크 설정, 스냅샷 관리 등 거의 모든 작업을 자동화할 수 있더라고요. Ansible Proxmox 모듈 덕분에 복잡한 API 호출 없이도 YAML 플레이북으로 직관적인 작업이 가능합니다. 말 그대로 인프라를 코드로 관리하는 거죠.

    1년 간의 Ansible Proxmox 자동화, 실전 구현 경험

    처음엔 저도 ‘이게 진짜 될까?’ 싶었거든요. 그런데 막상 해보니 생각보다 강력하더라고요. 기본적인 VM 생성부터 복잡한 네트워크 설정, 백업 관리까지 Ansible 플레이북 하나로 뚝딱 해결되는 걸 보고 감탄했습니다.

    기본적인 VM 생성 플레이북

    가장 많이 사용하는 작업이죠. 새로운 VM을 만들고, OS 이미지를 마운트하고, 기본적인 리소스(CPU, RAM, 디스크)를 할당하는 플레이북입니다. 저는 주로 community.general.proxmox 컬렉션의 모듈들을 활용했습니다.

    # vm_create.yml
    ---
    - name: Proxmox에 새로운 VM 생성 및 설정
      hosts: proxmox_host
      gather_facts: no
      vars:
        vm_id: 101
        vm_name: my-test-vm
        vm_memory: 2048 # MB
        vm_cores: 2
        vm_disk_size: 30 # GB
        vm_iso: local:iso/ubuntu-22.04-live-server-amd64.iso # Proxmox ISO 스토리지 경로
        vm_bridge: vmbr0
        vm_ip: 192.168.1.101/24
        vm_gw: 192.168.1.1
        vm_dns: 8.8.8.8
    
      tasks:
        - name: VM 생성
          community.general.proxmox_kvm:
            api_host: "{{ inventory_hostname }}"
            api_user: root@pam
            api_password: "{{ proxmox_root_password }}" # ansible vault로 관리
            vmid: "{{ vm_id }}"
            name: "{{ vm_name }}"
            memory: "{{ vm_memory }}"
            cores: "{{ vm_cores }}"
            scsihw: virtio-scsi-pci
            bootdisk: scsi0
            iso: "{{ vm_iso }}"
            net:
              - name: net0
                model: virtio
                bridge: "{{ vm_bridge }}"
            state: present
          register: create_vm_result
    
        - name: 디스크 추가 (VM 생성 시 디스크 옵션이 없는 경우)
          community.general.proxmox_disk:
            api_host: "{{ inventory_hostname }}"
            api_user: root@pam
            api_password: "{{ proxmox_root_password }}"
            vmid: "{{ vm_id }}"
            disk: scsi0
            size: "{{ vm_disk_size }}G"
            storage: local-lvm # Proxmox 스토리지 이름
            format: qcow2
            state: present
          when: create_vm_result.changed # VM이 새로 생성되었을 때만 디스크 추가
    
        - name: VM 부팅
          community.general.proxmox_kvm:
            api_host: "{{ inventory_hostname }}"
            api_user: root@pam
            api_password: "{{ proxmox_root_password }}"
            vmid: "{{ vm_id }}"
            state: started
          when: create_vm_result.changed

    위 플레이북은 특정 Proxmox 호스트(proxmox_host)에 새로운 VM을 만들고 시작하는 예시입니다. proxmox_root_password 같은 민감 정보는 나중에 설명할 Ansible Vault(볼트)로 암호화해서 관리하는 게 좋습니다. 그리고 VM 생성 시 디스크 옵션을 한 번에 주기 어려운 모듈 버전도 있어서, 저는 디스크 추가 태스크를 따로 분리하기도 했어요.

    네트워크 설정 자동화 (Bridge, VLAN)

    Proxmox 노드의 네트워크 인터페이스 설정도 Ansible로 자동화하더라고요. 특히 브릿지(Bridge)나 VLAN(Virtual Local Area Network) 태그를 적용할 때 정말 유용했습니다.

    # network_config.yml
    ---
    - name: Proxmox 노드 네트워크 설정
      hosts: proxmox_host
      become: yes
      tasks:
        - name: 네트워크 인터페이스 백업
          ansible.builtin.copy:
            src: /etc/network/interfaces
            dest: /etc/network/interfaces.bak_{{ ansible_date_time.iso8601_basic_short }}
            remote_src: yes
    
        - name: 새로운 네트워크 설정 적용
          ansible.builtin.template:
            src: interfaces.j2
            dest: /etc/network/interfaces
            owner: root
            group: root
            mode: '0644'
          notify: 네트워크 서비스 재시작
    
      handlers:
        - name: 네트워크 서비스 재시작
          ansible.builtin.systemd:
            name: networking
            state: restarted
    # templates/interfaces.j2
    # /etc/network/interfaces - Proxmox Host Network Configuration
    
    auto lo
    iface lo inet loopback
    
    auto vmbr0
    iface vmbr0 inet static
      address {{ vmbr0_ip }}
      netmask {{ vmbr0_netmask }}
      gateway {{ vmbr0_gateway }}
      bridge-ports {{ physical_nic }}
      bridge-stp off
      bridge-fd 0
    
    # VLAN 10 for Management
    auto vmbr0.10
    iface vmbr0.10 inet static
      address {{ vmbr0_10_ip }}
      netmask {{ vmbr0_10_netmask }}
      vlan-raw-device vmbr0

    template 모듈을 사용해서 Jinja2 템플릿 파일(interfaces.j2)로 Proxmox 호스트의 /etc/network/interfaces 파일을 관리했습니다. 이렇게 하면 네트워크 구성이 코드화되어 버전 관리도 쉽고, 여러 노드에 동일한 설정을 적용하기도 편리하죠. notify 핸들러를 사용해서 변경 사항 적용 후 네트워크 서비스를 자동으로 재시작하도록 했습니다.

    백업 및 스냅샷 관리

    데이터는 소중하니까요. 자동화된 백업과 스냅샷 관리는 필수입니다. 특히 홈랩에서는 실수로 날려버리는 경우가 많아서 꼭 필요하더라고요.

    # backup_snapshot.yml
    ---
    - name: Proxmox VM 백업 및 스냅샷 관리
      hosts: proxmox_host
      gather_facts: no
      vars:
        vmid_to_manage: 101
        backup_storage: backup_pool # Proxmox 백업 스토리지 이름
    
      tasks:
        - name: VM 스냅샷 생성
          community.general.proxmox_snap:
            api_host: "{{ inventory_hostname }}"
            api_user: root@pam
            api_password: "{{ proxmox_root_password }}"
            vmid: "{{ vmid_to_manage }}"
            snapname: "daily-snapshot-{{ ansible_date_time.iso8601_basic_short }}"
            description: "Daily snapshot by Ansible"
            state: present
    
        - name: VM 백업 실행 (shell 명령 사용)
          ansible.builtin.shell: |
            vzdump {{ vmid_to_manage }} \
              --storage {{ backup_storage }} \
              --compress zstd \
              --mode stop
          register: backup_result
          async: 3600
          poll: 60

    proxmox_snap 모듈로 특정 VM의 스냅샷을 생성했습니다. 백업의 경우, Proxmox 환경에 따라 직접 vzdump 유틸리티를 호출하는 방식도 많이 사용합니다. 이렇게 하면 더 세밀한 제어가 가능하더라고요. async: 3600과 poll: 60을 사용해서 백업이 완료될 때까지 Ansible이 기다려줍니다.

    Ansible 플레이북 실행 성공 결과 터미널 화면

    Ansible 플레이북이 성공적으로 실행되어 Proxmox 환경에 VM이 생성되고 네트워크 설정이 적용되는 과정을 보여주는 터미널 화면입니다. 각 태스크의 성공 여부와 변경 사항이 녹색으로 표시되어 자동화가 잘 작동하고 있음을 나타냅니다.

    ⚠️ 삽질 대잔치! Proxmox Ansible 자동화의 함정과 해결책

    자동화가 늘 쉬웠던 건 아닙니다. 저도 꽤 많은 삽질을 했거든요. 특히 Proxmox는 업데이트 주기가 빠르고, Ansible 모듈도 계속 발전하다 보니 버전 호환성이나 예상치 못한 동작으로 골머리를 앓기도 했습니다.

    모듈 버전 호환성 문제

    초기에는 community.general 컬렉션의 proxmox 모듈이 자주 업데이트되면서, 특정 옵션이 사라지거나 이름이 바뀌는 경우가 많았습니다. 제가 작성했던 플레이북이 갑자기 에러를 뿜어낼 때마다 당황했죠.

    • 해결책: `ansible-galaxy collection install community.general:==X.Y.Z` 명령으로 특정 버전의 컬렉션을 설치하고 고정했습니다. 프로덕션 환경이라면 더더욱 버전을 명확히 관리하는 것이 중요하더라고요.

    인증 방식의 복잡함

    Proxmox API에 접근하려면 인증이 필요합니다. 처음엔 root 계정의 비밀번호를 직접 플레이북에 넣었는데, 보안상 너무 위험하다는 걸 깨달았죠.

    • 해결책: Proxmox의 API 토큰(API Token) 기능을 활용했습니다. 특정 사용자에게만 권한을 부여한 API 토큰을 발급받아 사용하고, 이 토큰 정보는 Ansible Vault (앤서블 볼트)로 암호화해서 관리했습니다. ansible-vault encrypt_string 'MY_PROXMOX_API_TOKEN' --name 'proxmox_api_token' 같은 명령어로 쉽게 암호화할 수 있습니다.

    네트워크 인터페이스 이름 충돌

    VM을 생성할 때 네트워크 인터페이스를 여러 개 추가하다 보면, Proxmox 내부적으로 할당되는 인터페이스 이름(예: net0, net1) 때문에 예상치 못한 문제가 발생하기도 했습니다. 특히 net 배열 인덱스를 잘못 지정하면 원하는 브릿지에 연결이 안 되는 경우가 있었어요.

    • 해결책: 플레이북 내에서 net 옵션을 사용할 때 인덱스 순서를 명확히 하고, Proxmox 웹 UI에서 VM 생성 후 실제 할당된 인터페이스 이름과 비교하며 디버깅했습니다. 그리고 네트워크 설정 변경 후 Proxmox 호스트 재부팅이 필요한 경우도 있어서, reboot 모듈을 활용하기도 했습니다.

    비동기 작업 처리

    VM 생성이나 백업 같은 작업은 시간이 오래 걸릴 수 있습니다. Ansible은 기본적으로 동기(Synchronous) 방식으로 동작하기 때문에, Proxmox에서 작업이 완료되기 전에 Ansible 태스크가 타임아웃(Timeout)되거나 다음 태스크로 넘어가 버리는 문제가 있었습니다.

    • 해결책: async와 poll 옵션을 활용했습니다. 예를 들어, async: 300은 해당 태스크를 백그라운드에서 최대 300초(5분) 동안 실행하고, poll: 10은 10초마다 작업 완료 여부를 확인하는 방식입니다. 이렇게 하면 Ansible이 Proxmox의 비동기 작업을 기다려줍니다.
    Proxmox 웹 UI에서 Ansible로 자동화된 VM 리스트 확인

    Ansible 자동화로 생성 및 설정된 Proxmox VM들의 리스트를 Proxmox 웹 UI에서 보여주는 화면입니다. 플레이북으로 지정된 이름과 ID, 그리고 현재 상태(Running)가 명확하게 표시되어 자동화가 잘 작동하고 있음을 나타냅니다.

    🎉 1년 간의 성과와 얻은 교훈 (검증 및 결과)

    지난 1년간 Ansible과 Proxmox를 함께 사용하면서 얻은 가장 큰 성과는 역시 효율성입니다. 이제는 새로운 서버를 구축하거나 기존 서버 환경을 재구성할 때 클릭 몇 번이 아니라, 플레이북 실행 한 번으로 모든 것이 해결됩니다. 삽질도 많이 했지만, 그만큼 얻은 것도 많아요.

    압도적인 효율성 증가

    예전에는 새 VM 하나 만드는데 10분 이상 걸렸지만, 이제는 플레이북 실행부터 VM 부팅까지 2~3분이면 충분합니다. 특히 여러 대의 VM을 동시에 배포할 때는 그 효과가 정말 크더라고요. 재현 가능한(Idempotent) 인프라를 구축했다는 점도 중요합니다. 언제든 동일한 상태로 인프라를 복원하거나 재구축할 수 있거든요.

    인프라 문서화 효과

    플레이북 자체가 인프라의 현재 상태를 설명하는 가장 정확한 문서가 됩니다. 누가 봐도 이 플레이북이 어떤 VM을 어떤 설정으로 만들고 있는지 한눈에 들어오더라고요. 팀원들과의 협업이나 나중에 인프라를 다시 파악할 때 정말 큰 도움이 됩니다.

    홈랩 운영의 즐거움

    무엇보다 홈랩 운영이 훨씬 즐거워졌습니다. 새로운 기술을 실험하고 싶을 때, 클릭 몇 번으로 환경을 만들고 망가뜨려도 부담이 없거든요. 실패해도 플레이북만 다시 돌리면 그만이니까요. 이게 진짜 홈랩 자동화 경험의 핵심 아닐까요?

    Ansible Proxmox 자동화의 장점과 단점을 비교하는 표

    Ansible을 활용한 Proxmox 자동화의 주요 장점과 고려해야 할 단점을 비교하여 보여주는 표입니다. 효율성, 재현성, 문서화 등의 장점과 함께 학습 곡선, 복잡성 관리 등의 단점을 요약합니다.

    마무리하며: 다음 단계와 독자에게 전하는 말

    Ansible과 Proxmox의 조합은 저의 인프라 관리 방식을 완전히 바꿔놓았습니다. 물론 완벽하지는 않았지만, 수동 작업으로 인한 피로감을 줄이고, 더 본질적인 문제 해결에 집중할 수 있게 해주었죠. Ansible 플레이북과 Proxmox 인프라 관리에 대한 경험은 저에게 큰 자산이 되었습니다.

    혹시 아직 자동화를 시작하지 않으셨다면, 작은 부분부터라도 꼭 도전해보시길 권합니다. 처음엔 어렵게 느껴질 수 있지만, 한 번 손에 익으면 인프라 관리의 새로운 지평이 열릴 겁니다. Ansible 외에도 Terraform(테라폼) 같은 다른 IaC 도구들도 많으니, 여러분의 환경과 필요에 맞는 도구를 찾아보는 것도 좋은 방법입니다. 저는 다음 단계로 Proxmox 클러스터 관리나 더 복잡한 스토리지 연동 자동화에 도전해볼 생각입니다. 여러분의 자동화 여정도 응원할게요! 궁금한 점이나 공유하고 싶은 경험이 있다면 언제든 댓글로 남겨주세요.

  • [Nas] Jellyfin 트랜스코딩 성능 벤치마크: N100 미니PC vs Ryzen 5700G NAS

    [Nas] Jellyfin 트랜스코딩 성능 벤치마크: N100 미니PC vs Ryzen 5700G NAS

    안녕하세요, 13년차 서버실 지킴이입니다. 😅 요즘 홈랩에서 미디어 서버 가지고 씨름하는 재미에 푹 빠져 있네요. 다들 Plex나 Emby 많이 쓰시겠지만, 저는 오픈소스의 매력에 빠져 Jellyfin을 열심히 굴리고 있습니다. 개인 미디어 라이브러리를 구축하고 언제 어디서든 원하는 콘텐츠를 스트리밍하는 건 정말 매력적인 일이거든요.

    근데 여기서 늘 고민되는 부분이 있죠? 바로 트랜스코딩(Transcoding) 성능입니다. 원본 파일을 그대로 재생할 수 없는 기기(낮은 대역폭, 특정 코덱 미지원 등)에서 미디어를 보려면, 서버에서 실시간으로 변환해줘야 하거든요. 이 과정이 서버에 꽤나 큰 부하를 줍니다.

    그래서 제가 직접 한번 비교해봤습니다. 요즘 가성비 미니PC로 핫한 N100 미니PC와, 제가 주력으로 쓰는 Ryzen 5700G 기반의 NAS에서 Jellyfin 트랜스코딩 성능이 얼마나 차이 나는지 말이죠. 혹시 어떤 하드웨어로 미디어 서버를 구축할지 고민 중이셨다면, 오늘 제 삽질 경험과 벤치마크 결과가 작은 힌트가 될 거예요! 함께 보시죠. 🚀

    N100 미니PC와 Ryzen 5700G NAS를 활용한 Jellyfin 미디어 서버 홈랩 아키텍처 다이어그램

    N100 미니PC와 Ryzen 5700G NAS를 활용한 Jellyfin 미디어 서버 홈랩 아키텍처 다이어그램

    💡 Jellyfin 트랜스코딩, 왜 중요할까요?

    자, 먼저 트랜스코딩(Transcoding)이 뭔지 쉽게 설명해 드릴게요. 쉽게 말해, ‘실시간 동영상 변환’이라고 생각하시면 됩니다. 우리가 스마트폰으로 4K 고화질 영화를 보려고 하는데, 인터넷 회선이 느리거나 스마트폰이 4K HEVC(H.265) 코덱을 제대로 지원하지 못할 때가 있잖아요? 이럴 때 Jellyfin 서버가 ‘아, 알겠어! 그럼 이 4K HEVC 영상을 1080p H.264로 바꿔서 보내줄게!’ 하고 실시간으로 변환해서 보내주는 게 바로 트랜스코딩입니다.

    이 과정이 중요한 이유는, 모든 기기가 모든 코덱과 해상도를 지원하지 않기 때문이에요. 특히 외부에서 접속할 때는 네트워크 대역폭 문제로 트랜스코딩이 필수적일 때가 많습니다. 문제는 이 변환 작업이 CPU 자원을 엄청나게 잡아먹는다는 점이죠. 그래서 우리는 하드웨어 트랜스코딩(Hardware Transcoding)에 주목해야 합니다.

    하드웨어 트랜스코딩은 CPU가 아닌 GPU(Graphics Processing Unit)에 내장된 전용 인코더와 디코더를 활용해서 처리하는 방식입니다. 인텔 CPU의 Quick Sync Video (QSV)나 AMD CPU의 Video Core Next (VCN) 같은 기술들이 여기에 해당하죠. 이 기능을 활용하면 CPU 부하를 획기적으로 줄이고, 훨씬 많은 동시 스트림을 처리할 수 있게 됩니다. Jellyfin은 이러한 하드웨어 가속 기능을 아주 잘 지원하는 고마운 미디어 서버입니다. 🎉

    🛠️ 실전 구현: Jellyfin 벤치마크 환경 구성

    본격적인 벤치마크를 위해 두 가지 시스템에 Jellyfin을 설치하고 설정해봤습니다. 둘 다 리눅스 기반 환경에서 Docker 컨테이너로 Jellyfin을 운영했습니다.

    1. N100 미니PC 환경

    • 프로세서: Intel N100 (4코어, 4스레드)
    • 내장 GPU: Intel UHD Graphics (Quick Sync Video 지원)
    • RAM: 16GB DDR5
    • OS: Ubuntu Server 22.04 LTS
    • Jellyfin 설치: Docker Compose

    N100은 저전력 프로세서로 유명하죠. 하지만 Quick Sync Video 덕분에 미디어 트랜스코딩 성능은 예상외로 꽤나 괜찮더라고요. 특히 전성비(전력 대비 성능)가 아주 훌륭합니다.

    2. Ryzen 5700G NAS 환경

    • 프로세서: AMD Ryzen 7 5700G (8코어, 16스레드)
    • 내장 GPU: Radeon Graphics (Video Core Next, VCN 지원)
    • RAM: 32GB DDR4
    • OS: Unraid OS (내부적으로 Linux 기반)
    • Jellyfin 설치: Docker Compose

    Ryzen 5700G는 CPU 성능도 강력하고, 내장 그래픽 성능도 꽤 괜찮아서 다재다능한 NAS 구축에 인기가 많죠. 과연 Jellyfin 트랜스코딩 성능에서는 어떤 모습을 보여줄까요?

    Jellyfin Docker 설치 및 하드웨어 가속 설정 (공통)

    기본적인 Jellyfin Docker Compose 설정은 다음과 같습니다. 하드웨어 가속을 사용하려면 /dev/dri 장치를 컨테이너에 매핑해주는 것이 핵심입니다.

    version: "3.8"
    services:
      jellyfin:
        image: jellyfin/jellyfin:latest
        container_name: jellyfin
        network_mode: host
        volumes:
          - /path/to/jellyfin/config:/config
          - /path/to/jellyfin/cache:/cache
          - /path/to/your/media:/media
          # 하드웨어 가속을 위한 장치 매핑
          - /dev/dri:/dev/dri
        devices:
          # 추가적으로 디바이스 직접 매핑 (N100/Intel QSV의 경우 필수)
          - /dev/dri/renderD128:/dev/dri/renderD128
          - /dev/dri/card0:/dev/dri/card0
        restart: unless-stopped
        environment:
          - PUID=1000
          - PGID=1000
          - TZ=Asia/Seoul
          # 추가적인 환경 변수 (예: NVIDIA GPU 사용 시)
          # - NVIDIA_VISIBLE_DEVICES=all
          # - NVIDIA_DRIVER_CAPABILITIES=all
    

    Jellyfin 웹 UI에 접속한 후, 관리자 대시보드 > 재생(Playback) 설정에서 하드웨어 가속 옵션을 선택해야 합니다. N100은 VAAPI를, Ryzen 5700G는 AMF 또는 VAAPI를 선택하고 선호하는 인코더/디코더를 설정해줍니다.

    Jellyfin 미디어 서버의 하드웨어 트랜스코딩 설정 화면 예시

    Jellyfin 미디어 서버의 하드웨어 트랜스코딩 설정 화면 예시

    ⚠️ 주의사항 및 트러블슈팅: 삽질은 나의 힘!

    제가 이 과정에서 겪었던 삽질 경험을 솔직하게 공유해 드릴게요. 😭

    1. 드라이버 문제: 하드웨어 가속은 단순히 장치를 매핑한다고 끝나는 게 아닙니다. 리눅스 환경에서 해당 GPU를 위한 드라이버와 라이브러리가 제대로 설치되어 있어야 하거든요.
      • N100 (Intel QSV): intel-media-va-driver-non-free (Debian/Ubuntu 계열) 패키지 설치가 필수였습니다. 처음엔 이것 때문에 VAAPI가 제대로 작동하지 않아서 ‘N100이 생각보다 별로인가?’ 하고 좌절했었죠. 🤦
      • Ryzen 5700G (AMD VCN): AMD는 인텔보다 드라이버 세팅이 까다로운 경우가 종종 있더라고요. mesa-va-drivers 같은 VAAPI 관련 패키지는 물론이고, 커널 모듈 (amdgpu)이 제대로 로드되어 있는지 확인해야 합니다. Unraid 같은 OS는 기본적으로 잘 세팅되어 있지만, 순수 Ubuntu에서는 조금 더 신경 써야 할 수 있어요.
    2. 권한 문제: Docker 컨테이너가 /dev/dri 장치에 접근할 권한이 없어서 문제가 발생하기도 합니다. Docker Compose 파일에 devices 섹션을 추가하고, 호스트 시스템에서 Jellyfin을 실행하는 사용자(PUID/PGID)가 video 그룹에 속해 있는지 확인하는 것이 중요합니다.
    3. 코덱 지원: 모든 GPU가 모든 코덱을 하드웨어 가속으로 지원하는 건 아닙니다. 특히 VP9, AV1 같은 최신 코덱이나 10비트 HEVC 같은 특정 포맷은 하드웨어 지원 여부를 확인해야 합니다. 제가 주로 테스트한 4K HEVC -> 1080p H.264 변환은 대부분의 최신 GPU에서 잘 지원하더라고요.

    이런 문제들 때문에 밤늦게까지 구글링하고 포럼을 뒤적거렸던 기억이 생생하네요. 😅 하지만 해결하고 나면 그 성취감이란! 여러분은 저처럼 삽질하지 마시라고 이렇게 자세히 적어봅니다. 💪

    📊 Jellyfin 트랜스코딩 벤치마크 검증 및 결과

    본격적인 벤치마크는 다음과 같은 방식으로 진행했습니다.

    • 테스트 파일: 4K HEVC (H.265) 10비트 영상
    • 트랜스코딩 목표: 1080p H.264
    • 측정 방법: 여러 클라이언트에서 동시에 스트리밍을 시작하며, 각 서버의 CPU 및 GPU 사용률, 그리고 버퍼링 발생 여부 확인
    • 모니터링 도구: htop (CPU), intel_gpu_top (N100 GPU), radeontop (Ryzen 5700G GPU), Jellyfin 대시보드 로그

    N100 미니PC 결과

    예상보다 훨씬 뛰어난 성능을 보여줬습니다! N100의 Intel Quick Sync Video는 정말 대단하더군요. 3개 정도의 4K HEVC -> 1080p H.264 동시 트랜스코딩은 무리 없이 소화해냈습니다. GPU 사용률은 70~80% 정도로 올라갔지만, CPU 사용률은 20~30% 정도로 매우 낮게 유지되면서 안정적인 스트리밍을 제공했습니다. 4개 스트림부터는 가끔 버퍼링이 발생하기 시작했거든요.

    저전력 미니PC에서 이 정도 성능이라니, 정말 인상 깊었습니다. 전력 소모도 아이들 시 10W 내외, 트랜스코딩 시 20W 내외로 매우 착했습니다. 💡

    Ryzen 5700G NAS 결과

    역시 Ryzen 5700G는 강력했습니다. 5~6개 정도의 4K HEVC -> 1080p H.264 동시 트랜스코딩도 거뜬히 처리했습니다. GPU 사용률은 50~60% 수준에서 안정적이었고, CPU 사용률도 N100과 마찬가지로 낮게 유지되었습니다. 7개 이상부터는 간헐적인 버퍼링이 발생하기 시작했거든요.

    N100보다 더 많은 동시 스트림을 처리할 수 있었고, 여전히 CPU 자원에 여유가 있어서 다른 NAS 작업(가상 머신, 다른 Docker 컨테이너 등)을 병행하기에도 충분했습니다. 다만, 전력 소모는 아이들 시 30W 내외, 트랜스코딩 시 50~60W 정도로 N100보다는 높았습니다.

    정리하자면 다음과 같습니다.

    Jellyfin 트랜스코딩 N100과 Ryzen 5700G의 동시 스트림 및 CPU/GPU 사용률 비교 그래프

    Jellyfin 트랜스코딩 N100과 Ryzen 5700G의 동시 스트림 및 CPU/GPU 사용률 비교 그래프

    마무리: 당신의 선택은?

    자, 이제 결론을 내릴 시간입니다. 어떤 시스템이 더 좋은 선택일까요?

    특성 N100 미니PC Ryzen 5700G NAS
    트랜스코딩 성능 (동시 스트림) 3~4개 (4K HEVC -> 1080p H.264) 5~6개 이상 (4K HEVC -> 1080p H.264)
    전력 소모 매우 낮음 (아이들 10W, 풀로드 20W 내외) 보통 (아이들 30W, 풀로드 50~60W 내외)
    가격 저렴 (10~20만원대) 높음 (30만원 이상, NAS 구성 시 더 높음)
    다용도성 Jellyfin 전용 미디어 서버로 최적 Jellyfin + NAS + VM 등 다용도 서버로 최적
    주요 장점 압도적인 전성비, 저렴한 구축 비용 강력한 CPU 성능, 높은 동시 스트림 처리, 높은 확장성
    추천 대상 1~3인 가구, 전력 소모에 민감한 사용자 3인 이상 가구, 다양한 서버 기능 원하는 사용자

    개인적인 생각으로는, 순수하게 Jellyfin 미디어 서버만을 위한 시스템을 구축한다면 N100 미니PC의 가성비와 전성비는 정말 타의 추종을 불허하더라고요. 저렴한 가격에 이 정도 성능을 뽑아준다는 건 정말 놀라운 일입니다. 혼자 또는 가족과 함께 사용하는 미디어 서버로는 충분하고도 남습니다.

    하지만 만약 NAS에 더 많은 기능(파일 서버, 백업, 가상 머신, 다른 Docker 서비스 등)을 올리고 싶고, 동시 스트림 사용자 수가 많다면 Ryzen 5700G 같은 더 강력한 프로세서가 탑재된 NAS가 좋은 선택이 될 거예요. 저처럼 홈랩에서 이것저것 실험하는 분들에게는 이쪽이 더 매력적일 수 있습니다.

    이번 벤치마크를 통해 하드웨어 가속의 중요성을 다시 한번 깨달았더라고요. 그리고 드라이버 세팅의 중요성도요! 😅 여러분도 자신의 환경과 예산에 맞춰 현명한 선택을 하시길 바랍니다. 다음번에는 Jellyfin과 Emby의 좀 더 심층적인 비교 분석으로 찾아올게요! 그때까지 즐거운 홈랩 생활 되세요! 👋

    N100 미니PC와 Ryzen 5700G NAS의 Jellyfin 미디어 서버 장단점 비교 인포그래픽

    N100 미니PC와 Ryzen 5700G NAS의 Jellyfin 미디어 서버 장단점 비교 인포그래픽