13년차의 서버실

서버, 인프라, 홈랩 기술 블로그

[작성자:] admin

  • [Cloud] Terraform 멀티 클라우드 관리 가이드 – AWS/GCP/Azure 한 번에 관리하기

    [Cloud] Terraform 멀티 클라우드 관리 가이드 – AWS/GCP/Azure 한 번에 관리하기

    멀티 클라우드, 이제는 선택이 아니라 현실입니다

    혹시 이런 상황 겪어보신 적 있으신가요? 개발팀에서는 AWS를 쓰고, 데이터 분석팀에서는 GCP BigQuery를 쓰고, 어느 날 갑자기 Azure AD 연동도 필요하다고 하고… 처음엔 각 팀이 알아서 하면 되겠지 싶었는데, 인프라 엔지니어 입장에서 이걸 다 관리하려니 머리가 터질 것 같더라고요.

    저도 딱 그 상황이었습니다. 몇 년 전에 회사에서 AWS만 쓰다가 GCP 프로젝트가 하나 붙고, 또 Azure가 붙고… 각 클라우드마다 콘솔 따로 열고, CLI 따로 설치하고, 권한 관리도 따로 하다 보니 진짜 정신없었거든요. 그때 Terraform으로 멀티 클라우드 환경을 구성하면서 삶이 좀 편해졌습니다 ㅎㅎ

    이 글에서는 제가 직접 구성해서 운영 중인 Terraform으로 AWS, GCP, Azure를 동시에 관리하는 멀티 클라우드 IaC(Infrastructure as Code, 코드로 인프라 관리) 환경을 단계별로 풀어드릴게요. 처음 접하시는 분도 따라오실 수 있게 최대한 친절하게 써볼게요.
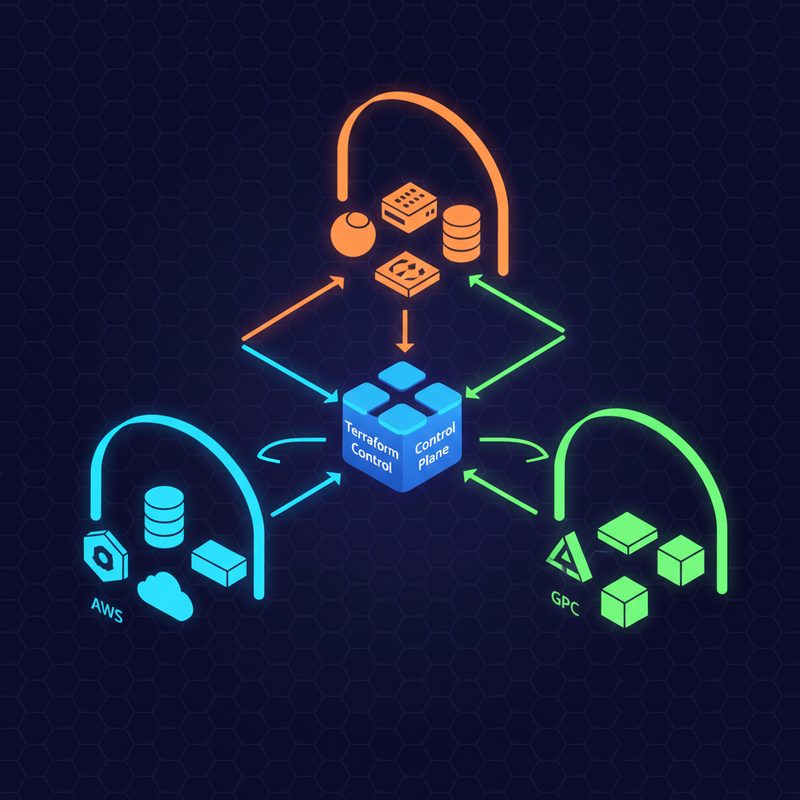
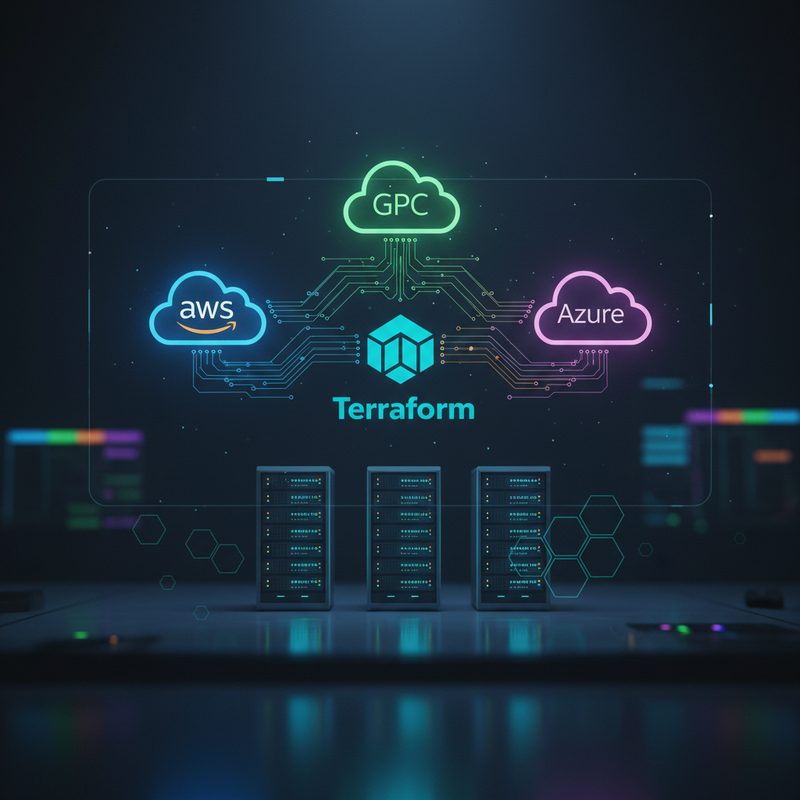
    Terraform multi-cloud architecture diagram showing AWS, GCP, and Azure connected through a central Terraform control plane with arrows indicating resource provisioning flow

    ▲ Terraform 단일 코드베이스에서 AWS, GCP, Azure 세 클라우드를 동시에 관리하는 전체 아키텍처 개요도

    Terraform 멀티 클라우드란? 한 번에 여러 클라우드를 관리하는 방법

    Terraform은 HashiCorp에서 만든 오픈소스 IaC 도구입니다. 쉽게 말해, 클라우드 인프라를 코드로 정의하고 실행하면 실제 리소스가 만들어지는 방식이에요. 여러 클라우드를 한 번에 관리할 수 있다는 게 가장 큰 장점입니다.

    여기서 핵심은 Provider(프로바이더)라는 개념입니다. Terraform은 각 클라우드사에서 제공하는 Provider 플러그인을 통해 해당 클라우드와 통신하거든요. AWS Provider, Google Provider, AzureRM Provider를 동시에 선언하면 하나의 Terraform 코드로 여러 클라우드를 한 번에 관리할 수 있어요.

    구분 AWS GCP Azure
    Terraform Provider hashicorp/aws hashicorp/google hashicorp/azurerm
    인증 방식 Access Key / IAM Role Service Account JSON / ADC Service Principal / Managed Identity
    상태 저장소 S3 + DynamoDB GCS Bucket Azure Blob Storage
    주요 IaC 용어 Region, VPC, EC2 Project, VPC, Compute Subscription, VNet, VM

    저도 처음엔 각 클라우드마다 용어가 달라서 헷갈렸는데요, Terraform을 쓰면 이 차이를 Provider가 알아서 추상화해줘서 훨씬 편하더라고요.

    디렉터리 구조 설계 — 이게 제일 중요합니다

    멀티 클라우드 Terraform 프로젝트에서 제가 가장 많이 고민한 부분이 바로 디렉터리 구조였어요. 처음에 그냥 막 만들었다가 나중에 전부 갈아엎은 쓴 경험이 있거든요. 그래서 여러분은 처음부터 제대로 잡으셨으면 해서 제가 실제로 쓰는 구조를 공유합니다.

    multi-cloud-infra/
    ├── providers.tf          # 모든 Provider 선언
    ├── versions.tf           # Terraform 버전 및 Provider 버전 고정
    ├── variables.tf          # 공통 변수
    ├── outputs.tf            # 공통 출력값
    │
    ├── modules/              # 재사용 가능한 모듈
    │   ├── aws/
    │   │   ├── vpc/
    │   │   ├── ec2/
    │   │   └── s3/
    │   ├── gcp/
    │   │   ├── vpc/
    │   │   ├── gce/
    │   │   └── gcs/
    │   └── azure/
    │       ├── vnet/
    │       ├── vm/
    │       └── storage/
    │
    └── environments/         # 환경별 실제 구성
        ├── dev/
        │   ├── main.tf
        │   ├── variables.tf
        │   └── terraform.tfvars
        ├── staging/
        └── prod/
    

    💡 핵심 포인트: 환경(dev/staging/prod)을 디렉터리로 분리하고, 각 클라우드별 모듈을 따로 관리하면 나중에 유지보수할 때 훨씬 편합니다. 처음엔 귀찮아 보여도, 실제로 운영하다 보면 정말 감사하게 되더라고요.

    실전 구현 1단계 — Provider 및 버전 설정

    자, 이제 실제 코드로 들어가 볼게요. 먼저 versions.tf에서 Terraform 버전과 각 Provider 버전을 고정해줍니다. 버전 고정 안 하면 나중에 Provider 업데이트되면서 갑자기 코드가 안 돌아가는 참사가 생기거든요. 저 이거로 한 번 크게 당했습니다 ㅎㅎ

    # versions.tf
    terraform {
      required_version = ">= 1.5.0"
    
      required_providers {
        aws = {
          source  = "hashicorp/aws"
          version = "~> 5.0"
        }
        google = {
          source  = "hashicorp/google"
          version = "~> 5.0"
        }
        azurerm = {
          source  = "hashicorp/azurerm"
          version = "~> 3.0"
        }
      }
    
      # 원격 State 백엔드 — AWS S3 예시
      backend "s3" {
        bucket         = "my-terraform-state-bucket"
        key            = "multi-cloud/terraform.tfstate"
        region         = "ap-northeast-2"
        dynamodb_table = "terraform-state-lock"
        encrypt        = true
      }
    }
    

    다음은 providers.tf입니다. 각 클라우드 인증 정보를 여기서 설정해요.

    # providers.tf
    
    # AWS Provider
    provider "aws" {
      region = var.aws_region
      # 로컬에선 ~/.aws/credentials 사용
      # CI/CD에선 환경변수 AWS_ACCESS_KEY_ID, AWS_SECRET_ACCESS_KEY 사용
    }
    
    # GCP Provider
    provider "google" {
      project = var.gcp_project_id
      region  = var.gcp_region
      # GOOGLE_APPLICATION_CREDENTIALS 환경변수로 Service Account JSON 경로 지정
    }
    
    # Azure Provider
    provider "azurerm" {
      features {}
      subscription_id = var.azure_subscription_id
      # ARM_CLIENT_ID, ARM_CLIENT_SECRET, ARM_TENANT_ID 환경변수 사용
    }
    

    ⚠️ 경고: 절대로 Access Key나 Secret Key를 코드에 하드코딩하면 안 됩니다! 환경변수나 Vault 같은 시크릿 관리 도구를 꼭 사용하세요. GitHub에 실수로 올렸다가 과금 폭탄 맞은 사례 정말 많거든요.

    실전 구현 2단계 — 각 클라우드 리소스 모듈 만들기

    이제 각 클라우드별로 기본 네트워크 리소스를 만들어볼게요. 실제로 제가 쓰는 패턴입니다.
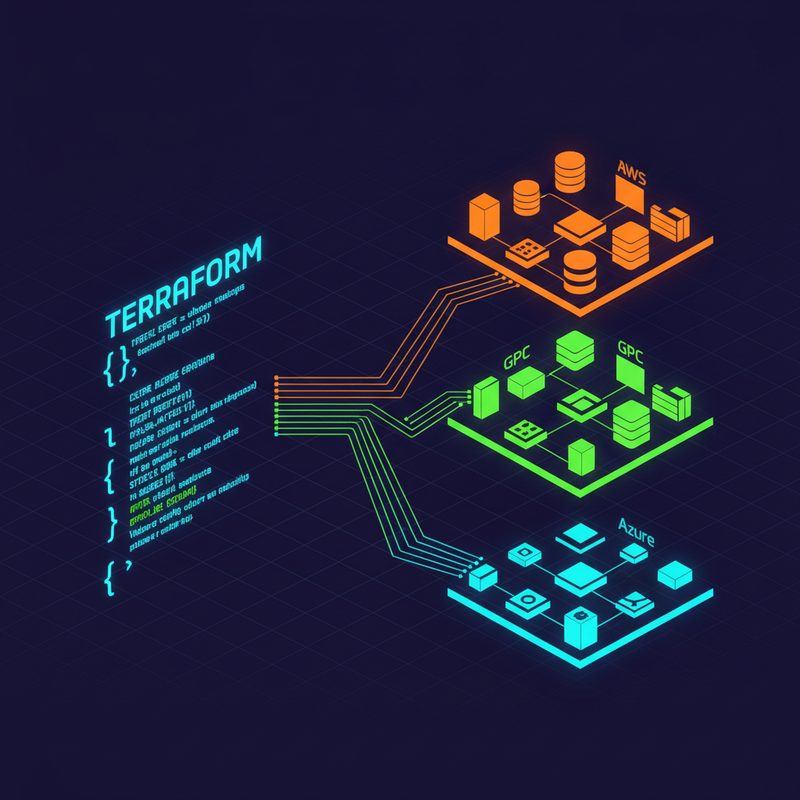
    Split-screen diagram showing Terraform code on the left and resulting cloud resources on AWS, GCP, and Azure on the right, with color-coded resource blocks

    ▲ 하나의 Terraform 코드가 각 클라우드 플랫폼의 실제 리소스로 프로비저닝되는 과정을 보여주는 구성 다이어그램

    AWS VPC 모듈로 가상 네트워크 구성하기

    # modules/aws/vpc/main.tf
    resource "aws_vpc" "main" {
      cidr_block           = var.cidr_block
      enable_dns_hostnames = true
      enable_dns_support   = true
    
      tags = merge(var.common_tags, {
        Name = "${var.env}-vpc"
        Cloud = "AWS"
      })
    }
    
    resource "aws_subnet" "public" {
      count             = length(var.public_subnet_cidrs)
      vpc_id            = aws_vpc.main.id
      cidr_block        = var.public_subnet_cidrs[count.index]
      availability_zone = var.availability_zones[count.index]
    
      tags = merge(var.common_tags, {
        Name = "${var.env}-public-subnet-${count.index + 1}"
      })
    }
    
    resource "aws_internet_gateway" "main" {
      vpc_id = aws_vpc.main.id
    
      tags = var.common_tags
    }
    

    GCP VPC 모듈로 가상 네트워크 구성하기

    # modules/gcp/vpc/main.tf
    resource "google_compute_network" "main" {
      name                    = "${var.env}-vpc"
      auto_create_subnetworks = false
      project                 = var.project_id
    }
    
    resource "google_compute_subnetwork" "main" {
      name          = "${var.env}-subnet"
      ip_cidr_range = var.cidr_block
      region        = var.region
      network       = google_compute_network.main.id
      project       = var.project_id
    
      private_ip_google_access = true
    }
    

    Azure VNet 모듈로 가상 네트워크 구성하기

    # modules/azure/vnet/main.tf
    resource "azurerm_resource_group" "main" {
      name     = "${var.env}-rg"
      location = var.location
    
      tags = var.common_tags
    }
    
    resource "azurerm_virtual_network" "main" {
      name                = "${var.env}-vnet"
      address_space       = [var.cidr_block]
      location            = azurerm_resource_group.main.location
      resource_group_name = azurerm_resource_group.main.name
    
      tags = var.common_tags
    }
    
    resource "azurerm_subnet" "main" {
      name                 = "${var.env}-subnet"
      resource_group_name  = azurerm_resource_group.main.name
      virtual_network_name = azurerm_virtual_network.main.name
      address_prefixes     = [var.subnet_cidr]
    }
    

    환경별 실제 구성 파일로 모듈 조합하기

    # environments/dev/main.tf
    
    # AWS 네트워크
    module "aws_network" {
      source = "../../modules/aws/vpc"
    
      env                  = "dev"
      cidr_block           = "10.0.0.0/16"
      public_subnet_cidrs  = ["10.0.1.0/24", "10.0.2.0/24"]
      availability_zones   = ["ap-northeast-2a", "ap-northeast-2c"]
      common_tags = {
        Environment = "dev"
        ManagedBy   = "Terraform"
      }
    }
    
    # GCP 네트워크
    module "gcp_network" {
      source = "../../modules/gcp/vpc"
    
      env        = "dev"
      project_id = var.gcp_project_id
      region     = "asia-northeast1"
      cidr_block = "10.1.0.0/20"
    }
    
    # Azure 네트워크
    module "azure_network" {
      source = "../../modules/azure/vnet"
    
      env        = "dev"
      location   = "koreacentral"
      cidr_block = "10.2.0.0/16"
      subnet_cidr = "10.2.1.0/24"
      common_tags = {
        Environment = "dev"
        ManagedBy   = "Terraform"
      }
    }
    

    실전 구현 3단계 — 멀티 클라우드 배포 실행하기

    이제 준비가 끝났습니다. 실제로 배포를 해볼게요. 명령어는 어느 클라우드나 동일합니다. 이게 Terraform의 진짜 강점이에요.

    # 1. Terraform 초기화 (Provider 다운로드)
    terraform init
    
    # 2. 실행 계획 확인 (dry-run)
    terraform plan -out=tfplan
    
    # 3. 실제 배포 (AWS, GCP, Azure 동시에 리소스 생성)
    terraform apply tfplan
    
    # 4. 배포된 리소스 확인
    terraform show
    
    # 5. 특정 출력값 확인
    terraform output
    

    명령어 하나로 AWS VPC, GCP VPC, Azure VNet이 동시에 만들어집니다. 정말 신기하더라고요. 각 클라우드 콘솔에 들어가서 확인해보면 실제로 리소스가 생성되어 있을 거예요.

    멀티 클라우드 운영할 때 꼭 알아야 할 팁

    1. State 파일 관리는 신중하게

    Terraform State 파일은 현재 인프라 상태를 기록한 중요한 파일입니다. 절대로 로컬에만 저장하면 안 됩니다. S3, GCS, Azure Blob Storage 같은 원격 백엔드에 저장하고, DynamoDB나 Blob Storage 잠금 기능으로 동시 접근을 방지하세요. 여러 팀이 동시에 배포하면서 State 파일이 꼬이는 참사를 막아야 거든요.

    2. 환경 분리는 필수

    dev, staging, prod를 완전히 분리된 디렉터리로 관리하세요. 실수로 prod 환경을 destroy하는 일을 막기 위해 terraform destroy는 스크립트로 자동화하지 말고 수동으로만 실행하는 게 좋습니다.

    3. 변수 파일은 .gitignore에 추가

    terraform.tfvars 파일에는 민감한 정보(API 키, 구독 ID 등)가 들어갑니다. 절대로 Git에 커밋하면 안 됩니다. .gitignore에 추가하고, CI/CD 파이프라인에서 환경변수로 주입하세요.

    4. 비용 모니터링을 자동화하세요

    멀티 클라우드는 각 클라우드의 비용이 따로 집계되기 때문에 전체 비용을 파악하기 어렵습니다. Terraform Cloud나 Infracost 같은 도구로 배포 전에 비용을 예측하는 게 좋습니다.

    자주 하는 실수와 해결 방법

    Q: 특정 클라우드 리소스만 삭제하고 싶은데 어떻게 하나요?

    A: terraform destroy -target=module.aws_network 명령으로 특정 모듈만 삭제할 수 있습니다. 다만 이 방법은 State 파일 불일치를 초래할 수 있으니 주의하세요.

    Q: Provider 버전을 업그레이드하면 기존 리소스가 삭제되나요?

    A: 보통은 아닙니다. 다만 terraform plan으로 변경사항을 꼭 확인한 후 업그레이드하세요. 간혹 주요 버전 업그레이드 시 리소스 구조가 바뀔 수 있거든요.

    Q: 기존 클라우드 리소스를 Terraform으로 관리하려면?

    A: terraform import 명령을 사용합니다. 예: terraform import aws_vpc.main vpc-12345678. 기존 리소스를 State 파일에 등록한 후 코드를 작성하면 됩니다.

    마치며: Terraform 멀티 클라우드의 미래

    저는 지난 3년간 Terraform으로 AWS, GCP, Azure를 관리해오면서 정말 많은 이점을 느꼈습니다. 각 클라우드의 콘솔을 오갈 필요 없이 코드 한 곳에서 모든 걸 관리할 수 있다는 게 최고의 장점이에요. 팀 규모가 커져도 일관된 방식으로 인프라를 관리할 수 있고, 재해 복구나 환경 복제도 정말 쉬워집니다.

    처음에는 디렉터리 구조를 잡는 데 시간이 걸릴 수 있지만, 한 번 제대로 설계해놓으면 정말 오랫동안 써먹을 수 있는 자산이 됩니다. 여러분도 이 글을 참고해서 Terraform 멀티 클라우드 환경을 구축해보세요. 분명 개발과 운영이 훨씬 편해질 거예요!
  • [k8s] 쿠버네티스 Ingress Controller 비교: Nginx, Traefik, HAProxy 선택 가이드

    [k8s] 쿠버네티스 Ingress Controller 비교: Nginx, Traefik, HAProxy 선택 가이드

    쿠버네티스 Ingress Controller, 뭘 써야 할까요?

    쿠버네티스를 처음 공부할 때 저도 Ingress Controller 선택 앞에서 한참 멈췄던 기억이 나요. Nginx는 익숙하고, Traefik은 이름이 예쁘고, HAProxy는 오래됐으니 안정적일 것 같고… 근데 막상 뭘 골라야 할지 기준이 없으니까 그냥 남들 쓰는 거 따라갔었거든요.

    13년 동안 인프라 엔지니어로 일하면서 홈랩부터 실제 프로덕션 환경까지 세 가지 컨트롤러를 다 써봤습니다. 오늘은 그 경험을 바탕으로 Nginx Ingress, Traefik Ingress, HAProxy Ingress를 솔직하게 비교해 드릴게요. 어떤 상황에서 어떤 걸 골라야 하는지, 실제 겪었던 삽질 포인트까지 전부 공유해 드리겠습니다.

    팀에서 쿠버네티스 Ingress Controller를 선택해야 하는데 레퍼런스가 너무 많고 각자 장점만 얘기해서 오히려 더 헷갈리는 상황, 있으시죠? 이 글이 그 혼란을 정리해 드릴 거예요.

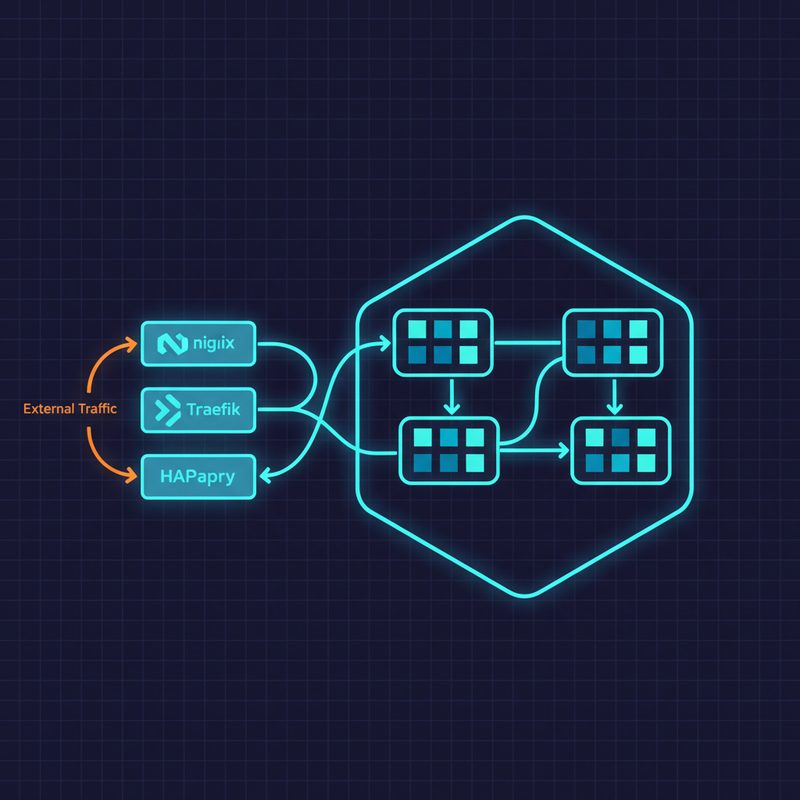
    쿠버네티스 Ingress Controller 전체 아키텍처 - Nginx, Traefik, HAProxy 트래픽 흐름 비교

    쿠버네티스 클러스터에서 외부 트래픽이 Ingress Controller를 통해 각 서비스로 라우팅되는 전체 흐름. Nginx, Traefik, HAProxy 세 가지 컨트롤러의 위치를 비교하여 보여줍니다.

    Ingress Controller가 뭔지 먼저 짚고 가요

    쉽게 말해서, Ingress(인그레스)는 클러스터 외부에서 내부 서비스로 들어오는 트래픽을 관리하는 쿠버네티스 오브젝트예요. 근데 Ingress 오브젝트 자체는 그냥 규칙 명세서일 뿐이고, 이걸 실제로 실행하는 게 바로 Ingress Controller(인그레스 컨트롤러)입니다.

    비유하자면 Ingress는 “3번 테이블 손님은 A 주방으로, 4번 테이블은 B 주방으로” 같은 안내판이고, Ingress Controller는 그 안내판을 읽고 실제로 손님을 안내하는 직원인 거죠. 이 직원 역할을 Nginx가 할 수도 있고, Traefik이나 HAProxy가 할 수도 있는 겁니다.

    • Ingress Resource: 라우팅 규칙을 정의하는 쿠버네티스 오브젝트
    • Ingress Controller: Ingress 규칙을 실제로 처리하는 프록시/로드밸런서 파드
    • 쿠버네티스는 기본으로 Ingress Controller를 제공하지 않아서 직접 설치해야 해요

    세 가지 Ingress Controller 핵심 특징 비교

    본격 비교 전에 각 컨트롤러의 DNA를 먼저 이해하면 선택이 훨씬 쉬워져요.

    Nginx Ingress Controller

    가장 널리 쓰이는 컨트롤러입니다. 사실 Nginx Ingress Controller에는 두 가지 버전이 있어요. 쿠버네티스 커뮤니티가 관리하는 ingress-nginx와 Nginx 사가 직접 관리하는 nginx-ingress. 보통 오픈소스 쪽에서 말하는 건 ingress-nginx 쪽이에요. 처음에 저도 이게 헷갈려서 잘못된 걸 설치했던 기억이 있습니다.

    • 레퍼런스가 가장 많고 커뮤니티가 활발해요
    • Nginx.conf 기반이라 기존 Nginx 경험자에게 친숙함
    • Annotation(어노테이션) 기반 세밀한 설정 가능
    • 설정 변경 시 nginx reload가 필요한 구조 (무중단 배포 시 주의)

    Traefik Ingress Controller

    클라우드 네이티브 시대에 맞게 설계된 현대적인 리버스 프록시예요. 처음 Traefik을 접했을 때 “이게 진짜 쿠버네티스랑 찰떡이구나” 싶었거든요. 서비스 디스커버리(Service Discovery)를 자동으로 처리해서 설정 파일을 거의 안 만져도 되는 게 매력이에요.

    • 자동 서비스 디스커버리로 설정 최소화
    • 내장 대시보드(Dashboard)로 트래픽 시각화 가능
    • Let’s Encrypt TLS 인증서 자동 발급/갱신 지원
    • 미들웨어(Middleware) 체인으로 요청 처리 파이프라인 구성
    • CRD(Custom Resource Definition) 기반 설정으로 쿠버네티스 네이티브한 느낌

    HAProxy Ingress Controller

    HAProxy는 원래 고성능 로드밸런서로 유명하죠. 금융권이나 대용량 트래픽 환경에서 오랫동안 검증된 친구입니다. 쿠버네티스 Ingress Controller로서의 HAProxy는 이 안정성과 성능을 그대로 가져왔어요.

    • 로드밸런싱 알고리즘 선택지가 풍부함
    • TCP/UDP 레이어 처리에 강점
    • 설정 변경 시 무중단 리로드(hitless reload) 지원
    • Nginx, Traefik 대비 국내 레퍼런스가 적은 편

    Ingress Controller 핵심 비교표

    항목 Nginx Ingress Traefik Ingress HAProxy Ingress
    설정 방식 Annotation + ConfigMap CRD + Annotation ConfigMap + Annotation
    자동 서비스 디스커버리 제한적 ✅ 강력 지원 제한적
    TLS 자동화 cert-manager 연동 필요 ✅ 내장 지원 cert-manager 연동 필요
    내장 모니터링 UI ❌ 없음 ✅ 대시보드 내장 HAProxy Stats 페이지
    무중단 설정 리로드 부분 지원 ✅ 지원 ✅ 지원
    학습 난이도 낮음 (친숙함) 중간 중간~높음
    커뮤니티/레퍼런스 매우 풍부 풍부 보통
    적합한 환경 범용, 소~대규모 클라우드 네이티브, 동적 환경 고성능, 금융/엔터프라이즈

    실전 설치 및 기본 설정 방법

    자, 이제 실제로 설치해 봅시다. 각 컨트롤러별로 가장 빠른 설치 방법을 보여드릴게요. 제가 홈랩에서 테스트할 때 쓰는 방식이에요.

    Helm을 이용한 Nginx, Traefik, HAProxy Ingress Controller 설치 및 배포 구성

    Helm을 이용한 Nginx, Traefik, HAProxy Ingress Controller 설치 과정과 각 컨트롤러의 파드 구성을 보여주는 다이어그램.

    1. Nginx Ingress Controller 설치

    Helm을 이용하는 게 제일 편합니다. ingress-nginx 공식 차트를 사용해요.

    # Helm 레포지토리 추가
    helm repo add ingress-nginx https://kubernetes.github.io/ingress-nginx
    helm repo update
    
    # 설치
    helm install ingress-nginx ingress-nginx/ingress-nginx \
      --namespace ingress-nginx \
      --create-namespace

    설치 후 기본 Ingress 리소스 예시입니다.

    apiVersion: networking.k8s.io/v1
    kind: Ingress
    metadata:
      name: my-app-ingress
      annotations:
        kubernetes.io/ingress.class: "nginx"
        nginx.ingress.kubernetes.io/rewrite-target: /
    spec:
      rules:
      - host: myapp.example.com
        http:
          paths:
          - path: /
            pathType: Prefix
            backend:
              service:
                name: my-app-service
                port:
                  number: 80

    2. Traefik Ingress Controller 설치

    Traefik도 Helm으로 설치하는 게 가장 깔끔해요. 대시보드 활성화 옵션도 같이 넣어줄게요.

    # Helm 레포지토리 추가
    helm repo add traefik https://helm.traefik.io/traefik
    helm repo update
    
    # values 파일 생성 (대시보드 활성화)
    cat < traefik-values.yaml
    dashboard:
      enabled: true
    api:
      dashboard: true
    EOF
    
    # 설치
    helm install traefik traefik/traefik \
      --namespace traefik \
      --create-namespace \
      -f traefik-values.yaml

    Traefik에서는 IngressRoute라는 CRD를 사용하는 방식이 더 권장돼요.

    apiVersion: traefik.containo.us/v1alpha1
    kind: IngressRoute
    metadata:
      name: my-app-route
      namespace: default
    spec:
      entryPoints:
        - web
      routes:
        - match: Host(`myapp.example.com`)
          kind: Rule
          services:
            - name: my-app-service
              port: 80

    3. HAProxy Ingress Controller 설치

    # Helm 레포지토리 추가
    helm repo add haproxytech https://haproxytech.github.io/helm-charts
    helm repo update
    
    # 설치
    helm install haproxy-ingress haproxytech/kubernetes-ingress \
      --namespace haproxy-controller \
      --create-namespace
    apiVersion: networking.k8s.io/v1
    kind: Ingress
    metadata:
      name: my-app-ingress
      annotations:
        kubernetes.io/ingress.class: "haproxy"
    spec:
      rules:
      - host: myapp.example.com
        http:
          paths:
          - path: /
            pathType: Prefix
            backend:
              service:
                name: my-app-service
                port:
                  number: 80

    ⚠️ 실제로 겪었던 주의사항과 트러블슈팅

    이론은 여기까지 하고, 제가 실제로 삽질했던 포인트들 정리해 드릴게요. 이게 진짜 중요한 부분이에요.

    Nginx Ingress에서 자주 만나는 문제들

    ⚠️ 문제 1: Annotation 오타로 설정이 안 먹히는 경우

    Nginx Ingress는 Annotation에 오타가 있어도 에러를 안 뿜고 그냥 무시해버려요. 처음에 이걸 몰라서 한참 헤맸습니다. 설정이 안 먹힌다 싶으면 아래 명령어로 컨트롤러 로그를 꼭 확인하세요.

    kubectl logs -n ingress-nginx \
      $(kubectl get pods -n ingress-nginx -l app.kubernetes.io/name=ingress-nginx -o jsonpath='{.items[0].metadata.name}')

    ⚠️ 문제 2: 413 Request Entity Too Large 에러

    파일 업로드 기능이 있는 서비스를 Nginx Ingress 뒤에 놓으면 자주 만나는 에러예요. Annotation으로 해결 가능합니다.

    annotations:
      nginx.ingress.kubernetes.io/proxy-body-size: "50m"

    Traefik에서 자주 만나는 문제들

    ⚠️ 문제 1: IngressRoute와 기본 Ingress 혼용 시 충돌

    Traefik은 기본 쿠버네티스 Ingress 오브젝트도 처리하고 자체 IngressRoute CRD도 처리해요. 근데 팀 내에서 두 가지 방식을 섞어 쓰면 나중에 관리가 진짜 복잡해집니다. 처음부터 방식을 통일하는 걸 강력 추천해요.

    ⚠️ 문제 2: 대시보드 외부 노출 시 인증 필수

    Traefik 대시보드를 아무 인증 없이 외부에 노출하면 큰일 납니다. BasicAuth 미들웨어라도 꼭 붙여주세요.

    apiVersion: traefik.containo.us/v1alpha1
    kind: Middleware
    metadata:
      name: dashboard-auth
      namespace: traefik
    spec:
      basicAuth:
        secret: traefik-dashboard-auth-secret

    HAProxy Ingress에서 자주 만나는 문제들

    ⚠️ 문제 1: ConfigMap 설정 반영 지연

    HAProxy Ingress는 ConfigMap을 통한 글로벌 설정 변경이 즉시 반영되지 않는 경우가 있어요. 설정 변경 후 컨트롤러 파드를 재시작해줘야 하는 상황이 생길 수 있습니다.

    kubectl rollout restart deployment haproxy-ingress -n haproxy-controller

    어떤 상황에서 뭘 골라야 할까요?

    제가 내린 결론을 솔직하게 말씀드릴게요. 완벽한 정답은 없지만, 상황별 추천은 꽤 명확해요.

    Nginx Traefik HAProxy Ingress Controller 성능 및 기능 비교 대시보드

    Nginx, Traefik, HAProxy Ingress Controller의 주요 지표(성능, 설정 편의성, 생태계, 모니터링)를 레이더 차트로 비교한 시각화.

    ✅ Nginx Ingress를 선택하세요, 만약…

    • 팀원들이 Nginx에 익숙한 경우
    • 레퍼런스와 커뮤니티 지원이 중요한 경우
    • 처음 쿠버네티스를 도입하는 팀
    • 범용적인 웹 트래픽 처리가 주 목적인 경우

    ✅ Traefik Ingress를 선택하세요, 만약…

    • 마이크로서비스가 자주 추가/삭제되는 동적인 환경
    • TLS 인증서 관리를 자동화하고 싶은 경우
    • 별도 모니터링 설정 없이 트래픽을 시각화하고 싶은 경우
    • 클라우드 네이티브 환경에서 GitOps 방식으로 운영하는 경우

    ✅ HAProxy Ingress를 선택하세요, 만약…

    • 기존에 HAProxy를 잘 알고 있는 팀
    • L4(TCP/UDP) 레벨의 세밀한 로드밸런싱이 필요한 경우
    • 금융, 통신 등 고성능/고가용성이 핵심인 환경
    • 엄격한 엔터프라이즈 지원이 필요한 경우

    자주 묻는 질문 (FAQ)

    Q. 클러스터에 Ingress Controller를 여러 개 동시에 설치할 수 있나요?

    네, 가능합니다. IngressClass 리소스를 이용해서 각 Ingress 오브젝트가 어떤 컨트롤러를 사용할지 지정할 수 있어요. 다만 운영 복잡도가 올라가니까 특별한 이유가 없다면 하나만 쓰는 걸 추천합니다.

    Q. 쿠버네티스 Ingress Controller와 서비스 메시는 다른 건가요?

    다릅니다. Ingress Controller는 클러스터 외부에서 내부로 들어오는 북-남(North-South) 트래픽을 처리하고, Istio 같은 서비스 메시는 클러스터 내부 서비스 간의 동-서(East-West) 트래픽을 관리해요. 보통 두 가지를 같이 쓰기도 합니다.

    Q. Traefik v2와 v3는 많이 다른가요?

    Traefik v3에서 일부 API와 설정 방식이 변경됐어요. 특히 일부 CRD API 버전이 바뀌었으니 마이그레이션 시 공식 문서를 꼭 확인하세요. 신규 설치라면 최신 버전을 쓰는 게 좋습니다.

    마무리 — 결국 팀의 상황이 답이에요

    쿠버네티스 Ingress Controller 선택 가이드 - Nginx Traefik HAProxy 상황별 추천 요약

    Nginx, Traefik, HAProxy Ingress Controller의 특징과 적합한 사용 환경을 한눈에 정리한 요약 인포그래픽.

    오늘 세 가지 쿠버네티스 Ingress Controller를 비교해 봤는데요. 제 개인적인 결론을 한 줄로 정리하면 이래요.

    “처음이라면 Nginx, 클라우드 네이티브 환경이라면 Traefik, 고성능/엔터프라이즈라면 HAProxy.”

    저는 홈랩에서는 Traefik을 주로 써요. 대시보드가 있어서 트래픽 흐름 보기 편하고, TLS 자동화가 정말 편리하거든요. 근데 실무에서 처음 쿠버네티스를 도입하는 팀이라면 역시 Nginx가 제일 무난합니다. 레퍼런스가 많아서 문제 생겼을 때 해결하기 수월하니까요.

    💡 팁 하나 더! 어떤 Ingress Controller를 선택하든 cert-manager와 함께 쓰면 TLS 인증서 관리가 훨씬 수월해집니다. cert-manager 설정 방법은 다음 글에서 자세히 다룰 예정이에요.

    궁금한 점이나 다른 삽질 경험이 있으시면 댓글로 공유해 주세요. 같이 고민해 봅시다! 🎉

  • [k8s] ArgoCD 멀티 클러스터 GitOps 배포 및 관리 전략

    [k8s] ArgoCD 멀티 클러스터 GitOps 배포 및 관리 전략

    클러스터가 하나일 때는 괜찮았는데…

    처음 쿠버네티스를 도입했을 때 저도 클러스터 하나로 시작했어요. 개발(dev), 스테이징(staging), 프로덕션(production) 환경을 네임스페이스(Namespace)로 분리해서 쓰는 방식이었는데, 솔직히 그때는 그게 맞다고 생각했거든요. 근데 조직이 커지고 팀이 늘어나면서 문제가 하나씩 터지기 시작했습니다.

    “개발팀이 실수로 프로덕션 네임스페이스에 배포했어요.” 이 한 마디에 심장이 철렁 내려앉은 적 있으신가요? 저는 있습니다 ㅎㅎ. 결국 클러스터를 분리하기로 결정했고, 그때부터 ArgoCD 멀티 클러스터 전략을 본격적으로 파고들었습니다.

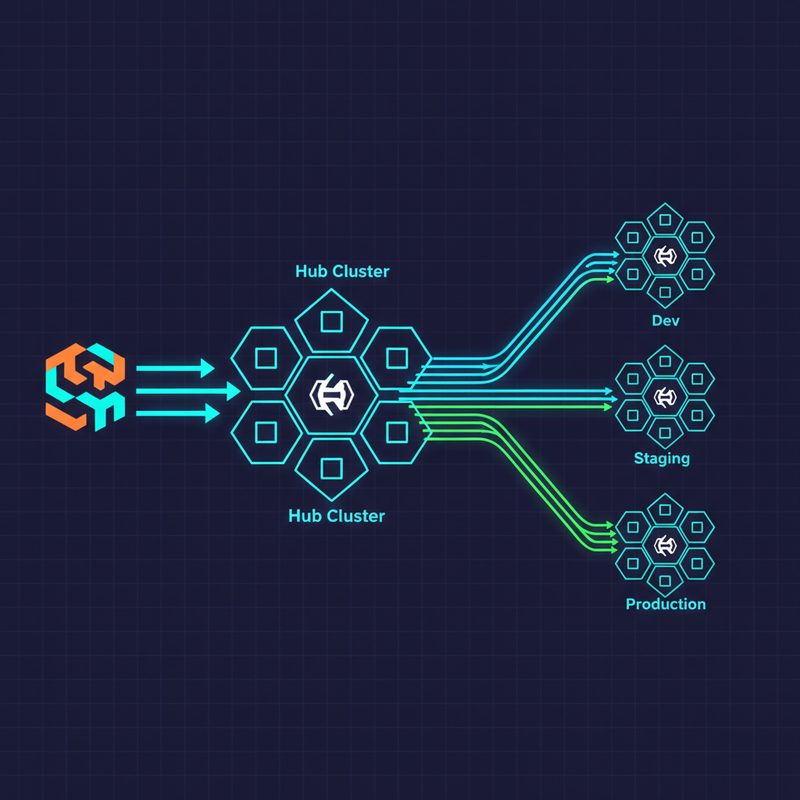
    이 글에서는 ArgoCD를 허브(Hub) 클러스터에 설치하고, 여러 개의 쿠버네티스 클러스터를 GitOps 방식으로 배포 및 관리하는 전략을 단계별로 정리해 드리겠습니다. 저처럼 삽질하지 않도록요.

    ArgoCD 멀티 클러스터 Hub-and-Spoke 아키텍처 다이어그램 - 허브 클러스터에서 dev, staging, prod 클러스터로 GitOps 배포 흐름

    ▲ ArgoCD 허브 클러스터가 여러 대상 클러스터(dev, staging, prod)를 관리하는 전체 아키텍처 구조. Hub-and-Spoke 패턴의 핵심입니다.

    ArgoCD 멀티 클러스터란? 개념부터 잡고 가요

    GitOps가 뭔지 먼저 짚고 가면

    GitOps는 쉽게 말해 “Git 저장소가 인프라와 애플리케이션의 단일 진실 공급원(Single Source of Truth)이 되는 운영 방식”이에요. 배포하고 싶으면 kubectl로 직접 명령을 날리는 게 아니라, Git에 커밋하면 자동으로 클러스터에 반영되는 방식이죠.

    ArgoCD는 이 GitOps를 쿠버네티스 위에서 구현해주는 대표적인 오픈소스 도구입니다. Git 저장소를 지속적으로 감시하다가 변경이 감지되면 클러스터에 자동으로 동기화(Sync)해줘요.

    멀티 클러스터 관리, 왜 필요한가요?

    네임스페이스 분리 방식의 가장 큰 문제는 폭발 반경(Blast Radius)이 너무 넓다는 거예요. 클러스터 레벨의 장애가 모든 환경에 영향을 주고, 보안 격리도 완벽하지 않습니다. 반면 클러스터를 분리하면:

    • 환경 간 완전한 격리 — 개발 배포 실수가 프로덕션에 영향 없음
    • 클러스터별 독립적인 리소스 할당 및 스케일링
    • 규정 준수(Compliance) 요구사항 충족 용이
    • 팀별 독립적인 업그레이드 주기 관리

    그런데 클러스터가 여러 개가 되면 관리 포인트도 여러 개가 되잖아요. 각 클러스터에 ArgoCD를 따로 설치하는 방법도 있지만, 저는 Hub-and-Spoke 패턴을 선호합니다. 허브 클러스터 하나에 ArgoCD를 설치하고, 나머지 클러스터들을 원격으로 관리하는 방식이에요.

    방식 장점 단점 추천 상황
    클러스터별 ArgoCD 설치 독립성 높음, 장애 격리 관리 포인트 분산, 일관성 유지 어려움 팀/조직이 완전히 분리된 경우
    Hub-and-Spoke (중앙화) 단일 관리 포인트, 일관된 정책 적용 허브 클러스터 장애 시 배포 불가 중앙 플랫폼팀이 관리하는 경우

    ArgoCD 설치 및 멀티 클러스터 등록 — 실전으로 들어갑니다

    1단계: 허브 클러스터에 ArgoCD 설치

    저는 허브 클러스터로 별도의 관리 전용 클러스터를 사용합니다. 프로덕션 워크로드가 없는 클러스터에 ArgoCD를 올리는 게 안전하더라고요.

    # ArgoCD 네임스페이스 생성
    kubectl create namespace argocd
    
    # ArgoCD 공식 매니페스트로 설치
    kubectl apply -n argocd -f https://raw.githubusercontent.com/argoproj/argo-cd/stable/manifests/install.yaml
    
    # 설치 확인
    kubectl get pods -n argocd
    

    설치가 완료되면 argocd-server 파드가 Running 상태가 되는데, 처음엔 이미지 풀(Image Pull) 때문에 좀 기다려야 할 수도 있어요. 저도 처음에 “왜 안 되지?” 하고 5분 기다렸더니 그냥 올라왔습니다 ㅎㅎ.

    # 초기 admin 비밀번호 확인
    kubectl -n argocd get secret argocd-initial-admin-secret \
      -o jsonpath="{.data.password}" | base64 -d
    
    # ArgoCD CLI 설치 (macOS 기준)
    brew install argocd
    
    # ArgoCD 서버 포트포워딩 (로컬 접근용)
    kubectl port-forward svc/argocd-server -n argocd 8080:443
    
    # CLI 로그인
    argocd login localhost:8080 --username admin --password <위에서_확인한_비밀번호> --insecure
    

    2단계: 대상 클러스터(Spoke) 등록

    이 부분이 멀티 클러스터 설정의 핵심이에요. ArgoCD CLI로 대상 클러스터를 등록하면, ArgoCD가 해당 클러스터에 argocd-manager라는 서비스 어카운트(Service Account)를 만들고 필요한 RBAC 권한을 자동으로 설정해줍니다.

    # 현재 kubeconfig에 등록된 컨텍스트 확인
    kubectl config get-contexts
    
    # 예시 출력:
    # CURRENT   NAME            CLUSTER         AUTHINFO
    # *         hub-cluster     hub-cluster     hub-admin
    #           dev-cluster     dev-cluster     dev-admin
    #           staging-cluster staging-cluster staging-admin
    #           prod-cluster    prod-cluster    prod-admin
    
    # 개발 클러스터 등록
    argocd cluster add dev-cluster --name dev
    
    # 스테이징 클러스터 등록
    argocd cluster add staging-cluster --name staging
    
    # 프로덕션 클러스터 등록
    argocd cluster add prod-cluster --name prod
    
    # 등록된 클러스터 목록 확인
    argocd cluster list
    

    💡 팁: 클러스터 등록 시 --name 옵션으로 별칭을 지정하면 나중에 Application 설정에서 훨씬 읽기 편합니다. URL 대신 이름으로 참조할 수 있거든요.

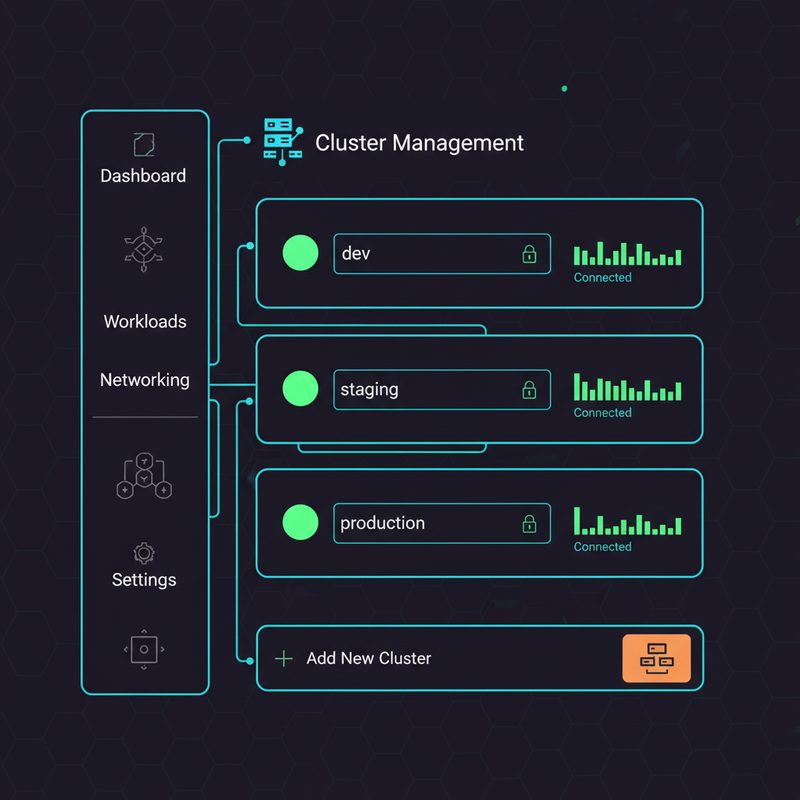
    ArgoCD Settings Clusters 화면에서 dev, staging, prod 멀티 클러스터가 등록된 관리 UI 화면

    ▲ ArgoCD 웹 UI의 Settings > Clusters 화면. dev, staging, prod 클러스터가 각각 등록되어 연결 상태를 실시간으로 확인할 수 있습니다.

    Git 저장소 구조 설계 — 이게 진짜 중요합니다

    멀티 클러스터 GitOps에서 Git 저장소 구조를 어떻게 잡느냐가 나중에 관리 편의성을 크게 좌우해요. 제가 여러 방식을 시도해보고 정착한 구조를 공유합니다.

    모노레포(Monorepo) 방식 — 제가 선호하는 방식

    gitops-repo/
    ├── apps/                          # 애플리케이션 정의
    │   ├── base/                      # 공통 기본 설정 (Kustomize base)
    │   │   ├── my-app/
    │   │   │   ├── deployment.yaml
    │   │   │   ├── service.yaml
    │   │   │   └── kustomization.yaml
    │   └── overlays/                  # 환경별 오버레이
    │       ├── dev/
    │       │   └── my-app/
    │       │       ├── kustomization.yaml
    │       │       └── patch-replicas.yaml
    │       ├── staging/
    │       │   └── my-app/
    │       └── prod/
    │           └── my-app/
    ├── argocd/                        # ArgoCD 설정 자체도 Git으로 관리
    │   ├── projects/                  # ArgoCD Project 정의
    │   │   ├── dev-project.yaml
    │   │   ├── staging-project.yaml
    │   │   └── prod-project.yaml
    │   └── applications/              # ArgoCD Application 정의
    │       ├── dev/
    │       ├── staging/
    │       └── prod/
    └── clusters/                      # 클러스터 레벨 설정
        ├── dev/
        ├── staging/
        └── prod/
    

    이 구조의 핵심은 Kustomize(커스터마이즈)를 활용해서 base 설정을 공유하면서 환경별로 다른 값(레플리카 수, 리소스 제한, 이미지 태그 등)만 오버레이로 덮어쓰는 방식이에요.

    Kustomize 오버레이 예시

    # apps/base/my-app/deployment.yaml
    apiVersion: apps/v1
    kind: Deployment
    metadata:
      name: my-app
    spec:
      replicas: 1
      selector:
        matchLabels:
          app: my-app
      template:
        metadata:
          labels:
            app: my-app
        spec:
          containers:
          - name: my-app
            image: my-registry/my-app:latest
            resources:
              requests:
                cpu: 100m
                memory: 128Mi
    
    # apps/overlays/prod/my-app/kustomization.yaml
    apiVersion: kustomize.config.k8s.io/v1beta1
    kind: Kustomization
    resources:
      - ../../../base/my-app
    patches:
      - path: patch-replicas.yaml
    images:
      - name: my-registry/my-app
        newTag: v1.2.3  # 프로덕션은 명시적 태그 사용
    
    # apps/overlays/prod/my-app/patch-replicas.yaml
    apiVersion: apps/v1
    kind: Deployment
    metadata:
      name: my-app
    spec:
      replicas: 3  # 프로덕션은 3개로
    

    ArgoCD Application 및 AppProject 설정

    AppProject(앱 프로젝트)로 클러스터 접근 제어

    ArgoCD의 AppProject는 애플리케이션들을 논리적으로 그룹화하고, 어떤 Git 저장소에서 어떤 클러스터로 배포할 수 있는지 제한하는 역할을 합니다. 저는 이걸 환경별로 나눠서 씁니다.

    # argocd/projects/prod-project.yaml
    apiVersion: argoproj.io/v1alpha1
    kind: AppProject
    metadata:
      name: production
      namespace: argocd
    spec:
      description: Production environment project
      # 허용된 소스 저장소
      sourceRepos:
        - 'https://github.com/myorg/gitops-repo.git'
      # 배포 가능한 대상 클러스터와 네임스페이스
      destinations:
        - server: https://prod-cluster-api.example.com
          namespace: '*'
      # 클러스터 범위 리소스 생성 제한 (선택적)
      clusterResourceWhitelist:
        - group: ''
          kind: Namespace
      # RBAC 역할 정의
      roles:
        - name: prod-deployer
          description: Production deployment role
          policies:
            - p, proj:production:prod-deployer, applications, sync, production/*, allow
          groups:
            - myorg:platform-team
    

    Application 정의 — 멀티 클러스터 배포의 핵심

    # argocd/applications/prod/my-app.yaml
    apiVersion: argoproj.io/v1alpha1
    kind: Application
    metadata:
      name: my-app-prod
      namespace: argocd
      # 앱 삭제 시 리소스도 함께 삭제되지 않도록 (중요!)
      finalizers:
        - resources-finalizer.argocd.argoproj.io
    spec:
      project: production
      source:
        repoURL: https://github.com/myorg/gitops-repo.git
        targetRevision: main
        path: apps/overlays/prod/my-app  # 프로덕션 오버레이 경로
      destination:
        # 등록한 클러스터 이름 또는 API 서버 URL
        server: https://prod-cluster-api.example.com
        namespace: my-app
      syncPolicy:
        automated:
          prune: true       # Git에서 삭제된 리소스는 클러스터에서도 삭제
          selfHeal: true    # 클러스터 상태가 Git과 다르면 자동 복구
        syncOptions:
          - CreateNamespace=true  # 네임스페이스 없으면 자동 생성
          - PrunePropagationPolicy=foreground
        retry:
          limit: 5
          backoff:
            duration: 5s
            factor: 2
            maxDuration: 3m
    

    ApplicationSet으로 여러 클러스터에 한 번에 배포

    근데 여기서 더 편한 방법이 있어요. ApplicationSet(애플리케이션셋)을 쓰면 여러 클러스터에 대한 Application을 템플릿 하나로 자동 생성할 수 있거든요. 처음 이걸 알았을 때 “이게 왜 이렇게 편하지?” 싶었습니다.

    # argocd/applicationsets/my-app-all-clusters.yaml
    apiVersion: argoproj.io/v1alpha1
    kind: ApplicationSet
    metadata:
      name: my-app-all-clusters
      namespace: argocd
    spec:
      generators:
        - list:
            elements:
              - cluster: dev
                url: https://dev-cluster-api.example.com
                env: dev
                revision: HEAD
              - cluster: staging
                url: https://staging-cluster-api.example.com
                env: staging
                revision: main
              - cluster: prod
                url: https://prod-cluster-api.example.com
                env: prod
                revision: main
      template:
        metadata:
          name: 'my-app-{{env}}'
        spec:
          project: '{{env}}'
          source:
            repoURL: https://github.com/myorg/gitops-repo.git
            targetRevision: '{{revision}}'
            path: 'apps/overlays/{{env}}/my-app'
          destination:
            server: '{{url}}'
            namespace: my-app
          syncPolicy:
            automated:
              prune: true
              selfHeal: true
            syncOptions:
              - CreateNamespace=true
    

    💡 팁: ApplicationSet의 generators에는 List 방식 외에도 클러스터 레이블 기반으로 자동 감지하는 Cluster Generator도 있어요. 클러스터가 많아질수록 이쪽이 훨씬 강력합니다.

    ⚠️ 실제로 겪은 트러블슈팅 — 이거 꼭 읽으세요

    문제 1: 클러스터 등록 후 연결 끊김 (Connection Refused)

    클러스터를 등록했는데 ArgoCD UI에서 계속 “Unknown” 상태가 뜨는 경우가 있었어요. 원인을 파고들어보니 허브 클러스터에서 대상 클러스터의 API 서버로 직접 네트워크 연결이 안 되는 거였습니다. VPC 피어링이나 방화벽 규칙을 확인해야 해요.

    # 허브 클러스터에서 대상 클러스터 API 서버 연결 테스트
    kubectl run curl-test --image=curlimages/curl --rm -it --restart=Never -- \
      curl -k https://prod-cluster-api.example.com/healthz
    

    문제 2: prune 옵션으로 인한 의도치 않은 리소스 삭제

    이건 진짜 아찔했던 경험인데요. automated.prune: true를 켜놨는데, 실수로 Git에서 파일을 지웠다가 프로덕션 Deployment가 통째로 삭제된 적이 있었어요. 다행히 빠르게 복구했지만…

    이후로 저는 프로덕션 환경에는 Sync Windows(동기화 창)를 설정해서 업무 시간 외에는 자동 동기화가 안 되도록 했습니다.

    # AppProject에 Sync Window 추가
    spec:
      syncWindows:
        - kind: allow
          schedule: '0 9 * * 1-5'  # 평일 오전 9시에만
          duration: 8h
          applications:
            - '*'
          manualSync: true  # 수동 동기화는 항상 허용
    

    문제 3: Helm 차트 버전 충돌

    여러 클러스터에 같은 Helm 차트를 다른 버전으로 배포하다 보면 values 파일 구조가 버전마다 달라서 오류가 나는 경우가 있어요. 저는 이걸 해결하기 위해 클러스터별 values 파일을 명확하게 분리해서 관리하고 있습니다.

    # Helm 소스 예시 - 클러스터별 values 파일 분리
    source:
      repoURL: https://charts.example.com
      chart: my-chart
      targetRevision: 1.2.3
      helm:
        valueFiles:
          - values.yaml
          - values-prod.yaml  # 환경별 values 파일
    
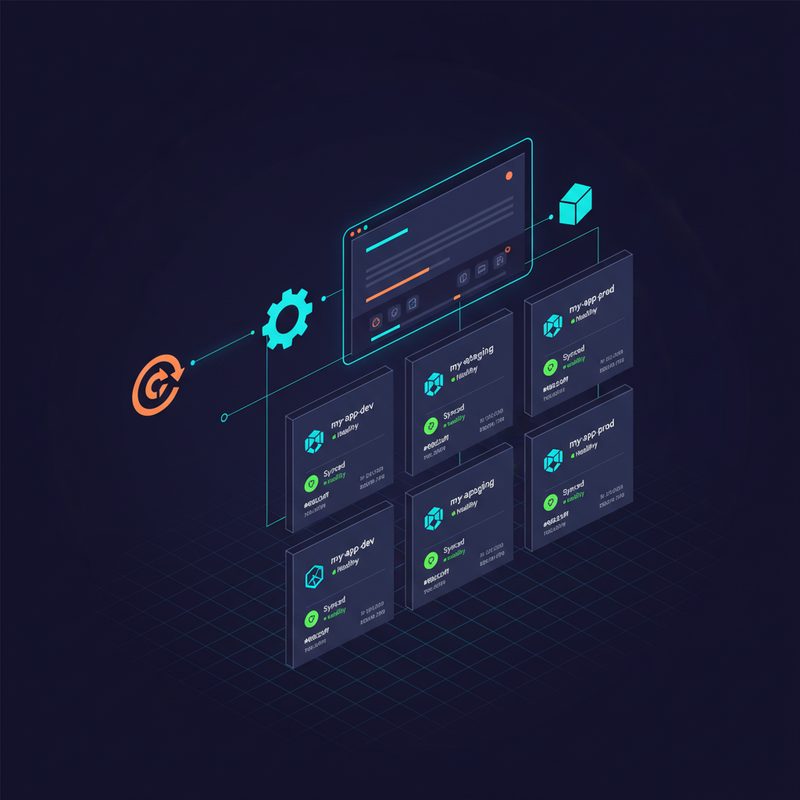
    ArgoCD Applications 대시보드에서 멀티 클러스터 배포된 애플리케이션들이 모두 Synced Healthy 상태로 표시된 결과 화면

    ▲ ArgoCD 웹 UI의 Applications 화면. dev, staging, prod 클러스터에 배포된 my-app들이 모두 Synced/Healthy 상태로 표시되는 모습입니다.

    ✅ 배포 검증 및 운영 팁

    헬스 체크와 동기화 상태 모니터링

    # 전체 Application 상태 확인
    argocd app list
    
    # 특정 앱 상세 상태 확인
    argocd app get my-app-prod
    
    # 수동으로 동기화 실행
    argocd app sync my-app-prod
    
    # 동기화 상태 및 히스토리 확인
    argocd app history my-app-prod
    
    # 롤백 (이전 버전으로)
    argocd app rollback my-app-prod 
    

    Notification(알림) 설정으로 배포 상태 파악

    ArgoCD에는 argocd-notifications라는 컴포넌트가 있어서 Slack, 이메일, PagerDuty 등으로 배포 상태를 알림 받을 수 있어요. 저는 Slack 채널에 연동해서 배포 성공/실패를 실시간으로 받고 있는데, 이거 없으면 이제 못 살 것 같습니다 ㅎㅎ.

    RBAC으로 팀별 접근 제어

    # argocd-rbac-cm ConfigMap 예시
    apiVersion: v1
    kind: ConfigMap
    metadata:
      name: argocd-rbac-cm
      namespace: argocd
    data:
      policy.csv: |
        # 개발팀: dev 프로젝트만 접근 가능
        p, role:dev-team, applications, *, dev/*, allow
        p, role:dev-team, applications, sync, dev/*, allow
        
        # 플랫폼팀: 전체 접근 가능
        p, role:platform-team, applications, *, */*, allow
        p, role:platform-team, clusters, *, *, allow
        
        g, myorg:dev-team, role:dev-team
        g, myorg:platform-team, role:platform-team
      policy.default: role:readonly
    

    전략 정리 — 이것만 기억하세요

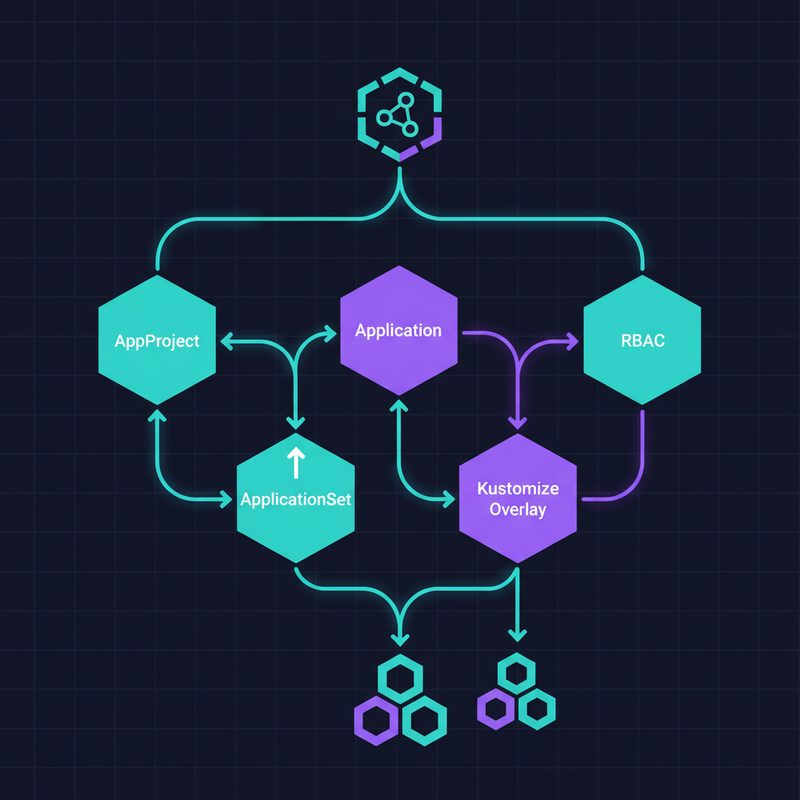
    ArgoCD 멀티 클러스터 GitOps 전략 핵심 구성요소 요약 인포그래픽 - AppProject, ApplicationSet, Kustomize, RBAC 관계도

    ▲ ArgoCD 멀티 클러스터 GitOps 전략의 핵심 요소를 한눈에 정리한 요약 다이어그램. Git 저장소 구조, ArgoCD 컴포넌트, 클러스터 관계를 보여줍니다.

    구성 요소 역할 핵심 포인트
    AppProject 배포 범위 및 권한 제한 환경별로 분리, Sync Window 설정
    Application 개별 앱 배포 정의 destination.server로 대상 클러스터 지정
    ApplicationSet 다중 클러스터 배포 자동화 템플릿 하나로 여러 클러스터에 배포
    Kustomize Overlay 환경별 설정 분리 base 공유, 환경별 차이만 patch
    RBAC 팀별 접근 제어 AppProject role + argocd-rbac-cm

    마무리하며 — 그래서 뭐가 달라졌냐면

    ArgoCD 멀티 클러스터 구성을 제대로 잡고 나서 가장 크게 달라진 건, 배포에 대한 불안감이 사라졌다는 거예요. 예전엔 “내가 지금 어떤 클러스터에 붙어있지?”를 항상 확인해야 했는데, 이제는 Git에 PR 올리고 머지하면 끝이거든요.

    물론 처음 설계할 때 Git 저장소 구조를 잘 잡는 게 제일 중요합니다. 나중에 구조를 바꾸려면 진짜 손이 많이 가거든요. 저도 한 번 갈아엎었습니다… ㅎㅎ 이 글을 보시는 분들은 처음부터 overlays 구조로 시작하시길 강력 추천합니다.

    다음 글에서는 ArgoCD Image Updater를 활용해서 컨테이너 이미지 태그 업데이트까지 완전 자동화하는 방법을 다뤄볼 예정이에요. CI 파이프라인에서 이미지 빌드되면 ArgoCD가 자동으로 Git 커밋하고 배포까지 이어지는 풀 사이클인데, 이거 진짜 편합니다.

    혹시 멀티 클러스터 구성하면서 막히는 부분 있으시면 댓글로 남겨주세요. 제가 겪어본 삽질이라면 같이 해결해 드릴 수 있을 것 같습니다 🎉

    자주 묻는 질문 (FAQ)

    Q. ArgoCD 자체가 설치된 허브 클러스터가 다운되면 어떻게 되나요?

    A. 허브 클러스터가 다운되면 새로운 배포는 불가능하지만, 이미 배포된 애플리케이션들은 각 클러스터에서 계속 정상 동작합니다. 이 때문에 허브 클러스터는 고가용성(HA) 구성으로 운영하는 것을 권장합니다.

    Q. ApplicationSet과 Application을 언제 선택해야 하나요?

    A. 동일한 앱을 여러 클러스터에 배포해야 한다면 ApplicationSet이 훨씬 효율적입니다. 클러스터마다 배포 설정이 크게 다르거나 배포 시점을 완전히 독립적으로 관리해야 한다면 개별 Application을 사용하는 게 맞습니다.

    Q. Helm과 Kustomize 중 어떤 걸 쓰는 게 좋나요?

    A. 서드파티 차트를 그대로 쓸 때는 Helm, 자체 매니페스트를 환경별로 관리할 때는 Kustomize가 더 직관적입니다. 둘을 혼합해서 쓰는 것도 가능하고, 저는 실제로 두 방식을 같이 씁니다.

  • [Game] MOBAPAD M12 HD 컨트롤러: 닌텐도 스위치 게이밍 업그레이드 경험담

    [Game] MOBAPAD M12 HD 컨트롤러: 닌텐도 스위치 게이밍 업그레이드 경험담

    MOBAPAD M12 HD 컨트롤러: 닌텐도 스위치 게이밍 업그레이드 경험담

    안녕하세요, 13년차 인프라 엔지니어이자 홈랩 운영에 진심인 개발자입니다. 요즘 제가 눈여겨보고 있는 게이밍 기어가 있어서 이야기를 나눠볼까 합니다. 바로 닌텐도 스위치용 MOBAPAD M12 HD 컨트롤러인데요. 유튜브에서 이 컨트롤러로 ‘홀로우 나이트’를 플레이하는 영상을 보다 보니 관심이 확 생겼거든요.

    처음엔 ‘MOBAPAD 핸드헬드 게임기’라는 키워드 때문에 새로운 휴대용 콘솔이 나왔나 싶었어요. 그런데 영상을 자세히 보니, MOBAPAD M12 HD는 닌텐도 스위치 본체를 장착해서 사용하는 컨트롤러더군요. 스위치 본연의 휴대성을 유지하면서도 게임 플레이 경험을 한 단계 끌어올려 주는 액세서리라는 점이 정말 끌렸습니다. 특히 ‘홀로우 나이트’ 같은 정교한 조작과 빠른 반응이 중요한 게임을 즐겨 하는 저로서는 이런 컨트롤러가 반가울 수밖에 없더라고요.

    MOBAPAD M12 HD 컨트롤러에 닌텐도 스위치 본체가 장착된 모습

    MOBAPAD M12 HD 컨트롤러로 ‘홀로우 나이트’를 플레이하는 영상을 보면, 스위치 휴대 모드의 잠재력을 제대로 끌어올리는 모습이 정말 인상적이더라고요. 기존 조이콘의 한계를 뛰어넘어 더욱 몰입감 있고 편안한 게이밍 경험을 제공하려는 의도가 엿보입니다. 특히 ‘홀로우 나이트’처럼 맵 탐색과 전투가 유기적으로 연결된 게임에서는 넓고 선명한 화면이 몰입감에 큰 영향을 미치더라고요. 영상 속에서 캐릭터의 움직임과 주변 환경이 디테일하게 표현되는 것을 보면서, 저도 모르게 게임 속으로 빠져드는 기분이었습니다.

    '홀로우 나이트' 게임 플레이 중 캐릭터가 적을 공격하는 장면

    영상을 보면서 가장 인상 깊었던 부분은 컨트롤러의 반응성이었어요. ‘홀로우 나이트’는 특히 보스전이나 복잡한 구간에서 한 치의 오차도 없는 컨트롤을 요구하는 게임이거든요. 영상 속 플레이어는 거침없이 적들을 회피하고 공격하며, 정말 본인이 게임 캐릭터가 된 듯한 느낌을 줍니다. 이는 컨트롤러의 입력 지연이 거의 없고, 버튼과 조이스틱의 물리적 피드백이 훌륭하다는 뜻이죠. 13년차 엔지니어로서 저는 시스템의 ‘반응성’과 ‘효율성’에 늘 민감합니다. 게임에서도 마찬가지죠. 미세한 딜레이 하나가 승패를 가르고 몰입감을 해칠 수 있으니까요. MOBAPAD M12 HD 컨트롤러는 이런 제 기대를 충분히 만족시킬 수 있을 것 같다는 강한 확신을 줬습니다.

    '홀로우 나이트' 게임 플레이 중 몬스터와 전투하는 장면

    제가 MOBAPAD M12 HD 컨트롤러에 관심을 갖게 된 결정적인 이유는 닌텐도 스위치 조이콘의 고질적인 문제 때문이었어요. 많은 스위치 유저들이 공감하겠지만, 조이콘은 ‘조이콘 드리프트’라는 치명적인 문제가 있고, 장시간 플레이 시 손에 피로감을 주는 작은 크기와 아쉬운 그립감을 가지고 있거든요. 특히 저는 게임을 휴대 모드로 즐길 때마다 답답함을 느꼈어요. 화면은 작은데 컨트롤러는 더 작아서 몰입도가 떨어지는 경험을 여러 번 했습니다. 홈랩에서 다양한 장비들을 세팅하고 최적화하는 데 익숙한 저로서는 이런 불편함을 그냥 두고 볼 수 없었죠.

    MOBAPAD M12 HD 컨트롤러는 이런 문제들에 명확한 해답을 제시합니다. 먼저 Hall Effect 조이스틱을 채택해서 드리프트 문제를 원천적으로 해결했다고 하네요. 이 부분이 가장 기대되는데, 더 이상 게임 도중 의도치 않은 움직임 때문에 스트레스받을 일이 없어진다는 거죠. 또한 인체공학적으로 설계된 그립감은 장시간 플레이에도 손의 피로를 최소화해 줄 것 같습니다. 영상에서 보이는 넉넉한 버튼 배치와 넓은 스크린 영역은 게임 플레이의 정확성과 시각적 만족도를 동시에 높여줄 것 같네요. 단순히 게임을 ‘할 수 있다’를 넘어, 게임을 ‘최고의 경험으로 즐길 수 있다’는 차이를 만들어주는 거죠.

    저는 홈랩에서 다양한 OS와 에뮬레이터를 돌려보며 하드웨어와 소프트웨어 간의 시너지를 탐구하는 것을 좋아합니다. MOBAPAD M12 HD 컨트롤러는 스위치 본체와 완벽하게 결합하여 마치 하나의 통합된 게이밍 디바이스처럼 작동하더라고요. 이는 단순한 주변 기기가 아니라, 스위치 게이밍 경험을 ‘재정의’하는 시도라고 생각해요. 직접 만져보지는 못했지만, 이 컨트롤러가 제 ‘홀로우 나이트’ 플레이는 물론, 다른 복잡한 액션 게임이나 RPG 게임들까지도 더욱 풍부하게 만들어 줄 것이라는 강한 기대감을 가지고 있습니다. 마치 서버 랙에 새로운 고성능 모듈을 추가하는 것처럼, 제 게이밍 환경에도 강력한 업그레이드가 될 거라는 확신이 드네요.

    MOBAPAD M12 HD 컨트롤러의 전반적인 디자인과 버튼 구성

    물론 모든 하드웨어가 완벽할 수는 없겠죠. 하지만 MOBAPAD M12 HD 컨트롤러가 제시하는 대화면 게이밍 경험과 향상된 조작감은 닌텐도 스위치 휴대 모드에 새로운 기준을 제시한다고 봅니다. 특히 저처럼 기술적인 완성도를 중요하게 생각하고, 게임 플레이에 있어 작은 불편함도 용납하지 못하는 유저들에게는 정말 매력적인 선택지가 될 거예요. 얼른 컨트롤러가 도착해서 ‘홀로우 나이트’의 깊은 숲을 새로운 감각으로 탐험해보고 싶네요. 혹시 스위치 게이밍 경험에 변화를 주고 싶다면, MOBAPAD M12 HD 컨트롤러를 한번 고려해 보시는 건 어떨까요?

    📺 참고 영상: 원본 영상 보기

  • [AI] ChatGPT, Claude, Gemini: 실무 LLM 비교 분석

    [AI] ChatGPT, Claude, Gemini: 실무 LLM 비교 분석

    LLM 비교: ChatGPT, Claude, Gemini — 실무에서 직접 써본 솔직한 이야기

    요즘 팀 내에서 자주 받는 질문이 있어요. “ChatGPT랑 Claude랑 Gemini 중에 뭐 써야 해요?” 인프라 엔지니어가 LLM 비교 글을 쓰는 게 좀 뜬금없어 보일 수도 있는데, 솔직히 저도 처음엔 그냥 ChatGPT 하나만 쓰면 되는 거 아닌가 싶었거든요. 근데 실제로 업무에서 쓰다 보니까 — 스크립트 작성, 장애 로그 분석, 문서화, 코드 리뷰 요청 등등 — 도구마다 확실히 잘하는 게 다르더라고요.

    그래서 오늘은 제가 실무에서 직접 써보면서 느낀 LLM 비교 이야기를 솔직하게 풀어볼게요. ChatGPT, Claude, Gemini 세 가지를 중심으로, 어떤 상황에서 뭘 쓰는 게 유리한지 정리해 봤습니다.

    ChatGPT, Claude, Gemini LLM 비교 — 세 가지 AI 챗봇 서비스 나란히 배치

    ▲ ChatGPT, Claude, Gemini — 각자 개성이 뚜렷한 세 가지 LLM. 어떤 상황에서 무엇을 써야 할지가 핵심입니다.

    🤖 LLM(대형 언어 모델)이 뭔지 잠깐 짚고 가기

    혹시 LLM(Large Language Model, 대형 언어 모델)이라는 용어가 아직 낯선 분들을 위해 짧게 설명하고 넘어갈게요. 쉽게 말해서, 방대한 텍스트 데이터를 학습해서 사람처럼 글을 읽고 쓸 수 있는 AI 모델이에요. ChatGPT, Claude, Gemini 모두 이 LLM 기술을 기반으로 만들어진 AI 챗봇 서비스입니다.

    각각 만든 회사가 다르고, 기반 모델도 달라요:

    • ChatGPT: OpenAI에서 만든 GPT 시리즈 기반. GPT-4o 등의 모델 사용
    • Claude: Anthropic에서 만든 Claude 시리즈 기반. Claude 3 시리즈(Haiku, Sonnet, Opus 등)
    • Gemini: Google에서 만든 Gemini 시리즈 기반. Gemini 1.5 Pro, Flash 등

    같은 LLM 계열이지만, 학습 방식과 철학이 달라서 답변 스타일과 강점이 꽤 차이가 나요. 이게 핵심입니다.

    📊 세 가지 LLM 기본 특성 한눈에 보기

    먼저 기본 스펙 비교부터 보시죠. 제가 실제로 사용해보면서 느낀 체감 특성을 함께 정리했어요.

    항목 ChatGPT (OpenAI) Claude (Anthropic) Gemini (Google)
    개발사 OpenAI Anthropic Google
    대표 모델 GPT-4o, GPT-4 Turbo Claude 3 Sonnet, Opus, Haiku Gemini 1.5 Pro, Flash
    컨텍스트 창 128K 토큰(GPT-4 Turbo) 200K 토큰(Claude 3) 1M 토큰(Gemini 1.5 Pro)
    강점 분야 범용, 코드 생성, 플러그인 생태계 긴 문서 분석, 글쓰기, 안전성 멀티모달, Google 서비스 연동
    무료 플랜 있음 (제한적) 있음 (제한적) 있음
    API 제공 ✅ ✅ ✅

    표만 보면 다 비슷비슷해 보이죠? 근데 실제로 써보면 체감이 확연히 달라요. 이제 제가 실무에서 겪은 케이스별로 풀어볼게요.

    💻 실무 케이스 1: 코드 작성 및 디버깅

    인프라 엔지니어로서 제일 자주 쓰는 용도가 스크립트 작성이에요. Bash, Python, Terraform(테라폼, 인프라 자동화 도구) 코드를 짤 때 LLM을 많이 활용하는데, 여기서 ChatGPT가 확실히 강하더라고요.

    예를 들어, 로그 파일에서 특정 패턴을 뽑아서 Slack으로 알림 보내는 Python 스크립트를 만들어달라고 했을 때, ChatGPT는 바로 실행 가능한 코드를 척척 내놓거든요. Claude도 잘 하는데, 코드 외에 “이 부분은 이런 이유로 이렇게 작성했습니다” 같은 설명을 더 붙여줘서 학습 목적엔 오히려 Claude가 나을 수도 있어요.

    Gemini는 Google Cloud 관련 코드에서 빛을 발하더라고요. GCP(Google Cloud Platform) 서비스 관련 설정이나 gcloud CLI 명령어 쪽은 역시 구글 것이라 그런지 정확도가 높았어요.

    # ChatGPT에게 요청한 프롬프트 예시
    # "Nginx 액세스 로그에서 5xx 에러를 추출해서
    # Slack Webhook으로 알림 보내는 Python 스크립트 작성해줘"
    
    import re
    import requests
    from datetime import datetime
    
    LOG_FILE = "/var/log/nginx/access.log"
    SLACK_WEBHOOK_URL = "https://hooks.slack.com/services/YOUR/WEBHOOK/URL"
    
    def parse_5xx_errors(log_file):
        errors = []
        pattern = re.compile(r'(\S+) \S+ \S+ \[(.+?)\] "(.+?)" (5\d{2})')
        with open(log_file, 'r') as f:
            for line in f:
                match = pattern.search(line)
                if match:
                    errors.append({
                        'ip': match.group(1),
                        'time': match.group(2),
                        'request': match.group(3),
                        'status': match.group(4)
                    })
        return errors
    
    def send_slack_alert(errors):
        if not errors:
            return
        message = f"⚠️ *5xx 에러 감지* ({datetime.now().strftime('%Y-%m-%d %H:%M')})"
        for e in errors[:5]:  # 최대 5개만
            message += f"\n• `{e['status']}` | {e['ip']} | {e['request']}"
        payload = {"text": message}
        requests.post(SLACK_WEBHOOK_URL, json=payload)
    
    if __name__ == "__main__":
        errors = parse_5xx_errors(LOG_FILE)
        send_slack_alert(errors)
        print(f"총 {len(errors)}개의 5xx 에러 감지")
    

    💡 팁: 코드 생성 프롬프트를 쓸 때는 “실행 환경(OS, Python 버전 등)”과 “입력/출력 예시”를 함께 알려주면 훨씬 정확한 코드가 나와요. 저도 처음엔 그냥 대충 물어봤다가 쓸 수 없는 코드 받고 삽질 좀 했습니다 ㅎㅎ

    📄 실무 케이스 2: 긴 문서 분석 및 요약

    여기서는 Claude가 압도적이에요. 실제로 제가 겪은 상황인데, 100페이지짜리 벤더 제안서를 분석해야 했던 적이 있었어요. 전체 내용을 붙여넣고 “핵심 기술 스펙과 비용 구조를 표로 정리해줘”라고 했더니, Claude는 컨텍스트 창(Context Window, AI가 한 번에 처리할 수 있는 텍스트 양)이 넓어서 문서 전체를 한 번에 처리하더라고요.

    ChatGPT도 GPT-4 Turbo 기준으로 128K 토큰까지 처리하는데, Claude 3의 200K 토큰에는 못 미치고, 긴 문서에서 중간 부분을 약간 흘리는 느낌이 있었어요. 반면 Claude는 문서 전체를 꽤 꼼꼼하게 읽고 정리해주는 인상이었습니다.

    Gemini 1.5 Pro의 경우 컨텍스트 창이 1M 토큰으로 이론상 가장 크지만, 실제 사용에서 긴 문서의 세부 내용 파악 정확도는 케이스마다 달랐어요. 구글 Docs나 Drive와 연동해서 쓸 때는 편리함 면에서 확실히 좋더라고요.

    ChatGPT, Claude, Gemini의 긴 문서 분석 비교 화면

    ▲ 긴 문서 분석 시나리오 — 컨텍스트 창 크기와 정보 처리 방식에 따라 결과 품질이 달라집니다.

    ✍️ 실무 케이스 3: 기술 문서 작성 및 글쓰기

    이건 솔직히 Claude 손을 들어주고 싶어요. 글쓰기 품질이 세 가지 중 가장 자연스럽고, 문장 구조도 깔끔하더라고요. Anthropic이 Claude를 만들 때 “도움이 되고, 무해하고, 정직한(Helpful, Harmless, Honest)” 원칙을 강조했는데, 그 덕분인지 답변이 과장 없이 균형 잡혀 있어요.

    장애 보고서(Post-mortem, 포스트모템)나 운영 가이드 초안 작성할 때 Claude한테 맡기면 꽤 쓸 만한 초안이 나와요. ChatGPT도 잘 하는데, 가끔 좀 과하게 친절하거나 불필요한 서론이 길어질 때가 있거든요.

    Gemini는 Google Workspace(구글 워크스페이스)와 연동이 자연스러워서, Docs에서 직접 쓸 때는 편리해요. 특히 팀 전체가 Google 생태계를 쓰는 환경이라면 Gemini의 통합성이 큰 장점이 됩니다.

    🔍 실무 케이스 4: 멀티모달(이미지 분석) 활용

    멀티모달(Multimodal, 텍스트 외에 이미지·영상 등 다양한 형식 처리)은 Gemini와 GPT-4o가 강하더라고요. 실제로 네트워크 다이어그램 이미지를 붙여넣고 “이 구성에서 단일 장애 지점(SPOF, Single Point of Failure)이 어디야?” 하고 물어봤더니 둘 다 꽤 정확하게 짚어주더라고요.

    ChatGPT GPT-4o는 이미지 분석을 잘 하고, 실제로 많이 쓰이는 편이에요. Claude 3도 이미지 입력을 지원하는데, 이미지 분석보다는 텍스트 처리 쪽에서 더 두각을 나타내는 느낌입니다.

    ⚠️ 주의사항: 이미지에 민감한 내부 정보(IP 주소, 내부 아키텍처 등)가 포함된 경우, 외부 AI 서비스에 업로드하는 건 보안 정책 검토가 필요해요. 저희 팀에서도 이 부분 때문에 한 번 논의가 있었거든요.

    🛠️ API 활용 및 자동화 관점에서 본 LLM 비교

    인프라 엔지니어 입장에서 API(Application Programming Interface, 프로그래밍 연동 인터페이스) 활용도 중요한 비교 포인트예요. 세 가지 모두 API를 제공하는데, 각각 특징이 있어요.

    • OpenAI API (ChatGPT): 레퍼런스가 가장 많고, 커뮤니티 자료도 풍부해요. LangChain(랭체인, LLM 애플리케이션 개발 프레임워크) 같은 오픈소스 도구와의 연동 예제도 제일 많고요. 처음 LLM API를 써본다면 여기서 시작하는 걸 추천합니다.
    • Anthropic API (Claude): 문서가 깔끔하고, 응답 품질이 안정적이에요. 최근 Claude API를 써서 내부 문서 검색 봇을 만들어봤는데, 긴 컨텍스트 처리가 필요한 RAG(Retrieval-Augmented Generation, 검색 증강 생성) 구현에 잘 맞더라고요.
    • Google AI API (Gemini): Google Cloud를 이미 쓰고 있다면 Vertex AI(버텍스 AI)를 통해 Gemini를 쓰는 게 자연스러워요. IAM(Identity and Access Management, 접근 권한 관리) 연동이나 모니터링도 GCP 생태계 안에서 처리할 수 있어서 편합니다.
    # Claude API 간단 사용 예시 (Anthropic SDK)
    import anthropic
    
    client = anthropic.Anthropic(api_key="YOUR_API_KEY")
    
    message = client.messages.create(
        model="claude-3-sonnet-20240229",
        max_tokens=1024,
        messages=[
            {
                "role": "user",
                "content": "다음 Nginx 에러 로그를 분석하고 원인과 해결책을 알려줘:\n[error] 1234#1234: *1 connect() failed (111: Connection refused)"
            }
        ]
    )
    
    print(message.content[0].text)
    
    # OpenAI API 간단 사용 예시
    from openai import OpenAI
    
    client = OpenAI(api_key="YOUR_API_KEY")
    
    response = client.chat.completions.create(
        model="gpt-4o",
        messages=[
            {
                "role": "system",
                "content": "당신은 인프라 엔지니어를 돕는 DevOps 전문가입니다."
            },
            {
                "role": "user",
                "content": "Kubernetes Pod가 CrashLoopBackOff 상태일 때 디버깅 순서를 알려줘"
            }
        ]
    )
    
    print(response.choices[0].message.content)
    
    LLM API 자동화 개발 환경 — OpenAI, Anthropic, Google AI API 활용

    ▲ LLM API를 활용한 자동화 — 각 서비스의 SDK를 통해 인프라 운영 자동화에 통합할 수 있습니다.

    ⚠️ 실제로 겪은 주의사항 및 한계

    장밋빛 얘기만 하면 안 되죠. 직접 써보면서 느낀 한계도 솔직하게 공유할게요.

    할루시네이션(Hallucination, AI 환각) 문제

    세 가지 모두 가끔 틀린 정보를 자신 있게 말하는 경우가 있어요. 특히 최신 정보나 아주 구체적인 기술 스펙을 물어볼 때 주의해야 해요. 저도 한 번은 특정 오픈소스 도구의 설정 옵션을 물어봤다가 존재하지 않는 파라미터를 안내받아서 한참 삽질했습니다. 공식 문서와 교차 검증은 필수예요.

    데이터 최신성 한계

    각 모델마다 학습 데이터 컷오프(Knowledge Cutoff, 학습 데이터 기준 날짜)가 있어서, 그 이후에 출시된 도구나 버전에 대해서는 부정확할 수 있어요. “최신” 정보를 물어볼 때는 직접 공식 사이트를 확인하는 습관이 필요합니다.

    보안 및 데이터 프라이버시

    업무에서 쓸 때 제일 조심해야 할 부분이에요. 내부 코드, 고객 데이터, 기밀 정보는 절대 외부 AI 서비스에 입력하면 안 됩니다. 기업 환경에서는 각 서비스의 엔터프라이즈 플랜(데이터 학습 제외 옵션 포함)을 검토하거나, 온프레미스(On-premise, 자체 서버 운영) 배포 가능한 오픈소스 LLM을 고려해야 해요.

    비용 관리

    API를 자동화에 붙이다 보면 비용이 생각보다 빠르게 쌓여요. 토큰(Token, AI 언어 처리 단위) 사용량 모니터링과 예산 알림 설정은 꼭 해두세요. 저도 처음에 테스트 코드 잘못 돌렸다가 예상보다 많은 비용이 청구된 적 있었거든요 😅

    🎯 상황별 추천 정리

    그래서 결론적으로 어떤 상황에서 뭘 쓰면 좋냐고요? 제 경험 기반으로 정리해봤어요.

    상황 추천 도구 이유
    코드 생성 / 디버깅 ChatGPT (GPT-4o) 레퍼런스 많고, 코드 품질 안정적
    긴 문서 분석 / 요약 Claude (Sonnet/Opus) 넓은 컨텍스트 창, 정확한 내용 파악
    기술 문서 / 보고서 작성 Claude 자연스러운 문체, 균형 잡힌 답변
    이미지 분석 / 멀티모달 Gemini 또는 GPT-4o 멀티모달 처리 강점
    Google 생태계 통합 Gemini Workspace, GCP 연동 자연스러움
    LLM API 첫 도입 ChatGPT (OpenAI API) 커뮤니티 자료 가장 풍부
    RAG 기반 내부 문서 봇 Claude API 긴 컨텍스트 처리 안정적
    상황별 LLM 추천 가이드 — ChatGPT, Claude, Gemini 활용 사례 비교 인포그래픽

    ▲ 상황별 LLM 선택 가이드 — 어떤 도구도 모든 면에서 완벽하지 않습니다. 상황에 맞게 선택하는 게 핵심이에요.

    ❓ 자주 묻는 질문 (FAQ)

    Q. 하나만 써야 한다면 뭘 골라야 하나요?
    범용으로는 ChatGPT GPT-4o를 추천합니다. 코드도 되고, 문서도 되고, 이미지도 되고, 커뮤니티 자료도 제일 많아서 처음 시작하기에 좋아요.
    Q. 무료로 쓸 수 있나요?
    세 가지 모두 무료 플랜이 있어요. 다만 무료 플랜에서는 최신/고성능 모델 접근이 제한되거나 사용량 제한이 있어요. 업무용으로 제대로 쓰려면 유료 플랜이 필요한 경우가 많습니다.
    Q. 회사 내부 코드를 AI에 넣어도 되나요?
    원칙적으로는 사내 보안 정책 확인이 먼저입니다. 각 서비스의 엔터프라이즈 플랜에서는 입력 데이터를 학습에 사용하지 않는 옵션을 제공하는 경우가 있어요. 확인 전까지는 민감 정보 입력을 피하세요.
    Q. API 비용이 얼마나 드나요?
    사용량에 따라 크게 달라서 딱 말씀드리기 어렵고, 각 서비스 공식 페이지의 Pricing 페이지에서 최신 가격을 확인하시는 게 정확합니다. 토큰당 과금이라 사용 패턴에 따라 차이가 커요.

    🎉 마무리: 도구는 도구일 뿐, 판단은 내가

    13년 동안 인프라 엔지니어 하면서 느낀 건데, 좋은 도구가 생겼을 때 제일 중요한 건 “이걸 어디에 쓸 것인가”를 판단하는 능력이에요. LLM도 마찬가지예요. ChatGPT, Claude, Gemini 모두 훌륭한 도구인데, 맹목적으로 믿으면 안 되고 결과물을 항상 검증하는 습관이 필요합니다.

    저는 요즘 이렇게 쓰고 있어요. 코드 초안은 ChatGPT, 긴 문서 분석이나 문서 작성은 Claude, Google Cloud 관련 작업은 Gemini. 상황에 따라 골라 쓰는 거죠. 하나에 올인하기보다 각각의 강점을 파악하고 조합해서 쓰는 게 실무에서 훨씬 효율적이더라고요.

    다음 글에서는 이 LLM들을 활용해서 실제로 내부 지식베이스 챗봇을 만드는 과정을 다룰 예정이에요. RAG(검색 증강 생성) 아키텍처 구성부터 온프레미스 배포까지 — 관심 있으신 분들은 RSS나 뉴스레터 구독해두시면 알림 받으실 수 있어요.

    혹시 실무에서 LLM 활용하면서 재밌는 경험이나 삽질 경험 있으신 분들, 댓글로 공유해주시면 좋겠어요. 저도 아직 배우는 중이라서 ㅎㅎ 같이 성장해요! 🚀
  • [3D 프린팅] OctoPrint 완벽 가이드: 라즈베리 파이로 원격 제어하기

    [3D 프린팅] OctoPrint 완벽 가이드: 라즈베리 파이로 원격 제어하기

    [3D 프린팅] OctoPrint 완벽 가이드: 라즈베리 파이로 3D 프린터 원격 제어하기

    안녕하세요, 13년차 인프라 엔지니어입니다. 오늘은 제 홈랩에서 정말 유용하게 쓰고 있는 OctoPrint에 대한 이야기를 해볼까 합니다. 혹시 3D 프린터 출력 시작 버튼 누르고 나서, 혹시나 실패할까 봐 전전긍긍하며 프린터 앞에서 밤새 대기하고 계신가요? 아니면 출력 상태 확인하려고 작업실까지 왔다 갔다 하는 게 귀찮으신가요? 제가 딱 그랬거든요. 😅

    저도 처음엔 3D 프린터 출력을 시작하면 중간에 문제가 생길까 봐 걱정이 많았어요. 출력물 베드가 들뜨거나, 필라멘트가 엉키거나, 심지어는 프린터가 오작동해서 불이 날까 봐 불안했죠. 이런 불안감을 해결해 준 게 바로 라즈베리 파이와 OctoPrint였습니다. 이제는 사무실에 앉아서도, 심지어는 외부에 있을 때도 제 3D 프린터의 상태를 실시간으로 모니터링하고 제어할 수 있게 됐습니다. 정말 편하더라고요! 오늘은 이 OctoPrint를 라즈베리 파이에 설치하고 활용하는 완벽 가이드를 공유해 드릴게요. 저의 삽질 경험을 녹여냈으니, 여러분은 좀 더 쉽게 성공하실 수 있을 겁니다. 🎉
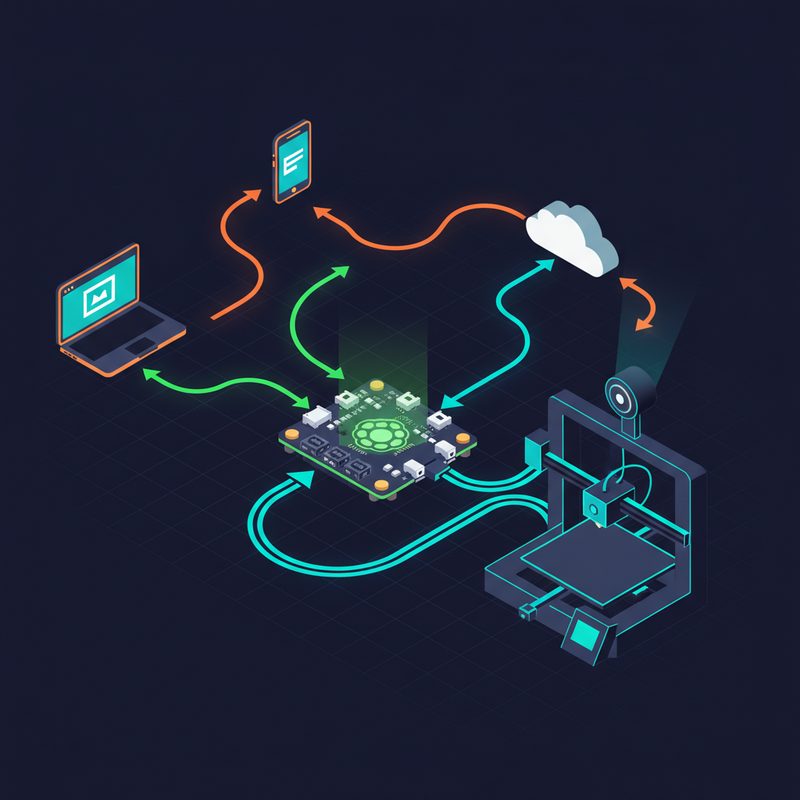
    OctoPrint가 라즈베리 파이와 3D 프린터를 연결하여 원격 제어 및 모니터링하는 전체 아키텍처 다이어그램

    OctoPrint와 라즈베리 파이, 그리고 3D 프린터의 연결 구조를 보여주는 다이어그램입니다. 마치 뇌가 신체 각 부분을 통제하는 모습과 비슷하죠?

    OctoPrint가 뭐야? 왜 써야 할까요?

    먼저 OctoPrint가 정확히 무엇인지, 그리고 왜 이걸 써야 하는지부터 알아봐야겠죠?

    OctoPrint 개념 쉽게 설명

    쉽게 말해 OctoPrint는 3D 프린터를 위한 웹 인터페이스 기반의 원격 제어 및 모니터링 시스템입니다. 오픈소스 프로젝트로, 주로 라즈베리 파이 같은 싱글 보드 컴퓨터에 설치해서 사용하죠. 3D 프린터에 USB로 연결하면, 마치 프린터의 두뇌처럼 작동하면서 웹 브라우저나 스마트폰 앱으로 모든 제어를 가능하게 해줍니다.

    OctoPi는 이런 OctoPrint를 라즈베리 파이에 쉽게 설치할 수 있도록 미리 세팅해 놓은 운영체제 이미지입니다. 라즈베리 파이 OS 위에 OctoPrint와 웹캠 스트리밍을 위한 mjpg-streamer 등이 포함되어 있어서, SD 카드에 굽기만 하면 바로 사용할 수 있어요. 저처럼 이것저것 설정하는 데 익숙한 사람에게도 편하지만, 초보자에게는 더할 나위 없이 좋은 솔루션입니다.

    OctoPrint의 주요 장점

    • 원격 제어: 웹 브라우저나 앱으로 언제 어디서든 프린터의 움직임, 온도, 팬 속도 등을 제어할 수 있습니다. G-code(3D 프린터 명령 언어)를 직접 보내는 것도 가능하죠.
    • 실시간 모니터링: 웹캠을 연결하면 실시간으로 출력 과정을 영상으로 볼 수 있습니다. 제가 가장 애용하는 기능 중 하나예요.
    • 타임랩스: 출력 과정 전체를 멋진 타임랩스 영상으로 자동 제작해 줍니다. 결과물을 보면서 뿌듯함을 느낄 수 있죠.
    • 플러그인 확장성: 수많은 플러그인이 있어서 기능을 무한히 확장할 수 있습니다. 예를 들어, AI 기반의 실패 감지 플러그인이나 Telegram 알림 플러그인 등이 있습니다.
    • 파일 관리: G-code 파일을 웹 인터페이스에서 직접 업로드하고 관리할 수 있습니다. SD 카드에 넣었다 뺐다 할 필요가 없어져요.

    실전 구현: 라즈베리 파이에 OctoPi 설치하기

    자, 이제 직접 OctoPrint를 설치해볼 차례입니다. 단계별로 차근차근 따라오시면 어렵지 않게 성공하실 수 있을 거예요. 저도 처음엔 좀 헤맸지만, 결국 해냈거든요! 💡

    준비물

    시작하기 전에 필요한 것들을 먼저 챙겨봅시다.

    • 라즈베리 파이: Raspberry Pi 3B+ 또는 Raspberry Pi 4 (2GB 이상 권장). 저는 Pi 4 4GB 모델을 쓰고 있습니다. 구형 모델은 웹캠 스트리밍 시 버벅일 수 있어요.
    • MicroSD 카드: 16GB 이상 (클래스 10 이상 권장).
    • 라즈베리 파이 전원 어댑터: 5V 3A 이상. 전원 부족은 라즈베리 파이의 가장 흔한 문제입니다. ⚠️ 정품 어댑터를 쓰시는 게 정신 건강에 좋습니다. 제가 싸구려 어댑터 썼다가 엄청 삽질했거든요.
    • USB 케이블 (Type A to B): 3D 프린터와 라즈베리 파이를 연결할 케이블.
    • USB 웹캠 (선택 사항): 모니터링을 위한 웹캠. 라즈베리 파이와 호환되는 모델인지 확인하는 게 좋아요.
    • 컴퓨터: OctoPi 이미지를 MicroSD 카드에 구울 때 사용합니다.

    단계 1: OctoPi 이미지 다운로드 및 설치

    1. OctoPi 이미지 다운로드: OctoPrint 공식 홈페이지에서 최신 OctoPi 이미지를 다운로드합니다.

    2. Raspberry Pi Imager 설치: 컴퓨터에 Raspberry Pi Imager를 설치합니다. 이 툴을 사용하면 아주 쉽게 OS 이미지를 SD 카드에 구울 수 있습니다.

    3. 이미지 굽기:

      • Imager를 실행하고 CHOOSE OS를 클릭합니다.
      • Custom을 선택한 후, 다운로드한 OctoPi 이미지를 선택합니다.
      • CHOOSE STORAGE를 클릭하여 MicroSD 카드를 선택합니다.
      • WRITE를 클릭하여 이미지를 굽습니다. 이 과정은 몇 분 정도 소요될 수 있습니다.
    4. Wi-Fi 및 SSH 설정 (강력 권장): 이미지가 성공적으로 구워지면, SD 카드가 컴퓨터에 다시 마운트됩니다. 이 SD 카드 내부에 boot 파티션이 보일 거예요. 여기에 octopi-wpa-supplicant.txt 파일을 열어서 Wi-Fi 설정을 해줍니다. 주석을 제거하고 아래와 같이 수정하세요.

      # WPA/WPA2 secured
      network={
        ssid="YOUR_WIFI_SSID"
        psk="YOUR_WIFI_PASSWORD"
      }
      

      그리고 SSH를 활성화하려면 boot 파티션에 확장자 없는 ssh라는 이름의 빈 파일을 생성합니다. 윈도우에서는 메모장으로 ssh.txt를 만든 후 확장자를 제거하면 됩니다. ⚠️ SSID나 PSK 오타 조심하세요! 제가 여기서 오타 때문에 연결이 안 돼서 한참을 헤맸습니다. ㅎㅎ

    단계 2: OctoPrint 초기 설정

    1. 라즈베리 파이 부팅: 설정이 완료된 MicroSD 카드를 라즈베리 파이에 삽입하고 전원을 연결합니다. 처음 부팅하는 데 시간이 좀 걸릴 수 있어요.

    2. OctoPrint 접속: 라즈베리 파이가 네트워크에 연결되면, 웹 브라우저를 열고 http://octopi.local 또는 라즈베리 파이의 IP 주소(예: http://192.168.1.xxx)로 접속합니다. IP 주소는 공유기 관리 페이지에서 확인하거나, nmap 같은 툴로 스캔해서 찾을 수 있습니다.

    3. 초기 설정 마법사 진행: 웹 인터페이스에 접속하면 OctoPrint 초기 설정 마법사가 시작됩니다. 사용자 이름, 비밀번호를 설정하고, 3D 프린터 프로필을 생성합니다. 프린터의 베드 사이즈, 노즐 크기 등을 입력하면 돼요. 이 과정에서 액세스 제어를 설정하여 보안을 강화하는 게 중요합니다. 외부에서 접속할 계획이라면 꼭 비밀번호를 강력하게 설정하세요!

    4. 3D 프린터 연결: 라즈베리 파이와 3D 프린터를 USB 케이블로 연결한 다음, OctoPrint 웹 인터페이스에서 Connect 버튼을 클릭합니다. 올바른 Serial Port와 Baudrate를 선택해야 합니다. 보통 자동으로 감지되지만, 안 되면 수동으로 설정해야 해요. 제 프린터는 115200 Baudrate를 썼습니다.

    OctoPrint 웹 인터페이스의 대시보드 화면, 3D 프린터 원격 제어 및 모니터링

    OctoPrint에 성공적으로 접속했을 때 볼 수 있는 대시보드 화면입니다. 제 3D 프린터가 연결되어 있고, 웹캠 스트리밍도 잘 나오고 있네요.

    단계 3: 웹캠 연결 및 설정 (선택 사항)

    실시간 모니터링의 핵심인 웹캠을 연결해봅시다.

    1. USB 웹캠 연결: 라즈베리 파이에 USB 웹캠을 연결합니다.

    2. 웹캠 스트리밍 확인: OctoPrint 웹 인터페이스의 Control 탭으로 이동하면, 웹캠 스트리밍 화면이 보일 겁니다. 만약 보이지 않으면, Settings > Webcam & Timelapse 섹션에서 Stream URL이 올바르게 설정되어 있는지 확인합니다. 보통 /webcam/?action=stream으로 되어 있을 거예요. 웹캠 호환성 문제가 있을 수 있으니, 미리 라즈베리 파이에서 잘 동작하는지 확인해두는 게 좋습니다.

    주의사항 및 삽질 해결 경험

    제가 OctoPrint를 설치하고 사용하면서 겪었던 몇 가지 문제점과 그 해결 방법을 공유해 드립니다. 여러분은 저처럼 삽질하지 마세요! 😅

    • ⚠️ 라즈베리 파이 전원 부족: 가장 흔한 문제입니다. 웹캠이나 다른 USB 장치를 연결했을 때, 라즈베리 파이의 전압이 부족하면 오작동하거나 부팅이 안 될 수 있습니다. 저는 정품 5V 3A 어댑터로 교체하고 나서 해결됐습니다. 터미널에서 dmesg | grep voltage 명령으로 전압 경고를 확인할 수 있어요.

    • ⚠️ USB 케이블 불량: 3D 프린터와 라즈베리 파이를 연결하는 USB 케이블이 불량인 경우가 의외로 많습니다. 다른 케이블로 바꿔보니 바로 연결되는 경험을 몇 번 했어요. 데이터 전송이 가능한 케이블인지 확인하세요.

    • ⚠️ Wi-Fi 연결 문제: SSID나 비밀번호에 오타가 있으면 라즈베리 파이가 Wi-Fi에 연결되지 않습니다. 특히 특수문자가 포함된 비밀번호는 더 주의해야 해요. ssh로 접속해서 sudo cat /var/log/syslog | grep wpa 명령으로 로그를 확인해보면 원인을 찾을 수 있습니다.

    • ⚠️ 웹캠 인식 문제: 일부 웹캠은 라즈베리 파이에서 제대로 인식되지 않거나, mjpg-streamer와 호환되지 않을 수 있습니다. lsusb 명령으로 웹캠이 인식되는지 확인하고, 구글에 [웹캠 모델명] Raspberry Pi OctoPrint로 검색해서 호환성 정보를 찾아보세요. 저는 로지텍 C920 모델을 사용하는데, 아무 문제 없이 잘 작동하더라고요.

    • ⚠️ 프린터 연결 오류: OctoPrint에서 프린터 연결이 안 될 때, Serial Port가 여러 개 뜨거나 Baudrate가 맞지 않는 경우가 있습니다. /dev/ttyUSB0이나 /dev/ttyACM0 같은 포트를 시도해보고, 프린터 제조사에서 권장하는 Baudrate를 찾아보세요. 보통 115200 또는 250000을 많이 써요.

    결과 확인: 따뜻한 커피와 함께하는 원격 출력!

    모든 설정이 완료되고, 드디어 OctoPrint를 통해 3D 프린터를 원격으로 제어할 수 있게 되었습니다! 🎉 이제 여러분은 웹 인터페이스에서 G-code 파일을 업로드하고, 출력을 시작하며, 웹캠으로 진행 상황을 지켜볼 수 있어요. 심지어 문제가 생기면 출력을 일시 중지하거나 취소할 수도 있죠. 이 편리함은 정말이지 겪어봐야 압니다.

    저는 이제 아침에 출근해서 사무실에 앉아 어제 자기 전에 슬라이싱해둔 G-code 파일을 OctoPrint에 업로드하고 출력을 시작합니다. 그리고 중간중간 웹캠으로 출력 상태를 확인하면서 다른 업무를 보거나, 따뜻한 커피 한 잔의 여유를 즐기죠. 예전 같으면 프린터 옆에 붙어 앉아 노심초사했을 텐데, 정말 삶의 질이 달라졌어요. 홈랩의 진정한 의미를 여기서 찾았다고 생각합니다.

    OctoPrint의 플러그인 목록 화면, 3D 프린터 기능 확장

    OctoPrint의 강력한 기능 중 하나인 플러그인 확장 기능입니다. 다양한 플러그인을 통해 기능을 무한히 확장할 수 있어요.

    마무리: 이제 당신의 3D 프린터는 스마트해졌습니다!

    오늘은 OctoPrint와 라즈베리 파이를 활용해 3D 프린터를 원격 제어하고 모니터링하는 방법에 대해 자세히 알아봤습니다. 제가 직접 경험한 삽질과 해결 과정을 공유하면서, 여러분이 좀 더 쉽고 빠르게 이 편리함을 누리시길 바라는 마음으로 글을 써봤어요.

    OctoPrint는 단순히 원격 제어를 넘어, 3D 프린팅 경험 자체를 한 단계 업그레이드 시켜주는 강력한 도구입니다. 이제 여러분의 3D 프린터도 스마트해졌으니, 더 멋진 출력물을 만드는데 집중할 수 있을 거예요. 다음 단계로는 다양한 플러그인을 활용해보시길 추천합니다. 특히 AI 기반 실패 감지 플러그인은 정말 신세계입니다. 🤩

    혹시 설치 중에 궁금한 점이나 문제가 발생하면 언제든지 댓글로 남겨주세요. 저의 13년차 인프라 경험이 여러분의 삽질을 줄여주는 데 도움이 될 수 있다면 기쁠 것 같습니다. 그럼 다음 기술 이야기에서 또 만나요! 🚀

    OctoPrint와 라즈베리 파이를 통한 3D 프린터 원격 제어 장점 인포그래픽

    OctoPrint와 라즈베리 파이의 주요 장점들을 한눈에 볼 수 있도록 요약한 인포그래픽입니다.

  • [AI] Google Gemini API 실전 활용: 멀티모달 기능과 최신 모델 연동 가이드

    [AI] Google Gemini API 실전 활용: 멀티모달 기능과 최신 모델 연동 가이드

    드디어 Gemini API를 써보기로 했습니다

    솔직히 말씀드리면, 저는 꽤 오랫동안 OpenAI API만 쓰고 있었거든요. 익숙하기도 하고, 레퍼런스도 많고. 근데 작년부터 Google Gemini API가 계속 눈에 밟히기 시작했습니다. 특히 멀티모달(Multimodal) — 텍스트, 이미지, 오디오, 영상까지 하나의 API로 처리한다는 게 인프라 자동화 쪽에서 꽤 매력적으로 보이더라고요.

    서버 로그 이미지 분석이라든가, 네트워크 토폴로지 다이어그램 해석이라든가. 이런 걸 텍스트 API 하나로만 하려면 전처리가 엄청 복잡해지는데, 이미지를 그냥 던져버릴 수 있다면 얘기가 달라지잖아요.

    그래서 이번에 홈랩 프로젝트 겸 Google Gemini API를 제대로 파봤습니다. Google AI Studio 세팅부터 멀티모달 요청까지, 제가 삽질했던 부분들도 솔직하게 공유할게요.

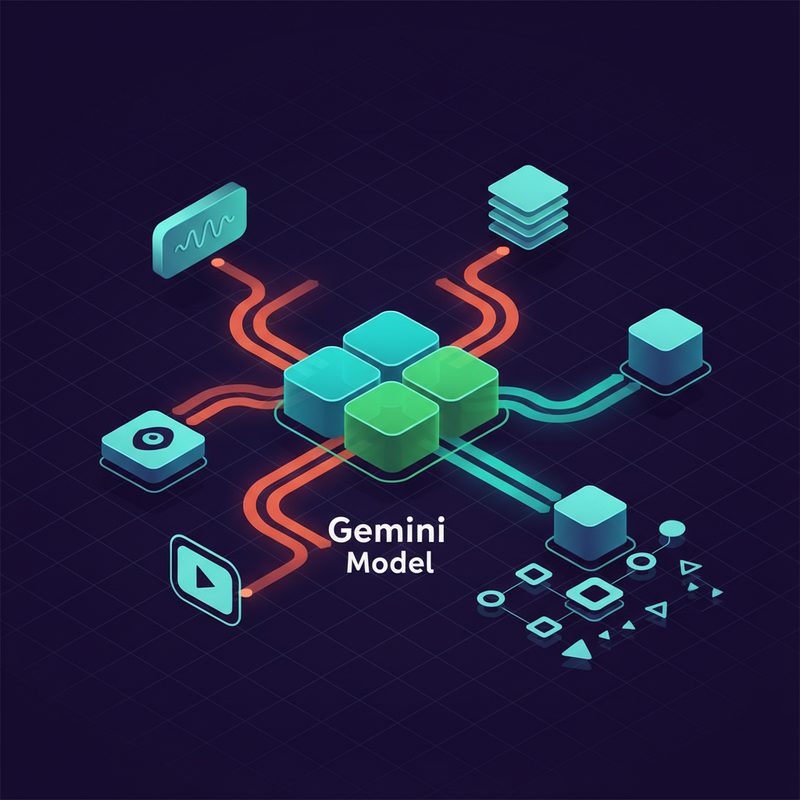
    Google Gemini API overview architecture diagram showing multimodal inputs (text, image, audio, video) flowing into Gemini model and returning responses

    ▲ Google Gemini API의 멀티모달 아키텍처 — 텍스트, 이미지, 오디오, 영상을 하나의 엔드포인트로 처리합니다

    Google Gemini API란? 기본 개념 정리

    Gemini 모델 계열 이해하기

    Gemini API를 쓰기 전에 모델 계열을 먼저 이해해야 해요. 저도 처음엔 이름이 너무 많아서 헷갈렸거든요.

    모델명 특징 주요 용도 멀티모달
    Gemini 1.5 Pro 최대 100만 토큰 컨텍스트, 고성능 복잡한 추론, 긴 문서 처리 ✅ 지원
    Gemini 1.5 Flash 빠른 응답, 비용 효율적 실시간 처리, 대량 요청 ✅ 지원
    Gemini 1.0 Pro 안정적인 범용 모델 텍스트 기반 작업 ⚠️ 제한적

    제 용도에는 Gemini 1.5 Flash가 제일 잘 맞더라고요. 홈랩 자동화 스크립트에서 API를 자주 호출하다 보니 응답 속도와 비용이 중요했거든요. Pro는 진짜 복잡한 분석이 필요할 때만 씁니다.

    멀티모달(Multimodal)이 뭔데 이렇게 떠드냐면

    쉽게 말해서, 기존 LLM API는 텍스트만 주고받는 구조였잖아요. 근데 멀티모달은 이미지, 영상, 오디오, PDF 같은 다양한 형식의 데이터를 텍스트와 함께 입력으로 넣을 수 있는 구조입니다.

    인프라 엔지니어 관점에서 실용적인 예시를 들면:

    • Grafana 대시보드 스크린샷을 던져주고 “이 그래프에서 이상 징후 찾아줘” 요청
    • 서버 아키텍처 다이어그램 이미지를 분석해서 보안 취약점 리포트 생성
    • 에러 로그 파일을 통째로 넣고 원인 분석 요청
    • 네트워크 패킷 캡처 요약본 이미지 분석

    이게 텍스트만 쓸 때랑 얼마나 차이가 나는지는 실제로 써보면 느낌이 와요. 아래에서 코드로 직접 보여드릴게요.

    Google AI Studio 세팅 — API 키 발급부터

    1단계: Google AI Studio 접속 및 API 키 발급

    Gemini API를 쓰려면 먼저 Google AI Studio(aistudio.google.com)에서 API 키를 발급받아야 합니다. Google 계정만 있으면 되고, 무료 티어도 있어서 테스트하기엔 충분해요.

    1. aistudio.google.com 접속 후 Google 계정으로 로그인
    2. 좌측 메뉴에서 “Get API key” 클릭
    3. “Create API key” 선택 후 프로젝트 연결
    4. 발급된 키를 안전한 곳에 저장 (다시 볼 수 없으니 주의!)

    ⚠️ 주의: API 키는 절대 코드에 하드코딩하지 마세요. 저는 환경변수로 관리합니다.

    # .env 파일 또는 환경변수로 관리
    export GOOGLE_API_KEY="your-api-key-here"
    
    # Python에서 불러올 때
    # import os
    # api_key = os.environ.get("GOOGLE_API_KEY")

    2단계: Python SDK 설치

    # Google Generative AI Python SDK 설치
    pip install google-generativeai
    
    # 버전 확인
    pip show google-generativeai

    저는 가상환경(venv)에서 작업하는 걸 항상 권장해요. 나중에 의존성 충돌로 고생하는 것보다 처음부터 깔끔하게 관리하는 게 낫거든요.

    # 가상환경 생성 및 활성화
    python3 -m venv gemini-env
    source gemini-env/bin/activate  # Linux/Mac
    # gemini-env\\Scripts\\activate  # Windows
    
    pip install google-generativeai python-dotenv
    Google AI Studio interface screenshot showing API key generation page and model playground with clean dark theme UI

    ▲ Google AI Studio에서 API 키를 발급받고 플레이그라운드에서 바로 테스트할 수 있습니다

    실전 구현 — 텍스트부터 멀티모달까지

    기본 텍스트 요청 — Hello, Gemini!

    먼저 가장 기본적인 텍스트 요청부터 시작해봅시다. 이것만 돌아가도 절반은 성공이에요.

    import google.generativeai as genai
    import os
    from dotenv import load_dotenv
    
    # 환경변수 로드
    load_dotenv()
    
    # API 키 설정
    genai.configure(api_key=os.environ.get("GOOGLE_API_KEY"))
    
    # 모델 초기화 — gemini-1.5-flash 사용
    model = genai.GenerativeModel("gemini-1.5-flash")
    
    # 기본 텍스트 요청
    response = model.generate_content(
        "Linux 서버에서 메모리 누수를 디버깅하는 방법을 3단계로 설명해줘"
    )
    
    print(response.text)

    처음 돌렸을 때 진짜 빠르게 응답이 오더라고요. 체감상 GPT-3.5 터보랑 비슷하거나 조금 빠른 느낌? 물론 이건 네트워크 상황마다 다르니 참고만 하세요.

    멀티모달 요청 — 이미지 분석하기

    자, 이제 진짜 재밌는 부분입니다. 이미지를 같이 넣어서 분석을 요청하는 거예요. 저는 이걸로 서버 모니터링 대시보드 스크린샷을 분석하는 스크립트를 만들었습니다.

    import google.generativeai as genai
    import PIL.Image
    import os
    from dotenv import load_dotenv
    
    load_dotenv()
    genai.configure(api_key=os.environ.get("GOOGLE_API_KEY"))
    
    # 멀티모달 모델 초기화
    model = genai.GenerativeModel("gemini-1.5-flash")
    
    # 로컬 이미지 파일 로드
    image = PIL.Image.open("server_dashboard.png")
    
    # 이미지 + 텍스트 함께 요청
    response = model.generate_content([
        image,
        "이 서버 모니터링 대시보드에서 이상 징후가 있는지 분석해줘. "
        "CPU, 메모리, 네트워크 트래픽 관점에서 각각 평가해줘."
    ])
    
    print(response.text)

    💡 팁: PIL.Image 말고도 URL로 직접 이미지를 넘길 수도 있어요. 로컬 파일 없이 빠르게 테스트할 때 유용합니다.

    import httpx
    import google.generativeai as genai
    
    # URL에서 이미지 직접 로드
    image_url = "https://example.com/network-diagram.png"
    image_data = httpx.get(image_url).content
    
    # 바이트 데이터로 넘기기
    response = model.generate_content([
        {
            "mime_type": "image/png",
            "data": image_data
        },
        "이 네트워크 다이어그램에서 SPOF(Single Point of Failure)를 찾아줘"
    ])
    
    print(response.text)
  • [Proxmox] Proxmox VE 백업 및 복원 전략: 안전한 가상 환경 운영 가이드

    [Proxmox] Proxmox VE 백업 및 복원 전략: 안전한 가상 환경 운영 가이드

    백업 없는 서버는 시한폭탄이나 마찬가지입니다

    13년 동안 인프라를 운영하면서 가장 많이 들은 말이 뭔지 아세요? “백업은 있는데 복원은 해본 적이 없어요.” 이거거든요. 솔직히 저도 초반에 그랬습니다. 백업 스크립트 돌려놓고 ‘됐겠지’ 하고 넘어갔다가… 실제로 장애가 났을 때 복원이 안 되는 경험을 한 번 해보고 나서야 정신이 번쩍 들었죠.

    Proxmox VE(프록스목스 가상 환경) 환경에서 VM(가상 머신)이나 LXC 컨테이너를 운영 중이라면, Proxmox VE 백업 전략은 선택이 아니라 필수입니다. 홈랩이든 소규모 프로덕션이든 마찬가지예요. 오늘은 제가 실제로 구성하고 운영 중인 Proxmox VE 백업 및 복원 전략을 처음부터 끝까지 풀어드리겠습니다.

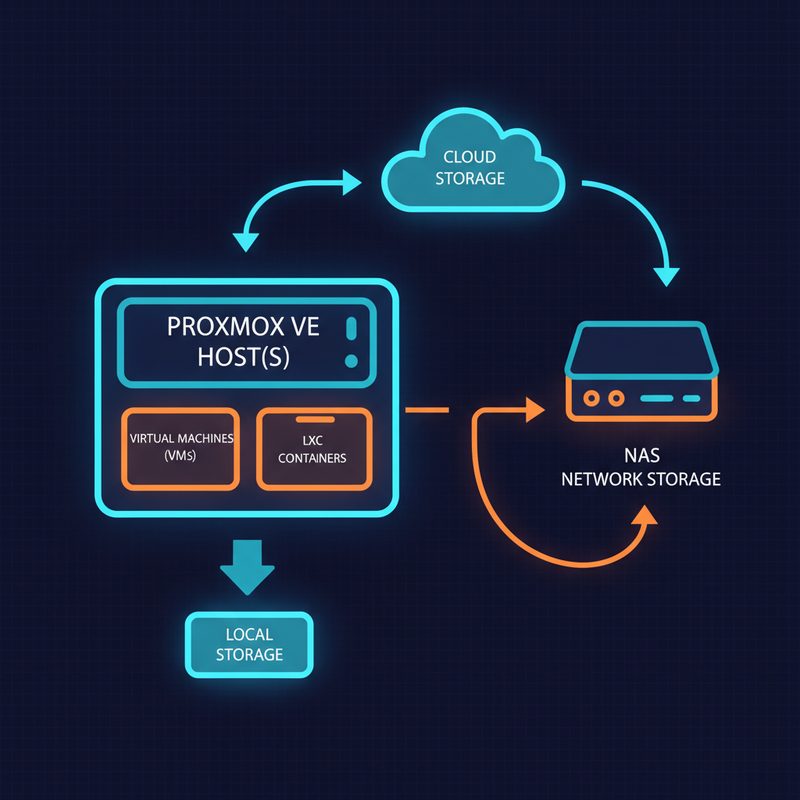
    Proxmox VE 백업 전략 전체 아키텍처 구성도 — VM, 로컬 스토리지, NAS, 클라우드 백업 흐름

    ▲ Proxmox VE 백업 전략의 전체 구성도 — VM 백업, 스냅샷, 외부 스토리지까지 한눈에 볼 수 있습니다.

    Proxmox VE 백업 방식, 뭐가 다른 건가요?

    Proxmox VE에서 제공하는 데이터 보호 방식은 크게 세 가지입니다. 처음 접하면 헷갈리는데, 쉽게 정리해드릴게요.

    1. 스냅샷 (Snapshot) — 빠르지만 독립적이지 않다

    스냅샷은 특정 시점의 VM 상태를 기록해두는 기능입니다. 쉽게 말해서, 게임의 세이브 포인트 같은 거예요. 디스크 상태뿐 아니라 RAM 상태까지 저장할 수 있어서 그 순간 그대로 돌아올 수 있습니다. 단, 스냅샷은 원본 스토리지에 의존하기 때문에 스토리지 자체가 날아가면 함께 사라집니다. 이 점을 반드시 기억해야 해요.

    2. 백업 (Backup/vzdump) — 진짜 의미의 백업

    Proxmox VE의 vzdump 도구를 사용해서 VM이나 LXC의 전체 이미지를 별도 파일로 추출하는 방식입니다. 이 파일은 독립적으로 존재하기 때문에 원본이 날아가도 복원이 가능합니다. 저장 형식은 .vma(VM용) 또는 .tar(LXC용)이고, 압축 옵션을 선택할 수 있습니다.

    3. 복제 (Replication) — HA 구성을 위한 실시간 동기화

    Proxmox VE 클러스터 환경에서 노드 간에 ZFS 스냅샷 기반으로 데이터를 동기화하는 기능입니다. 고가용성(HA, High Availability) 구성에 주로 쓰이고, 단일 노드 홈랩에서는 크게 쓸 일이 없습니다.

    방식 독립성 속도 용도 권장 상황
    스냅샷 ❌ 원본 의존 ⚡ 매우 빠름 작업 전 임시 저장 업데이트, 설정 변경 전
    vzdump 백업 ✅ 독립적 🐢 느림 재해 복구(DR) 정기 백업, 장기 보관
    복제 ✅ 노드 분리 ⚡ 빠름(증분) HA 구성 클러스터 환경

    실전 구현: vzdump로 VM 백업 설정하기

    자, 이제 실제로 설정해봅시다. Proxmox VE 웹 UI와 CLI 양쪽 다 설명드릴게요. 저는 주로 CLI를 쓰는 편인데, 자동화하기 훨씬 편하거든요.

    백업 스토리지 추가

    먼저 백업 파일을 저장할 스토리지를 지정해야 합니다. 웹 UI 기준으로는 Datacenter → Storage → Add에서 추가할 수 있어요. NFS나 SMB/CIFS, 로컬 디렉토리 등 다양한 방식을 지원합니다.

    CLI로 NFS 스토리지를 추가하는 예시입니다:

    # NFS 백업 스토리지 추가
    pvesm add nfs backup-nfs \
      --server 192.168.1.100 \
      --export /mnt/nas/proxmox-backup \
      --content backup \
      --maxfiles 3
    
    # 추가된 스토리지 확인
    pvesm status

    여기서 --maxfiles 3은 백업 파일을 최대 3개까지 보관하고, 초과하면 오래된 것부터 자동 삭제한다는 뜻입니다. 스토리지가 부족할 때 꼭 설정해줘야 해요. 저 처음에 이거 안 해놨다가 NAS가 꽉 차서 백업이 실패하는 상황을 겪었거든요.

    수동 백업 실행 (CLI)

    # 특정 VM 백업 (VM ID: 100)
    vzdump 100 --storage backup-nfs --compress zstd --mode snapshot
    
    # 모든 VM 백업
    vzdump --all --storage backup-nfs --compress zstd --mode snapshot
    
    # LXC 컨테이너 백업 (CT ID: 200)
    vzdump 200 --storage backup-nfs --compress zstd --mode suspend

    백업 모드(--mode) 옵션이 중요합니다. 세 가지가 있어요:

    • snapshot: VM을 계속 실행하면서 스냅샷 기반으로 Proxmox VE 백업을 진행. 서비스 중단 없음. 권장
    • suspend: 백업 중 VM을 일시 정지. 데이터 일관성은 좋지만 서비스 잠깐 중단
    • stop: VM을 완전히 중지 후 백업. 가장 안전하지만 다운타임 발생

    자동 백업 스케줄 설정

    Proxmox VE 웹 UI에서 Datacenter → Backup → Add로 스케줄을 만들 수 있습니다. 하지만 저는 설정 파일을 직접 확인하고 관리하는 걸 더 좋아해요. 설정 파일 위치는 여기입니다:

    # 백업 스케줄 설정 파일
    cat /etc/cron.d/vzdump
    
    # 예시: 매일 새벽 2시에 모든 VM 백업
    0 2 * * * root /usr/bin/vzdump --all --storage backup-nfs \
      --compress zstd --mode snapshot \
      --mailto [email protected] \
      --quiet 1

    웹 UI에서 만든 스케줄은 /etc/pve/jobs.cfg 파일에 저장됩니다. 확인해보면 이런 형태예요:

    vzdump: job-daily-backup
    	compress zstd
    	day mon,tue,wed,thu,fri,sat,sun
    	enabled 1
    	mailnotification always
    	mode snapshot
    	node pve-node01
    	starttime 02:00
    	storage backup-nfs
    Proxmox VE 웹 UI 자동 백업 스케줄 설정 화면 예시

    ▲ Proxmox VE 웹 UI에서 자동 백업 스케줄을 설정하는 화면 — 스토리지, 시간, 압축 방식을 직관적으로 설정할 수 있습니다.

    복원(Restore) 실전 가이드

    백업만큼 중요한 게 복원 연습입니다. 실제로 장애 상황에서 손이 떨리면서 복원 명령어 치는 것보다, 미리 한 번이라도 해봤냐 안 해봤냐가 엄청난 차이를 만들어요.

    웹 UI로 복원하기

    1. Proxmox VE 웹 UI 접속 → 왼쪽 패널에서 백업 스토리지 선택
    2. Content 탭 클릭 → 백업 파일 목록 확인
    3. 복원할 백업 파일 선택 → Restore 버튼 클릭
    4. 복원할 노드, VM ID, 스토리지 선택 후 Restore 실행

    CLI로 복원하기

    # 백업 파일 목록 확인
    pvesm list backup-nfs
    
    # VM 복원 (백업 파일에서 VM ID 101로 복원)
    qmrestore /mnt/pve/backup-nfs/dump/vzdump-qemu-100-2024_01_15-02_00_00.vma.zst 101
    
    # 기존 VM을 덮어쓰면서 복원 (같은 ID 사용)
    qmrestore /mnt/pve/backup-nfs/dump/vzdump-qemu-100-2024_01_15-02_00_00.vma.zst 100 --force
    
    # LXC 컨테이너 복원
    pct restore 201 /mnt/pve/backup-nfs/dump/vzdump-lxc-200-2024_01_15-02_00_00.tar.zst \
      --storage local-lvm

    복원 후에는 반드시 VM을 시작해서 서비스가 정상 동작하는지 확인하세요. 저는 복원 테스트할 때 항상 다른 VM ID로 먼저 복원해보고, 내부에서 서비스 상태 확인한 다음에 실제 교체하는 방식을 씁니다.

    스냅샷 활용 전략 — 올바르게 쓰는 법

    스냅샷은 정말 편리한 기능인데, 잘못 쓰면 오히려 독이 됩니다. 제가 봐온 가장 흔한 실수가 스냅샷을 백업 대용으로 쓰는 거예요.

    스냅샷 생성 및 관리

    # VM 스냅샷 생성 (RAM 상태 포함)
    qm snapshot 100 pre-update-20240115 \
      --description "커널 업데이트 전 스냅샷" \
      --vmstate 1
    
    # 스냅샷 목록 확인
    qm listsnapshot 100
    
    # 스냅샷으로 롤백
    qm rollback 100 pre-update-20240115
    
    # 스냅샷 삭제
    qm delsnapshot 100 pre-update-20240115

    💡 팁: 스냅샷이 쌓이면 VM 성능에 영향을 줄 수 있습니다. 특히 QCOW2 포맷에서 스냅샷 체인이 길어지면 I/O 성능이 떨어지거든요. 작업이 끝나면 반드시 필요 없는 스냅샷은 지워주세요.

    스냅샷 vs 백업 — 언제 뭘 써야 하나

    • ✅ 스냅샷 사용 시점: 패키지 업데이트 전, 설정 변경 전, 테스트 작업 전 (단기 롤백 목적)
    • ✅ 백업 사용 시점: 정기적 데이터 보호, 장기 보관, 다른 서버로 이전, 재해 복구(DR, Disaster Recovery)

    ⚠️ 트러블슈팅 — 제가 직접 겪은 문제들

    자, 이제 진짜 중요한 부분입니다. Proxmox VE 백업 설정하면서 제가 삽질했던 경험들을 공유할게요.

    문제 1: 백업 중 “lock file exists” 오류

    백업이 중간에 실패하면 락 파일이 남아서 다음 백업도 실패하는 경우가 있습니다.

    # 락 파일 확인
    ls /var/run/vzdump.lock
    
    # 강제 삭제 (프로세스가 없을 때만!)
    rm /var/run/vzdump.lock
    
    # vzdump 프로세스 확인
    ps aux | grep vzdump

    문제 2: NFS 스토리지 백업 실패

    NFS 마운트 포인트 권한 문제로 백업이 실패하는 경우가 많습니다. NFS 서버 설정에서 no_root_squash 옵션이 빠져 있으면 root 권한으로 쓰기가 안 돼요.

    # NFS 서버 측 /etc/exports 설정 예시
    /mnt/nas/proxmox-backup 192.168.1.0/24(rw,sync,no_root_squash,no_subtree_check)
    
    # NFS 서버에서 exports 재적용
    exportfs -ra
    
    # Proxmox에서 마운트 상태 확인
    mount | grep nfs
    df -h

    문제 3: 스냅샷 상태에서 백업 실패

    VM에 스냅샷이 남아 있는 상태에서 mode=snapshot으로 백업하면 오류가 나는 경우가 있습니다. 특히 QCOW2 포맷에서 발생하는데, 이럴 때는 mode=suspend나 mode=stop을 시도해보세요.

    문제 4: 백업 파일 무결성 검증

    백업 파일이 제대로 됐는지 확인하는 방법도 알아두면 좋습니다.

    # 백업 파일 무결성 검사
    vzdump --verify /mnt/pve/backup-nfs/dump/vzdump-qemu-100-2024_01_15-02_00_00.vma.zst
    
    # zstd 압축 파일 테스트
    zstd --test /mnt/pve/backup-nfs/dump/vzdump-qemu-100-2024_01_15-02_00_00.vma.zst
    Proxmox VE 백업 무결성 검증 및 복원 테스트 결과 대시보드

    ▲ 백업 무결성 검증 및 복원 테스트 결과 확인 — 정기적인 복원 테스트가 진짜 재해 복구의 핵심입니다.

    3-2-1 백업 규칙 — 홈랩에도 적용하세요

    인프라 업계에서 오랫동안 통용되는 백업 황금 규칙이 있습니다. 3-2-1 규칙이에요.

    • 📁 3: 데이터 복사본을 최소 3개 보관
    • 💾 2: 2가지 이상의 서로 다른 미디어/스토리지에 저장
    • 🌍 1: 1개는 오프사이트(원격 위치)에 보관

    홈랩 기준으로 현실적인 구성을 제안드리면:

    복사본 위치 방법
    원본 Proxmox 노드 로컬 스토리지 운영 중인 VM 자체
    2번째 로컬 NAS vzdump → NFS/SMB 백업
    3번째 클라우드 또는 외장 드라이브 rclone으로 클라우드 동기화

    클라우드 동기화는 rclone을 이용하면 편리합니다. Backblaze B2나 AWS S3 같은 저렴한 오브젝트 스토리지와 연동할 수 있거든요.

    # rclone으로 백업 파일 클라우드 동기화 예시
    rclone sync /mnt/pve/backup-nfs/dump/ remote:proxmox-backup/ \
      --include "*.vma.zst" \
      --min-age 1h \
      --log-file /var/log/rclone-backup.log
    
    # cron에 등록 (매일 새벽 4시 실행)
    echo "0 4 * * * root rclone sync /mnt/pve/backup-nfs/dump/ remote:proxmox-backup/ --include '*.vma.zst' --min-age 1h" >> /etc/cron.d/rclone-backup

    재해 복구(DR) 시나리오별 대응 전략

    마지막으로, 실제 장애 상황별로 어떻게 대응해야 하는지 정리해드릴게요. 이걸 미리 문서화해두면 실제 장애 시 훨씬 침착하게 대응할 수 있습니다.

    시나리오 1: VM 데이터 손상 (단일 VM 문제)

    1. 해당 VM 중지
    2. 최신 백업 파일 확인: pvesm list backup-nfs
    3. 새 VM ID로 복원 후 데이터 확인
    4. 문제없으면 기존 VM 삭제 후 ID 교체

    시나리오 2: Proxmox 노드 장애 (하드웨어 교체 필요)

    1. 새 하드웨어에 동일 버전 Proxmox VE 설치
    2. 백업 스토리지(NAS) 연결 및 스토리지 추가
    3. 모든 VM을 백업에서 순차 복원
    4. 네트워크 설정 재확인 및 서비스 점검

    시나리오 3: 스토리지 전체 장애

    1. 클라우드 또는 외장 드라이브에 보관된 3번째 백업 사용
    2. 새 스토리지 준비 후 백업 파일 복사
    3. Proxmox에서 스토리지 재구성 후 복원 진행
    Proxmox VE 재해 복구 전략 3-2-1 백업 규칙 인포그래픽

    ▲ 재해 복구 전략 요약 인포그래픽 — 3-2-1 백업 규칙과 시나리오별 대응 흐름을 한눈에 정리했습니다.

    자주 묻는 질문 (FAQ)

    Q. 백업 중에 VM을 사용해도 되나요?

    네, mode=snapshot 옵션을 사용하면 백업 중에도 VM이 계속 실행됩니다. 다만 데이터베이스 서버처럼 트랜잭션이 많은 경우엔 애플리케이션 레벨의 백업도 병행하는 걸 권장합니다.

    Q. 압축 형식은 뭘 써야 하나요?

    Proxmox VE 7.x 이상에서는 zstd를 추천합니다. gzip보다 훨씬 빠르면서 압축률도 비슷하거든요. 구버전에서는 lzo가 속도가 빠른 편입니다.

    Q. 백업 파일 크기가 너무 큰데 줄일 방법이 있나요?

    VM 내부에서 불필요한 파일을 정리하고 디스크 빈 공간을 0으로 채운 후 백업하면 압축률이 올라갑니다. Linux VM 기준으로 dd if=/dev/zero of=/tmp/zero.file; rm /tmp/zero.file 실행 후 백업해보세요.

    마무리 — 백업은 문화입니다

    오늘 Proxmox VE 백업과 복원 전략을 처음부터 끝까지 다뤄봤는데요. 핵심만 다시 정리하면:

    • ✅ 스냅샷은 단기 롤백, vzdump 백업은 장기 보관용으로 구분해서 사용하세요
    • ✅ 3-2-1 규칙을 홈랩에도 적용하세요 — 클라우드 동기화가 생각보다 저렴합니다
    • ✅ 복원 테스트를 정기적으로 해보세요 — 최소 분기에 한 번은 실제로 복원해보는 걸 강력 추천합니다
    • ✅ 백업 알림 설정을 꼭 해두세요 — 실패했는데 모르고 있는 게 제일 위험합니다

    혹시 Proxmox VE 클러스터 환경에서의 복제(Replication) 설정이나 Proxmox Backup Server(PBS) 연동에 대해 궁금하신 분들은 다음 글에서 자세히 다룰 예정이니 기대해주세요. PBS는 중복 제거(deduplication) 기능이 있어서 스토리지 효율이 훨씬 좋거든요.

    13년 동안 서버 운영하면서 배운 가장 중요한 교훈 하나를 드리고 마칠게요. “백업은 있는데 복원은 안 된다”는 건 백업이 없는 것과 같습니다. 오늘 바로 복원 테스트 한 번 해보시는 거 어떨까요? 🎉

  • [Proxmox] Proxmox VE ZFS 스토리지 최적화: 성능과 안정성 동시 확보 가이드

    [Proxmox] Proxmox VE ZFS 스토리지 최적화: 성능과 안정성 동시 확보 가이드

    ZFS를 Proxmox에 올리면 생기는 일

    홈랩을 운영하다 보면 어느 순간 이런 생각이 드시죠. “스토리지 관리 좀 제대로 해보고 싶다.” 저도 그랬거든요. 처음엔 그냥 ext4 파티션에 LVM(논리 볼륨 관리자) 얹어서 쓰다가, 어느 날 디스크 하나가 조용히 세상을 떠나면서 VM 이미지를 통째로 날린 경험이 있습니다. 그날 이후로 ZFS(Zettabyte File System)를 진지하게 공부하기 시작했어요.

    Proxmox VE ZFS 조합은 사실 홈랩 커뮤니티에서 꽤 오래된 조합입니다. Proxmox VE가 ZFS를 기본 지원하기 시작한 이후로, 별도의 커널 모듈 컴파일 없이도 ZFS를 바로 쓸 수 있게 됐거든요. 근데 막상 써보면 “설치는 쉬운데, 최적화는 어디서부터 시작해야 하지?” 하는 막막함이 있더라고요. 오늘은 그 막막함을 같이 해소해 보겠습니다.

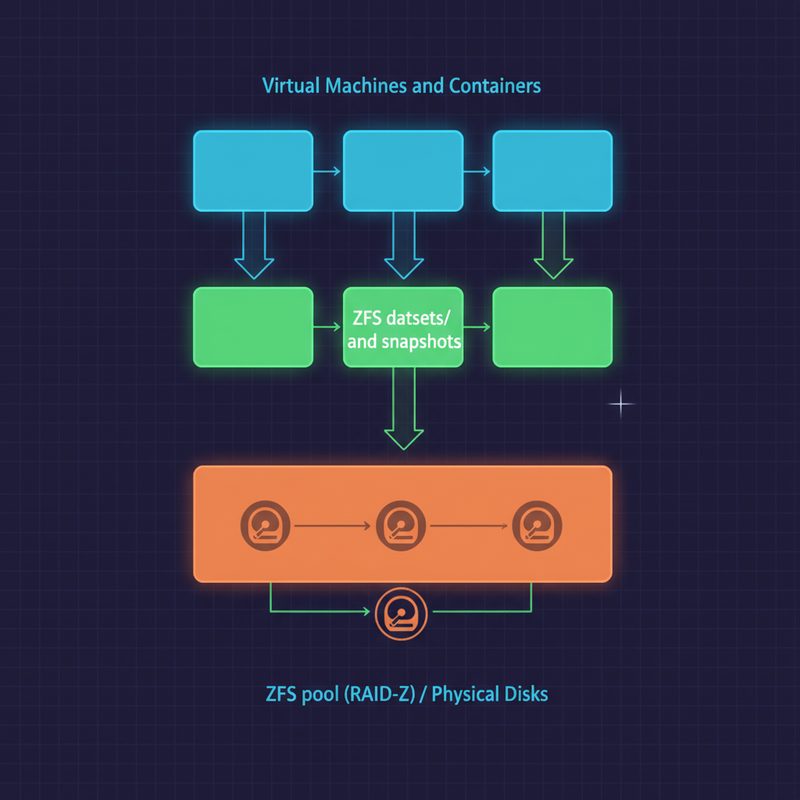
    Proxmox VE ZFS 스토리지 아키텍처 전체 계층 구조 다이어그램

    ▲ Proxmox VE + ZFS 스토리지 구성 전체 아키텍처 — VM/CT 레이어부터 ZFS 풀(Pool), 물리 디스크까지의 계층 구조를 보여줍니다.

    ZFS가 뭔지 먼저 짚고 가겠습니다

    쉽게 말해서 ZFS는 “똑똑한 파일 시스템”입니다

    일반 파일 시스템과 ZFS의 가장 큰 차이점은, ZFS가 파일 시스템과 볼륨 관리자를 동시에 담당한다는 점이에요. 기존에는 파티션 → LVM → 파일 시스템 이렇게 레이어가 쌓였다면, ZFS는 이걸 하나로 통합해서 관리합니다.

    핵심 기능만 짚어볼게요:

    • Copy-on-Write(CoW, 쓰기 시 복사): 데이터를 덮어쓰지 않고 항상 새 블록에 씁니다. 시스템이 갑자기 꺼져도 데이터가 깨지지 않아요.
    • Checksum(체크섬, 데이터 무결성 검증): 모든 블록에 체크섬이 붙어 있어서, 읽을 때마다 데이터가 정상인지 자동으로 확인합니다. Silent Data Corruption(무음 데이터 손상)을 잡아내는 거죠.
    • Snapshot(스냅샷): 순간적으로 파일 시스템 상태를 저장합니다. Proxmox에서 VM 백업할 때 이게 핵심이에요.
    • RAID-Z(레이드-Z): 소프트웨어 RAID를 ZFS 레벨에서 처리합니다. 하드웨어 RAID 컨트롤러 없이도 충분한 안정성을 확보할 수 있어요.
    • ARC(Adaptive Replacement Cache, 적응형 교체 캐시): RAM을 읽기 캐시로 활용합니다. 메모리가 많을수록 성능이 올라가요.

    Proxmox VE에서 ZFS 스토리지를 쓰면 좋은 이유

    솔직히 말하면, Proxmox + ZFS 조합의 가장 큰 장점은 스냅샷 기반 백업이 기가 막히게 편하다는 겁니다. VM을 백업할 때 ZFS 스냅샷을 찍으면 거의 순간적으로 완료되거든요. 100GB짜리 VM이라도 스냅샷 자체는 1초도 안 걸립니다. 실제 데이터 복사가 아니라 메타데이터만 기록하는 방식이라서요.

    항목 기존 LVM + ext4 ZFS
    데이터 무결성 파일 시스템 레벨만 블록 레벨 체크섬
    스냅샷 속도 데이터 크기에 비례 거의 즉각적
    RAID 관리 별도 mdadm 필요 ZFS 내장
    압축 지원 안 함 투명 압축 지원
    RAM 요구량 낮음 높음 (ARC 때문에)
    설정 복잡도 낮음 중간~높음

    Proxmox VE ZFS 풀(Pool) 구성하기

    1단계: ZFS 풀 생성 전 디스크 확인

    먼저 사용할 디스크들을 확인합니다. 중요한 건 ZFS는 반드시 디스크 전체를 넘겨줘야 한다는 거예요. 파티션 위에 ZFS를 올리는 것도 기술적으로는 가능하지만, 권장하지 않습니다. 저도 처음에 파티션 위에 올렸다가 나중에 풀 교체하는 데 고생했거든요.

    # 현재 연결된 디스크 목록 확인
    lsblk -d -o NAME,SIZE,MODEL,SERIAL
    
    # 디스크 상태 확인 (스마트 정보)
    smartctl -a /dev/sdb
    
    # ZFS에서 사용할 디스크 ID 확인 (권장: ID 방식으로 지정)
    ls -la /dev/disk/by-id/ | grep -v part

    💡 팁: ZFS 풀 생성 시 /dev/sdb 같은 경로 대신 /dev/disk/by-id/ 아래의 ID를 사용하세요. 재부팅 후 디스크 순서가 바뀌어도 안전합니다.

    2단계: ZFS 풀 생성

    Proxmox에서 ZFS 풀을 만드는 방법은 두 가지입니다. GUI로 하거나 CLI로 하거나. 저는 CLI를 선호해요. 정확히 뭘 하는지 눈에 보이니까요.

    # 미러(Mirror, RAID-1과 유사) 풀 생성 예시 — 디스크 2개
    zpool create -o ashift=12 \
      -O compression=lz4 \
      -O atime=off \
      -O xattr=sa \
      -O dnodesize=auto \
      rpool mirror \
      /dev/disk/by-id/ata-디스크1_시리얼 \
      /dev/disk/by-id/ata-디스크2_시리얼
    
    # RAID-Z1 풀 생성 예시 — 디스크 3개 이상
    zpool create -o ashift=12 \
      -O compression=lz4 \
      -O atime=off \
      -O xattr=sa \
      -O dnodesize=auto \
      datapool raidz1 \
      /dev/disk/by-id/ata-디스크1_시리얼 \
      /dev/disk/by-id/ata-디스크2_시리얼 \
      /dev/disk/by-id/ata-디스크3_시리얼

    여기서 각 옵션이 뭔지 짚어볼게요:

    • ashift=12: 4KB 섹터 디스크에 맞는 설정. 요즘 HDD/SSD 대부분이 4KB 섹터 또는 그 이상이라서 거의 필수입니다. 풀 생성 후 변경 불가니까 처음에 꼭 확인하세요.
    • compression=lz4: LZ4 압축 활성화. CPU 부하가 거의 없으면서 10~30% 정도 공간을 아낄 수 있어요.
    • atime=off: 파일 접근 시간 기록 비활성화. I/O 성능 향상에 도움이 됩니다.
    • xattr=sa: 확장 속성을 inode에 저장. 성능 향상에 기여해요.
    • dnodesize=auto: dnode 크기 자동 조정. 대용량 파일 시스템에 유리합니다.

    3단계: Proxmox에 ZFS 스토리지 등록

    풀을 만들었으면 Proxmox가 이걸 스토리지로 인식하게 해줘야 합니다.

    # /etc/pve/storage.cfg 에 추가하거나
    # Proxmox GUI: Datacenter > Storage > Add > ZFS 선택
    
    # CLI로 추가하는 방법
    pvesm add zfspool datapool-storage \
      --pool datapool \
      --content images,rootdir \
      --sparse 1

    GUI에서 하시면 Datacenter → Storage → Add → ZFS 선택하고 풀 이름 입력하면 됩니다. 훨씬 직관적이에요.

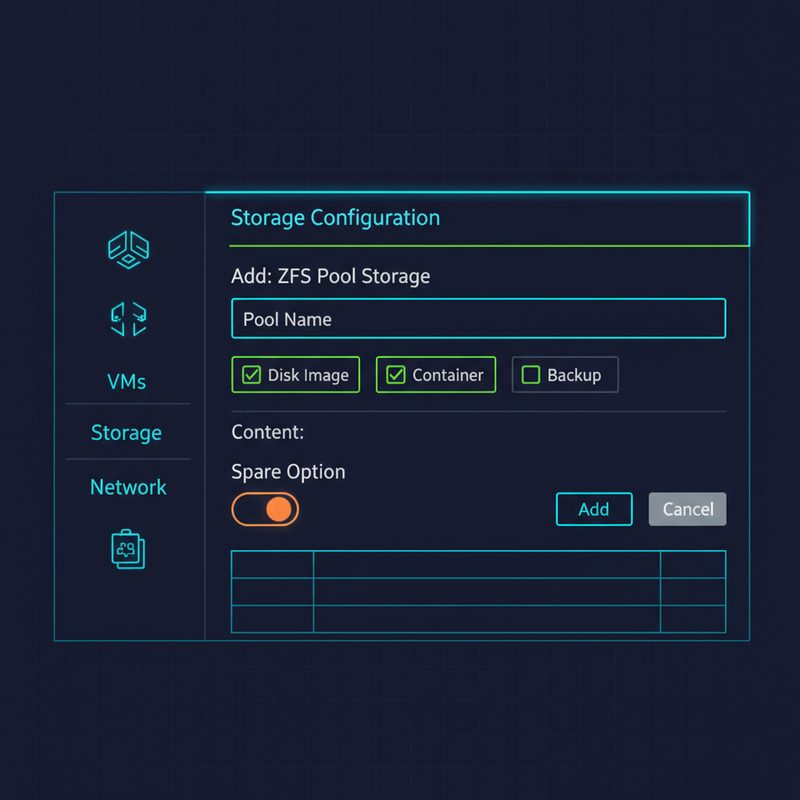
    Proxmox VE 웹 GUI ZFS 스토리지 추가 설정 화면

    ▲ Proxmox VE 관리 콘솔에서 ZFS 풀을 스토리지로 등록하는 화면 — 풀 이름, Content 타입, Sparse 옵션 등을 설정합니다.

    ZFS 성능 최적화 핵심 설정

    ARC 메모리 설정 — 제일 중요합니다

    ZFS의 ARC(Adaptive Replacement Cache)는 기본적으로 사용 가능한 RAM의 절반 정도까지 사용하려고 합니다. 홈랩이나 소규모 서버에서는 이게 VM들이 쓸 메모리를 잡아먹는 문제가 생겨요. 저도 처음에 이 설정 안 하고 쓰다가 “왜 VM이 이렇게 느리지?” 하면서 한참 삽질했습니다.

    # 현재 ARC 사용량 확인
    cat /proc/spl/kstat/zfs/arcstats | grep -E '^(size|c_max|c_min|hits|misses)'
    
    # ARC 최대 크기 제한 설정 (예: 8GB로 제한)
    # /etc/modprobe.d/zfs.conf 파일 생성/편집
    cat > /etc/modprobe.d/zfs.conf << 'EOF'
    options zfs zfs_arc_max=8589934592
    EOF
    
    # 즉시 적용 (재부팅 없이)
    echo 8589934592 > /sys/module/zfs/parameters/zfs_arc_max
    
    # 변경 확인
    cat /sys/module/zfs/parameters/zfs_arc_max

    ⚠️ 주의: ARC를 너무 작게 설정하면 ZFS 성능이 크게 떨어집니다. 일반적으로 전체 RAM의 20~25% 정도는 ARC에 남겨두는 걸 권장해요. 16GB RAM이면 최소 4GB는 ARC에 할당하는 게 좋습니다.

    L2ARC와 ZIL/SLOG 설정 — SSD 있으면 써먹어야죠

    SSD가 여분으로 있다면 L2ARC(Level 2 ARC, 2차 읽기 캐시)와 SLOG(Separate Intent Log, 분리 의도 로그)로 활용할 수 있습니다.

    # L2ARC 추가 (읽기 캐시, SSD 권장)
    zpool add datapool cache /dev/disk/by-id/ssd-캐시디스크_시리얼
    
    # SLOG/ZIL 추가 (쓰기 캐시, 저지연 SSD 권장)
    # 미러 구성을 강력히 권장 (SLOG 손실 시 데이터 손실 위험)
    zpool add datapool log mirror \
      /dev/disk/by-id/ssd-slog1_시리얼 \
      /dev/disk/by-id/ssd-slog2_시리얼
    
    # 현재 풀 구성 확인
    zpool status datapool

    💡 팁: SLOG는 반드시 미러로 구성하세요. SLOG 디스크가 고장나면 최근 쓰기 데이터가 날아갈 수 있거든요. 비용이 두 배가 되더라도 미러가 맞습니다.

    ZFS 데이터셋 최적화 설정

    Proxmox에서 VM 이미지를 저장하는 데이터셋은 별도로 최적화해 주는 게 좋아요. VM 워크로드 특성에 맞게요.

    # VM 이미지용 데이터셋 최적화
    # recordsize를 VM 디스크 블록 크기에 맞게 조정
    zfs set recordsize=64K datapool/images
    
    # 또는 데이터베이스 VM이 많다면
    zfs set recordsize=16K datapool/images
    
    # 압축 설정 (lz4가 성능/압축률 균형이 좋음)
    zfs set compression=lz4 datapool
    
    # 현재 데이터셋 속성 확인
    zfs get all datapool | grep -E '(compression|recordsize|atime|sync)'
    
    # sync 설정 (주의: disabled는 데이터 손실 위험 있음)
    # VM이 많고 성능이 중요하다면 standard 유지 권장
    zfs set sync=standard datapool/images

    Scrub(스크럽, 데이터 무결성 검사) 자동화

    ZFS의 핵심 기능 중 하나가 스크럽이에요. 모든 데이터 블록을 읽어서 체크섬을 검증하는 작업인데, 주기적으로 해줘야 Silent Data Corruption을 조기에 발견할 수 있습니다.

    # 수동으로 스크럽 실행
    zpool scrub datapool
    
    # 스크럽 진행 상황 확인
    zpool status datapool
    
    # 자동 스크럽 설정 (Proxmox는 기본적으로 월 1회 cron 설정됨)
    # /etc/cron.d/zfsutils-linux 확인
    cat /etc/cron.d/zfsutils-linux
    
    # 직접 cron 설정 (매월 1일 새벽 2시)
    crontab -e
    # 아래 내용 추가:
    # 0 2 1 * * /sbin/zpool scrub datapool

    ⚠️ 실제로 겪은 문제들과 해결법

    문제 1: VM 성능이 생각보다 안 나온다

    ZFS를 처음 올렸을 때 “왜 이렇게 느리지?” 하는 경험을 많이들 하세요. 저도 그랬는데, 원인이 몇 가지 있더라고요.

    원인 및 해결책:

    1. ashift 설정 오류: zpool status -v로 확인. 이미 풀이 생성됐다면 재생성 외에는 방법이 없어요. 처음부터 ashift=12를 꼭 넣어주세요.
    2. ARC 부족: arcstat 명령으로 hit ratio 확인. 70% 이하면 ARC가 부족한 겁니다.
    3. recordsize 불일치: VM 워크로드에 따라 recordsize를 조정하세요. 랜덤 I/O가 많은 DB 워크로드는 작은 recordsize가 유리합니다.
    # ARC 히트율 확인
    arcstat 1 5
    
    # ZFS I/O 통계 모니터링
    zpool iostat -v datapool 2
    
    # 상세 ZFS 통계
    zfs-stats -a

    문제 2: 디스크 오류 발견 시 대응

    어느 날 아침에 zpool status를 실행했더니 DEGRADED 상태가 뜨는 경험을 한 적이 있습니다. 심장이 쿵 내려앉더라고요. 근데 ZFS가 있으니까 침착하게 대응할 수 있었어요.

    # 풀 상태 확인
    zpool status -v datapool
    
    # 오류 난 디스크 교체 후 resilvering(데이터 재동기화) 시작
    # 1. 오류 디스크 오프라인 처리
    zpool offline datapool /dev/disk/by-id/문제디스크_시리얼
    
    # 2. 물리적으로 디스크 교체 후 새 디스크 지정
    zpool replace datapool \
      /dev/disk/by-id/문제디스크_시리얼 \
      /dev/disk/by-id/새디스크_시리얼
    
    # 3. resilvering 진행 상황 확인
    zpool status datapool

    문제 3: 스냅샷이 쌓여서 공간이 부족해진다

    Proxmox 자동 백업 설정해 놓으면 스냅샷이 계속 쌓입니다. 어느 순간 “왜 공간이 이렇게 없지?” 하고 보면 스냅샷이 수십 개 쌓여 있는 경우가 있어요.

    # 스냅샷 목록 확인
    zfs list -t snapshot -o name,used,creation | sort -k3
    
    # 오래된 스냅샷 삭제
    zfs destroy datapool/images/vm-100-disk-0@2024-01-01
    
    # 특정 패턴의 스냅샷 일괄 삭제 (주의해서 사용!)
    zfs list -t snapshot -H -o name | grep 'vm-100' | xargs -n1 zfs destroy
    
    # Proxmox 백업 보존 정책 설정 (GUI 권장)
    # Datacenter > Backup > 해당 작업 편집 > Keep 설정
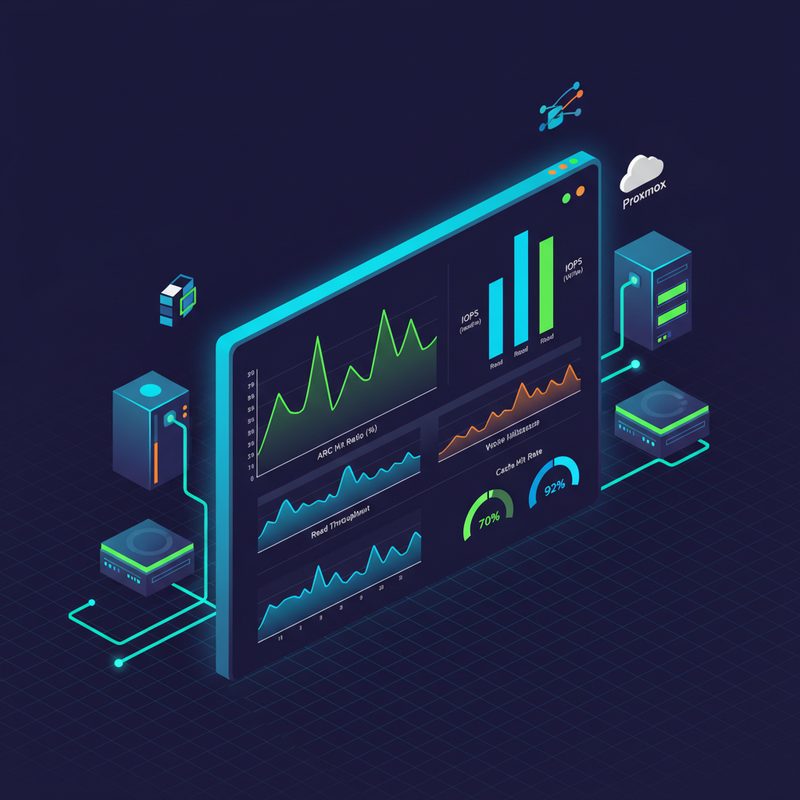
    ZFS ARC 히트율 및 스토리지 I/O 성능 모니터링 대시보드

    ▲ ZFS ARC 히트율과 풀 I/O 성능 모니터링 — arcstat 및 zpool iostat 출력 결과를 시각화한 예시입니다. 히트율 80% 이상을 목표로 합니다.

    ZFS 스토리지 상태 검증하기

    일상적인 헬스체크 루틴

    이 명령어들은 저도 주기적으로 확인하는 것들이에요. 습관처럼 만들어 두면 정말 든든합니다.

    # 전체 풀 상태 한눈에 보기
    zpool status
    
    # 풀 사용량 확인
    zpool list
    
    # 데이터셋별 사용량 (스냅샷 포함)
    zfs list -t all -o name,used,avail,refer,mountpoint
    
    # 압축 효율 확인
    zfs get compressratio datapool
    
    # 전체 ZFS 이벤트 로그 확인
    zpool events -v | tail -50

    성능 벤치마크 기준점 잡기

    최적화 전후를 비교하려면 기준점이 있어야 하죠. fio(Flexible I/O Tester)로 간단히 측정해 볼 수 있습니다.

    # fio 설치
    apt install fio
    
    # 순차 쓰기 테스트
    fio --name=seqwrite \
      --filename=/datapool/testfile \
      --rw=write \
      --bs=1M \
      --size=4G \
      --numjobs=1 \
      --ioengine=libaio \
      --direct=1 \
      --group_reporting
    
    # 랜덤 읽기 테스트 (4K 블록)
    fio --name=randread \
      --filename=/datapool/testfile \
      --rw=randread \
      --bs=4K \
      --size=4G \
      --numjobs=4 \
      --ioengine=libaio \
      --direct=1 \
      --group_reporting
    
    # 테스트 파일 정리
    rm /datapool/testfile

    정리: ZFS 최적화 체크리스트

    Proxmox VE ZFS 최적화 핵심 설정 체크리스트 요약 인포그래픽

    ▲ Proxmox VE ZFS 최적화 핵심 설정 요약 — 풀 생성부터 ARC 튜닝, 스크럽 자동화까지 단계별 체크리스트입니다.

    지금까지 다룬 내용을 정리해 보겠습니다. 처음엔 복잡해 보여도, 하나씩 따라가면 충분히 할 수 있어요.

    필수 설정 체크리스트

    • ✅ ashift=12 — 풀 생성 시 반드시 지정
    • ✅ compression=lz4 — 성능 영향 없이 공간 절약
    • ✅ atime=off — 불필요한 I/O 제거
    • ✅ ARC 크기 제한 — VM 메모리와 균형 맞추기
    • ✅ 정기 스크럽 — 월 1회 이상 실행
    • ✅ 디스크 ID 방식 사용 — 재부팅 후 안정성 확보
    • ✅ 스냅샷 보존 정책 — 디스크 공간 관리
    • ✅ SLOG 미러 구성 — SLOG 사용 시 필수

    자주 묻는 질문 (FAQ)

    Q. ZFS는 ECC 메모리가 없으면 위험한가요?
    A. ECC 메모리가 없어도 ZFS를 쓸 수 있습니다. 다만 메모리 오류로 인한 데이터 손상 가능성이 이론적으로 존재해요. 홈랩 수준에서는 크게 걱정 안 해도 되지만, 프로덕션 환경이라면 ECC를 권장합니다.

    Q. ZFS 풀 크기를 나중에 늘릴 수 있나요?
    A. 네, 가능합니다. 미러 풀은 동일한 크기의 디스크 쌍을 추가해서 확장할 수 있어요. RAID-Z는 같은 VDEV(가상 디바이스) 내에서 디스크 추가가 어렵고, 새 VDEV를 추가하는 방식으로 확장합니다.

    Q. 압축을 켜면 CPU 사용률이 많이 올라가나요?
    A. lz4 압축은 CPU 영향이 매우 적습니다. 요즘 프로세서에서는 거의 체감이 안 될 정도예요. 오히려 I/O 양이 줄어서 전체 성능이 올라가는 경우도 있어요.

    마무리하며

    Proxmox VE ZFS 조합은 한번 제대로 세팅해 두면 정말 든든합니다. 디스크 하나가 죽어도 침착하게 교체하고 resilvering 기다리면 되고, 실수로 VM 날려도 스냅샷에서 복구하면 되고. 처음 세팅이 좀 복잡해 보이지만, 그 이후의 편안함은 진짜 다르더라고요.

    물론 ZFS가 만능은 아닙니다. 메모리를 많이 먹고, 설정이 복잡하고, 한번 만든 풀 구조를 바꾸기 어렵다는 단점도 있어요. 그래도 데이터 안정성과 스냅샷 편의성을 생각하면, 홈랩에서 ZFS를 선택하지 않을 이유가 없다고 생각합니다.

    다음 글에서는 Proxmox VE의 백업 자동화와 원격 ZFS 복제(Replication)를 다뤄볼 예정이에요. 오늘 설정한 ZFS 풀을 활용해서 다른 서버로 데이터를 자동으로 복제하는 방법인데, 이것도 꽤 유용하더라고요. 기대해 주세요!

    궁금한 점이나 다른 삽질 경험이 있으시면 댓글로 공유해 주세요. 같이 해결해 봐요!

  • [K8s] 쿠버네티스 Ingress Controller 비교: Nginx, Traefik, Gateway API 선택 가이드

    [K8s] 쿠버네티스 Ingress Controller 비교: Nginx, Traefik, Gateway API 선택 가이드

    쿠버네티스 Ingress Controller, 뭘 써야 할지 모르겠다면?

    쿠버네티스(Kubernetes)를 처음 도입할 때 가장 많이 막히는 부분 중 하나가 바로 Ingress Controller(인그레스 컨트롤러) 선택이에요. 저도 처음엔 “Nginx 쓰면 되는 거 아닌가?” 하고 무심코 설치했다가, 나중에 Traefik이 더 편하다는 걸 알고 갈아엎은 경험이 있거든요. 그리고 최근엔 Gateway API라는 새로운 표준까지 등장해서 선택지가 더 복잡해졌습니다.

    이 글에서는 쿠버네티스 클러스터 운영에서 가장 중요한 선택 중 하나인 Ingress Controller의 세 가지 주요 선택지를 실제 운영 경험을 바탕으로 비교해 드릴게요. 홈랩부터 프로덕션까지 다양한 환경에서 직접 써본 입장에서 솔직하게 이야기해 보겠습니다.

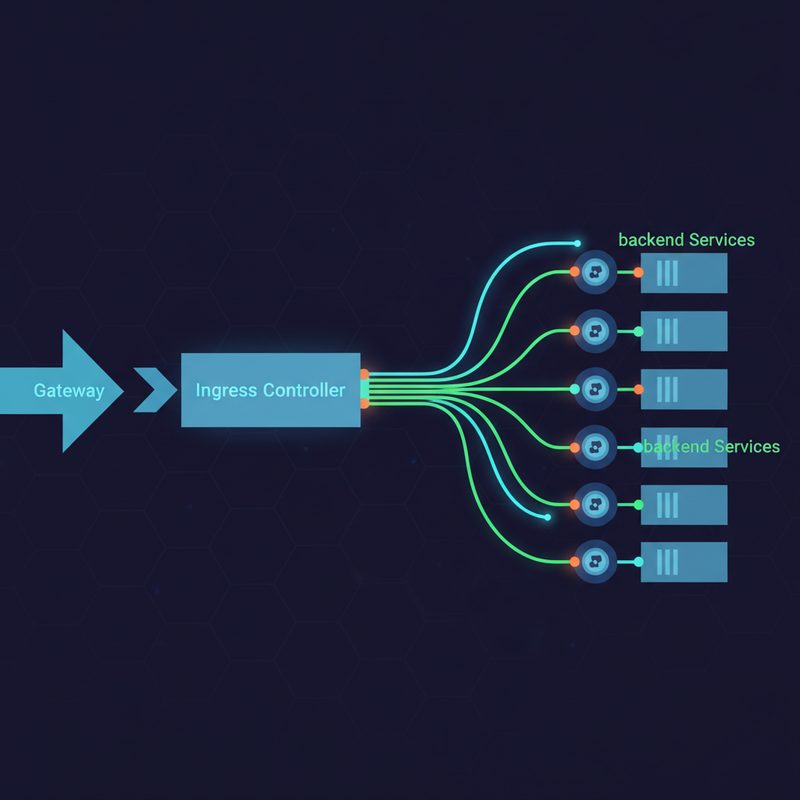
    쿠버네티스 Ingress Controller 전체 아키텍처 — 외부 트래픽이 인그레스 컨트롤러를 통해 내부 서비스로 라우팅되는 구조

    ▲ 쿠버네티스 클러스터에서 외부 트래픽이 Ingress Controller를 거쳐 내부 서비스로 전달되는 전체 흐름 다이어그램

    Ingress Controller가 뭔지부터 짚고 가자

    쉽게 말해서, Ingress(인그레스)는 외부에서 쿠버네티스 클러스터 안으로 들어오는 HTTP/HTTPS 트래픽을 어떻게 라우팅할지 정의하는 규칙이에요. 근데 이 규칙만 있다고 실제로 동작하는 게 아니에요. 규칙을 실제로 실행해 주는 주체가 바로 Ingress Controller(인그레스 컨트롤러)입니다.

    비유하자면, Ingress 리소스는 “1번 도메인은 A 서비스로, 2번 도메인은 B 서비스로 보내라”는 지시서고, Ingress Controller는 그 지시서를 읽고 실제로 트래픽을 처리하는 리버스 프록시(Reverse Proxy) 서버라고 보시면 됩니다.

    쿠버네티스 자체에는 Ingress Controller가 기본 내장되어 있지 않아요. 그래서 우리가 직접 선택해서 설치해야 합니다. 그리고 이 선택이 생각보다 중요한 결정이거든요.

    왜 선택이 중요한가요?

    • 운영 중에 교체하면 서비스 중단이 발생할 수 있어요
    • 각 컨트롤러마다 지원하는 기능과 설정 방식이 달라요
    • 팀의 기술 스택과 러닝 커브도 고려해야 합니다
    • 트래픽 규모와 패턴에 따라 성능 특성이 다르게 나타나요

    세 가지 선택지 한눈에 비교

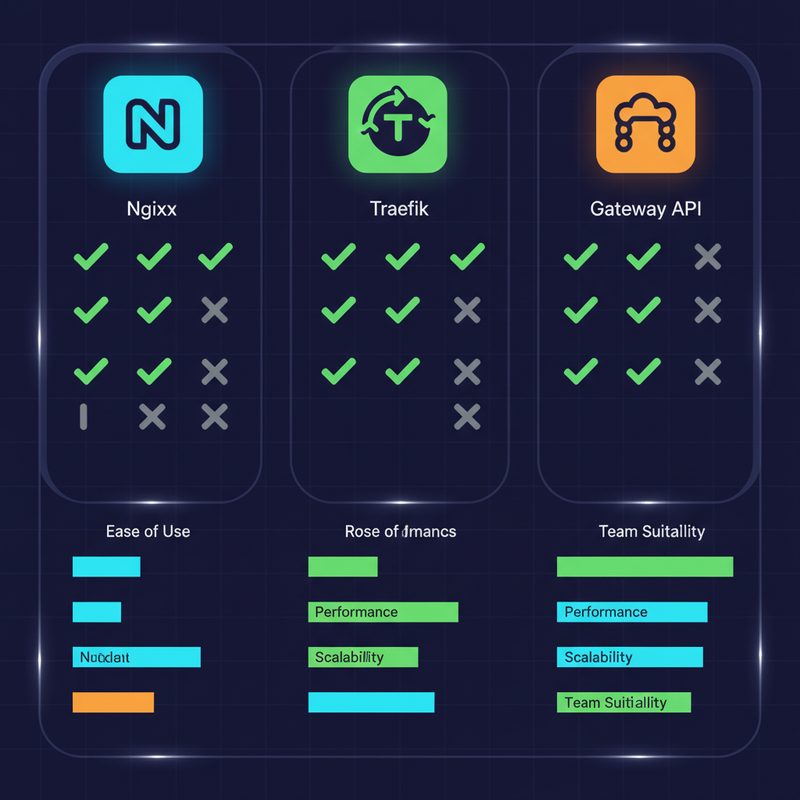
    본격적인 비교 전에 전체 그림을 먼저 보시죠.

    항목 Nginx Ingress Controller Traefik Gateway API
    기반 기술 Nginx (리버스 프록시) Go 기반 자체 구현 표준 API (구현체 별도)
    설정 방식 Ingress + Annotation Ingress + CRD Gateway/HTTPRoute CRD
    자동 설정 갱신 지원 (일부 재시작 필요) ✅ 완전 동적 구현체에 따라 다름
    대시보드 별도 설치 필요 ✅ 내장 없음 (구현체 의존)
    학습 난이도 낮음 (Nginx 경험자) 중간 높음
    성숙도 매우 높음 높음 성장 중 (GA 달성)
    멀티 팀 지원 제한적 중간 ✅ 설계 목표
    커뮤니티/레퍼런스 매우 풍부 풍부 성장 중

    Nginx Ingress Controller — 검증된 베테랑

    솔직히 말씀드리면, 저도 처음 쿠버네티스 클러스터 구성할 때 고민 없이 Nginx Ingress를 선택했어요. 이유는 단순했습니다. Nginx를 이미 10년 넘게 써왔으니까요.

    Nginx Ingress Controller는 CNCF(Cloud Native Computing Foundation) 산하 프로젝트인 kubernetes/ingress-nginx와, Nginx Inc.에서 만든 nginxinc/kubernetes-ingress 두 가지가 있어요. 헷갈리시는 분들이 많은데, 커뮤니티에서 주로 쓰는 건 전자인 ingress-nginx입니다.

    Helm으로 설치하기

    # Nginx Ingress Controller Helm 설치
    helm repo add ingress-nginx https://kubernetes.github.io/ingress-nginx
    helm repo update
    
    helm install ingress-nginx ingress-nginx/ingress-nginx \
      --namespace ingress-nginx \
      --create-namespace \
      --set controller.replicaCount=2

    기본 Ingress 리소스 예시

    apiVersion: networking.k8s.io/v1
    kind: Ingress
    metadata:
      name: my-app-ingress
      annotations:
        nginx.ingress.kubernetes.io/rewrite-target: /
        nginx.ingress.kubernetes.io/ssl-redirect: "true"
    spec:
      ingressClassName: nginx
      tls:
      - hosts:
        - myapp.example.com
        secretName: myapp-tls
      rules:
      - host: myapp.example.com
        http:
          paths:
          - path: /
            pathType: Prefix
            backend:
              service:
                name: my-app-service
                port:
                  number: 80

    Nginx Ingress의 장단점

    ✅ 장점

    • 레퍼런스가 압도적으로 많아요. 구글에서 뭐든 찾을 수 있습니다
    • Nginx에 익숙한 분들은 Annotation으로 세밀한 튜닝이 가능해요
    • 안정성이 검증된 오랜 역사를 가지고 있습니다
    • 대규모 트래픽 처리에 강점이 있어요

    ⚠️ 단점

    • 설정 변경 시 nginx.conf를 reload해야 해서, 대규모 클러스터에선 부담이 될 수 있어요
    • Annotation이 너무 많아서 처음엔 뭘 써야 할지 헷갈립니다
    • 내장 대시보드가 없어서 별도로 Prometheus + Grafana를 구성해야 해요

    Traefik — 쿠버네티스 네이티브의 매력

    Traefik을 처음 접한 건 홈랩에서 Docker Compose로 운영하다가였어요. 당시에 “이거 레이블(Label) 하나 달면 자동으로 라우팅이 된다고?” 하면서 신기해했던 기억이 납니다. 쿠버네티스에서도 비슷한 경험을 할 수 있어요.

    Traefik의 핵심 철학은 동적 설정(Dynamic Configuration)이에요. 새로운 서비스가 배포되면 자동으로 감지해서 라우팅 규칙을 업데이트합니다. Nginx처럼 reload가 없어요.

    Traefik Helm 설치

    # Traefik Helm 설치
    helm repo add traefik https://helm.traefik.io/traefik
    helm repo update
    
    helm install traefik traefik/traefik \
      --namespace traefik \
      --create-namespace \
      --set dashboard.enabled=true \
      --set ingressRoute.dashboard.enabled=true

    Traefik IngressRoute CRD 예시

    Traefik은 표준 Ingress 리소스도 지원하지만, 자체 CRD인 IngressRoute를 쓰면 훨씬 풍부한 기능을 쓸 수 있어요.

    apiVersion: traefik.io/v1alpha1
    kind: IngressRoute
    metadata:
      name: my-app-ingressroute
      namespace: default
    spec:
      entryPoints:
        - websecure
      routes:
        - match: Host(`myapp.example.com`)
          kind: Rule
          services:
            - name: my-app-service
              port: 80
          middlewares:
            - name: my-ratelimit
      tls:
        certResolver: letsencrypt

    Middleware로 Rate Limiting 적용

    apiVersion: traefik.io/v1alpha1
    kind: Middleware
    metadata:
      name: my-ratelimit
    spec:
      rateLimit:
        average: 100
        burst: 50

    💡 Traefik의 진짜 강점은 Let’s Encrypt 인증서 자동 발급이 내장되어 있다는 거예요. cert-manager를 별도로 설치하지 않아도 TLS 인증서를 자동으로 관리해 줍니다. 홈랩에서 이거 하나 때문에 Traefik으로 갈아탔을 정도로 편하더라고요.

    Traefik 내장 대시보드 화면 — 라우터, 서비스, 미들웨어 현황을 한눈에 확인하는 모니터링 인터페이스

    ▲ Traefik 내장 대시보드에서 라우터, 서비스, 미들웨어 현황을 한눈에 확인할 수 있는 화면

    Traefik의 장단점

    ✅ 장점

    • 동적 설정 갱신 — 서비스 변경 시 reload 없이 즉시 반영돼요
    • 내장 대시보드로 라우팅 현황을 바로 확인할 수 있어요
    • Let’s Encrypt 자동 인증서 발급/갱신 내장
    • Middleware로 인증, Rate Limiting, 헤더 조작 등을 깔끔하게 구성 가능

    ⚠️ 단점

    • CRD 방식이 Nginx Annotation과 달라서 러닝 커브가 있어요
    • Nginx에 비해 레퍼런스가 적습니다 (그래도 요즘은 많이 늘었어요)
    • 초대형 클러스터에서의 성능 검증 사례가 Nginx보다 적은 편이에요

    Gateway API — 쿠버네티스 네트워크의 미래

    처음 Gateway API 문서를 읽었을 때 솔직히 “이게 뭐가 다른 건데?” 싶었어요. 근데 알고 보니 기존 Ingress 리소스의 한계를 근본적으로 해결하려는 시도더라고요.

    Gateway API는 SIG Network(쿠버네티스 네트워킹 특별관심그룹)에서 만든 공식 표준이에요. 2023년에 v1.0으로 GA(Generally Available, 정식 출시)를 달성했습니다. Ingress 리소스를 대체하려는 게 아니라, 더 표현력 있고 역할 기반으로 분리된 네트워크 설정을 가능하게 하는 게 목표예요.

    Gateway API의 핵심 개념

    기존 Ingress는 개발자와 인프라 관리자가 같은 리소스를 수정해야 했어요. Gateway API는 역할을 명확히 분리합니다.

    • GatewayClass: 인프라 제공자가 정의 (“이 구현체를 쓸게”)
    • Gateway: 클러스터 운영자가 정의 (“이 포트, 이 프로토콜로 받을게”)
    • HTTPRoute: 개발자가 정의 (“이 경로는 내 서비스로 보내줘”)

    Gateway API 설치 (CRD 먼저)

    # Gateway API CRD 설치
    kubectl apply -f https://github.com/kubernetes-sigs/gateway-api/releases/download/v1.1.0/standard-install.yaml
    
    # 구현체 예시: Nginx Gateway Fabric
    helm install ngf oci://ghcr.io/nginxinc/charts/nginx-gateway-fabric \
      --namespace nginx-gateway \
      --create-namespace

    Gateway와 HTTPRoute 설정 예시

    # Gateway 리소스 (운영자가 관리)
    apiVersion: gateway.networking.k8s.io/v1
    kind: Gateway
    metadata:
      name: main-gateway
      namespace: infra
    spec:
      gatewayClassName: nginx
      listeners:
      - name: https
        port: 443
        protocol: HTTPS
        tls:
          mode: Terminate
          certificateRefs:
          - name: main-tls-cert
        allowedRoutes:
          namespaces:
            from: Selector
            selector:
              matchLabels:
                gateway-access: allowed
    # HTTPRoute 리소스 (개발자가 관리)
    apiVersion: gateway.networking.k8s.io/v1
    kind: HTTPRoute
    metadata:
      name: my-app-route
      namespace: my-app-ns
    spec:
      parentRefs:
      - name: main-gateway
        namespace: infra
      hostnames:
      - myapp.example.com
      rules:
      - matches:
        - path:
            type: PathPrefix
            value: /api
        backendRefs:
        - name: api-service
          port: 8080
      - matches:
        - path:
            type: PathPrefix
            value: /
        backendRefs:
        - name: frontend-service
          port: 3000

    보이시나요? Gateway는 인프라팀이 관리하고, HTTPRoute는 각 개발팀이 자기 네임스페이스에서 독립적으로 관리할 수 있어요. 멀티 팀 환경에서 진짜 강력한 구조입니다.

    Gateway API의 장단점

    ✅ 장점

    • 역할 기반 분리로 멀티 팀 환경에 최적화되어 있어요
    • 표현력이 풍부해서 복잡한 라우팅 규칙도 명확하게 표현 가능
    • 쿠버네티스 공식 표준이라 장기적으로 생태계 지원이 확대될 거예요
    • 구현체를 교체해도 HTTPRoute 설정은 그대로 재사용 가능 (이식성)

    ⚠️ 단점

    • 개념이 많아서 처음 배우기가 쉽지 않아요. 저도 꽤 헷갈렸습니다
    • 구현체마다 지원하는 기능이 달라서 사전 확인이 필요해요
    • 소규모 팀이나 단순한 환경에선 오버엔지니어링이 될 수 있어요
    • 레퍼런스와 사례가 아직 Nginx/Traefik에 비해 적습니다

    ⚠️ 실제 트러블슈팅 경험담

    각 컨트롤러를 쓰면서 제가 직접 겪은 문제들을 공유할게요.

    Nginx Ingress — 413 Request Entity Too Large

    파일 업로드 기능이 있는 서비스에서 자꾸 413 에러가 났었어요. Nginx 기본 설정의 client_max_body_size 제한 때문이었는데, Annotation으로 해결했습니다.

    metadata:
      annotations:
        nginx.ingress.kubernetes.io/proxy-body-size: "50m"

    Traefik — 인증서가 갱신 안 되는 문제

    Let’s Encrypt 인증서를 Traefik이 자동으로 갱신해 주는 게 편한데, 어느 날 갑자기 인증서 만료 알림이 왔어요. 알고 보니 acme.json 파일이 저장된 PersistentVolume이 Pod 재시작 시 초기화되는 문제였습니다. acme.json은 반드시 영구 스토리지에 마운트해야 해요.

    # values.yaml에서 persistence 설정
    persistence:
      enabled: true
      storageClass: "longhorn"
      size: 128Mi

    Gateway API — 구현체 호환성 확인 필수

    HTTPRoute의 고급 기능(예: RequestRedirect, URLRewrite)을 사용했는데, 특정 구현체에서 지원하지 않아서 라우팅이 묵묵히 실패하는 경우가 있었어요. 구현체의 Conformance Report(적합성 보고서)를 미리 확인하는 게 중요합니다. Gateway API 공식 문서에서 구현체별 지원 기능표를 제공하고 있어요.

    쿠버네티스 Ingress Controller 모니터링 대시보드 — Prometheus와 Grafana를 활용한 요청 수, 에러율, 레이턴시 시각화

    ▲ Prometheus와 Grafana를 활용한 Ingress Controller 모니터링 대시보드 — 요청 수, 에러율, 레이턴시를 실시간으로 확인

    상황별 선택 가이드

    “그래서 뭘 써야 하나요?” 라고 물어보신다면, 상황에 따라 다르다고 답할 수밖에 없어요. 하지만 경험상 이런 기준으로 선택하시면 크게 후회는 없더라고요.

    Nginx Ingress Controller를 선택하세요, 만약…

    • 팀에 Nginx 경험자가 있고, 레퍼런스가 많은 안정적인 선택을 원할 때
    • 대규모 트래픽을 처리해야 하고 검증된 성능이 필요할 때
    • 기존 Nginx 설정을 쿠버네티스로 마이그레이션할 때
    • 복잡한 Nginx 설정(custom snippet 등)이 필요할 때

    Traefik을 선택하세요, 만약…

    • 홈랩이나 소규모 환경에서 편리하게 운영하고 싶을 때
    • Let’s Encrypt 자동 인증서 관리를 간단하게 하고 싶을 때
    • 내장 대시보드로 라우팅 현황을 빠르게 파악하고 싶을 때
    • 동적 환경에서 서비스 변경이 잦을 때

    Gateway API를 선택하세요, 만약…

    • 여러 팀이 각자의 라우팅 설정을 독립적으로 관리해야 할 때
    • 장기적으로 쿠버네티스 표준에 맞춰 가고 싶을 때
    • 복잡한 트래픽 분산(카나리 배포, A/B 테스트 등)이 필요할 때
    • 구현체 이식성을 확보하고 싶을 때
    쿠버네티스 Ingress Controller 비교 인포그래픽 — Nginx Ingress, Traefik, Gateway API 특징과 선택 기준 요약

    ▲ 환경과 요구사항에 따른 Ingress Controller 선택 가이드 요약 인포그래픽

    마무리 — 정답은 없지만, 기준은 있다

    13년 동안 인프라를 운영하면서 느낀 건, 기술 선택에 절대적인 정답은 없다는 거예요. 중요한 건 내 환경과 팀의 요구사항에 맞는 선택을 하는 겁니다.

    개인적으로는 이렇게 정리하고 싶어요.

    • 처음 시작하는 분들: Nginx Ingress로 시작하세요. 레퍼런스가 많아서 막힐 때 찾기 쉬워요
    • 홈랩이나 소규모 팀: Traefik을 강력 추천합니다. 편의성이 정말 좋아요
    • 엔터프라이즈/멀티 팀 환경: Gateway API를 진지하게 검토해 보세요. 미래 방향성이 여기 있거든요

    그리고 하나 더 — 저는 지금 홈랩에서 Traefik을 쓰고, 회사 프로덕션에서는 Nginx Ingress를 씁니다. 두 개 다 쓸 줄 알면 더 좋아요. 😄

    다음 글에서는 Traefik의 Middleware를 활용한 인증/인가(Authentication/Authorization) 설정을 더 자세히 다룰 예정이에요. cert-manager를 이용한 TLS 자동화 내용도 이전 글에서 다룬 적 있으니 참고해 보세요.

    자주 묻는 질문 (FAQ)

    Q. Nginx Ingress Controller와 Nginx Gateway Fabric은 다른 건가요?

    네, 다릅니다. ingress-nginx는 기존 Ingress API 기반이고, Nginx Gateway Fabric은 Gateway API 표준의 구현체예요. 용도와 설정 방식이 다릅니다.

    Q. 하나의 클러스터에 여러 Ingress Controller를 동시에 쓸 수 있나요?

    가능합니다. ingressClassName을 통해 어떤 컨트롤러를 사용할지 지정할 수 있어요. 다만 운영 복잡도가 올라가니 꼭 필요한 경우에만 권장합니다.

    Q. Gateway API는 Ingress를 완전히 대체하나요?

    장기적으로는 그 방향이지만, 현재는 공존하는 상태예요. 기존 Ingress 리소스가 deprecated되지는 않았고, Gateway API가 더 복잡한 요구사항을 위한 차세대 표준으로 자리잡고 있는 중입니다.