13년차의 서버실

서버, 인프라, 홈랩 기술 블로그

[카테고리:] ai

  • [AI] MCP 솔루션 비교: AI 에이전트 통합 기준

    [AI] MCP 솔루션 비교: AI 에이전트 통합 기준

    MCP 솔루션 비교: AI 에이전트 통합 기준

    MCP 솔루션 비교를 제대로 하려면 제품명부터 보시는 것보다, 권한이 어디에서 행사되고 장애가 어느 층에서 터지며 누가 로그를 볼 수 있는지부터 잡는 편이 훨씬 덜 헷갈립니다. 저도 몇 번 붙여보니 이건 단순 기능 비교라기보다 책임 경계를 어디에 두느냐를 고르는 문제에 더 가깝더라고요. 같은 Tool 호출이어도 로컬 stdio인지, 원격 Streamable HTTP인지, 아니면 OpenAI Responses API 같은 플랫폼이 원격 MCP 서버 호출을 중개하는지에 따라 운영 난이도와 사고 방식이 꽤 달라집니다.

    처음 붙일 때 자주 놓치는 포인트도 있습니다. MCP는 도구를 보기 좋게 나열하는 포맷이 아니라, 모델이 외부 시스템을 건드릴 때 생기는 책임 경계를 분리하는 표준에 가깝습니다. 그래서 저는 기능 목록보다 실행 위치, 전송 방식, 승인 흐름, 로그 위치를 먼저 봅니다. 이 순서를 바꾸면 PoC는 빨리 끝나도 운영 전환에서 다시 돌아오게 되는 경우가 많았습니다.
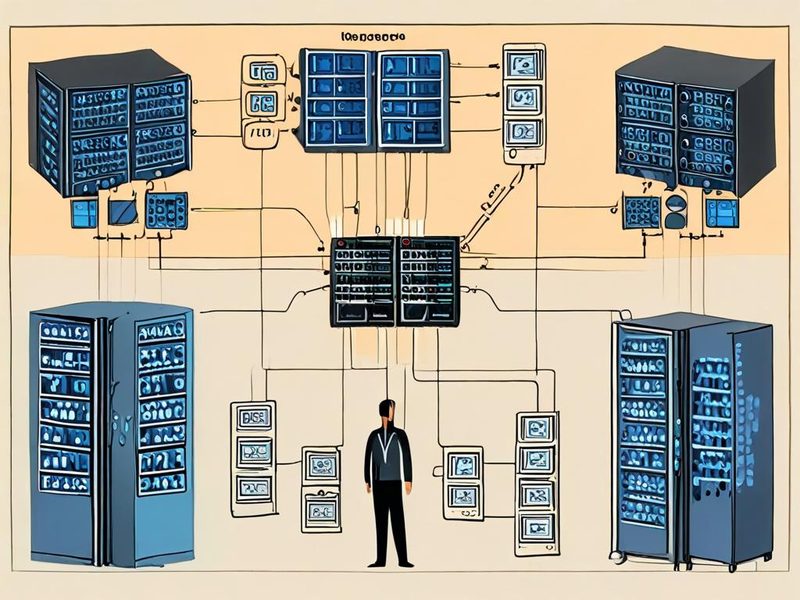
    MCP 솔루션 비교를 위한 호스트 클라이언트 서버 아키텍처 다이어그램

    Host, Client, Server의 역할과 stdio, HTTP 경로가 한눈에 보이는 아키텍처 개요입니다.

    1. MCP 표준, 실무에서는 어떻게 이해하면 편한가

    공식 정의를 길게 외울 필요는 없습니다. 실무에서는 MCP를 LLM용 제어면(control plane)처럼 이해하면 편합니다. 모델이 파일시스템, 티켓 시스템, 사내 API를 제각각 이해하는 대신, Host가 필요한 컨텍스트만 골라 Server에 연결하고, Server는 Tool, Resource, Prompt를 같은 규약으로 노출하거든요.

    • Host: 사용자가 실제로 대화하는 앱입니다. 어떤 서버를 연결할지, 어떤 호출을 승인할지, 세션을 얼마나 유지할지를 관리합니다.
    • Client: Host 안에서 특정 MCP 서버와 통신하는 연결 계층입니다. transport별 제약을 가장 많이 받는 곳이기도 합니다.
    • Server: Tool, Resource, Prompt를 공개하는 쪽입니다. 외부 API, 파일, DB, 런북 같은 실제 자산은 여기 뒤에 숨어 있습니다.

    여기서 제가 중요하게 보는 포인트는 서버가 대화를 통째로 소유하지 않는다는 점입니다. Host가 필요한 맥락만 전달하니 보안 검토 문서도 훨씬 단순해집니다. 반대로 말하면, 도구는 잘 뜨는데 모델이 기대만큼 못 쓰는 문제는 서버 기능 부족보다 Host가 어떤 문맥을 전달했는지에서 터지는 경우가 많습니다.

    2. MCP 솔루션 비교를 할 때 먼저 자르는 기준

    저는 MCP 솔루션 비교를 할 때 제품명보다 아래 다섯 가지 기준으로 먼저 자릅니다. 이 기준이 있어야 선택이 흔들리지 않더라고요.

    1. 권한이 있는 곳: 로컬 파일, SSH, 브라우저 쿠키처럼 사용자 장치에 붙어야 하는지, 아니면 서버 측 토큰으로 충분한지
    2. 장애가 터지는 층: stdio는 프로세스 실행, 환경 변수, 경로 문제로, HTTP는 Host, Origin, CORS, 프록시 문제로 주로 막힙니다
    3. 승인 단위: 도구별로 사람 승인 흐름을 넣을지, 읽기 전용만 자동 허용할지, 쓰기 작업은 별도 게이트를 둘지
    4. 운영 형태: 1인 실험인지, 팀 공용인지, 다중 테넌트 서비스인지
    5. 관측 가능성: 실패 시 어디 로그를 보면 되는지, 4xx/5xx와 프로토콜 오류를 분리해 볼 수 있는지

    이 기준으로 보면 중요한 사실이 하나 보입니다. transport 선택은 곧 장애 도메인 선택이라는 점입니다. stdio는 네트워크가 단순한 대신 실행 환경에 묶이고, Streamable HTTP는 배포가 쉬운 대신 네트워크 정책과 브라우저 보안 규칙을 피할 수 없습니다. 그래서 개인 자동화와 운영형 에이전트를 같은 잣대로 비교하면 계속 답이 엇갈립니다.

    3. 한눈에 보는 MCP 솔루션 비교 표

    구분 대표 형태 권한이 놓이는 위치 잘 맞는 상황 강점 주의할 점 제가 권하는 선택
    Local stdio 호스트가 로컬 프로세스를 직접 실행 사용자 PC 개인 생산성, 홈랩, 사내 PoC, 로컬 파일 접근 설정이 단순하고 디버깅 시작점이 명확합니다 OS 경로, 실행기 설치, stdout 오염 같은 로컬 환경 이슈에 취약합니다 첫 검증은 여기서 시작하는 편이 가장 덜 헤맵니다
    Streamable HTTP ASGI/HTTP 서버가 MCP 엔드포인트 제공 중앙 서버 또는 사내 네트워크 팀 공유 도구, 서비스형 에이전트, 중앙 인증/감사 배포, 인증, 회수, 로깅, 공용 운영에 유리합니다 Host/Origin allowlist, CORS, 프록시, 헤더 전달을 같이 설계해야 합니다 운영을 전제로 한다면 기본 선택지입니다
    OpenAI 원격 MCP 연동 Responses API 같은 플랫폼이 원격 MCP 서버 연결을 중개 원격 MCP 서버와 플랫폼 사이 외부 SaaS 도구를 빠르게 붙이는 실험, 플랫폼 중심 에이전트 애플리케이션이 MCP 왕복을 전부 직접 구현하지 않아도 됩니다 공개 도달성, 인증 헤더, 허용 도구 필터, 승인 정책을 더 엄격히 봐야 합니다 OpenAI 중심 스택이라면 검토 가치가 큽니다
    HTTP with SSE 기존 SSE + 별도 메시지 경로 원격 서버 이미 돌아가는 구형 구현 유지 레거시 이전 비용을 당장 줄일 수 있습니다 최신 표준 기준으로는 Streamable HTTP보다 신규 구축 이점이 적습니다 새로 만들 때 출발점으로 잡지는 않는 편이 낫습니다

    이 표에서 핵심은 무엇이 더 최신이냐보다 어떤 권한을 어디로 옮길 수 있느냐입니다. 예를 들어 로컬 파일 읽기와 사내 VPN 뒤 API 호출이 핵심인 도구를 원격 MCP 중심으로 밀어 넣으면, 연결보다 권한 설계부터 꼬이기 쉽습니다. 반대로 팀 전체가 쓰는 CRM 조회 도구를 stdio로 고집하면 배포보다 사용자 환경 지원이 더 커지더라고요.

    4. MCP 솔루션 비교 실전 1: 로컬 stdio 방식부터 붙여보기

    처음에는 로컬 stdio가 가장 낫습니다. 이유는 단순합니다. 실패 원인을 네트워크에서 찾지 않아도 되기 때문입니다. stdio가 먼저 되면 툴 스키마, 반환 형식, 예외 처리, 로그 분리 같은 핵심 계약부터 검증할 수 있습니다. 저도 보통 이 단계에서 도구 설명과 입력 스키마를 다듬고, 그다음에만 HTTP로 올립니다.

    4-1. Python SDK v2로 최소 서버 만들기

    공식 Python SDK 문서 기준으로 현재 안정 라인은 v2이고, 고수준 서버 클래스는 MCPServer입니다. 아래 예제는 그대로 server.py에 저장해 Inspector에서 바로 확인할 수 있는 형태입니다.

    uv init mcp-ops-demo
    cd mcp-ops-demo
    uv add "mcp[cli]"
    uv run mcp dev server.py
    from mcp.server import MCPServer
    
    mcp = MCPServer("Ops Helper")
    
    
    @mcp.tool()
    def tail_log(path: str, lines: int = 100) -> str:
        """Return the last N lines from a text log file."""
        with open(path, "r", encoding="utf-8") as f:
            return "".join(f.readlines()[-lines:])
    
    
    @mcp.resource("runbook://incident/network")
    def network_runbook() -> str:
        return "1. Check ingress status\n2. Check upstream health\n3. Verify DNS and TLS"
    
    
    if __name__ == "__main__":
        mcp.run()

    여기서 실무 포인트는 세 가지입니다. 첫째, uv run mcp dev server.py는 서버를 띄우고 Inspector로 바로 이어지는 가장 빠른 검증 루프입니다. 둘째, 공식 문서 기준으로 Inspector는 Node.js 앱이라 mcp dev를 쓰려면 PATH에 npx가 있어야 하고, 최신 Inspector는 Node 22.19 이상 환경을 권장합니다. 셋째, Tool과 Resource를 섞어 두면 운영 문서와 실행 코드를 분리할 수 있어 모델이 긴 문서를 매번 Tool 호출로 읽어오는 비효율을 줄이기 좋습니다. 이거 실제로 꽤 편합니다.

    4-2. stdio에서 자주 터지는 실패 모드

    stdio는 단순하지만 실패 모드는 꽤 인간적입니다. 제가 가장 자주 본 건 아래 셋입니다.

    • 실행 파일을 찾지 못함: npx, uv, python 경로가 호스트가 기대한 PATH와 다릅니다.
    • stdout 오염: 디버그 로그를 print()로 찍어서 JSON-RPC 프레이밍을 깨뜨립니다.
    • 허용 경로 과다: 파일시스템 서버에 홈 디렉터리 전체를 열어두고 나중에 권한 설명을 못 합니다.

    특히 두 번째는 정말 자주 나옵니다. stdio에서는 stdout이 곧 프로토콜 채널이라 사람이 보기 좋은 로그 한 줄이 연결을 깨뜨릴 수 있습니다. 로그는 stderr나 표준 로거로 보내는 편이 안전합니다.

    4-3. Claude Desktop 계열 로컬 설정 예시

    로컬 프로세스를 띄우는 호스트에서는 설정 파일에 명령과 인자를 명시합니다. 아래처럼 절대 경로만 허용해 두면 권한 설명이 훨씬 쉬워집니다.

    {
      "mcpServers": {
        "filesystem": {
          "command": "npx",
          "args": [
            "-y",
            "@modelcontextprotocol/server-filesystem",
            "/Users/username/Desktop",
            "/Users/username/Downloads"
          ]
        }
      }
    }

    제가 권하는 방식은 명확합니다. 처음부터 필요한 디렉터리만 노출하세요. 나중에 범위를 줄이는 건 생각보다 어렵습니다. 모델 성능보다 권한 범위가 먼저 사고를 만듭니다.

    로컬 프로세스를 실행하는 호스트, 설정 파일, 파일시스템 서버의 연결 흐름을 보여주는 그림입니다.

    5. MCP 솔루션 비교 실전 2: Streamable HTTP로 운영형 구조 만들기

    여러 사용자가 같은 도구를 쓰고, 인증 토큰을 서버에서 통제하고, 배포 파이프라인에 묶고 싶다면 결국 Streamable HTTP로 갑니다. 여기서부터는 도구가 보이느냐보다 브라우저, 프록시, 로드밸런서가 이 트래픽을 어떻게 취급하느냐가 더 중요해집니다.

    5-1. 최소 서버와 권장 옵션

    공식 Python SDK 문서 기준으로 production 성격의 Streamable HTTP에서는 stateless_http=True와 json_response=True를 우선 검토할 만합니다. 다만 이 조합이 만능은 아닙니다.

    from mcp.server import MCPServer
    
    mcp = MCPServer("Notes")
    
    
    @mcp.tool()
    def add_note(text: str) -> str:
        return f"Saved: {text}"
    
    
    if __name__ == "__main__":
        mcp.run(
            transport="streamable-http",
            host="127.0.0.1",
            port=8000,
            streamable_http_path="/mcp",
            json_response=True,
            stateless_http=True,
        )
    uv run server.py
    npx -y @modelcontextprotocol/inspector --server-url http://127.0.0.1:8000/mcp --transport http

    json_response=True는 각 POST 요청에 대해 단일 JSON 바디로 응답하게 만들어 운영과 프록시 처리가 단순해집니다. 대신 공식 문서가 설명하듯 이 옵션과 stateless_http=True는 서버에서 클라이언트로 되묻는 back-channel 기능을 제한합니다. 그래서 읽기 전용 조회형 도구가 많으면 편하지만, 인간 승인이나 중간 상호작용이 많은 워크플로라면 다시 따져봐야 합니다.

    5-2. 운영에서 가장 많이 막히는 지점: Host/Origin allowlist

    이 부분은 정말 중요합니다. 공식 Python SDK 문서 기준으로 streamable_http_app()와 관련 런타임은 localhost가 아닌 실제 호스트명 뒤에 배포할 때 transport_security 설정을 같이 보지 않으면 요청이 막힐 수 있습니다. 겉으로는 서버가 멀쩡히 떠 있는데도 아무 일도 안 된 것처럼 보여서 더 헷갈립니다.

    증상은 대개 이렇습니다.

    • 421 Misdirected Request: Host 헤더가 allowlist에 없습니다.
    • 403 Forbidden: 브라우저가 보낸 Origin 헤더가 allowlist에 없습니다.

    즉, 앱 코드가 아니라 전송 보안 설정이 먼저 요청을 거절하는 겁니다. 이걸 모르면 서버 코드를 한참 뒤집게 됩니다.

    from collections.abc import AsyncIterator
    from contextlib import asynccontextmanager
    
    from starlette.applications import Starlette
    from starlette.middleware import Middleware
    from starlette.middleware.cors import CORSMiddleware
    from starlette.routing import Mount
    
    from mcp.server import MCPServer
    from mcp.server.transport_security import TransportSecuritySettings
    
    mcp = MCPServer("Notes")
    
    
    @mcp.tool()
    def add_note(text: str) -> str:
        return f"Saved: {text}"
    
    
    @asynccontextmanager
    async def lifespan(app: Starlette) -> AsyncIterator[None]:
        async with mcp.session_manager.run():
            yield
    
    
    security = TransportSecuritySettings(
        allowed_hosts=["mcp.example.com", "mcp.example.com:*"] ,
        allowed_origins=["https://app.example.com"],
    )
    
    app = Starlette(
        routes=[Mount("/", app=mcp.streamable_http_app(transport_security=security))],
        middleware=[
            Middleware(
                CORSMiddleware,
                allow_origins=["https://app.example.com"],
                allow_methods=["GET", "POST", "DELETE"],
                allow_headers=[
                    "Authorization",
                    "Content-Type",
                    "Last-Event-ID",
                    "Mcp-Method",
                    "Mcp-Name",
                    "Mcp-Protocol-Version",
                    "Mcp-Session-Id",
                ],
                expose_headers=["Mcp-Session-Id"],
            )
        ],
        lifespan=lifespan,
    )

    브라우저 클라이언트가 붙는다면 allow_headers와 expose_headers를 빼먹지 마세요. 실무에서는 이게 더 자주 문제를 만듭니다. 브라우저는 preflight에서 허용받지 못한 Mcp-* 헤더를 아예 보내지 않거든요. 그러면 서버 로그를 보기 전까지는 왜 초기화가 안 되지 하는 상태만 남습니다.

    5-3. Streamable HTTP를 언제 쓰지 말아야 하나

    중앙 운영이 필요 없고 로컬 파일 접근이나 사용자 장치 상태가 핵심이면 굳이 HTTP를 먼저 고르지 않는 편이 낫습니다. 예를 들어 개발자 개인 PC의 로그 파일, SSH 키, 로컬 Docker 소켓을 건드리는 도구라면 HTTP 서버화하는 순간 권한 전달 방식이 더 복잡해집니다. 이때는 stdio가 더 안전하고 설명 가능성도 높습니다.

    6. 실전 구현 3: OpenAI 원격 MCP 연동

    OpenAI Responses API처럼 원격 MCP 서버 도구를 붙일 수 있는 플랫폼을 쓰면 애플리케이션 코드가 MCP 세부 통신을 전부 직접 처리하지 않아도 됩니다. 이 방식의 장점은 연결 속도이고, 단점은 권한을 플랫폼과 원격 서버 경계에서 다시 설계해야 한다는 점입니다.

    response = client.responses.create(
        model="gpt-4.1",
        tools=[{
            "type": "mcp",
            "server_label": "shopify",
            "server_url": "https://example.com/mcp",
            "allowed_tools": ["list_products", "get_product"],
            "require_approval": {
                "always": {"tool_names": ["create_order"]},
                "never": {"read_only": True}
            }
        }],
        input="List the available tools and summarize what each one does."
    )

    이 구성이 실무적으로 의미 있는 이유는 두 가지입니다. 첫째, allowed_tools로 노출 면적을 줄일 수 있습니다. 둘째, require_approval로 읽기와 쓰기 도구를 분리해 승인 정책을 다르게 둘 수 있습니다. 저는 외부 SaaS 연동에서 이 두 값을 거의 필수처럼 봅니다. 연결은 됐는데 왠지 무섭다는 느낌이 들 때가 있는데, 대부분 이 필터가 비어 있더라고요.

    다만 이 방식은 아무 상황에나 맞지는 않습니다. 원격에서 접근 가능한 MCP 서버가 있어야 하고, 내부망 전용 리소스나 사용자 로컬 자산을 만질 때는 자연스럽지 않습니다. 공개 접근성, 인증 토큰 주입, 서버 신뢰성, 데이터 경로 설명 가능성까지 감수할 수 있을 때 쓰는 게 맞습니다.

    7. 많이 겪는 문제와 트러블슈팅

    이 섹션은 문서 재포장보다 실제로 시간을 많이 잡아먹는 문제를 원인 중심으로 정리한 것입니다. MCP는 겉으로는 툴이 안 뜬다로 보이지만 실제 원인은 층마다 꽤 다릅니다.

    7-1. 서버는 떴는데 도구가 안 보일 때

    • stdio라면: 설정 JSON 문법, 실행 경로, 환경 변수, 프로세스 즉시 종료 여부를 먼저 봅니다.
    • HTTP라면: 서버 코드보다 엔드포인트 경로, Host/Origin 거부, CORS preflight 실패를 먼저 봅니다.
    • OpenAI 원격 MCP 연동이라면: 노출된 도구가 allowed_tools에 걸러진 건 아닌지, 인증 헤더가 실제로 전달되는지 확인합니다.
    npx -y @modelcontextprotocol/server-filesystem /Users/username/Desktop /Users/username/Downloads
    uv run server.py
    curl -i http://127.0.0.1:8000/mcp

    여기서 curl은 프로토콜 검증 도구라기보다 HTTP 레벨에서 막히는지 확인하는 1차 체크입니다. 421이나 403이 보이면 MCP 메시지 이전 단계에서 막히는 겁니다. 이럴 때는 서버 핸들러보다 allowlist와 프록시 설정을 먼저 봐야 합니다.

    7-2. stdout에 로그를 찍어서 프로토콜이 깨질 때

    stdio에서는 이게 가장 흔한 근본 원인입니다. 서버 개발자가 보기 편하라고 print("start") 한 줄 넣었는데, Host 입장에서는 유효하지 않은 MCP 메시지 한 줄이 끼어든 셈입니다. 증상은 보통 연결 실패, 초기화 실패, 가끔만 깨짐처럼 보입니다. 이 문제는 로직 버그가 아니라 채널 분리 실패입니다.

    7-3. 브라우저에서만 유독 안 붙을 때

    서버는 살아 있고 curl도 되는데 브라우저 앱만 안 된다면 거의 CORS나 Origin 검증 문제입니다. 특히 Streamable HTTP는 POST만 보는 게 아니라 GET, DELETE, Mcp-* 헤더 노출까지 같이 맞아야 합니다. 흔한 근본 원인은 API 서버 CORS는 열어뒀는데 MCP 전용 헤더는 허용하지 않은 경우입니다.

    7-4. 새로 구축하는데 왜 SSE가 자꾸 애매하냐

    최신 공개 MCP 사양 문서 기준으로 표준 transport는 stdio와 Streamable HTTP입니다. 공식 changelog에서도 2025-03-26 개정판부터 이전 HTTP+SSE 방식이 Streamable HTTP로 대체됐다고 설명합니다. 그래서 신규 구축에서 SSE를 택하면 당장은 붙더라도 최신 예제와 운영 지식이 더 많이 쌓인 경로를 일부러 비켜가는 셈입니다. 기존 자산 유지라면 이해되지만, 출발점으로는 굳이 고를 이유가 크지 않습니다.

    8. 검증과 결과 확인: 어디까지 보면 진짜 끝난 건가

    Tool 한 번 호출됐다고 끝난 건 아닙니다. 제가 실무에서 됐다고 판단하는 기준은 아래와 같습니다.

    1. 도구 목록 조회: Tool과 Resource가 기대한 이름으로 보이는지
    2. 입력 스키마: 타입 힌트가 Host나 Inspector에서 의도대로 폼으로 노출되는지
    3. 오류 전달: 잘못된 인자나 권한 부족 시 조용히 실패하지 않고 원인이 드러나는지
    4. 권한 범위: 허용한 디렉터리, 헤더, 도메인 밖 접근이 실제로 차단되는지
    5. 로그 분리: 프로토콜 메시지와 운영 로그가 섞이지 않는지
    6. 업그레이드 내성: SDK v1/v2, 구 transport/신 transport가 섞인 환경에서도 최소한 실패 원인이 읽히는지

    특히 마지막이 중요합니다. MCP는 아직 빠르게 움직이는 영역이라 지금 붙는다보다 나중에 어디서 깨졌는지 읽을 수 있느냐가 더 중요할 때가 많습니다. 예를 들어 Python SDK는 현재 안정 라인에서 MCPServer 중심 인터페이스를 제공하고, Streamable HTTP 옵션과 보안 동작도 예전 글과 차이가 있습니다. 오래된 블로그 예제를 그대로 복붙하면 코드 모양은 비슷해도 디버깅 포인트가 어긋나는 경우가 생깁니다.

    • 도구가 목록에 안 뜨면 연결 설정과 transport 계층부터 봅니다.
    • 도구는 뜨는데 호출만 실패하면 핸들러 예외, 파일 권한, 외부 API 자격 증명을 봅니다.
    • 배포 직후 전부 실패하면 코드보다 Host allowlist와 Origin 거부를 먼저 의심합니다.
    • 읽기 도구는 되는데 쓰기 도구만 실패하면 승인 정책이나 상위 시스템 권한 매핑을 봅니다.
    MCP 솔루션 비교 결과를 검증하는 도구 호출 화면 이미지

    도구 목록, 인자 폼, 호출 결과, 에러 메시지를 검증하는 예시 화면입니다.

    9. 어떤 경우에 무엇을 고르면 되나

    여기서는 애매하게 끝내지 않겠습니다. 선택 기준은 꽤 또렷합니다.

    상황 고를 방식 이유 피하는 편이 나은 선택
    개인용 자동화, 홈랩, 데스크톱 중심 Local stdio 권한이 사용자 장치에 있고 디버깅 시작점이 가장 단순합니다 처음부터 OpenAI 원격 MCP 연동
    팀 공용 도구, 사내 운영, 중앙 감사 로그 필요 Streamable HTTP 인증, 회수, 배포, 공용 운영을 서버 측에서 통제하기 쉽습니다 각 사용자 PC에 stdio 배포
    OpenAI 기반 에이전트에 외부 SaaS를 빠르게 연결 OpenAI 원격 MCP 연동 애플리케이션이 MCP 통신을 전부 직접 다루지 않아도 됩니다 내부망 전용 리소스를 억지로 원격 공개
    기존 SSE 서버를 이미 운영 중 당장은 유지, 신규 기능은 Streamable HTTP 검토 이전 비용을 조절하면서 점진적으로 옮길 수 있습니다 새 프로젝트를 SSE로 시작

    제 추천은 한 줄로 정리할 수 있습니다. 로컬 자산과 개발 속도가 중요하면 stdio, 운영과 중앙 통제가 중요하면 Streamable HTTP, 플랫폼 중심 외부 연동 실험이면 원격 MCP 연동입니다. 그리고 신규 프로젝트의 기본값은 여전히 stdio로 모델과 도구 계약을 먼저 검증한 뒤 Streamable HTTP로 승격하는 순서를 권합니다. 이 흐름이 비용, 안정성, 설명 가능성 면에서 가장 덜 비쌉니다.

    실무에서는 제품보다 권한 경계가 오래갑니다. 예쁘게 데모되는 것보다 누가 어떤 헤더와 어떤 디렉터리, 어떤 쓰기 권한을 갖는지 먼저 선명하게 그리는 편이 결국 시간을 아낍니다. MCP 솔루션 비교는 결국 그걸 고르는 작업이라고 보시면 됩니다.

    다음 글에서는 MCP 서버를 ASGI 배포 뒤에 어떻게 묶는지, reverse proxy와 ingress 앞단에서 어떤 헤더와 로그를 남겨야 디버깅이 쉬운지, 그리고 읽기 전용 도구와 변경 도구를 승인 정책으로 어떻게 분리하는지까지 이어서 다뤄보겠습니다. 관련 글에서는 MCP 서버 보안 체크리스트와 Streamable HTTP 배포 예제도 함께 정리해 보겠습니다.

    개인용, 팀용, 운영용, 외부 연동용에 따라 어떤 MCP 방식을 고를지 요약한 인포그래픽입니다.

    FAQ

    MCP 솔루션 비교에서 가장 먼저 볼 항목은 뭔가요?

    실행 위치보다 한 단계 더 앞선 질문인 권한이 어디에 있어야 하는가입니다. 로컬 자산이 핵심이면 stdio 쪽이 자연스럽고, 중앙 통제가 필요하면 HTTP 계열이 맞습니다.

    MCP 장점 단점은 한 문장으로 어떻게 보시나요?

    장점은 도구 연결 방식을 표준화해 재사용성과 교체 가능성을 높인다는 점이고, 단점은 권한 경계와 전송 계층을 대충 설계하면 복잡도가 뒤로 숨는다는 점입니다.

    모델 컨텍스트 프로토콜을 처음 붙일 때 추천 경로는요?

    로컬 stdio로 최소 Tool과 Resource를 검증하고, Inspector에서 스키마와 오류 처리를 확인한 뒤, 팀 공유가 필요해지는 시점에 Streamable HTTP로 올리는 경로를 권합니다.

    OpenAI 원격 MCP 연동은 언제 특히 유용한가요?

    Responses API처럼 원격 MCP 서버 도구를 지원하는 플랫폼 위에서 외부 SaaS 도구를 빠르게 실험할 때 유용합니다. 대신 allowed_tools와 require_approval 같은 제한 장치는 같이 걸어두는 편이 안전합니다.

    새 프로젝트에서 SSE를 시작점으로 삼아도 되나요?

    기술적으로는 가능하지만 권하지 않습니다. 신규 기준으로는 stdio와 Streamable HTTP 쪽이 공식 사양, 예제, 운영 지식이 더 풍부해서 장기적으로 덜 불편합니다.
  • [AI] MLflow MLOps 실험 추적 체크리스트와 운영 베스트 프랙티스

    [AI] MLflow MLOps 실험 추적 체크리스트와 운영 베스트 프랙티스

    MLflow MLOps 실험 추적 체크리스트와 운영 베스트 프랙티스

    MLflow MLOps를 붙일 때 진짜 어려운 건 설치 자체보다 실험 기록을 나중에도 믿을 수 있게 만드는 일이더라고요. 실험은 돌아갔는데 어떤 데이터 버전으로, 어떤 코드 커밋에서, 누가, 왜 돌렸는지 안 남으면 그 run은 숫자만 남은 흔적에 가깝습니다. 저도 초반엔 UI만 뜨면 된다고 생각했는데, 팀 협업이 시작되자 바로 문제가 터졌습니다. run은 많은데 배포 후보는 안 보이고, 모델은 등록돼 있는데 검증 사유가 없고, artifact는 있는데 다시 못 읽는 식이었죠.

    그래서 이 글은 MLflow 사용법을 나열하는 글이 아니라 실험 추적 체계를 망치지 않기 위한 운영 체크리스트에 집중합니다. 특히 아래 세 가지를 분리해서 보셔야 합니다. 이 구분이 안 되면 실험 관리가 금방 꼬이거든요.

    • 메타데이터: param, metric, tag, run 상태가 어디에 저장되는가
    • 대용량 산출물: 모델 파일, plot, 리포트, 샘플 입력이 어디에 저장되는가
    • 승격 판단: 어떤 모델이 단순히 기록된 모델이고, 어떤 모델이 배포 가능한 모델인가

    이 셋을 한 덩어리로 보면 운영이 꼬입니다. 반대로 분리해서 설계하면, MLflow MLOps 워크플로우가 꽤 단단해집니다. 실험 관리 기준만 잘 잡아도 나중에 UI에서 헤매는 시간이 확 줄어들더라고요.

    MLflow MLOps 실험 추적 아키텍처 개요 이미지

    MLflow Tracking Server, artifact storage, model registry, training job 흐름을 한눈에 보여주는 개요 이미지입니다.

    MLflow MLOps 시작 전 먼저 볼 체크리스트

    제가 실무에서 먼저 확인하는 건 UI가 아니라 규칙입니다. 아래 항목이 빠져 있으면, 서버를 잘 띄워도 몇 주 뒤엔 실험 관리가 아니라 실험 발굴 작업을 하게 됩니다.

    • Tracking URI를 모든 학습 작업이 같은 값으로 사용하도록 강제했는가
    • Experiment 이름에 프로젝트, 작업 종류, 환경이 들어가는가
    • Artifact 저장소가 서버 로컬 디스크인지, S3/GCS/Azure Blob 같은 공용 스토리지인지 합의됐는가
    • Run tag에 최소한 git_sha, data_version, owner, purpose가 남는가
    • 등록 기준이 "최고 점수"인지, "검증 통과 + 설명 작성"인지 명확한가
    • 모델 승격 방식을 stages보다 alias/tag 중심으로 설계했는가
    • 접근 제어를 네트워크 레벨, 리버스 프록시, 또는 MLflow 인증 기능 중 무엇으로 처리할지 정했는가
    • 실패 run 보존 정책이 있는가, 아니면 좋은 결과만 남기고 나쁜 기록을 지우는가

    여기서 특히 중요한 판단이 하나 있습니다. 개인 실험 환경과 팀 공용 환경을 섞지 마세요. 혼자 노트북에서 돌리는 추적과 팀 공용 추적을 같은 URI 체계 없이 섞어버리면, 나중에 "왜 내 run은 UI에 없지?" 같은 문제가 너무 쉽게 생깁니다. 그때는 도구 문제가 아니라 운영 모델이 애매했던 겁니다.

    MLflow MLOps 핵심 개념, 이 4개만 구분하시면 됩니다

    초반에 많이 헷갈리는 부분이 Tracking, Artifact, Registry, Deployment를 한 기능처럼 생각하는 겁니다. 실제로는 성격이 다릅니다. 저는 아래처럼 분리해서 설명하는 편입니다.

    구성 요소 무엇을 저장하나 언제 중요해지나 자주 터지는 실패 모드 권장 판단 기준
    Tracking run, param, metric, tag, 상태 여러 실험을 비교할 때 같은 코드인데 run 이름과 tag 규칙이 제각각임 검색 가능한 메타데이터가 30초 안에 보여야 합니다
    Artifact Store 모델 파일, 이미지, 리포트, input example 재현과 검증이 필요할 때 run은 보이는데 artifact 다운로드가 실패함 학습 노드가 아니라 서버 또는 공용 스토리지가 파일의 기준점이어야 합니다
    Model Registry 모델 버전, 설명, alias, tag 배포 후보가 2개 이상 생길 때 버전은 늘어나는데 어떤 버전이 운영용인지 모름 버전 번호보다 alias와 승인 상태 태그를 믿는 편이 낫습니다
    Serving/Deployment 실제 추론 엔드포인트와 연결된 버전 정보 운영 반영과 롤백 시 서빙 중인 모델과 Registry가 따로 놈 배포 코드가 models:/name@alias를 보게 해야 합니다

    여기서 하나 짚고 갈 점이 있습니다. Model Stages는 MLflow 2.9.0부터 deprecated입니다. 예전 글처럼 Production, Staging만 믿고 설계하면 금방 한계가 보입니다. 요즘은 model version alias와 tag를 중심으로 보는 쪽이 더 낫습니다. 저는 운영 코드에는 @champion, 검증 중인 후보에는 validation_status=pending 같은 태그를 붙이는 방식을 권합니다.

    혹시 이런 경험 있으신가요? 성능이 제일 좋던 run은 찾았는데, 그 모델이 실제 배포 가능한 버전인지 아닌지 판단이 안 되는 경우요. 그건 Tracking은 했는데 Registry 정책이 비어 있었던 겁니다. 숫자를 남긴 것과, 의사결정을 남긴 것은 다릅니다.

    실험 관리 기준부터 정해야 MLflow MLOps가 굴러갑니다

    실험 추적이 망가지는 패턴은 거의 비슷합니다. 사람마다 run 이름이 다르고, 어떤 사람은 tag를 남기고 어떤 사람은 안 남기고, 어떤 사람은 Registry에 바로 등록하고 어떤 사람은 artifact만 남깁니다. 이걸 막으려면 최소 운영 규칙을 코드 수준에서 강제해야 합니다.

    1. Experiment 이름: 프로젝트-태스크-환경 형식으로 고정합니다. 예: fraud-detection-train-dev
    2. Run name: 모델 종류와 핵심 파라미터가 드러나게 둡니다. 예: xgb-md6-lr0.05-seed42
    3. 필수 tag: git_sha, data_version, owner, purpose, pipeline는 무조건 남깁니다
    4. Artifact 구조: model/, plots/, reports/, samples/처럼 목적별로 분리합니다
    5. 등록 기준: metric 1개로 자동 등록하지 말고, 검증 통과 여부와 설명 입력까지 포함합니다
    6. 배포 참조 방식: 버전 번호가 아니라 alias 기반으로 읽게 합니다. 그래야 운영 코드 수정 없이 교체할 수 있습니다

    저는 여기서 등록 조건과 승격 조건을 꼭 나눕니다. 등록은 "비교 가능한 후보를 남긴다"에 가깝고, 승격은 "이 버전에 트래픽을 태워도 된다"에 가깝습니다. 둘을 합치면 점수 하나 높은 실험이 그대로 운영 모델이 되는 사고가 납니다.

    그리고 metric 자동 등록은 생각보다 위험합니다. 예를 들어 검증셋 누수가 있거나, 데이터 전처리가 우연히 섞여 숫자만 좋아졌을 수 있거든요. 그래서 저는 최소한 아래 중 둘 이상이 충족돼야 등록 후보로 봅니다.

    • 핵심 metric이 베이스라인보다 명확히 개선됨
    • 데이터 버전과 코드 커밋이 명시돼 있음
    • input signature와 input example이 함께 저장돼 있음
    • 검증 리포트 artifact가 같이 올라감
    • 설명(description) 또는 모델 버전 태그에 승인 맥락이 남아 있음

    실전 구현 1: MLflow Tracking Server를 제대로 띄우기

    처음 시작은 mlflow ui로 많이 합니다. 개인 노트북에서 보는 용도로는 괜찮습니다. 다만 팀이 붙는 순간에는 서버 프로세스, backend store, artifact 경로를 명시하는 편이 훨씬 안전합니다. 애매하게 두면 나중에 어디에 저장됐는지부터 찾게 되더라고요.

    빠르게 시작하는 최소 구성은 아래처럼 갈 수 있습니다. 여기서 포인트는 기본값에 기대지 말고 의도를 코드와 명령어에 남기는 겁니다. 특히 MLflow 공식 문서 기준으로 MLflow 3.7.0부터 기본 tracking backend가 file store 중심에서 SQLite 중심으로 바뀌었기 때문에, 더더욱 명시적으로 적는 편이 덜 헷갈립니다.

    mkdir -p /srv/mlflow/artifacts
    cd /srv/mlflow
    
    python -m venv .venv
    source .venv/bin/activate
    pip install mlflow
    
    mlflow server \
      --backend-store-uri sqlite:////srv/mlflow/mlflow.db \
      --default-artifact-root file:///srv/mlflow/artifacts \
      --host 0.0.0.0 \
      --port 5000

    이 구성은 개인 실험이나 1~2명 PoC까지는 충분합니다. 다만 운영을 조금이라도 염두에 둔다면 아래 옵션 의미는 꼭 이해하고 넘어가세요.

    • --backend-store-uri: run 메타데이터 저장소입니다. 검색, 비교, tag 조회 속도와 안정성에 직접 영향 줍니다
    • --default-artifact-root: 새 experiment의 artifact 기본 위치입니다. 이미 만들어진 experiment에는 소급 적용되지 않습니다
    • --serve-artifacts 또는 --artifacts-destination: artifact를 서버가 프록시할지, 원격 저장소와 어떻게 연결할지 결정합니다
    • --registry-store-uri: Registry 저장소를 backend store와 분리할 때 명시합니다. 작게 시작할 땐 같은 DB도 괜찮습니다

    조금 더 운영에 가깝게 가려면 PostgreSQL과 S3 계열 스토리지를 붙이는 구성이 낫습니다. 제 경험상 이 시점의 분기점은 동시 사용자 수보다 artifact를 누가 어떤 네트워크에서 읽을 건가예요. 브라우저와 작업 노드가 스토리지에 직접 접근 가능한 환경이면 직접 다운로드도 괜찮고, 그렇지 않으면 서버 프록시가 더 단순합니다.

    export AWS_ACCESS_KEY_ID="YOUR_ACCESS_KEY"
    export AWS_SECRET_ACCESS_KEY="YOUR_SECRET_KEY"
    export AWS_DEFAULT_REGION="ap-northeast-2"
    
    mlflow server \
      --backend-store-uri postgresql://mlflow:[email protected]:5432/mlflow \
      --artifacts-destination s3://company-mlflow-artifacts \
      --serve-artifacts \
      --host 0.0.0.0 \
      --port 5000 \
      --allowed-hosts "mlflow.example.com" \
      --cors-allowed-origins "https://mlops.example.com"

    이 설정에서 중요한 트레이드오프는 이렇습니다.

    선택지 언제 권하나 장점 주의할 점
    로컬 파일 + SQLite 개인 실험, 짧은 PoC 설치가 빠르고 디버깅이 단순함 동시성, 백업, 공유 접근에서 금방 한계가 옵니다
    PostgreSQL + 서버 프록시 artifact 팀 공용, 내부망 위주 클라이언트 설정이 단순하고 권한 통제가 쉬움 대용량 artifact 트래픽이 서버를 통과해 병목이 될 수 있습니다
    PostgreSQL + 원격 object storage 직접 접근 대용량 모델, 다수 사용자 서버 부하를 줄이기 좋음 브라우저와 작업 노드가 스토리지에 직접 접근 가능해야 합니다

    서비스로 굴릴 거면 프로세스 생명주기도 정리하셔야 합니다. systemd로 묶어두면 재시작과 장애 복구가 한결 낫습니다.

    [Unit]
    Description=MLflow Tracking Server
    After=network.target
    
    [Service]
    User=mlflow
    WorkingDirectory=/srv/mlflow
    Environment=MLFLOW_FLASK_SERVER_SECRET_KEY=replace-with-random-secret
    ExecStart=/srv/mlflow/.venv/bin/mlflow server \
      --backend-store-uri postgresql://mlflow:[email protected]:5432/mlflow \
      --artifacts-destination s3://company-mlflow-artifacts \
      --serve-artifacts \
      --host 0.0.0.0 \
      --port 5000
    Restart=on-failure
    RestartSec=5
    
    [Install]
    WantedBy=multi-user.target

    보안 쪽도 한 줄로 넘기면 안 됩니다. 예전엔 다들 NGINX 뒤에 두는 정도로 끝냈는데, 지금은 MLflow가 기본 인증 기능도 제공해서 선택지가 늘었습니다. 내부 테스트라면 프록시 뒤에서 Basic Auth만 걸어도 충분할 때가 있고, 여러 팀이 같이 쓰는 환경이면 내장 auth나 별도 SSO 연동을 같이 검토하는 편이 낫습니다.

    pip install 'mlflow[auth]'
    export MLFLOW_FLASK_SERVER_SECRET_KEY='replace-with-random-secret'
    mlflow server --app-name basic-auth --host 0.0.0.0 --port 5000

    제 판단은 이렇습니다. 사내 단일 팀이면 리버스 프록시 + TLS + 네트워크 제한으로 시작해도 됩니다. 여러 조직이 한 서버를 공유하면 접근 권한을 MLflow 자원 단위로 관리할 수 있는 쪽이 운영이 덜 아픕니다.

    Tracking Server, backend store, artifact root가 각각 어떤 역할인지 구분해서 보여주는 구성 이미지입니다.

    실전 구현 2: 코드에서 MLflow 사용법을 일관되게 강제하기

    서버보다 더 중요하다고 느끼는 건 학습 코드 템플릿입니다. 팀원마다 로그 방식이 다르면 UI는 몇 주 안에 금방 더러워집니다. 저는 아예 "기록 안 하면 실험으로 인정하지 않는다"는 쪽으로 갑니다. 이거 진짜 편하더라고요. 기준이 한 번 잡히면 리뷰도 빨라집니다.

    아래 예시는 최소 템플릿입니다. 포인트는 tracking URI 지정, 실험 이름 고정, 필수 tag 기록, signature와 input example 저장, 등록 이름 부여입니다.

    import os
    import mlflow
    from mlflow.models import infer_signature
    from sklearn.datasets import load_iris
    from sklearn.ensemble import RandomForestClassifier
    from sklearn.metrics import accuracy_score
    from sklearn.model_selection import train_test_split
    
    TRACKING_URI = os.getenv("MLFLOW_TRACKING_URI", "http://127.0.0.1:5000")
    EXPERIMENT_NAME = os.getenv("MLFLOW_EXPERIMENT_NAME", "iris-train-dev")
    REGISTERED_MODEL_NAME = os.getenv("MLFLOW_REGISTERED_MODEL", "dev.ml_team.iris-rf")
    
    mlflow.set_tracking_uri(TRACKING_URI)
    mlflow.set_experiment(EXPERIMENT_NAME)
    
    X, y = load_iris(return_X_y=True)
    X_train, X_test, y_train, y_test = train_test_split(
        X, y, test_size=0.2, random_state=42
    )
    
    params = {
        "n_estimators": 100,
        "max_depth": 4,
        "random_state": 42,
    }
    
    with mlflow.start_run(run_name="rf-md4-seed42"):
        mlflow.log_params(params)
        mlflow.set_tags({
            "owner": os.getenv("USER", "unknown"),
            "purpose": "baseline",
            "data_version": os.getenv("DATA_VERSION", "iris_builtin_v1"),
            "git_sha": os.getenv("GIT_COMMIT", "unknown"),
            "pipeline": os.getenv("PIPELINE_NAME", "manual-train"),
        })
    
        model = RandomForestClassifier(**params)
        model.fit(X_train, y_train)
        preds = model.predict(X_test)
        acc = accuracy_score(y_test, preds)
    
        mlflow.log_metric("accuracy", acc)
    
        signature = infer_signature(X_train, model.predict(X_train))
        mlflow.sklearn.log_model(
            sk_model=model,
            artifact_path="model",
            signature=signature,
            input_example=X_train[:2],
            registered_model_name=REGISTERED_MODEL_NAME,
            await_registration_for=0,
        )

    여기서 특히 중요한 건 세 가지입니다. git_sha가 없으면 코드 재현성이 거의 사라지고, data_version이 없으면 metric 비교가 절반만 유효해집니다. 그리고 signature와 input_example이 없으면 서빙 시 입력 스키마 문제를 늦게 발견하는 경우가 많습니다.

    다만 모든 실험에서 바로 등록까지 가는 구조는 저는 권하지 않습니다. 탐색 단계에선 Registry가 후보 저장소가 아니라 쓰레기장처럼 되기 쉽거든요. 아래처럼 성능 기준을 만족한 경우에만 등록하게 분기하는 편이 운영상 훨씬 낫습니다.

    import mlflow
    from mlflow import MlflowClient
    
    client = MlflowClient()
    threshold = 0.90
    
    with mlflow.start_run(run_name="rf-candidate") as run:
        # ... train and evaluate
        score = 0.95
        mlflow.log_metric("accuracy", score)
    
        model_info = mlflow.sklearn.log_model(
            sk_model=model,
            artifact_path="model",
            signature=signature,
            input_example=X_train[:2],
        )
    
        if score >= threshold:
            mv = mlflow.register_model(model_uri=model_info.model_uri, name="dev.ml_team.iris-rf")
            client.set_model_version_tag("dev.ml_team.iris-rf", mv.version, "validation_status", "pending")
            client.set_model_version_tag("dev.ml_team.iris-rf", mv.version, "source_run_id", run.info.run_id)

    실무에선 이 분기가 꽤 중요합니다. 모든 run을 다 등록하면 Registry는 비교용 데이터베이스가 아니라 잡동사니 서랍이 됩니다. Registry는 후보군의 저장소여야지, raw experiment dump가 되면 안 됩니다.

    CLI에서 실행한다면 환경 변수도 템플릿에 포함시키세요. 사람 손으로 입력하면 늘 하나씩 빠집니다.

    export MLFLOW_TRACKING_URI=http://127.0.0.1:5000
    export MLFLOW_EXPERIMENT_NAME=fraud-detection-train-dev
    export MLFLOW_REGISTERED_MODEL=dev.ml_team.fraud_xgb
    export DATA_VERSION=2026-08-raw-v3
    export GIT_COMMIT=$(git rev-parse --short HEAD)
    python train.py

    이 설정 없이 실행했는데 현재 디렉터리에 mlruns/ 폴더가 생겼다면 거의 확실하게 Tracking URI 적용이 안 된 겁니다. 이건 제가 제일 먼저 보는 신호입니다. UI에 안 보이는 run을 한참 찾기 전에, 로컬에 mlruns/가 생겼는지부터 확인하세요.

    MLflow 모델 레지스트리와 승격 기준, 여기서 운영 냄새가 납니다

    Registry는 단순히 모델 파일 버전을 쌓는 곳이 아닙니다. 누가 어떤 근거로 이 버전을 다음 단계로 넘겼는지를 남기는 곳에 가깝습니다. 그래서 저는 예전의 stage 중심 설계보다 alias/tag 중심 설계를 더 권합니다.

    • 등록 전 확인: 학습 코드 커밋, 데이터 버전, 핵심 metric, artifact 저장, signature 존재 여부
    • 승인 보류 상태: validation_status=pending 같은 모델 버전 태그 부여
    • 검증 통과 상태: validation_status=approved, 검증 리포트 링크 또는 설명 기록
    • 배포 참조: 운영 코드는 models:/prod.ml_team.fraud_xgb@champion 같은 alias를 읽도록 구성
    • 롤백 준비: 직전 배포 버전에 previous_champion alias를 유지하거나 버전 태그를 남김

    이걸 stages로 해도 되지 않느냐고 많이 물으시는데, 새 글에서는 stages를 중심축으로 잡지 않는 편이 맞습니다. 이유는 간단합니다. 단계 이름이 고정되면 실제 운영 흐름을 충분히 표현하기 어렵기 때문이죠. A/B 테스트 후보, 지역별 배포 후보, 오프라인 승인 완료 상태 같은 걸 표현하려면 alias/tag가 훨씬 유연합니다.

    예를 들어 저는 이런 식으로 씁니다.

    from mlflow import MlflowClient
    
    client = MlflowClient()
    model_name = "prod.ml_team.fraud_xgb"
    version = 12
    
    client.set_model_version_tag(model_name, version, "validation_status", "approved")
    client.set_model_version_tag(model_name, version, "approved_by", "ml-reviewer")
    client.set_registered_model_alias(model_name, "champion", version)
    client.set_registered_model_alias(model_name, "shadow", 13)

    이렇게 해두면 서빙 시스템은 @champion만 보면 되고, 실험 시스템은 shadow나 validation_status를 보면서 다음 후보를 준비할 수 있습니다. 운영 코드와 실험 코드가 느슨하게 분리되는 거죠. 이 설계는 생각보다 큽니다. 배포 스크립트를 매번 수정하지 않아도 되니까요.

    ⚠️ 트러블슈팅: 실험은 보이는데 모델 파일이 안 보이는 상황

    이 문제는 꽤 흔하고, 원인도 생각보다 선명합니다. backend store와 artifact store의 기준점이 다를 때 생깁니다. 메타데이터는 DB에 잘 남는데 파일 경로가 서버 기준으로 일관되지 않으면, UI에서는 run이 보이는데 artifact 탭만 깨집니다.

    재현 시나리오를 하나 들어보겠습니다.

    1. 개발자 A가 자신의 서버에서 --default-artifact-root file:///home/a/mlartifacts로 Tracking Server를 띄웁니다.
    2. 개발자 B가 같은 Tracking URI로 실험을 기록합니다.
    3. run 메타데이터는 정상 저장되지만, artifact 저장 위치와 접근 주체가 서버 기준으로 설계되지 않아 다운로드가 실패합니다.

    이 상황에서 핵심은 누가 파일을 쓰고 누가 파일을 읽는가를 분리해서 보는 겁니다. 초보 단계에선 학습 노드가 파일을 쓴다고 생각하기 쉽지만, 실제 운영에서는 서버가 관리 가능한 위치 또는 공용 object storage가 기준이어야 합니다.

    제가 점검할 때는 아래 순서로 갑니다.

    • 1단계: run 상세에서 param, metric, tag가 보이는지 확인합니다. 보이면 backend store는 대체로 살아 있습니다
    • 2단계: artifact 탭만 비어 있거나 다운로드가 실패하면 artifact root 설계를 의심합니다
    • 3단계: 새 experiment 생성 시점에 어떤 artifact_location이 박혔는지 확인합니다. 기존 experiment는 나중에 --default-artifact-root를 바꿔도 자동 수정되지 않습니다
    • 4단계: 서버 프로세스 사용자와 스토리지 권한을 확인합니다. 로컬 디스크면 쓰기 권한, S3/GCS면 자격 증명과 네트워크 경로를 봅니다
    • 5단계: 원격 저장소 직접 다운로드를 쓴다면 브라우저가 해당 스토리지 엔드포인트에 접근 가능한지도 봅니다

    판단 기준도 같이 가져가시면 좋습니다.

    증상 가장 의심할 원인 우선 확인할 것
    run 목록은 보이는데 artifact만 안 열림 artifact store 경로/권한 불일치 --default-artifact-root, experiment의 artifact_location, 스토리지 권한
    로컬엔 파일이 있는데 UI엔 run이 없음 Tracking URI 미적용 현재 디렉터리의 mlruns/ 생성 여부, 환경 변수 설정
    run은 생기는데 등록이 안 됨 Registry 접근/권한 또는 등록 로직 누락 registered_model_name, 등록 API 호출, 인증 설정
    운영 코드가 옛 버전을 계속 읽음 버전 번호 고정 참조 models:/name/version 대신 alias 참조 여부

    또 하나 자주 터지는 게 experiment 이름 난립입니다. 누군가는 fraud-dev, 누군가는 fraud_detection, 누군가는 tmp-test로 남기면 실험 관리가 아니라 run 수색이 됩니다. 이건 교육으로 해결이 잘 안 됩니다. 환경 변수나 설정 파일로 강제하는 쪽이 훨씬 빠릅니다.

    MLflow MLOps 아티팩트 경로 오류 비교 이미지

    아티팩트 경로가 잘못되었을 때와 올바르게 구성되었을 때의 차이를 비교하는 이미지입니다.

    검증과 결과 확인은 숫자보다 연결 상태를 먼저 보세요

    MLflow가 제대로 붙었는지 확인할 때 숫자부터 보는 분이 많습니다. 그런데 운영 준비도는 metric보다 연결 상태가 먼저입니다. 저는 아래 순서대로 확인합니다.

    1. Tracking 검증: 예상한 experiment 아래에 run이 쌓이는가
    2. Metadata 검증: param, metric, tag가 최소 기준을 만족하는가
    3. Artifact 검증: 모델 파일, 리포트, input example을 실제로 열 수 있는가
    4. Registry 검증: 등록된 버전이 원본 run과 연결되어 보이는가
    5. 배포 검증: 서빙 코드가 버전 번호가 아니라 alias를 읽는가
    6. 재현성 검증: 같은 코드와 데이터 버전으로 재실행했을 때 비교가 성립하는가

    결과를 읽는 기준도 숫자 중심으로만 보면 안 됩니다. 예를 들어 run은 많은데 tag가 비어 있다면 실험 정책이 없는 겁니다. 모델 버전은 쌓이는데 설명이 없다면 Registry가 보관함 역할만 하는 겁니다. champion alias는 있는데 승인 태그가 없다면 배포 경로는 있으나 책임 추적은 약한 상태라고 봐야 합니다.

    제가 실제로 자주 쓰는 확인 시나리오를 하나 말씀드리면, 새 팀원이 첫 실험을 올린 날엔 점수보다 먼저 세 가지를 봅니다. git_sha가 남았는지, artifact가 다운로드되는지, 등록된 모델이 있으면 왜 등록했는지 설명이 있는지요. 여기서 하나라도 비면 그 실험은 재현성과 운영 연결성이 약하다고 판단합니다.

    MLflow MLOps 실험 결과와 모델 레지스트리 검증 이미지

    실험 결과, 태그, 모델 버전 연결 관계를 확인하는 대시보드 예시 이미지입니다.

    현업에서 바로 쓰는 MLflow MLOps 체크리스트

    여기서는 제가 실제 배포 전 점검 때 보는 항목을 좀 더 엄격하게 적어보겠습니다.

    • ✅ 모든 학습 잡이 같은 MLFLOW_TRACKING_URI를 사용한다
    • ✅ experiment 이름 규칙이 코드 또는 설정으로 강제된다
    • ✅ run마다 owner, git_sha, data_version, purpose 태그가 있다
    • ✅ 현재 디렉터리에 우발적으로 mlruns/가 생기지 않는다
    • ✅ artifact root가 서버 로컬 고정 경로 또는 공용 스토리지다
    • ✅ signature와 input example이 저장된다
    • ✅ Registry 등록은 기준을 통과한 run에만 허용된다
    • ✅ 모델 버전에 승인 상태 태그와 설명이 남는다
    • ✅ 운영 배포 코드는 alias 기반으로 모델을 참조한다
    • ✅ 직전 안정 버전으로 롤백 가능한 경로가 있다
    • ✅ 실패 run도 삭제하지 않고 비교 자료로 남긴다

    실패 run을 남기는 건 의외로 중요합니다. 예전에 저도 지저분해 보여서 정리하고 싶었던 적이 많았는데, 시간이 지나면 실패 기록이 오히려 팀의 판단 근거가 됩니다. 어떤 파라미터가 왜 버려졌는지, 어떤 전처리가 왜 제외됐는지, 문서보다 run 기록이 더 정직하게 남는 경우가 많거든요.

    자주 묻는 질문과 추천 시나리오

    Q1. 작은 팀도 모델 레지스트리가 꼭 필요할까요?

    혼자만 실험하는 단계라면 당장은 Tracking 중심으로 시작해도 됩니다. 다만 배포 후보가 둘 이상 생기기 시작하면 Registry를 미루지 마세요. 그 시점부터는 "좋은 숫자"와 "배포 가능한 버전"이 갈라집니다. 제 추천은 이렇습니다. 개인 프로젝트 초반이면 Tracking + artifact 정리까지만, 팀 협업이나 재배포가 시작되면 Registry + alias까지 바로 붙이세요.

    Q2. 로컬 파일 기반으로 시작해도 괜찮을까요?

    네, PoC나 홈랩 단계라면 충분히 괜찮습니다. 대신 두 가지는 지키세요. 첫째, artifact 경로를 임시 디렉터리나 사용자 홈의 애매한 위치로 두지 마세요. 둘째, 나중에 공용 스토리지로 옮길 걸 감안해 experiment와 artifact 구조를 단순하게 유지하세요. 시작은 가볍게 해도 되지만, 이사하기 어려운 경로 설계는 초반부터 피하는 게 좋습니다.

    Q3. 자동 등록이 좋을까요, 수동 승인 방식이 좋을까요?

    탐색 단계라면 성능 기준 충족 시 자동 등록도 괜찮습니다. 하지만 실제 운영 직전이라면 자동 등록 + 수동 승인 조합이 가장 안전합니다. 제가 권하는 방식은 이렇습니다. 성능 문턱을 넘으면 자동으로 Registry 후보로 등록하되, validation_status=pending으로 두고, 검증 리포트 확인 후에만 @champion alias를 이동하세요. 이러면 속도와 통제를 둘 다 가져갈 수 있습니다.

    개인 실험, 팀 협업, 배포 직전 단계별로 무엇을 우선 적용할지 요약한 이미지입니다.

    마지막으로, 이런 경우엔 이렇게 가시면 됩니다

    상황별로 딱 잘라 추천드리면 이렇습니다.

    • 개인 실험 단계: SQLite + 로컬 artifact + 엄격한 tag 규칙으로 충분합니다. 다만 experiment 이름과 필수 tag는 초반부터 습관을 들이세요
    • 팀 공용 추적 단계: PostgreSQL + 공용 object storage + 고정 Tracking URI로 가세요. 이 시점부터는 서버 설치보다 경로 일관성이 더 중요합니다
    • 배포 후보 운영 단계: Registry + alias + 승인 태그 + 롤백 경로까지 묶으세요. 버전 번호 직접 참조는 여기서 끊는 게 좋습니다
    • 여러 팀 공유 단계: 네트워크 제한만으로 끝내지 말고 인증과 권한 모델까지 포함해서 설계하세요

    제가 실제로 굴려보면서 내린 결론은 단순합니다. MLflow MLOps를 잘 쓰는 팀은 기능을 많이 쓰는 팀이 아니라, 남길 정보를 명확히 정한 팀입니다. 실험 추적의 품질은 UI보다도 이름 규칙, tag, artifact 기준점, Registry 승인 정책에서 갈립니다. 혼자라면 가볍게 시작하셔도 됩니다. 다만 둘 이상이 같은 모델을 만지기 시작했다면, 그때부터는 "툴 사용법"보다 "운영 기준"이 먼저입니다.

    제 추천을 한 줄로 줄이면 이렇습니다. 개인 단계에선 Tracking을 단단하게, 팀 단계에선 artifact를 공용화하고, 배포 단계에선 alias와 승인 흐름을 분리하세요. 이 순서만 지켜도 나중에 "이 모델 누가 왜 올렸죠?"라는 질문 앞에서 멈출 일은 크게 줄어듭니다. MLflow 사용법을 더 넓게 정리한 글이나 모델 배포 글과 내부 링크로 이어두면 검색 유입과 체류 시간 측면에서도 도움이 됩니다.

  • [AI] OpenVINO 도입 가이드: 기존 AI 모델 최적화 전환 기준

    [AI] OpenVINO 도입 가이드: 기존 AI 모델 최적화 전환 기준

    OpenVINO 도입 가이드: 기존 AI 모델 최적화 전환 기준

    OpenVINO 도입을 검토할 때 저는 먼저 병목부터 가릅니다. 엣지 장비나 사내 서버에서 추론만 오래 돌려보면 결국 질문이 하나로 모이거든요. 지금 느린 지점이 모델인지, 런타임인지, 하드웨어 배치인지를 먼저 나눠야 판단이 덜 흔들립니다. ONNX Runtime에서 이미 잘 도는데도 지연 시간이 출렁이거나 첫 요청만 유독 느릴 때가 있는데, 이런 경우 OpenVINO는 프레임워크를 갈아엎는 선택이라기보다 인텔 CPU 중심 추론 경로를 별도로 최적화하는 수단에 가깝습니다.

    이 글은 OpenVINO 입문서가 아니라, 기존 AI 모델을 언제 OpenVINO 경로로 분기할지 판단하는 실무 메모에 가깝습니다. 저는 보통 세 가지를 같이 봅니다. 첫째, 운영 하드웨어가 정말 인텔 CPU 중심인지. 둘째, ONNX 산출물이 이미 안정적으로 나오는지. 셋째, 병목의 본체가 모델 실행 경로인지 아니면 전처리·후처리·API 계층인지입니다. 사내 블로그에 ONNX export 체크리스트 글이 있다면 그 글과 함께 보시면 판단이 훨씬 빨라집니다.

    OpenVINO 도입 판단을 위한 전체 아키텍처 개요 이미지

    기존 ONNX 추론 경로와 OpenVINO 최적화 경로를 나란히 보여주는 개요 이미지입니다.

    OpenVINO 도입, 왜 여기서 판단이 갈리냐면요

    실무에서는 성능 숫자 하나보다 성능의 성격이 더 중요합니다. 같은 모델이라도 초당 많이 처리해야 하는 배치 작업과 한 요청 응답이 빨라야 하는 API는 최적점이 다르더라고요. OpenVINO는 특히 인텔 하드웨어에서 이 차이를 런타임 수준에서 조정하기 편합니다. 반대로 이미 NVIDIA GPU 최적화와 TensorRT 경로가 운영 표준이라면, OpenVINO를 주 경로로 들이는 순간 복잡도만 커질 수 있습니다.
    제가 보기에 OpenVINO는 아래 조건에서 특히 잘 맞았습니다.

    • 인텔 CPU가 메인 실행 장치라서 CPU 스레드 배치와 추론 요청 수 조정이 성능에 직접 반영되는 경우
    • 여러 엣지 노드에 같은 모델을 배포해야 해서 아티팩트를 단순하게 유지하고 싶은 경우
    • 학습 프레임워크는 그대로 두고, 배포 레이어만 별도로 최적화하고 싶은 경우
    • ONNX까지는 이미 정리됐지만 실제 서비스 지연 시간 편차가 커서 런타임 튜닝이 필요한 경우

    반대로 아래 상황이면 저는 먼저 보류합니다.
    • 커스텀 연산자가 많아 변환 호환성 자체가 리스크인 경우
    • GPU 혼합 환경에서 특정 벤더 최적화가 이미 운영 표준인 경우
    • 모델 추론보다 이미지 디코딩, 리사이즈, NMS, 직렬화가 더 무거운 경우
    • 서비스가 단건 응답 위주인데 비동기 다중 요청에서만 처리량이 좋아지는 경우

    OpenVINO 도입 기준을 AI 모델 최적화 관점에서 보면

    저는 “느리다”보다 “어디서 손해 보는가”를 먼저 적어 둡니다. 이 단계가 흐리면 OpenVINO를 붙인 뒤에도 왜 빨라졌는지, 왜 안 빨라졌는지 설명을 못 하게 되더라고요. 이 작업이 좀 귀찮아 보여도 나중엔 진짜 편합니다.
    상황 관찰 신호 OpenVINO 도입 적합도 제가 실제로 내리는 판단
    인텔 CPU 중심 API 서버 반복 추론 지연 편차가 크고 CPU 사용 패턴이 불안정함 높음 ONNX는 유지하고 OpenVINO IR을 추가 산출해 A/B 비교합니다.
    엣지 장비 다수 배포 GPU 없이 운영하고 패키징 단순성이 중요함 높음 IR 산출물 관리와 첫 로딩 시간, 캐시 전략까지 같이 검토합니다.
    NVIDIA GPU 표준 환경 TensorRT나 CUDA 경로가 이미 검증됨 낮음 주 경로는 유지하고 CPU fallback이 필요할 때만 제한적으로 씁니다.
    커스텀 연산자 다수 변환 경고가 반복되거나 지원 여부가 불명확함 주의 호환성 검증이 끝나기 전에는 마이그레이션 일정에 넣지 않습니다.
    서비스 응답보다 배치 처리량이 중요 동시 요청 수를 늘릴수록 전체 효율이 올라감 높음 <code>-hint throughput 기준으로 먼저 보고, API와 배치 경로를 분리합니다.
    첫 요청만 느림 웜업 이후엔 안정적이나 cold start가 큼 보통 이상 모델 캐시와 사전 컴파일 전략을 먼저 넣고 재측정합니다.

    OpenVINO 도입을 추천하는 가장 강한 신호는 이겁니다. 인텔 CPU 추론이 실제 핵심 경로이고, 모델은 이미 ONNX로 정리됐고, 남은 문제가 운영 레이어 성능과 일관성인 경우요. 이때는 투자 대비 회수 속도가 꽤 빠른 편입니다.

    반대로 학습 파이프라인까지 한 번에 옮기려는 접근은 저는 거의 항상 말립니다. 바꿔야 할 지점이 많아지는 순간 병목 분리가 안 되거든요. 가장 덜 아픈 경로는 여전히 학습은 기존 프레임워크 유지, 배포 추론만 OpenVINO로 분기하는 방식입니다.

    OpenVINO와 ONNX 관계, 실무에서는 이렇게 보시면 덜 헷갈립니다

    실무 관점에서 ONNX는 모델 교환용 공용 산출물이고, OpenVINO는 그 산출물을 인텔 실행 환경에 맞게 최적화해 배포하는 계층에 가깝습니다. 둘 중 하나만 고르는 관계가 아니라, ONNX를 중간 계약서처럼 두고 OpenVINO IR을 배포 전용 산출물로 추가하는 구조가 제일 안전했습니다.

    이 구조를 쓰면 좋은 점이 분명합니다.

    1. 학습 코드와 배포 코드를 억지로 묶지 않아도 됩니다.
    2. ONNX Runtime 경로를 롤백 스위치로 남길 수 있습니다.
    3. 변환 실패가 나도 원본 산출물 체계가 무너지지 않습니다.
    4. CPU 전용 최적화 실험을 서비스 전체 변경 없이 진행할 수 있습니다.

    실제로는 아래 흐름을 많이 씁니다. PyTorch에서 ONNX export를 만들고, OpenVINO IR로 한 번 더 변환한 뒤, benchmark_app으로 모델 단독 성능을 먼저 확인하고, 그다음 애플리케이션에 붙입니다. 이 순서를 지키면 앱 버그와 런타임 문제를 섞어 보지 않게 됩니다.

    실전 구현 1: ONNX 모델을 OpenVINO IR로 변환하기

    여기서는 이미 model.onnx가 있다고 가정하겠습니다. 현재 OpenVINO 배포판에서는 Python 패키지 openvino만으로 기본 런타임과 변환 도구를 시작할 수 있습니다. 예전 글처럼 openvino-dev를 기본 전제로 두는 문서는 아직 많지만, 최신 환경에서는 필수 전제처럼 쓰지 않는 편이 덜 헷갈립니다.

    python3 -m venv .venv
    source .venv/bin/activate
    python -m pip install --upgrade pip
    python -m pip install openvino onnx onnxruntime
    
    # 1) 가장 단순한 CLI 변환
    ovc model.onnx --output_model build/model.xml
    
    # 2) 입력 shape를 명시해야 하는 경우 예시
    ovc model.onnx --output_model build/model.xml --input_shape [1,3,224,224]

    여기서 --input_shape를 굳이 명시하는 이유는 변환 성공 여부보다 런타임 입력 계약을 명확히 하기 위해서입니다. 동적 차원을 넓게 둔 ONNX를 그대로 넘기면 앱 쪽 전처리 코드가 shape를 암묵적으로 가정하다가 운영 중에 터지는 일이 꽤 잦았습니다.

    import openvino as ov
    
    onnx_path = "model.onnx"
    ir_path = "build/model.xml"
    
    ov_model = ov.convert_model(onnx_path)
    ov.save_model(ov_model, ir_path)
    
    print("saved:", ir_path)

    변환 단계에서 제가 꼭 보는 건 세 가지입니다.

    • model.xml과 model.bin이 함께 생성되는지
    • 변환 로그에 unsupported operation, shape inference, precision 관련 경고가 남는지
    • 입력 이름과 입력 shape가 애플리케이션 코드가 기대하는 값과 맞는지

    중요한 건 변환 완료 자체보다 입력 계약이 명확해졌는가입니다. 현업에서 진짜 자주 나는 장애는 변환 실패보다 “변환은 됐는데 앱 입력이 미묘하게 안 맞는 상태”였어요.

    ONNX에서 OpenVINO IR로 변환되는 OpenVINO 도입 구성 이미지

    ONNX 파일이 OpenVINO IR로 바뀌고 CPU 플러그인으로 연결되는 과정을 보여주는 구성 이미지입니다.

    실전 구현 2: 인텔 CPU 추론과 기본 검증

    변환 직후에는 애플리케이션에 바로 붙이지 말고 모델 단독 성능부터 봅니다. 여기서 저는 목표를 둘로 나눕니다. API라면 지연 시간 중심, 배치 작업이라면 처리량 중심입니다. 이걸 안 나누고 평균 숫자 하나만 보면 해석이 자주 틀어집니다.

    # 지연 시간 우선: 단건 응답형 API 검증
    benchmark_app -m build/model.xml -d CPU -hint latency -api sync -t 15 \
      -report_type average_counters -report_folder reports/latency \
      -exec_graph_path reports/latency/exec_graph.xml
    
    # 처리량 우선: 다중 요청 또는 배치 작업 검증
    benchmark_app -m build/model.xml -d CPU -hint throughput -api async -t 15 \
      -report_type average_counters -report_folder reports/throughput \
      -pc

    제가 실제로 읽는 포인트는 아래입니다.

    • -hint latency에서 좋아지는 모델은 실시간 API 후보입니다. 반대로 -hint throughput에서만 성능이 오르면 단건 응답이 중요한 서비스에는 그대로 넣지 않는 편이 안전합니다.
    • -api async에서만 효율이 오르는 경우는 요청을 동시에 밀어 넣을 수 있을 때만 이득입니다. 호출 패턴이 순차형이면 체감 차이가 약할 수 있습니다.
    • -pc와 -report_type average_counters는 레이어별 힌트를 주지만, 서비스 전체 지연 시간을 그대로 대변하지는 않습니다.
    • -exec_graph_path를 남기면 실행 그래프를 따로 볼 수 있어서 레이어 융합 여부를 확인하기 좋습니다.

    CPU 쪽은 너무 빨리 저수준 옵션으로 내려가지 않는 게 중요합니다. 저는 보통 -hint latency나 -hint throughput로 시작하고, 그다음에만 -nthreads, -nireq, 필요 시 -pin 같은 옵션을 건드립니다. 시작부터 스레드 수를 직접 고정하면 휴리스틱보다 못한 조합으로 들어가는 일도 있더라고요.

    # CPU 스레드 경쟁이 의심될 때만 추가 비교
    benchmark_app -m build/model.xml -d CPU -hint latency -api async -t 15 \
      -nthreads 8
    
    # 동시 요청 수가 실제 서비스와 맞지 않는지 확인할 때
    benchmark_app -m build/model.xml -d CPU -hint throughput -api async -t 15 \
      -nireq 4

    NUMA나 멀티소켓 서버라면 스레드 고정 정책까지 볼 가치가 있습니다. 다만 이건 버전과 장치 구성에 따라 옵션 차이가 있어서, benchmark_app -h로 현재 설치 버전이 지원하는 플래그를 먼저 확인하는 게 안전합니다. 소형 단일 서버에서는 이런 저수준 옵션보다 입력 파이프라인 정리 쪽이 효과가 더 클 때가 많았습니다.

    파이썬 서비스에 붙일 때는 아래 정도로 시작하면 충분합니다.

    import openvino as ov
    import numpy as np
    
    core = ov.Core()
    core.set_property({"CACHE_DIR": "./ov_cache"})
    
    compiled_model = core.compile_model("build/model.xml", "CPU", {
        "PERFORMANCE_HINT": "LATENCY"
    })
    
    input_port = compiled_model.input(0)
    output_port = compiled_model.output(0)
    
    sample = np.random.rand(*input_port.shape).astype(np.float32)
    result = compiled_model({input_port.any_name: sample})
    output = result[output_port]
    
    print(output.shape)

    여기서 CACHE_DIR를 넣는 건 첫 요청 지연을 줄이기 위한 준비입니다. 다만 이건 무조건 빨라진다가 아니라 재시작이 잦고 컴파일 비용이 의미 있는 모델에서 특히 효과를 볼 수 있는 옵션으로 보는 편이 정확합니다. 장치와 모델에 따라 체감 차이가 달라서, 넣고 다시 재측정해야 합니다.

    주의사항과 트러블슈팅: 막히는 지점은 늘 비슷합니다

    제가 반복해서 본 실패 모드는 대체로 네 가지였습니다. 증상만 보는 것보다 근본 원인을 먼저 적어두면 대응이 훨씬 빨라집니다.

    1. 입력 shape 문제: 원인은 모델이 아니라 입력 계약 누락인 경우가 많습니다

    에러 메시지는 모델이 까다로운 것처럼 보이는데, 실제로는 전처리 코드가 NCHW, NHWC, dtype, 배치 차원을 제각각 가정하는 경우가 대부분이었습니다. 특히 ONNX 단계에서 동적 차원을 허용해 둔 모델은 “받아줄 줄 알았는데 실제 런타임 입력은 다르다”는 일이 자주 납니다. 해결은 단순합니다. 변환 시점에 입력 shape를 명시하고, 서비스 입력 스키마를 코드와 문서 양쪽에 고정하세요.

    2. 변환은 됐는데 추론 결과가 흔들리는 경우: 원인은 연산자 호환성보다 export 품질인 때도 많습니다

    이건 OpenVINO 쪽 문제로만 보면 안 됩니다. ONNX export 단계에서 이미 불안정한 그래프가 만들어졌거나, 커스텀 연산이 우회 변환되면서 의미가 달라지는 경우가 있습니다. 이런 때는 OpenVINO IR만 보지 말고 원본 프레임워크 출력, ONNX Runtime 출력, OpenVINO 출력을 같은 샘플로 나란히 비교해야 합니다. 분류 모델이면 top-k, 탐지 모델이면 박스 좌표와 score 분포를 같이 보는 편이 좋습니다.

    3. benchmark_app는 좋아 보이는데 API는 그대로인 경우: 원인은 모델 밖에 있습니다

    이건 정말 흔합니다. 예를 들어 FastAPI 뒤에 이미지 추론 API가 있고, 요청마다 파일 업로드를 받아 Pillow로 디코딩하고 NumPy 배열로 바꾸고, 후처리로 박스를 정리해 JSON으로 내보낸다고 해보겠습니다. 이 구조에서는 모델 추론이 빨라져도 디코딩, 리사이즈, 직렬화, 네트워크 대기가 더 크면 전체 응답 시간은 거의 안 줄 수 있습니다. OpenVINO 도입이 실패한 게 아니라 최적화 대상 선정이 틀린 것에 가깝습니다.

    4. 첫 요청만 유독 느린 경우: 원인은 cold start와 컴파일 비용입니다

    서비스 재배포 직후 첫 요청이 길게 나오는 건 흔히 모델 읽기, 컴파일, 캐시 미적용 때문입니다. 이때는 앱 시작 시 웜업 추론을 한 번 수행하고, CACHE_DIR를 켠 뒤 재시작 후 첫 요청을 다시 재보셔야 합니다. 첫 요청과 반복 요청을 같은 수치로 섞으면 운영 판단이 틀어집니다.

    제가 운영 검토 때 쓰는 간단한 구분법도 있습니다.

    증상 먼저 의심할 곳 근본 원인 후보 우선 조치
    모델은 로드되는데 입력 단계에서 바로 실패 전처리 shape, layout, dtype 불일치 입력 스키마를 고정하고 샘플 입력을 저장해 재현합니다.
    변환 경고 없이 결과만 이상함 export 품질 ONNX 그래프 의미 손실, 커스텀 연산 우회 프레임워크/ONNX/OpenVINO 3단 비교를 합니다.
    단독 벤치마크는 빠른데 API가 안 빨라짐 서비스 외곽 디코딩, 후처리, 직렬화, I/O 병목 모델과 서비스 벤치마크를 분리합니다.
    첫 요청만 느림 초기화 단계 컴파일, 캐시 미사용, 웜업 부재 캐시와 웜업을 넣고 cold start를 따로 측정합니다.
    인텔 CPU 추론 성능 검증과 OpenVINO 도입 병목 분석 이미지

    지연 시간과 처리량, CPU 사용 패턴을 함께 점검하는 검증 장면을 표현한 이미지입니다.

    OpenVINO 도입 검증에서 무엇을 보고 결정할지

    AI 모델 최적화에서 숫자 하나만 보면 거의 항상 놓치는 게 생깁니다. 저는 최소한 아래 네 축을 같이 봅니다.

    1. 기능 동등성: 같은 입력에서 결과 의미가 유지되는지 확인합니다. 분류면 top-k, 탐지면 박스 수와 score 경향, 세그멘테이션이면 마스크 경계를 봅니다.
    2. cold start와 steady state 분리: 첫 요청과 반복 요청을 같은 그래프에 섞지 않습니다.
    3. 단건 지연과 전체 처리량 분리: API냐 배치냐에 따라 좋은 설정이 다릅니다.
    4. 모델 안과 밖 분리: 모델 단독 벤치마크와 서비스 엔드투엔드 벤치마크를 따로 남깁니다.

    이 기준으로 보면 의사결정이 꽤 선명해집니다.

    • 정확도 변화가 없고 지연 시간 편차가 줄었다: 운영 전환 후보로 충분합니다.
    • 처리량은 좋아졌는데 단건 응답이 나빠졌다: 배치 경로엔 적합하지만 실시간 API엔 별도 설정이 필요합니다.
    • 변환 경고가 남고 일부 샘플 출력이 흔들린다: 런타임 튜닝 전에 export와 호환성부터 다시 잡아야 합니다.
    • 모델 숫자는 좋아졌는데 서비스 체감이 없다: 전처리와 후처리, I/O 비용이 본체일 가능성이 큽니다.

    실무에서는 여기서 결론을 분기하면 됩니다. 단건 응답형 서비스면 LATENCY 힌트부터, 다중 요청이나 배치형 작업이면 THROUGHPUT 힌트부터 시작하세요. 두 결과가 서로 다르게 나오면 “어느 쪽이 더 빠른가”보다 “현재 서비스 목표가 어느 쪽인가”로 결정하는 편이 맞습니다.

    운영 전환 체크리스트: 저는 이 항목이 안 채워지면 배포 안 합니다

    • 산출물 이원화: ONNX와 OpenVINO IR을 같이 보관하고, 어떤 버전에서 변환했는지 기록합니다.
    • 입력 계약 문서화: shape, dtype, layout, 채널 순서를 문서와 테스트 샘플로 고정합니다.
    • 검증 샘플 고정: 대표 입력 세트를 정해 변환 전후 비교를 자동화합니다.
    • 성능 측정 분리: 모델 단독 수치와 API 전체 수치를 별도로 저장합니다.
    • 롤백 스위치 유지: OpenVINO 경로에 장애가 나면 ONNX Runtime으로 즉시 되돌릴 수 있어야 합니다.
    • cold start 대비: 웜업 전략과 캐시 디렉터리 사용 여부를 배포 스크립트에 포함합니다.

    여기서 많이 놓치는 게 롤백입니다. 배포 표준을 바꾸는 게 아니라 실행 경로를 하나 더 두는 것이라고 생각하면 결정이 조금 쉬워집니다. 운영 안정성은 새로운 엔진을 넣는 것보다, 문제 났을 때 되돌아갈 길이 있는지가 더 크게 좌우합니다.

    OpenVINO 도입 전후 선택 기준을 정리한 요약 이미지

    어떤 환경에서 OpenVINO 도입이 유리한지 한눈에 정리한 요약 이미지입니다.

    자주 묻는 질문

    ONNX가 이미 있는데 굳이 OpenVINO까지 가야 하나요?

    인텔 CPU 추론이 핵심 경로라면 검토 가치는 충분합니다. 다만 기준은 단순하지 않습니다. ONNX Runtime이 이미 안정적이고 실제 병목이 전처리나 API 레이어라면 굳이 바꿀 이유는 약합니다. 반대로 CPU 지연 편차나 cold start, 요청 처리 패턴 최적화가 고민이라면 OpenVINO를 별도 경로로 두는 편이 낫습니다.

    엣지 AI 환경에서 특히 의미가 큰가요?

    네, 특히 GPU 없는 소형 노드에서 그렇습니다. 다만 “엣지라서 무조건”은 아닙니다. 장점은 하드웨어 특화 최적화와 배포 단순성이고, 단점은 변환 산출물 관리와 호환성 검증이 추가된다는 점입니다. 그래서 저는 엣지 환경일수록 산출물 버전 관리와 입력 스키마 고정을 더 엄격하게 잡습니다.

    도입 순서는 어떻게 잡는 게 안전한가요?

    가장 안전한 순서는 이렇습니다. 학습 코드는 그대로 유지하고, ONNX를 공통 산출물로 두고, OpenVINO IR을 배포 전용 산출물로 추가하세요. 그다음 모델 단독 벤치마크, 기능 비교, 서비스 A/B 테스트 순으로 가면 됩니다. 운영 경로를 한 번에 갈아엎는 방식은 추천하지 않습니다.

    여기서 이렇게 결정하시면 됩니다

    제 판단 기준은 꽤 단순합니다. 인텔 CPU 추론이 핵심이고, ONNX 산출물이 이미 안정적이며, 지금 문제의 본체가 모델 실행 경로라면 OpenVINO 도입 쪽으로 가는 편이 맞습니다. 이 경우에는 학습 스택을 건드리지 말고, 배포 레이어만 OpenVINO로 분기하세요. 특히 실시간 API라면 LATENCY 힌트 중심으로, 배치 작업이라면 THROUGHPUT 힌트 중심으로 검증하면 방향이 빨리 잡힙니다.

    반대로 GPU 최적화 체계가 이미 굳어 있거나, 모델보다 전처리·후처리·네트워크가 더 느리다면 지금 당장 OpenVINO로 옮길 이유는 약합니다. 이런 상황에서는 엔진을 바꾸기보다 병목 측정부터 다시 하는 게 맞습니다. 그리고 커스텀 연산자가 많은 모델이라면 성능 실험보다 먼저 호환성 검증을 별도 작업으로 떼어 두세요. 실무에서는 이 순서를 지키는 팀이 결국 덜 헤맵니다.

  • [AI] Triton Inference Server 프로덕션 배포 가이드와 고려사항

    [AI] Triton Inference Server 프로덕션 배포 가이드와 고려사항

    목차

    Triton Inference Server 프로덕션 배포: 도입 사례와 고려사항

    Triton Inference Server로 AI 모델 배포를 붙일 때, 문제는 대개 모델 정확도보다 운영 계약에서 먼저 터지더라고요. 개발 노트북에서는 잘 돌던 모델이 서비스에 올라가면 지연 시간(latency, 응답 지연), 동시성(concurrency, 동시 처리), 버전 교체, 헬스체크, 타임아웃 정책이 한꺼번에 얽힙니다. 저도 초반엔 “모델만 띄우면 끝”이라고 봤는데, 실제 운영에선 어떤 문제를 Triton으로 해결할지를 먼저 정하는 쪽이 훨씬 중요했습니다. 이번 글은 홈랩과 실무 검증에서 반복해서 확인한 패턴을 바탕으로, Triton을 단순한 AI 모델 서빙 엔진이 아니라 운영 경계(operational boundary)로 보는 관점에서 정리해보겠습니다.

    Triton Inference Server 기반 AI 모델 배포 아키텍처 개요 이미지

    클라이언트, 로드밸런서, Triton 서버, 모델 저장소, 모니터링까지 연결된 전체 구조를 보여주는 개요 이미지입니다.

    Triton Inference Server를 왜 보게 되나

    실무에서 Triton Inference Server가 자꾸 거론되는 이유는 단순합니다. 모델을 한 번 띄우는 건 어렵지 않은데, 같은 방식으로 오래 운영하는 일이 생각보다 어렵거든요. 프레임워크가 제각각이어도 API는 통일하고 싶고, 모델 버전은 분리하고 싶고, GPU는 놀지 않게 쓰고 싶고, 장애가 났을 때는 “서버가 죽었는지”, “모델만 실패했는지”, “큐가 막혔는지”를 빨리 구분하고 싶어집니다. Triton은 이 지점을 꽤 정직하게 해결해줍니다.

    제가 현업에서 Triton을 검토하는 기준은 기능 목록보다 아래 네 가지에 가깝습니다.

    • 모델 프레임워크가 섞여 있는데 운영 인터페이스는 하나로 가져가야 하는가
    • 실시간 추론 API와 소규모 배치 처리 요구가 한 시스템에 같이 들어오는가
    • 버전 롤백, 점진 배포, 모델 상태 점검을 서버 표준으로 묶고 싶은가
    • GPU를 여러 모델이나 여러 테넌트가 나눠 쓰는데, 감이 아니라 지표로 튜닝해야 하는가

    반대로 아래 조건이면 Triton이 과할 수 있습니다.

    • 단일 모델 하나만 낮은 트래픽으로 서비스하고 있고, 모델 교체 주기도 길다
    • 버전 병행 운영보다 애플리케이션 재배포가 더 단순하다
    • 메트릭과 큐 제어보다 구현 속도가 더 중요하다
    • CPU 기반 간단 추론만으로 충분하고, GPU 운영 복잡성을 들일 이유가 없다

    이럴 땐 FastAPI나 Flask 뒤에 모델 하나 붙이고, 앞단 리버스 프록시와 애플리케이션 메트릭만 잘 관리하는 편이 더 낫습니다. Triton은 성능 마법사가 아니라 운영 표준화 도구라서, 표준화가 아직 필요 없다면 이점도 그만큼 줄어듭니다.

    Triton Inference Server 도입 전에 먼저 정해야 하는 질문

    제가 팀에 Triton을 권할지 말지 결정할 때는 제품 요구보다 운영 질문을 먼저 던집니다.

    1. 지연 시간 상한이 빡빡한가: p95, p99 기준으로 큐잉을 얼마나 허용할지 먼저 정해야 dynamic batching을 안전하게 만질 수 있습니다.
    2. 모델 버전이 자주 바뀌는가: 교체 빈도가 높으면 모델 저장소 구조와 로드 정책부터 표준화해야 합니다.
    3. 한 GPU에 몇 개의 모델을 얹을 건가: instance_group의 count를 늘리는 순간 메모리 압박과 컨텍스트 전환 비용이 같이 따라옵니다.
    4. 장애 원인을 5분 안에 좁혀야 하는가: 이 요구가 있다면 health, stats, Prometheus metrics를 갖춘 서빙 계층이 훨씬 유리합니다.

    여기서 자주 놓치는 게 하나 있습니다. Triton은 모델 실행 속도를 빠르게 만드는 도구이기도 하지만, 실제 운영에서는 문제 위치를 빨리 찾게 해주는 도구로 더 큰 가치를 냅니다. 성능이 안 나오는 원인이 모델인지, 큐인지, 게이트웨이 타임아웃인지, 잘못된 입력 계약인지가 빨리 분리되거든요.

    핵심 개념: 모델은 올리는 게 아니라 운영하는 겁니다

    모델 저장소(Model Repository, 모델 저장소) 구조

    Triton은 모델 파일을 임의 경로에서 읽어주는 런타임이 아닙니다. 모델 저장소를 운영 단위로 본다는 점이 핵심입니다. 즉, 파일 배치 규칙이 곧 배포 규칙이 됩니다. 저도 초반에는 구조를 대충 맞췄다가 “컨테이너는 healthy인데 모델만 안 올라오는” 상태를 몇 번 겪었습니다. 그 뒤로는 모델 저장소를 코드 리뷰 대상에 포함시켰습니다.

    models/
    └── resnet50/
        ├── config.pbtxt
        ├── 1/
        │   └── model.onnx
        └── 2/
            └── model.onnx

    1, 2 같은 숫자 디렉터리가 단순 규칙처럼 보여도 운영에선 중요합니다. 버전 롤백, 병행 검증, 정책 기반 선택이 모두 이 구조에서 시작되기 때문입니다. 현업에서는 “모델 파일 교체”보다 “새 버전 디렉터리 추가 후 정책 전환”이 훨씬 덜 위험합니다.

    config.pbtxt: 성능보다 먼저 계약을 명시하는 파일

    많은 팀이 이 파일을 성능 튜닝용으로만 보는데, 저는 먼저 입력·출력 계약 명세서로 봅니다. 입력 이름, shape, 데이터 타입, 배치 허용 여부가 애플리케이션과 달라지는 순간, 서버는 살아 있어도 서비스는 실패합니다. 특히 이미지 추론에선 NHWC와 NCHW 혼동이 정말 자주 나옵니다. 클라이언트 전처리 코드와 config.pbtxt가 같은 문서를 보고 있지 않으면, 장애는 거의 반드시 다시 생기더라고요.

    dynamic batching: 처리량을 사는 대신 큐 대기를 허용하는 선택

    dynamic batching은 단순한 성능 옵션이 아닙니다. 더 정확히 말하면, GPU 효율을 높이기 위해 짧은 대기 시간을 의도적으로 허용하는 정책에 가깝습니다. 요청이 조금 모일 때까지 기다렸다가 한 번에 처리하니 처리량은 좋아질 수 있습니다. 대신 큐에서 기다리는 시간이 생기죠. 그래서 이 기능은 켜느냐 마느냐보다, 어느 정도 지연 증가를 서비스가 받아들일 수 있느냐가 먼저입니다.

    실시간 API라면 보통 max_queue_delay_microseconds를 길게 잡지 않습니다. 반대로 내부 배치성 서비스라면 queue delay를 조금 더 허용해 GPU 효율을 챙길 수 있습니다. 같은 모델이라도 서비스 성격이 다르면 정답이 달라집니다.

    instance_group: 인스턴스를 늘린다고 항상 빨라지진 않습니다

    instance_group은 같은 모델 실행 인스턴스를 CPU나 GPU에 몇 개 둘지 정하는 설정입니다. 여기서 자주 나오는 오해가 “count를 늘리면 병렬성이 늘어 성능이 무조건 좋아진다”는 생각입니다. 실제로는 모델 가중치가 인스턴스 수만큼 메모리를 더 먹고, GPU 메모리 압박이나 컨텍스트 전환 비용 때문에 응답 시간이 오히려 흔들릴 수 있습니다. 저는 이 설정을 만질 때 항상 GPU 메모리 여유, 큐 길이, compute duration 세 가지를 같이 봅니다.

    model control mode: 자동 재로딩의 편의와 운영 사고 가능성은 같이 갑니다

    이 부분은 의외로 글에서 자주 빠지는데, 운영에선 꽤 중요합니다. Triton은 모델 제어 방식을 바꿀 수 있습니다. 파일 변경을 주기적으로 감시하는 방식이 편할 때도 있지만, 프로덕션에서는 의도치 않은 재로딩이나 스토리지 지연이 문제를 만들기도 합니다. 저는 개발·실험 단계에서는 poll 기반 방식이 편하다고 보고, 운영에선 명시적 로드/언로드를 더 선호합니다. 이유는 단순합니다. 모델 교체 타이밍을 배포 파이프라인이 통제해야 장애 원인 추적이 쉬워지기 때문입니다.

    실전 구현: Triton Inference Server 최소 구성부터 올려보기

    처음 검증할 때 쿠버네티스로 바로 가는 접근은 보통 손해가 큽니다. 플랫폼 이슈와 모델 이슈가 섞여버리거든요. 저는 아래 순서로 가져가는 편입니다.

    1. 단일 Docker에서 모델 로딩 성공 여부 확인
    2. 헬스체크, 모델 상태, 메트릭 노출 확인
    3. 입력 계약과 클라이언트 payload 검증
    4. 그다음에야 Ingress, 오토스케일링, 롤링 배포 규칙 추가

    이 순서를 지키면 장애가 났을 때 “플랫폼 문제인지 모델 문제인지”를 훨씬 빨리 가를 수 있습니다.

    1. 모델 저장소와 설정 파일 만들기

    mkdir -p ./models/resnet50/1
    cp ./model.onnx ./models/resnet50/1/model.onnx
    
    cat > ./models/resnet50/config.pbtxt <<'EOF'
    name: "resnet50"
    platform: "onnxruntime_onnx"
    max_batch_size: 8
    
    input [
      {
        name: "input"
        data_type: TYPE_FP32
        dims: [ 3, 224, 224 ]
      }
    ]
    
    output [
      {
        name: "output"
        data_type: TYPE_FP32
        dims: [ 1000 ]
      }
    ]
    
    instance_group [
      {
        kind: KIND_GPU
        count: 1
      }
    ]
    
    dynamic_batching {
      preferred_batch_size: [ 4, 8 ]
      max_queue_delay_microseconds: 1000
    }
    
    version_policy: {
      latest {
        num_versions: 2
      }
    }
    EOF

    이 설정에서 운영 영향이 큰 항목은 네 가지입니다.

    • max_batch_size: 서버가 배치를 어떻게 받아들일지의 상한입니다. 값을 키우기 전에 클라이언트 요청 형식과 모델 shape가 배치를 실제로 감당하는지부터 확인해야 합니다.
    • dynamic_batching: 처리량을 끌어올리는 대신 큐 지연을 허용합니다. 실시간 추론이면 queue delay를 보수적으로 시작하는 편이 안전합니다.
    • instance_group: 병렬성뿐 아니라 GPU 메모리 사용량을 같이 바꿉니다. 메모리 부족이 나면 count 증가가 바로 비용 증가로 이어질 수 있습니다.
    • version_policy: 운영 중 남겨둘 버전 수를 제한합니다. 이걸 명시하지 않으면 저장소에 쌓인 버전이 예기치 않게 운영 면적을 넓힐 수 있습니다.

    실무에서는 config.pbtxt를 모델 산출물과 따로 보지 않고, 애플리케이션 계약 파일처럼 같이 리뷰하는 편이 훨씬 낫습니다. 모델만 바뀌었다고 생각했는데 실제로는 입력 dtype이나 shape가 바뀌는 경우가 적지 않거든요.

    Triton Inference Server 모델 저장소와 config.pbtxt 구성 설명 이미지

    모델 버전 디렉터리, config.pbtxt, 백엔드 선택, 배치 설정의 관계를 이해하기 쉽게 보여주는 구성 이미지입니다.

    2. 컨테이너 실행과 서버 상태 확인

    docker run --gpus=all --rm --name triton \
      -p 8000:8000 \
      -p 8001:8001 \
      -p 8002:8002 \
      -v $(pwd)/models:/models \
      nvcr.io/nvidia/tritonserver:24.01-py3 \
      tritonserver \
        --model-repository=/models \
        --model-control-mode=explicit \
        --load-model=* \
        --log-verbose=1

    포트는 보통 아래 역할로 씁니다.

    • 8000: HTTP endpoint
    • 8001: gRPC endpoint
    • 8002: Prometheus metrics endpoint

    여기서 한 가지 짚고 갈 점이 있습니다. 최근 운영 예시에선 config.pbtxt를 명시적으로 관리하는 쪽이 더 일반적이고, 예전 글에서 자주 보이던 --strict-model-config=true 같은 옵션은 최신 가이드 기준으로 굳이 앞세우지 않는 편이 낫습니다. 또 --model-control-mode=explicit를 쓰면 서버 시작 시 모델을 자동으로 다 올리지 않기 때문에, 위처럼 --load-model=*를 주거나 이후 API로 명시적으로 load해야 합니다. 이 차이를 놓치면 “서버는 떴는데 모델이 없다”는 상황을 바로 만나게 됩니다.

    3. 헬스체크, 개별 모델 상태, 메트릭을 분리해서 봅니다

    curl -s http://localhost:8000/v2/health/live
    curl -s http://localhost:8000/v2/health/ready
    
    curl -s http://localhost:8000/v2/models/resnet50/ready
    curl -s http://localhost:8000/v2/models/resnet50/stats
    
    curl -s http://localhost:8002/metrics | egrep "nv_inference_(request|queue|compute)"

    명시적 제어 모드에서 특정 모델만 따로 올리고 싶다면 아래처럼 repository API를 호출하면 됩니다.

    curl -s -X POST http://localhost:8000/v2/repository/models/resnet50/load

    여기서 중요한 건 ready 하나로 끝내지 않는 것입니다. 컨테이너가 ready여도 개별 모델은 로딩 실패 상태일 수 있습니다. 운영 헬스체크를 설계할 때는 컨테이너 준비 상태와 모델 가용 상태를 분리해야 합니다. 이걸 안 하면 배포는 열렸는데 특정 모델만 실패한 반쪽짜리 정상 상태가 됩니다.

    4. 초기에 꼭 보는 로그 패턴

    제가 검증 초반에 로그에서 먼저 찾는 건 세 종류입니다.

    • backend 관련 메시지: ONNX 모델인데 백엔드 선택이 어긋났거나, 모델 파일 위치가 기대 구조와 다를 때 여기서 드러납니다.
    • shape/dtype 관련 오류: 서버 설정과 클라이언트 payload 계약이 안 맞는 경우입니다.
    • model load/unload 이벤트: 의도한 시점에만 모델이 교체되는지 확인해야 합니다.

    실무에서는 서버가 떠 있는지만 보는 팀이 많습니다. 그런데 실제 장애는 “프로세스 다운”보다 계약 불일치와 큐 적체에서 더 자주 납니다.

    어떤 설정을 먼저 만질지, 비교 표로 보겠습니다

    항목 먼저 보는 상황 얻는 것 대가와 주의점
    dynamic_batching 동시 요청이 몰릴 때 GPU 활용률이 낮고 처리량이 안 나올 때 처리량 증가, GPU 활용 개선 큐 대기 시간이 늘 수 있어 실시간 API의 p95/p99를 해칠 수 있음
    max_queue_delay_microseconds 응답은 느린데 compute 시간보다 queue 시간이 먼저 커질 때 배치 효율과 지연 시간 사이 균형 조절 길게 잡으면 사용자는 “서버가 느리다”고 느끼지만 GPU는 바쁘게 보일 수 있음
    instance_group count 큐 적체가 있고 모델 병렬 실행이 실제로 필요할 때 병렬 처리 증가 가능 모델 메모리 복제, GPU 메모리 압박, 컨텍스트 전환 비용 증가 가능
    version_policy 롤백 요구가 있고 저장소에 여러 버전이 누적될 때 운영 버전 수 통제, 롤백 경로 명확화 버전 보존 전략을 배포 파이프라인과 같이 설계해야 함
    model-control-mode 모델 교체 타이밍을 엄격히 통제해야 할 때 의도한 시점에만 load/unload 수행 배포 자동화가 미흡하면 오히려 운영 절차가 번거로워질 수 있음
    HTTP vs gRPC 게이트웨이 호환성과 SDK 통일성이 중요할 때 팀 표준화 또는 고성능 연동 선택 가능 디버깅 편의, 프록시 호환성, 조직의 운영 경험을 같이 봐야 함

    제 경험상 첫 튜닝 포인트는 대개 배치와 큐입니다. 모델 최적화 전에 큐 정책을 잘못 잡아서 체감 성능을 망치는 경우를 훨씬 많이 봤습니다.

    트러블슈팅: 실제로 많이 걸리는 지점과 근본 원인

    1. 모델이 안 뜨는 경우: 파일이 아니라 운영 단위가 잘못 배치된 상태

    모델 파일을 models/resnet50/model.onnx에 바로 두는 실수는 흔합니다. 겉으로 보면 파일은 있는데, Triton 입장에선 버전이 없는 모델입니다. 운영 관점에서 보면 단순 경로 실수가 아니라 “배포 단위가 정의되지 않은 상태”에 가깝습니다. 로그에서 model version 관련 메시지가 보이면 권한보다 구조를 먼저 의심하는 편이 빠릅니다.

    2. 입력 shape 불일치: 서버 문제처럼 보이지만 계약 문제입니다

    NHWC와 NCHW 혼동, batch 차원 포함 여부, FP32와 UINT8 차이, 입력 이름 오타. 이 네 가지가 특히 잦습니다. 이때 중요한 건 서버를 재시작하는 게 아니라 클라이언트 payload와 config.pbtxt를 한 줄씩 대조하는 겁니다. readiness는 정상인데 요청만 실패하는 패턴이면, 거의 늘 계약 문제입니다.

    제가 자주 보는 실제 시나리오는 이렇습니다. 이미지 업로드 API가 애플리케이션 서버에서 전처리를 한 뒤 Triton으로 넘기는데, 전처리 코드는 NHWC 텐서를 만들고 모델은 NCHW를 기대합니다. 애플리케이션 로그에는 단순 500만 남고, 운영자는 Triton 장애로 오해합니다. 이런 건 모델 서버보다 전처리 코드와 서빙 계약을 같은 저장소에서 관리하지 않은 구조가 근본 원인입니다.

    3. 지연 시간 급증: 실행이 느린 게 아니라 큐가 길어진 경우

    실시간 추론에서 가장 헷갈리는 장애입니다. GPU 사용률은 낮거나 애매한데 응답은 느립니다. 이때는 모델 자체보다 먼저 nv_inference_queue_duration_us를 봐야 합니다. queue duration이 compute duration보다 눈에 띄게 커지면, 문제는 대개 dynamic batching 정책이나 인스턴스 병렬성 부족입니다. 반대로 compute 쪽이 크면 모델 최적화, 백엔드 선택, 하드웨어 자원 부족 쪽이 더 유력합니다.

    여기서 많이 하는 실수가 하나 있습니다. queue가 길다고 바로 instance count를 늘리는 겁니다. 모델이 무거우면 메모리가 더 들어가고, 결국 더 큰 GPU가 필요해져 비용이 올라갑니다. 먼저 queue delay, 요청 패턴, 앞단 연결 풀 크기, 게이트웨이 타임아웃을 같이 보셔야 합니다.

    4. readiness는 OK인데 서비스는 실패하는 경우

    컨테이너 readiness만 보고 배포를 열어버리면 생기는 전형적인 문제입니다. 프로세스는 살아 있고 일부 모델도 로딩됐지만, 실제로 서비스해야 하는 모델은 실패했을 수 있습니다. 운영에서는 단순 포트 체크보다 /v2/models/<name>/ready나 모델 상태 확인을 포함한 상위 헬스체크가 필요합니다. 저는 라우터가 대상 모델의 ready 여부를 확인하지 못하는 구조면, 그 구조부터 위험 신호로 봅니다.

    5. 모델 교체 때만 간헐적으로 장애가 나는 경우

    이건 성능 튜닝보다 배포 설계 문제인 경우가 많습니다. 파일 감시 기반 재로딩, 네트워크 스토리지 지연, 새 버전 업로드 중간 상태 노출이 겹치면 교체 시점에만 이상 현상이 납니다. 그래서 운영에선 새 버전 디렉터리를 완성한 뒤 명시적으로 load하는 절차가 안전합니다. 모델 파일을 덮어쓰는 방식은 복구도 추적도 둘 다 불리합니다.

    Triton Inference Server 메트릭과 실시간 추론 지연 분석 대시보드 이미지

    queue duration, compute duration, request success 지표를 함께 보고 병목을 판단하는 모니터링 예시 이미지입니다.

    검증은 이렇게 봤습니다: 응답이 왔다가 아니라, 병목 위치를 찾는 방식으로

    검증 단계에서 제가 먼저 보는 건 세 가지입니다.

    1. 헬스 상태: live, ready, 개별 모델 ready가 모두 정상인지
    2. 메트릭 이동 방향: 요청이 늘 때 queue duration과 compute duration 중 어디가 먼저 커지는지
    3. 로그 패턴: 로딩 실패, 텐서 계약 오류, 백엔드 초기화 오류가 반복되는지

    여기서 중요한 건 단순 성공률보다 병목 위치의 일관성입니다. 같은 부하 패턴에서 늘 queue가 먼저 커지면 배치 정책 문제일 가능성이 높고, 늘 compute가 먼저 치솟으면 모델 최적화나 하드웨어 부족을 의심하면 됩니다. 증상이 매번 다르면 앞단 게이트웨이, 네트워크, 클라이언트 요청 형식이 흔들리는 경우도 많습니다.

    • nv_inference_request_success가 늘어도 사용자 응답이 느리면 애플리케이션 레벨 타임아웃과 큐 대기를 같이 보셔야 합니다.
    • nv_inference_queue_duration_us가 커지면 dynamic batching의 queue delay, instance_group, 요청 분산을 우선 검토합니다.
    • nv_inference_compute_input_duration_us나 nv_inference_compute_output_duration_us가 크면 전처리·후처리 경계에서 병목이 생길 수 있습니다.
    • GPU 사용률이 낮은데 응답이 느리면 모델 엔진보다 클라이언트 연결 풀, 게이트웨이 timeout, 작은 요청 단위 반복을 먼저 의심하는 편이 맞습니다.

    저는 검증 완료 기준도 조금 보수적으로 잡습니다. 200 OK가 나오는 순간이 아니라, 요청 패턴이 바뀌어도 어느 구간이 먼저 무너지는지 설명 가능해지는 순간을 통과 기준으로 봅니다. 그때부터 운영이 덜 불안해집니다.

    언제 Triton Inference Server가 맞고, 언제 단순 구성이 더 낫나

    상황 추천 이유
    단일 모델, 낮은 트래픽, 빠른 실험 우선 앱 서버 직접 서빙 구조가 단순하고 디버깅 경로가 짧습니다. Triton의 운영 이점이 아직 크지 않습니다.
    여러 모델 병행 운영, 버전 롤백 필요 Triton 도입 모델 저장소, 버전 정책, 상태 점검, 공통 API를 한 계층으로 묶을 수 있습니다.
    GPU 자원을 여러 워크로드가 공유 Triton 우선 검토 배치, 인스턴스, 메트릭 기반 튜닝이 가능해 운영 판단이 빨라집니다.
    팀이 아직 MLOps 표준보다 기능 검증 속도를 더 중시 단일 Docker로 먼저 검증 문제 분리가 쉽고, 불필요한 플랫폼 복잡성을 늦출 수 있습니다.

    핵심은 이겁니다. 운영 표준화가 이미 필요한 팀이면 Triton이 맞고, 아직 모델 가치 검증이 먼저인 단계면 단순 구성이 더 낫습니다. 둘 다 맞는 도구인데, 맞는 시점이 다릅니다.

    실무에서 붙여둘 운영 체크리스트

    • 모델 저장소 구조를 CI 검증 대상에 넣으세요. 버전 디렉터리 규칙이 무너지면 배포 자동화가 바로 흔들립니다.
    • config.pbtxt를 모델 아티팩트와 함께 리뷰하세요. 입력 이름, dtype, shape 계약이 가장 자주 깨집니다.
    • Prometheus metrics를 기본값처럼 붙이세요. 감으로 튜닝하면 queue와 compute를 자꾸 혼동하게 됩니다.
    • 헬스체크는 컨테이너 ready만 보지 말고 개별 모델 ready를 포함하세요.
    • 모델 교체 절차는 파일 덮어쓰기보다 새 버전 디렉터리 추가 후 명시적 load/unload 쪽이 안전합니다.
    • Ingress나 API Gateway 앞단 타임아웃을 같이 보세요. 서버는 정상인데 앞단에서 먼저 끊기는 사례가 생각보다 많습니다.
    • instance_group 증가는 성능 개선안이 아니라 비용 증가안일 수도 있다는 전제로 접근하세요.

    이 체크리스트는 단순해 보여도 실제 장애 예방 효과가 큽니다. 저는 특히 모델 저장소 구조, 계약 파일, 상위 헬스체크 세 개를 먼저 잡는 편입니다. 이 셋이 정리되면 나머지 성능 튜닝은 훨씬 다루기 쉬워집니다.

    관련해서 MLOps 관측성과 모델 성능 최적화 글도 함께 보시면 흐름이 더 잘 잡힙니다. 내부 문서나 사내 기술 블로그가 있다면 이 체크리스트를 기준으로 연결해두는 것도 꽤 편합니다.

    Triton Inference Server 도입 판단 기준과 운영 체크리스트 인포그래픽

    단일 앱 서버 추론과 Triton 기반 운영을 어떤 기준으로 나눌지 한눈에 보는 요약 이미지입니다.

    자주 묻는 질문

    꼭 GPU가 있어야 하나요?

    반드시 그렇진 않습니다. 다만 Triton을 도입하는 실익은 대개 GPU 활용 최적화, 다중 모델 운영, 메트릭 기반 튜닝에서 커집니다. CPU만으로 단일 모델을 단순 서빙하는 상황이면 구조가 과할 가능성이 높습니다.

    처음부터 쿠버네티스로 가야 하나요?

    저는 권하지 않습니다. 단일 컨테이너로 모델 로딩, 상태 확인, 메트릭 노출, 입력 계약 검증까지 끝낸 뒤에 오케스트레이션으로 넘어가는 편이 낫습니다. 플랫폼 문제가 끼어들면 장애 원인 분리가 어려워집니다.

    실시간 추론에 dynamic batching을 켜도 되나요?

    됩니다. 다만 처리량만 보고 켜면 안 되고, queue delay를 짧게 시작한 뒤 p95, p99 지연과 queue duration 변화를 함께 보면서 조정하셔야 합니다. 사용자가 느끼는 느림은 compute보다 queue에서 더 자주 생깁니다.

    모델 버전은 많이 남겨둘수록 안전한가요?

    항상 그렇진 않습니다. 롤백 여지는 늘어나지만, 저장소 관리 범위와 운영 복잡성도 같이 커집니다. 운영에 필요한 수만 남기고, 버전 정책을 배포 파이프라인과 함께 관리하는 편이 더 안정적입니다.

    마무리: 이런 경우엔 Triton이 맞고, 이런 경우엔 단순 구성이 낫습니다

    여러 모델을 함께 운영해야 하고, 버전 교체와 롤백이 잦고, 실시간 추론과 처리량 사이에서 정책 결정을 계속해야 한다면 Triton Inference Server는 꽤 강한 선택지입니다. 특히 운영 중 문제를 성능, 계약, 배포, 관측성 관점으로 분리해 다뤄야 하는 팀이라면 더 그렇습니다.

    반대로 단일 모델 하나를 낮은 트래픽으로 빠르게 붙이는 단계라면, Triton이 기술적으로 가능하더라도 조직적으로는 과할 수 있습니다. 이럴 땐 앱 서버 직접 서빙이 더 낫습니다. 제 권장은 분명합니다. MLOps 요구가 이미 생겼다면 Triton부터 검토하시고, 아직 검증 단계라면 단일 Docker에서 성공 기준을 먼저 만든 뒤 확장하세요. 결국 중요한 건 화려한 기능보다 운영 계약을 어디까지 표준화해야 하느냐입니다. 이 질문이 생기는 순간, Triton은 제값을 합니다.

  • [AI] 벡터 데이터베이스 비교: Qdrant vs ChromaDB 선택 가이드

    [AI] 벡터 데이터베이스 비교: Qdrant vs ChromaDB 선택 가이드

    [AI] 벡터 데이터베이스 비교: Qdrant vs ChromaDB 선택 가이드

    RAG를 붙일 때 많은 분이 처음엔 임베딩 품질이나 프롬프트부터 만지십니다. 그런데 실무에선 장애가 저장소 계층에서 먼저 터지는 경우가 꽤 많더라고요. 벡터 데이터베이스 비교를 대충 하고 들어가면, 나중에 검색 필터가 느려지거나 재기동 뒤 데이터가 비어 보이거나 팀이 늘면서 컬렉션 규칙이 꼬이기 시작합니다.

    이번 글은 기능 목록을 나열하는 비교가 아닙니다. Qdrant와 ChromaDB를 어디서 갈라 써야 덜 갈아엎는지, 그리고 어떤 실수에서 실제 비용이 커지는지를 중심으로 보겠습니다. 하루 만에 PoC를 띄우는 문제와 6개월 뒤 운영팀이 덜 고생하는 구조를 고르는 문제는 꽤 다르거든요.

    벡터 데이터베이스 비교를 위한 Qdrant와 ChromaDB 아키텍처 개요 이미지

    RAG 파이프라인에서 임베딩 생성기, 벡터 저장소, 검색 API가 어떻게 연결되는지 한눈에 보여주는 개요 이미지입니다.

    벡터 데이터베이스 비교에서 왜 Qdrant와 ChromaDB가 자주 같이 언급될까

    둘 다 임베딩을 저장하고 유사한 벡터를 찾는다는 점은 같습니다. 다만 실무에서 중요한 건 저장 방식보다 운영 계약입니다. 같은 검색 저장소라도 애플리케이션이 기대하는 규칙이 다르면, 나중에 갈아타기 비용이 확 커집니다.

    • Qdrant는 서버 중심 구조라 컬렉션, 거리 함수, 필터, 인덱스, 헬스체크 같은 운영 요소가 비교적 명시적입니다.
    • ChromaDB는 개발 속도를 우선하는 경험이 강합니다. 로컬 실험이나 Python 중심 워크플로에 바로 넣기 편합니다.
    • 둘 다 메타데이터를 함께 저장해 RAG에 연결하기 좋지만, 필터를 얼마나 진지하게 다뤄야 하는지에서 체감 차이가 크게 납니다.

    제가 실제로는 이렇게 나눕니다. 한 프로세스가 실험용으로 쓰는가, 여러 서비스가 동시에 접근하는가. 이 질문에 답하면 절반은 이미 정리됩니다.

    이 비교에서 먼저 봐야 할 핵심 포인트

    벡터 DB를 고를 때 성능 숫자부터 찾기 쉬운데, 초기에 더 큰 차이를 만드는 건 아래 네 가지였습니다.

    1. 접근 모델: 같은 프로세스 안에서 쓰는지, HTTP나 gRPC로 외부에서 붙는지
    2. 필터 비중: 유사도 검색만 하는지, tenant/team/date/service 필터가 늘 붙는지
    3. 스키마 통제: 컬렉션 규칙을 코드로 강제하는지, 팀 규약에 맡기는지
    4. 운영 책임: 백업, 재시작, health check, 접근 제어를 누가 챙길지

    이걸 무시하고 간단해 보여서 고르면 나중에 삽질 포인트가 비슷합니다. 검색 품질 문제가 아니라, 저장 규칙과 조회 규칙이 분리되어 있지 않아서 생기는 문제인 경우가 많거든요.

    Qdrant vs ChromaDB, 실무에서 체감되는 차이

    비교 항목 Qdrant ChromaDB
    기본 성격 서버형 벡터 검색 엔진에 가깝습니다. 로컬 개발과 빠른 실험에 강한 벡터 데이터베이스입니다.
    처음 붙이는 속도 컬렉션 규칙을 먼저 생각해야 해서 초반 인지 부하가 있습니다. Python에서 바로 컬렉션 만들고 넣어보기가 쉽습니다.
    멀티앱 접근 여러 서비스가 API로 붙는 구성이 자연스럽습니다. 가능하지만 운영 원칙을 애플리케이션 쪽에서 더 엄격히 잡아야 편합니다.
    필터 중심 검색 payload filter와 payload index 전략을 세우기 좋습니다. where 필터는 편하지만 운영 규칙까지 자동으로 대신해주진 않습니다.
    구성 명시성 거리 함수, 인덱스, 헬스체크, 보안 경계가 비교적 분명합니다. 개발 경험은 가볍지만 구조적 제약은 덜 강합니다.
    어울리는 시점 서비스화가 보이거나 필터가 핵심인 RAG 노트북 실험, 내부 도구 MVP, 데이터 흐름 검증
    피해야 할 경우 오늘 안에 실험값만 확인하면 되는 초경량 테스트 여러 팀이 동시에 붙고 운영 경계가 분명해야 하는 환경

    현업에서 자주 보는 오판도 비슷합니다. ChromaDB를 간단하니 일단 운영까지 가보자로 시작했다가, 나중에 운영 규칙을 보강하느라 구조 비용을 뒤늦게 치르는 경우가 많습니다. 반대로 처음부터 Qdrant를 넣고도 실제로는 단일 Python 작업 하나만 돌리면서 서버 운영 부담만 떠안는 경우도 있고요.

    핵심 개념은 정의보다 실패 모드로 이해하는 편이 빠릅니다

    임베딩 차원은 설정값이 아니라 저장 계약입니다

    초보 때는 임베딩 차원을 모델 속성 정도로 넘기기 쉽습니다. 그런데 운영에서는 거의 스키마 역할을 합니다. 384차원으로 만든 컬렉션에 768차원 질의를 보내면, 그 순간 문제는 검색 품질이 아니라 저장 계약 위반입니다.

    • 컬렉션 생성 시 차원을 고정합니다.
    • 임베딩 모델 교체는 새 컬렉션 생성으로 보는 편이 안전합니다.
    • 질의 임베딩과 적재 임베딩의 생성 경로를 분리해두면 언젠가 꼭 사고가 납니다.

    저는 보통 <code>embedding_model, embedding_dimension, distance_metric를 같은 설정 파일이나 환경 변수 묶음에서 읽게 합니다. 모델만 바꾸고 컬렉션은 그대로 쓰는 실수, 이거 생각보다 자주 나옵니다.

    필터는 부가 기능이 아니라 RAG 품질 제어 장치입니다

    RAG에서 벡터 검색 결과가 이상하다는 말의 절반은 임베딩 성능 문제가 아닙니다. 검색 범위를 제어하지 않은 채 서로 다른 문서군을 한 컬렉션에 섞어 넣은 경우가 많습니다. 예를 들어 운영 런북과 제품 FAQ를 같은 컬렉션에 넣고 service나 source 필터 없이 질의하면, 유사도 상위권에 엉뚱한 문서가 뜨는 게 오히려 자연스럽습니다.

    이럴 때 중요한 건 top-k 숫자를 바꾸는 게 아니라 후보 집합을 먼저 줄이는 것입니다. 이 관점에 익숙해지면 Qdrant의 payload index가 왜 자주 언급되는지 바로 감이 옵니다.

    실전 구현: 같은 데이터를 Qdrant와 ChromaDB에 넣어보면

    여기서는 4차원 더미 벡터를 쓰겠습니다. 숫자는 단순하지만 컬렉션 정의 방식과 필터 흐름 차이는 그대로 드러납니다. 실제 프로젝트에선 여기에 임베딩 모델과 청킹 전략만 얹으면 됩니다. RAG 청킹 전략이나 LLM 임베딩 선택 글과 함께 보면 더 입체적으로 보이실 거예요.

    1. Docker로 두 저장소를 분리해서 띄우기

    이 단계부터 운영 감각이 드러납니다. 테스트라도 데이터 디렉터리와 헬스체크를 분리해서 보는 편이 좋습니다. 나중에 검색이 이상할 때 애플리케이션 오류인지 저장소 상태 문제인지 빨리 분리할 수 있거든요.

    services:
      qdrant:
        image: qdrant/qdrant
        container_name: qdrant
        ports:
          - "6333:6333"
          - "6334:6334"
        volumes:
          - ./qdrant_storage:/qdrant/storage
        healthcheck:
          test: ["CMD", "curl", "-f", "http://localhost:6333/healthz"]
          interval: 30s
          timeout: 10s
          retries: 3
    
      chroma:
        image: chromadb/chroma:1.5.9
        container_name: chroma
        environment:
          - IS_PERSISTENT=TRUE
        ports:
          - "8000:8000"
        volumes:
          - ./chroma_data:/data
        healthcheck:
          test: ["CMD", "curl", "-f", "http://localhost:8000/api/v2/heartbeat"]
          interval: 30s
          timeout: 10s
          retries: 3

    올릴 때는 이렇게 확인하시면 됩니다.

    docker compose up -d
    
    docker ps --format 'table {{.Names}}\t{{.Status}}\t{{.Ports}}'
    curl -f http://localhost:6333/healthz
    curl -f http://localhost:8000/api/v2/heartbeat

    여기서 제가 보는 포인트는 세 가지입니다.

    • 컨테이너가 Started인지보다 health check 통과 여부를 먼저 봅니다.
    • Qdrant는 6333이 REST, 6334가 gRPC라서 클라이언트 종류에 따라 포트를 명확히 나눠야 합니다.
    • ChromaDB는 Docker에서 /data 볼륨만 마운트한다고 끝이 아닙니다. 영속 모드 설정까지 확인해야 재기동 후 데이터가 남습니다.
    벡터 데이터베이스 비교 실습을 위한 Qdrant와 ChromaDB 홈랩 구성 이미지

    개발 PC 또는 홈랩 서버에서 두 컨테이너가 각각 다른 포트와 볼륨을 사용하는 모습을 보여주는 구성 이미지입니다.

    2. Qdrant는 컬렉션 규칙을 먼저 명시하는 편이 낫습니다

    Qdrant의 장점은 처음부터 규칙을 분명히 적게 만든다는 점입니다. 초반엔 조금 번거롭지만, 나중에 누가 봐도 이 컬렉션이 어떤 가정 위에 만들어졌는지가 남습니다. 운영 단계에 들어가면 이 차이가 꽤 크게 느껴집니다.

    from qdrant_client import QdrantClient, models
    
    client = QdrantClient(url="http://localhost:6333")
    
    client.create_collection(
        collection_name="docs",
        vectors_config=models.VectorParams(
            size=4,
            distance=models.Distance.COSINE,
        ),
    )
    
    client.create_payload_index(
        collection_name="docs",
        field_name="service",
        field_schema=models.PayloadSchemaType.KEYWORD,
    )
    
    client.upsert(
        collection_name="docs",
        wait=True,
        points=[
            models.PointStruct(
                id=1,
                vector=[0.12, 0.45, 0.33, 0.91],
                payload={"source": "runbook", "service": "nginx", "env": "prod"},
            ),
            models.PointStruct(
                id=2,
                vector=[0.10, 0.40, 0.30, 0.88],
                payload={"source": "wiki", "service": "kubernetes", "env": "dev"},
            ),
        ],
    )
    
    result = client.query_points(
        collection_name="docs",
        query=[0.11, 0.44, 0.31, 0.90],
        query_filter=models.Filter(
            must=[
                models.FieldCondition(
                    key="service",
                    match=models.MatchValue(value="nginx"),
                )
            ]
        ),
        with_payload=True,
        limit=2,
    )
    
    for point in result.points:
        print(point.id, point.score, point.payload)

    여기서 중요한 건 검색 API 호출 자체보다, 필터에 자주 쓸 필드를 별도로 인덱싱하는 사고방식입니다. Qdrant는 이 지점이 분명해서 service나 env 같은 운영 규칙을 코드로 남기기 좋습니다.

    3. ChromaDB는 시작 속도가 정말 빠릅니다

    ChromaDB의 강점은 여기서 딱 드러납니다. 코드가 가볍고 Python 워크플로 안에 자연스럽게 들어옵니다. 노트북에서 문서 검색 아이디어를 검증할 때는 이거 진짜 편하더라고요.

    다만 Docker로 서버를 띄웠다면 클라이언트도 그에 맞게 HttpClient로 붙이는 게 맞습니다. 로컬 디스크를 직접 쓰는 PersistentClient 예제와 서버 모드 예제를 섞으면 저장 위치를 헷갈리기 쉽습니다.

    import chromadb
    
    client = chromadb.HttpClient(host="localhost", port=8000)
    collection = client.get_or_create_collection(name="docs")
    
    collection.upsert(
        ids=["1", "2"],
        embeddings=[
            [0.12, 0.45, 0.33, 0.91],
            [0.10, 0.40, 0.30, 0.88],
        ],
        metadatas=[
            {"source": "runbook", "service": "nginx", "env": "prod"},
            {"source": "wiki", "service": "kubernetes", "env": "dev"},
        ],
        documents=[
            "Nginx timeout troubleshooting guide",
            "Kubernetes deployment checklist",
        ],
    )
    
    results = collection.query(
        query_embeddings=[[0.11, 0.44, 0.31, 0.90]],
        n_results=2,
        where={"service": "nginx"},
        include=["documents", "metadatas", "distances"],
    )
    
    print(results)

    제가 계속 강조하는 건 하나입니다. 개발이 쉽다는 것과 운영 계약이 강하다는 것은 다르다는 점입니다. ChromaDB는 빠르게 붙일 수 있지만, 팀이 커질수록 어떤 metadata를 반드시 넣어야 하는지, 컬렉션 이름 규칙은 뭔지, 서버 모드 접속은 어디까지 허용할지 같은 규칙을 애플리케이션 계층에서 더 엄격히 정해야 편해집니다.

    4. Qdrant는 필터가 늘어날수록 차이가 커집니다

    RAG를 운영하다 보면 질문 자체보다 조회 범위 제약이 더 중요해지는 순간이 옵니다. 예를 들어 테넌트별 격리, 운영/개발 문서 분리, 날짜 기반 문서 제한이 붙기 시작하면 벡터만 가까우면 된다는 가정이 금방 무너집니다.

    curl -X PUT 'http://localhost:6333/collections/docs' \
      -H 'Content-Type: application/json' \
      --data '{
        "vectors": {
          "size": 4,
          "distance": "Cosine"
        }
      }'
    
    curl -X PUT 'http://localhost:6333/collections/docs/index?wait=true' \
      -H 'Content-Type: application/json' \
      --data '{
        "field_name": "service",
        "field_schema": "keyword"
      }'
    
    curl -X POST 'http://localhost:6333/collections/docs/points/query' \
      -H 'Content-Type: application/json' \
      --data '{
        "query": [0.11, 0.44, 0.31, 0.90],
        "filter": {
          "must": [
            {
              "key": "service",
              "match": {"value": "nginx"}
            }
          ]
        },
        "with_payload": true,
        "limit": 2
      }'

    실무적으로는 이 차이가 꽤 큽니다. 단순 유사도 검색만 할 때는 둘 다 큰 불편 없이 갈 수 있지만, 필터가 검색 품질의 일부가 되는 순간 Qdrant 쪽이 구조를 유지하기 더 쉽습니다.

    Qdrant와 ChromaDB의 벡터 데이터베이스 비교 흐름도 이미지

    필터 조건이 붙은 검색 요청이 각각 어떤 경로로 처리되는지 비교하는 다이어그램입니다.

    성능보다 먼저 봐야 하는 결정 포인트

    판단 질문 Qdrant 쪽으로 기울 때 ChromaDB 쪽으로 기울 때
    누가 붙나요? 여러 앱, 여러 컨테이너, 별도 API 서버 Python 작업 하나, 내부 분석 스크립트, 개인 실험
    필터가 중요한가요? tenant, service, env, date 같은 조건이 자주 붙음 대부분 의미 기반 검색만 하고 필터는 단순함
    데이터 계약을 강하게 가져갈 건가요? 컬렉션 규칙과 인덱스 전략을 문서화하고 유지해야 함 빠르게 만들고 버려도 되는 실험 비중이 큼
    운영 장애를 누가 받나요? 서비스 운영팀, SRE, 플랫폼 팀이 관여함 개발자 본인이 로컬 혹은 소규모 앱을 직접 돌림
    마이그레이션 비용을 감수할 수 있나요? 초기부터 안정된 구조가 필요함 일단 검증 후 나중에 옮겨도 괜찮음

    추천하는 사고방식은 단순합니다. 지금 필요한 단순함과 나중에 치를 복잡도를 따로 계산하셔야 합니다. ChromaDB는 지금 당장 단순하고, Qdrant는 나중 복잡도를 미리 줄여줍니다.

    흔한 실패 모드와 근본 원인

    1. 임베딩 차원 불일치

    이건 단순 실수라기보다 설정 분리의 결과입니다. 문서 적재 코드와 질의 코드가 서로 다른 임베딩 모델 설정을 읽고 있으면 언젠가 반드시 터집니다. 특히 배치 적재 스크립트와 API 서버가 따로 배포될 때 자주 나옵니다.

    근본 원인은 하나입니다. 임베딩 모델 계약이 코드 여러 군데에 흩어져 있는 것입니다.

    1. 컬렉션 생성 시 차원과 거리 함수를 명시합니다.
    2. 애플리케이션 시작 시점에 임베딩 차원 검증을 넣습니다.
    3. 모델 교체는 기존 컬렉션 수정이 아니라 새 컬렉션 생성과 재색인으로 처리합니다.

    2. 컨테이너는 멀쩡한데 데이터가 안 남습니다

    이건 벡터 DB 문제처럼 보이지만, 실제로는 저장 경로나 영속 모드 설정 문제인 경우가 많습니다. 특히 팀원이 HttpClient 기반 서버 모드와 PersistentClient 기반 로컬 모드를 섞어 쓰면 어제 넣은 데이터가 왜 오늘 안 보이지 하는 상황이 바로 생깁니다.

    근본 원인은 저장 위치와 실행 모드가 실행 방식마다 다르다는 사실을 팀이 공유하지 않는 것입니다.

    docker inspect qdrant --format '{{json .Mounts}}'
    docker inspect chroma --format '{{json .Mounts}}'
    docker logs qdrant --tail 100
    docker logs chroma --tail 100

    이때 제가 보는 기준은 아래 세 가지입니다.

    • Mounts에 기대한 호스트 경로가 잡혀 있는지
    • 컨테이너 내부 경로가 Qdrant는 /qdrant/storage, Chroma는 /data로 맞는지
    • Chroma 서버가 영속 모드로 떠 있는지, 재기동 후 같은 디렉터리의 데이터가 유지되는지

    3. 필터가 없어서 검색 품질이 망가집니다

    운영 가이드를 예로 들어보겠습니다. service=nginx인 문서와 service=kubernetes인 문서를 한 컬렉션에 넣고, 사용자가 배포 후 응답 지연이라고 묻는 상황을 떠올려보세요. 메타데이터 필터가 없으면 벡터 상으로 비슷한 쿠버네티스 배포 체크리스트가 먼저 튈 수 있습니다. 이건 DB가 잘못한 게 아니라 검색 범위를 제어하지 않은 겁니다.

    근본 원인은 벡터 검색을 전체 문서군에 대한 만능 검색으로 오해하는 것입니다.

    • 출처가 다르면 source를 반드시 넣습니다.
    • 서비스 경계가 있으면 service나 tenant를 필수 메타데이터로 강제합니다.
    • 질문이 특정 문서군 전용이면 유사도 검색 전에 필터로 후보군을 줄입니다.

    4. 느린 건 벡터 연산보다 필터 설계인 경우가 많습니다

    특히 Qdrant에서는 필터에 자주 쓰는 payload field를 인덱싱하지 않은 채 왜 검색이 무겁지로 가는 경우가 꽤 많습니다. 반대로 모든 필드를 무작정 인덱싱하는 것도 메모리와 디스크 비용을 늘립니다. 결국 핵심은 많이 쓰는 필드가 아니라 결과 집합을 가장 강하게 줄이는 필드를 먼저 고르는 것입니다.

    예를 들어 color처럼 값 종류가 몇 개 안 되는 필드보다, tenant_id나 document_type처럼 검색 공간을 크게 좁히는 필드가 인덱스 우선순위가 높습니다. 이건 문서만 읽을 때보다 운영에 들어가면 더 강하게 체감됩니다.

    검증: 무엇을 보면 잘 붙었다고 판단할까

    저는 벡터 저장소를 붙이고 나면 벤치마크보다 먼저 아래 네 단계를 확인합니다. 이걸 통과하지 못하면 성능 수치는 큰 의미가 없습니다.

    1. 재조회 가능성: 넣은 id나 문서가 같은 컬렉션에서 다시 조회되는지
    2. 필터 정확성: service=nginx 같은 조건이 틀리지 않고 적용되는지
    3. 재기동 내구성: 컨테이너 재시작 후 데이터가 그대로 남는지
    4. 질의 일관성: 비슷한 표현을 바꿔도 같은 문서군이 안정적으로 상위에 오는지

    여기서 작은 재현 시나리오 하나를 권합니다. 운영 런북 5개, 개발 위키 5개를 넣고 아래처럼 질의를 세 번 바꿔보세요.

    • nginx timeout 원인
    • reverse proxy 지연
    • 응답이 늦을 때 점검 순서

    세 질의 모두 nginx 런북 군집 안에서 놀아야 정상입니다. 결과가 매번 다른 문서군으로 튄다면 저장소 자체보다도 청킹, 메타데이터 설계, 필터 적용 순서를 먼저 의심하셔야 합니다.

    벡터 데이터베이스 비교 검증을 위한 검색 결과 대시보드 이미지

    질의별 상위 결과, score, source/service 메타데이터를 함께 검토하는 검증 화면을 묘사한 이미지입니다.

    언제 Qdrant를 고르고, 언제 ChromaDB를 고를까

    여기서는 애매하게 말하지 않겠습니다.

    • Qdrant를 고르세요: 여러 애플리케이션이 같은 저장소를 공유한다, 메타데이터 필터가 검색 품질의 핵심이다, 운영 환경에서 health check와 접근 경계를 분명히 해야 한다, 컬렉션 규칙을 코드와 설정으로 남기고 싶다.
    • ChromaDB를 고르세요: Python 중심으로 빠르게 검증해야 한다, 혼자 혹은 작은 팀이 로컬/내부 도구를 먼저 만들어야 한다, 구조보다 속도가 우선이다, 나중에 서버형 구조로 옮길 가능성을 감수할 수 있다.

    현실적인 흐름도 있습니다.

    1. 아이디어 검증은 ChromaDB로 짧게 가져갑니다.
    2. 필터와 멀티서비스 요구가 보이면 Qdrant 이전 비용을 계산합니다.
    3. 처음부터 운영형 RAG라면 굳이 돌아가지 말고 바로 Qdrant로 갑니다.

    반대로 말하면 이렇습니다. ChromaDB를 오래 운영하려면 애플리케이션이 질서를 대신 만들어야 하고, Qdrant를 가볍게 쓰려면 서버 운영 부담을 감수해야 합니다. 둘 중 어느 비용을 지금 낼지 정하는 문제입니다.

    자주 묻는 질문

    ChromaDB도 서버처럼 쓸 수 있나요?

    가능합니다. 공식 문서 기준으로 Docker 컨테이너와 HttpClient 조합이 지원됩니다. 다만 서버 모드로 가는 순간부터는 편한 로컬 도구가 아니라 운영 대상이 되니, 접근 제어와 저장 경로, 영속 모드까지 같이 챙기셔야 합니다.

    Qdrant는 너무 무거운 선택 아닌가요?

    단일 프로세스 실험만 할 거라면 과할 수 있습니다. 하지만 필터가 중요한 RAG, 여러 서비스가 붙는 구조, 운영팀이 관여하는 환경에서는 초반에 규칙을 명시해두는 편이 오히려 나중 비용을 줄여줍니다.

    둘 다 알아야 하나요?

    짧게라도 둘 다 만져보시는 편이 좋습니다. 같은 데이터셋으로 두 저장소를 각각 붙여보면 내 프로젝트가 진짜 원하는 게 개발 속도인지, 운영 계약인지 감이 꽤 빨리 옵니다.

    벡터 데이터베이스 비교와 선택 기준을 정리한 Qdrant 대 ChromaDB 인포그래픽

    프로토타입, 사내 도구, 운영 서비스, 복잡한 필터링 등 상황별 추천 선택지를 요약한 이미지입니다.

    마무리

    벡터 데이터베이스 비교에서 중요한 건 누가 더 유명한지가 아니라, 내 검색 시스템이 어디서 깨질 가능성이 높은가입니다. 혼자 빠르게 RAG를 검증하는 단계라면 ChromaDB가 훨씬 민첩합니다. 반대로 필터와 운영이 본격적으로 중요해지는 순간부터는 Qdrant가 구조를 잡기 수월합니다.

    제 판단을 한 줄로 압축하면 이렇습니다. 오늘 바로 실험해야 하면 ChromaDB, 내일 운영팀이 붙을 게 보이면 Qdrant. 이 기준으로 가시면 초반 속도와 이후 유지비 사이에서 덜 후회할 가능성이 큽니다.

  • [AI] Ollama 커스텀 LLM 가이드: Modelfile 사용법과 실전 구축

    [AI] Ollama 커스텀 LLM 가이드: Modelfile 사용법과 실전 구축

    Ollama 커스텀 LLM 가이드: Modelfile 사용법과 실전 구축

    Ollama 커스텀 LLM을 오래 만지다 보면, 결국 성능 숫자보다 출력 습관을 통제하고 싶다는 요구가 더 자주 생기더라고요. 답변은 꼭 한국어로 나오게 하고 싶다든지, 명령어를 먼저 보여주고 설명은 뒤로 보내고 싶다든지, 모르면 지어내지 말고 확인이 필요하다고 말하게 만들고 싶을 때가 그렇습니다. 이럴 때 가장 먼저 손대기 좋은 게 Modelfile입니다.

    다만 기대치는 정확히 잡아야 합니다. Modelfile은 보통 사람들이 떠올리는 “모델 재학습” 자체와는 다릅니다. 실무 감각으로 말하면, 베이스 모델의 가중치를 새로 만드는 도구라기보다 실행 규약을 모델 단위로 고정하는 계층에 가깝습니다. 이 차이를 이해해 두면 왜 어떤 문제는 SYSTEM 한 줄로 풀리고, 어떤 문제는 ADAPTER나 RAG까지 가야 하는지 훨씬 빨리 감이 옵니다.

    이번 글은 로컬 AI 모델 개발 관점에서, Ollama의 Modelfile로 어디까지 바꿀 수 있는지, 어디서 멈추는 게 맞는지, 그리고 실제로 자주 깨지는 지점이 무엇인지까지 한 번에 정리한 글입니다. 문법과 API 필드는 Ollama 공식 Modelfile 문서, Create API 문서, Generate API 문서 기준으로 다시 확인했습니다.

    로컬 환경에서 베이스 모델 위에 Modelfile을 얹어 커스텀 모델을 만드는 전체 흐름입니다.

    1. Ollama 커스텀 LLM이 실무에서 먹히는 이유는 재현성 때문입니다

    제가 Modelfile을 계속 쓰는 이유는 단순합니다. 사람은 매번 같은 프롬프트를 정교하게 붙이기 어렵지만, 파일은 늘 같은 방식으로 동작하거든요. 특히 팀 단위로 로컬 모델을 쓰기 시작하면 모델 품질보다 먼저 문제 되는 게 사람마다 다른 사용 습관입니다. 어떤 분은 시스템 프롬프트를 길게 넣고, 어떤 분은 짧게 넣고, 어떤 분은 아예 안 넣습니다.

    이때 Modelfile은 계약서를 하나 만들어 줍니다. SYSTEM, TEMPLATE, PARAMETER, MESSAGE, ADAPTER를 모델 이름 뒤에 고정해 두니, 같은 이름을 호출하는 한 최소한의 행동 일관성은 확보됩니다. 이거 진짜 편하더라고요. 문서 초안 작성, 운영 가이드 보조, 코드 리뷰 보조처럼 반복성이 높은 작업일수록 차이가 분명합니다.

    • 반복 프롬프트 제거: 매번 붙이던 역할 설명과 금지 규칙을 모델 단위로 고정합니다.
    • 출력 형식 표준화: “명령어 먼저, 설명 나중” 같은 우선순위를 팀 공통 규약으로 만들기 좋습니다.
    • 실험 버전 분리: 같은 베이스 모델에서 보수형, 설명형, 요약형 모델을 나눠 비교하기 쉽습니다.
    • 장애 원인 분리: 모델 자체 문제인지, 템플릿 문제인지, 파라미터 문제인지 추적이 빨라집니다.

    2. Ollama 커스텀 LLM에서 먼저 선을 그어야 합니다: Modelfile이 바꾸는 것과 못 바꾸는 것

    여기서 선을 분명히 그어야 삽질이 줄어듭니다. Modelfile은 행동 규칙, 입력 형식, 실행 파라미터, 예시 대화, 어댑터 연결은 잘 다룹니다. 반면 모델 내부 지식 자체를 새로 학습시키는 일은 기본적으로 하지 못합니다. 문서 몇 줄 넣었다고 도메인 지식을 완전히 새로 습득하는 구조는 아니라는 뜻입니다.

    실제로는 이렇게 나누면 편합니다. “답변의 순서나 톤이 문제냐”면 Modelfile 쪽입니다. “모델이 특정 도메인 지식을 계속 모르거나 아는 척 틀리느냐”면 ADAPTER, RAG, 또는 더 맞는 베이스 모델을 검토하는 편이 맞습니다.

    문제 유형 우선 선택 이유 피해야 할 접근
    답변 톤이 들쭉날쭉함 SYSTEM + MESSAGE 행동 규칙과 말투는 프롬프트 계층에서 통제가 잘 됩니다 바로 ADAPTER부터 붙이기
    출력 형식이 자꾸 깨짐 TEMPLATE + stop 재검토 채팅 포맷 불일치일 가능성이 큽니다 모델 성능 탓으로 돌리기
    응답이 너무 산만하거나 창의성이 과함 PARAMETER 조정 temperature, top_p, num_ctx 영향이 큽니다 SYSTEM 문구만 계속 길게 늘리기
    특정 도메인 지식을 안정적으로 못 씀 ADAPTER 또는 RAG 검토 행동 지시만으로는 한계가 분명합니다 MESSAGE 예시를 과도하게 누적하기
    팀원마다 결과가 다름 Modelfile로 모델 이름 표준화 입력 규약 자체를 버전 관리할 수 있습니다 사람마다 프롬프트 템플릿 수동 복붙

    3. Modelfile 핵심 지시어는 많아 보여도 실무 우선순위는 분명합니다

    공식 문서에 나오는 지시어는 여러 개지만, 처음 모델을 잡을 때 자주 쓰는 순서는 거의 고정입니다. 보통 FROM → SYSTEM → PARAMETER → MESSAGE가 1차 세트입니다. TEMPLATE와 ADAPTER는 필요성이 분명할 때만 올리는 편이 안전합니다.

    지시어 실무 우선순위 주로 쓰는 상황 주의점
    FROM 최상 출발 베이스 모델 지정 이 선택이 나머지 품질과 호환성의 기준점이 됩니다
    SYSTEM 최상 역할, 금지사항, 출력 순서 고정 길이보다 우선순위가 중요합니다
    PARAMETER 높음 일관성, 컨텍스트, 중단 토큰 제어 값 하나로 안정성이 흔들릴 수 있습니다
    MESSAGE 높음 few-shot 예시 내장 예시를 많이 넣을수록 답변이 경직되기 쉽습니다
    TEMPLATE 중간 채팅 포맷을 명시적으로 제어할 때 베이스 템플릿과 stop이 어긋나면 토큰 누수가 납니다
    ADAPTER 상황 의존 LoRA 또는 QLoRA 결과물 적용 베이스 모델 불일치가 나면 품질이 급격히 무너집니다
    LICENSE 공유 시 중요 배포 또는 팀 공유 내부 사용과 외부 배포 조건을 분리해서 봐야 합니다
    REQUIRES 환경 의존 특정 Ollama 최소 버전 고정 버전 미충족이면 원인 모를 생성 실패처럼 보일 수 있습니다

    효율이 좋은 규칙은 하나입니다. 첫 번째 성공 모델은 단순하게 만들고, 두 번째 버전부터 정교화하는 쪽이 낫습니다. 처음부터 요소를 다 얹으면 실패했을 때 어느 레이어가 원인인지 식별하기가 어렵습니다.

    4. 실전 구현 1단계: 베이스 모델의 원본 템플릿부터 확인하세요

    많이 놓치는 단계인데, 사실상 필수에 가깝습니다. 커스텀 모델을 만들기 전에 ollama show --modelfile로 베이스 모델의 기본 구조를 먼저 봐야 합니다. 이유는 간단합니다. 모델마다 기대하는 채팅 템플릿과 stop 토큰이 다를 수 있기 때문입니다.

    ollama pull llama3.2
    ollama show --modelfile llama3.2
    ollama show --modelfile llama3.2 > base-llama3.2.Modelfile

    저는 보통 세 번째 줄까지 같이 해둡니다. 원본을 파일로 떠놓으면 수정 중에 기준점을 잃지 않거든요. 특히 stop 토큰과 TEMPLATE 블록은 기억으로 다시 쓰기보다 원본에서 필요한 만큼만 복사하는 쪽이 훨씬 안전합니다.

    그다음 1차 버전은 작게 갑니다. 출력 우선순위, 언어 정책, 추측 금지 같은 운영 규약만 넣어도 충분한 경우가 많습니다.

    mkdir -p ~/ollama-custom/workshop
    cd ~/ollama-custom/workshop
    cat > Modelfile <<'EOF'
    FROM llama3.2
    PARAMETER temperature 0.2
    PARAMETER num_ctx 4096
    SYSTEM """당신은 한국어로 답변하는 인프라 엔지니어 보조 AI입니다.
    답변은 항상 다음 순서를 지킵니다.
    1. 바로 실행할 명령어나 설정 예시
    2. 명령어가 실패할 때 확인할 지점
    3. 마지막에 짧은 설명
    모르는 내용은 추측하지 말고 확인이 필요하다고 말합니다."""
    MESSAGE user 리눅스 디스크 사용량 확인 방법 알려줘
    MESSAGE assistant 먼저 아래 명령어부터 확인하겠습니다.
    df -h
    sudo du -sh /var/* 2>/dev/null | sort -h
    lsblk
    EOF
    
    ollama create infra-assistant -f Modelfile
    ollama run infra-assistant

    포인트는 SYSTEM을 길게 쓰는 게 아니라 답변 순서와 금지 규칙을 관찰 가능한 형태로 명시하는 것입니다. “친절하게 답변해라” 같은 추상 문구보다 “명령어 먼저, 설명은 나중” 같은 규칙이 훨씬 잘 먹는 편입니다.

    실제 작업 흐름은 터미널에서 Modelfile을 편집하고 곧바로 create, run으로 검증하는 식으로 진행됩니다.

    5. PARAMETER는 품질보다도 행동 습관을 바꾸는 손잡이입니다

    파라미터를 만질 때 흔히 정답률만 보게 되는데, 실무에선 그보다 출력의 흔들림이 줄어드는가를 먼저 보는 게 맞습니다. 로컬 모델을 업무 보조로 쓸 때는 늘 비슷한 형식으로 나오는 답이 훨씬 값질 때가 많습니다. 이 부분은 실제 운영해 보면 체감이 꽤 큽니다.

    자주 보는 건 temperature, num_ctx, stop, 그리고 필요할 때 샘플링 계열 파라미터입니다. 여기서 특히 실수하기 쉬운 건 num_ctx입니다. 컨텍스트를 크게 잡으면 좋아 보이지만 메모리 사용량과 프롬프트 평가 시간도 같이 늘어납니다.

    파라미터 낮게 둘 때 높게 둘 때 판단 기준
    temperature 일관성 높음, 답변이 보수적 표현 다양성 증가, 흔들림도 증가 운영 문서/명령어 보조면 낮게, 아이디어 발산이면 높게
    num_ctx 메모리 부담 감소, 빠름 긴 문맥 유지에 유리, 느려질 수 있음 평소 넣는 입력 길이를 기준으로 최소 충분치만 확보
    stop 잘 맞으면 출력 경계가 깔끔함 불필요하거나 틀리면 출력이 잘리거나 토큰 누수 베이스 모델 원본 값에서 출발
    MESSAGE 예시 수 유연성 유지 답변 스타일 고정력 상승, 과하면 경직 대개 1~3개로도 충분

    실무적으로는 이렇게 나누면 편합니다.

    • 문서 초안, 운영 절차, 명령어 추천: temperature를 낮게 두고 형식 일관성을 우선합니다.
    • 브레인스토밍, 문안 변주: temperature를 조금 올리되, SYSTEM에서 출력 구조는 유지합니다.
    • 긴 로그/설정 해석: num_ctx를 무작정 키우기보다 먼저 입력을 잘라 넣을 수 있는지 확인합니다.

    6. TEMPLATE는 마지막에 건드리세요. 건드릴 땐 stop까지 세트로 보셔야 합니다

    TEMPLATE는 멋있어 보이지만 실제로는 가장 쉽게 사고 나는 영역입니다. 추천하는 원칙은 단순합니다. 기본 템플릿으로 원하는 형식이 나오면 TEMPLATE는 건드리지 않는 것입니다. SYSTEM과 MESSAGE만으로 해결되는 경우가 훨씬 많습니다.

    반대로 TEMPLATE를 건드려야 하는 경우도 있습니다. 베이스 모델의 채팅 포맷을 명시적으로 유지하면서 시스템, 사용자, 응답 경계를 통제하고 싶을 때입니다. 이때 핵심은 예쁘게 다시 쓰는 게 아니라 원본 구조를 최대한 보존하면서 필요한 부분만 조정하는 겁니다.

    FROM llama3.2
    TEMPLATE """{{ if .System }}<|start_header_id|>system<|end_header_id|>
    
    {{ .System }}<|eot_id|>{{ end }}{{ if .Prompt }}<|start_header_id|>user<|end_header_id|>
    
    {{ .Prompt }}<|eot_id|>{{ end }}<|start_header_id|>assistant<|end_header_id|>
    
    {{ .Response }}<|eot_id|>"""
    PARAMETER stop "<|start_header_id|>"
    PARAMETER stop "<|end_header_id|>"
    PARAMETER stop "<|eot_id|>"
    SYSTEM """당신은 한국어 운영 문서를 절차형으로 정리하는 도우미입니다."""

    이 블록에서 꼭 봐야 할 건 둘입니다.

    • {{ .System }}, {{ .Prompt }}, {{ .Response }}가 실제 템플릿에 반영되는지
    • TEMPLATE에 등장하는 특수 토큰과 PARAMETER stop이 서로 맞물리는지

    실패 사례도 꽤 단순합니다. 템플릿은 바꿨는데 stop은 예전 값을 그대로 두는 경우입니다. 그러면 응답 본문에 <|eot_id|> 같은 문자열이 그대로 보이거나, 반대로 답변이 중간에서 잘립니다. 이건 모델이 멍청해서가 아니라 출력 종료 경계가 틀어진 것입니다.

    7. ADAPTER는 지식 보강보다 정렬된 편향 추가에 가깝게 보는 편이 맞습니다

    ADAPTER를 붙이면 개인화 폭이 넓어지긴 합니다. 다만 기대를 너무 크게 잡으면 실망도 큽니다. 먼저 물어볼 건 하나입니다. “이 문제를 SYSTEM과 MESSAGE로 해결할 수 없는가?” 여기서 해결되면 굳이 어댑터를 안 붙이는 편이 운영은 더 쉽습니다.

    어댑터가 필요한 상황은 보통 두 가지입니다. 첫째, 특정 도메인 문체나 응답 습관을 훨씬 강하게 고정해야 할 때입니다. 둘째, 베이스 모델만으로는 일관되게 안 나오는 패턴을 추가 학습 결과로 밀어 넣고 싶을 때입니다.

    FROM llama3.2
    ADAPTER ./adapters/my-lora-adapter.gguf
    SYSTEM """당신은 Kubernetes 운영 가이드를 작성하는 보조 모델입니다.
    항상 점검 순서, 명령어, 장애 추정 원인을 순서대로 제시합니다."""

    여기서 제일 중요한 건 어댑터가 학습된 베이스 모델과 FROM의 베이스 모델이 맞아야 한다는 점입니다. 공식 문서도 이 경우 결과가 erratic해질 수 있다고 안내합니다. 현장에서는 이걸 모델 성능 탓으로 오해하는 경우가 적지 않습니다.

    그래서 저는 순서를 이렇게 잡습니다.

    1. ADAPTER 없이 동작하는 1차 모델을 만듭니다.
    2. 동일 질문 세트로 결과를 저장합니다.
    3. 그다음 ADAPTER를 붙인 버전을 따로 만듭니다.
    4. 스타일 개선인지, 지식 개선인지, 아니면 품질 붕괴인지 비교합니다.
    Ollama 커스텀 LLM에 LoRA 어댑터를 적용하는 구조 이미지

    베이스 모델 위에 LoRA 어댑터를 추가해 도메인 특화 성격을 강화하는 흐름입니다.

    8. API 자동화는 실험이 많아질수록 가치가 커집니다

    한두 개 만들 땐 Modelfile이 읽기 편합니다. 그런데 역할별 모델이 늘어나면 CLI 수작업은 금방 귀찮아집니다. 이때는 POST /api/create를 써서 생성 과정을 코드로 고정하는 편이 낫습니다. 모델 이름 규칙, 파라미터 조합, 예시 대화 구성을 반복해서 재현해야 할 때 특히 강합니다.

    curl http://localhost:11434/api/create -d '{
      "model": "infra-helper-api",
      "from": "llama3.2",
      "system": "You are a Korean infrastructure engineering assistant. Provide commands first, then failure checks, then short explanations.",
      "parameters": {
        "temperature": 0.2,
        "num_ctx": 4096
      },
      "messages": [
        {
          "role": "user",
          "content": "nginx 로그 확인 순서 알려줘"
        },
        {
          "role": "assistant",
          "content": "먼저 access.log와 error.log를 분리해서 보고, 그다음 4xx/5xx 비율과 upstream 오류를 확인하겠습니다."
        }
      ]
    }'

    이 방식을 선호하는 이유는 단순히 편해서만은 아닙니다. 실험 조건을 텍스트로 남길 수 있기 때문입니다. 어떤 모델 이름이 어떤 규칙과 파라미터로 만들어졌는지가 남아야 나중에 비교가 됩니다.

    생성 후에는 성능 체감만 보지 말고 API 응답 지표도 같이 보는 편이 좋습니다. Ollama의 생성 응답에는 load_duration, prompt_eval_count, prompt_eval_duration, eval_count, eval_duration 같은 필드가 포함됩니다. 이걸 보면 느린 이유가 로딩인지, 입력 길이인지, 출력 토큰 수인지 분리해서 보기 훨씬 편합니다.

    curl http://localhost:11434/api/generate -d '{
      "model": "infra-assistant",
      "prompt": "systemd 서비스 상태 확인 절차를 알려줘",
      "stream": false
    }'

    여기서 판단 포인트는 이렇습니다.

    • load_duration이 크면 모델 로딩 비용이 큰 겁니다.
    • prompt_eval_duration이 크면 입력 문맥이 길거나 num_ctx 운용이 과한 경우를 의심할 수 있습니다.
    • eval_duration이 크면 출력 토큰 수가 많거나 실행 자원이 부족한 쪽일 가능성이 큽니다.

    9. 트러블슈팅은 증상보다 근본 원인을 붙잡아야 빨리 끝납니다

    실제로 많이 부딪히는 문제는 대부분 네 부류였습니다. 중요한 건 증상을 외우는 게 아니라 어느 레이어가 깨졌는지를 먼저 가르는 겁니다. SYSTEM 문제인지, TEMPLATE 문제인지, ADAPTER 문제인지, 자원 문제인지 구분만 잘해도 시간이 꽤 절약됩니다.

    1) 시스템 프롬프트가 먹지 않는 것처럼 보일 때

    • 먼저 볼 것: ollama show --modelfile 모델명
    • 근본 원인: TEMPLATE 안에 {{ .System }} 반영이 없거나 베이스 템플릿을 수정하면서 시스템 경계를 깨뜨린 경우가 많습니다.
    • 판단 기준: 말투보다도 “추측 금지”, “명령어 우선” 같은 규칙이 반복적으로 무시되는지 봅니다.
    • 해결 방향: 원본 TEMPLATE로 되돌린 뒤 SYSTEM만 남기고 다시 비교합니다.

    2) 답변에 특수 토큰이 섞일 때

    • 먼저 볼 것: TEMPLATE와 PARAMETER stop 조합
    • 근본 원인: 출력 종료 토큰과 템플릿 토큰 경계가 맞지 않는 상황입니다.
    • 판단 기준: <|eot_id|>, <|start_header_id|> 같은 문자열이 본문에 보이면 거의 이쪽입니다.
    • 해결 방향: 베이스 모델 기본 Modelfile의 stop 설정을 그대로 기준 삼아 다시 맞춥니다.

    3) 어댑터 적용 후 품질이 갑자기 무너질 때

    • 먼저 볼 것: ADAPTER 학습 기준 모델
    • 근본 원인: FROM에 적은 베이스 모델과 어댑터가 기대하는 기반 모델 불일치
    • 판단 기준: 문장 붕괴, 주제 일탈, 불필요한 반복이 적용 직후 심해집니다.
    • 해결 방향: 어댑터 제작 시 사용한 기반 계열과 동일한 모델로 FROM을 맞춥니다.

    4) 속도가 너무 느리거나 메모리가 버거울 때

    • 먼저 볼 것: ollama ps, OS 메모리/스왑 사용량, 입력 길이, num_ctx
    • 근본 원인: 모델 크기보다도 과도한 컨텍스트, 동시 실행 모델 수, 자원 부족이 겹치는 경우가 많습니다.
    • 판단 기준: 스왑이 발생하면 체감 성능은 급격히 떨어집니다.
    • 해결 방향: 작은 베이스 모델로 내리거나 num_ctx를 낮추고 실험 모델 동시 구동 수를 줄입니다.

    저는 장애를 볼 때 항상 이렇게 나눕니다. 형식 이상은 TEMPLATE, 성격 이상은 SYSTEM/MESSAGE, 지식 이상은 ADAPTER 또는 베이스 모델, 속도 이상은 자원과 컨텍스트. 이 프레임으로 보면 원인 추적 속도가 빨라집니다.

    Ollama 커스텀 LLM 트러블슈팅과 검증 과정을 보여주는 이미지

    응답 토큰 이상 출력, 시스템 프롬프트 무시, 어댑터 불일치 같은 대표 장애 포인트를 점검하는 장면입니다.

    10. 검증은 더 똑똑해졌는가보다 의도대로 수렴하는가를 보셔야 합니다

    커스텀 모델을 만들고 나면 자꾸 성능 향상만 보게 됩니다. 그런데 Modelfile의 1차 목적은 대개 정답률 폭증이 아니라 출력 습관 고정입니다. 그래서 검증 질문 세트를 별도로 두고 베이스 모델과 커스텀 모델을 같은 질문으로 비교하는 편이 좋습니다.

    ollama run llama3.2 "systemd 서비스 상태 확인 절차를 알려줘"
    ollama run infra-assistant "systemd 서비스 상태 확인 절차를 알려줘"
    ollama run infra-assistant "모르면 추측하지 말고, nginx 502 점검 순서를 알려줘"

    여기서 보는 건 단순히 답변 길이나 그럴듯함이 아닙니다.

    1. 명령어가 먼저 나오는지
    2. 설명이 뒤로 밀리는지
    3. 모를 때 지어내지 않는지
    4. 한국어 톤과 형식이 유지되는지
    5. MESSAGE 예시가 답변을 과하게 복제하게 만들지는 않는지
    검증 항목 베이스 모델 커스텀 모델 합격 기준
    답변 언어 영문/국문 혼합 가능 국문 고정 가능 언어 정책이 흔들리지 않을 것
    명령어 우선 제시 질문마다 다름 일관되게 맞출 수 있음 초반 2~3줄 안에 바로 실행 항목이 나올 것
    톤 일관성 변동 가능 SYSTEM으로 안정화 질문이 바뀌어도 문체가 크게 흔들리지 않을 것
    도메인 집중도 일반 지식 중심 MESSAGE/ADAPTER로 강화 쓸데없는 일반론보다 절차형 답변이 앞설 것
    추측 억제 상황 따라 흔들림 금지 규칙 반영 가능 불확실할 때 확인 필요성을 분명히 말할 것

    현업 자동화에서는 “베이스 모델보다 더 똑똑하다”보다 “늘 같은 포맷으로 나온다”가 더 중요할 때가 많습니다. 운영 문서 초안, 반복 질의 응답, 내부 가이드 작성은 특히 그렇습니다. 이 지점이 바로 Ollama 커스텀 LLM의 실무 가치라고 봐도 무리가 없습니다.

    11. FAQ와 최종 추천: Ollama 커스텀 LLM은 이럴 땐 A, 저럴 땐 B로 나누면 편합니다

    자주 헷갈리는 질문

    • Q. Modelfile만 쓰면 미세 조정이 된 건가요?
      A. 아닙니다. 기본적으로는 설정, 프롬프트 구조, 예시 대화, 실행 파라미터를 묶는 작업에 가깝습니다. 추가 학습 결과를 붙이려면 ADAPTER 같은 별도 레이어가 필요합니다.
    • Q. TEMPLATE는 꼭 수정해야 하나요?
      A. 아닙니다. 기본 템플릿으로 문제가 없으면 안 건드리는 쪽이 맞습니다. 깨지는 빈도가 높은 영역이라 이유가 분명할 때만 손대는 게 좋습니다.
    • Q. 개인화된 AI를 가장 빨리 만드는 방법은?
      A. 베이스 모델 하나를 고르고, SYSTEM에 역할과 출력 순서를 명시한 뒤, MESSAGE 1~2개만 넣어 1차 버전을 만드는 방식이 가장 빠릅니다.
    • Q. 언제 ADAPTER까지 가야 하나요?
      A. SYSTEM과 MESSAGE로도 해결되지 않는 도메인 특화 패턴이 반복해서 필요할 때입니다. 단순한 말투 고정 정도라면 대개 과한 선택입니다.

    선택 기준은 이렇게 정리하면 편합니다.

    • 빠르게 목적형 모델이 필요하다: FROM + SYSTEM + PARAMETER + MESSAGE로 시작하세요. 가장 안전하고 재현성이 좋습니다.
    • 응답 형식을 강하게 통제해야 한다: 먼저 ollama show --modelfile로 원본을 확인한 뒤 TEMPLATE를 최소 수정하세요.
    • 특정 학습 결과물을 이미 갖고 있다: ADAPTER를 붙이되, 베이스 모델 호환성을 제일 먼저 확인하세요.
    • 역할별 모델을 반복 생성해야 한다: 사람이 수동으로 만들기보다 /api/create로 자동화하는 편이 관리가 낫습니다.
    • 속도와 메모리가 아슬아슬하다: 큰 모델 집착보다 작은 모델 + 낮은 num_ctx + 명확한 SYSTEM이 더 실용적일 때가 많습니다.

    한 줄로 압축하면 이렇습니다. Ollama 커스텀 LLM의 핵심은 모델을 새로 발명하는 게 아니라, 내 작업 방식을 반복 가능하게 고정하는 것입니다. 처음부터 무거운 학습 파이프라인으로 들어가기보다, Modelfile로 행동 규약을 먼저 굳히는 쪽이 훨씬 현실적입니다. 관련해서 로컬 LLM 성능 최적화나 RAG 비교 글도 함께 읽어보시면 다음 단계 판단이 더 쉬워집니다.

    Ollama 커스텀 LLM Modelfile 핵심 요소 요약 인포그래픽

    FROM, SYSTEM, PARAMETER, TEMPLATE, ADAPTER를 언제 선택하면 되는지 한눈에 정리한 요약 이미지입니다.

  • [AI] LLM 추론 성능 벤치마크: TensorRT vs ONNX Runtime

    [AI] LLM 추론 성능 벤치마크: TensorRT vs ONNX Runtime

    [AI 인프라] LLM 추론 성능 벤치마크: NVIDIA TensorRT vs ONNX Runtime

    LLM 추론 성능 벤치마크를 해보면, 병목은 생각보다 GPU 스펙 한 줄로 설명되지 않더라고요. 같은 GPU, 같은 모델이라도 어떤 런타임이 어떤 shape를 얼마나 안정적으로 처리하느냐, 그리고 초기화 비용과 토큰 생성 구간을 어떻게 분리해 봤느냐에 따라 체감 성능이 꽤 달라집니다. 저도 초반에는 TensorRT 쪽 숫자가 더 높게 나오면 무조건 이긴 줄 알았는데, 실제 운영에선 첫 요청 지연, 엔진 캐시, 입력 길이 분산, Python 생성 루프 오버헤드가 더 크게 문제 되는 경우가 많았습니다.

    이번 글은 단순 비교가 아니라, 같은 조건에서 TensorRT와 ONNX Runtime를 어떻게 공정하게 재는지, 그리고 측정값이 실제 서비스 판단으로 어떻게 이어지는지에 집중했습니다. 홈랩, 사내 검증 서버, PoC 환경에서 바로 써먹을 수 있게 명령어와 체크 포인트를 실무 기준으로 묶었습니다.

    로컬 LLM 추론 성능 벤치마크를 위한 TensorRT와 ONNX Runtime 아키텍처 이미지

    로컬 GPU 환경에서 모델 로딩, 토크나이저, 런타임, 추론 결과까지 이어지는 전체 흐름을 한눈에 보여주는 아키텍처 이미지입니다.

    1. 왜 TensorRT와 ONNX Runtime를 같이 보게 되나

    실무에서 둘을 같이 보는 이유는 단순합니다. TensorRT는 NVIDIA GPU 고정 환경에서 최대 성능을 노릴 때 강력한 선택지고, ONNX Runtime은 모델 비교, 환경 이동, 운영 단순성을 챙기기 좋은 기준선이기 때문입니다. 둘은 경쟁 관계이면서도, 실제론 비교용 baseline과 최적화용 target이라는 식으로 같이 쓰는 경우가 많습니다.

    • TensorRT: 엔진 빌드 비용과 shape 관리 부담을 감수하는 대신, 고정 워크로드에서는 높은 처리량과 낮은 지연을 기대할 수 있습니다.
    • ONNX Runtime: CUDA Execution Provider만 붙여도 baseline이 빨리 잡히고, 디버깅 난도가 비교적 낮습니다.
    • ONNX Runtime + TensorRT Execution Provider: 코드 경로는 유지하면서 일부 최적화를 노릴 수 있지만, 문제 원인 분리가 오히려 더 어려워지는 경우도 있습니다.

    여기서 제가 중요하게 보는 건 하나입니다. 런타임 성능만 빠른지, 전체 생성 경로가 빠른지를 분리해야 한다는 점입니다. TensorRT 엔진 레벨 숫자가 좋아도 실제 서비스 응답이 별 차이 없으면, 대개 병목은 런타임 바깥에 있습니다. 반대로 ONNX Runtime가 조금 느려 보여도 재현성과 운영 안정성이 높으면, 초기 서비스에는 그쪽이 더 값어치 있는 선택일 수 있습니다.

    2. LLM 추론 성능 벤치마크에서 꼭 봐야 할 지표

    LLM 벤치마크는 이미지 분류처럼 한 번 넣고 한 번 끝나는 추론과 다릅니다. 프롬프트 처리(prefill)와 토큰 생성(decode)이 분리되고, KV cache가 붙고, 입력 길이 편차가 커서 평균값 하나로 끝내면 판단을 그르치기 쉽습니다. 그래서 LLM 추론 성능 벤치마크에선 평균 속도보다 구간별 특성을 같이 봐야 합니다.

    2-1. 꼭 맞춰야 하는 비교 조건

    1. 같은 모델 가중치, 같은 토크나이저, 같은 전처리 조건을 씁니다.
    2. 가능하면 같은 ONNX 그래프를 기준으로 비교하고, TensorRT 11.x처럼 강타입 빌드가 필요한 경우에는 사전 precision 변환 단계까지 함께 기록합니다.
    3. 정밀도는 FP16, BF16, FP32, INT8 중 하나로 고정합니다. 섞어 재면 비교가 무너집니다.
    4. 프롬프트 길이와 생성 토큰 수를 고정하고, 가능하면 짧은 입력/긴 입력 두 구간으로 나눠 봅니다.
    5. 워밍업 횟수와 측정 구간을 분리합니다. 첫 요청을 평균에 섞으면 해석이 흐려집니다.
    6. 배치 크기와 동시성은 별도 축입니다. 둘을 한 번에 바꾸면 원인을 찾기 어렵습니다.
    7. 전원 상태, 클럭 상태, 백그라운드 프로세스를 고정합니다. 특히 데스크톱 환경에서는 이 영향이 꽤 큽니다.

    2-2. 해석할 지표

    • TTFT(Time To First Token): 사용자 체감에 가장 직접적입니다. 첫 토큰이 느리면 답답하게 느껴지거든요.
    • Tokens/sec: 긴 출력에서 중요합니다. decode 구간 효율이 여기서 드러납니다.
    • p95 latency: 운영 안정성을 보려면 평균보다 이 수치가 더 중요합니다.
    • GPU memory usage: 속도가 비슷하면 메모리 여유가 있는 쪽이 운영성이 좋습니다.
    • Engine build / session init overhead: 재시작이 잦은 환경, 다중 모델 환경에서는 이 비용이 실제 총비용으로 이어집니다.
    • CPU time: 토크나이저, 후처리, Python 루프가 병목이면 GPU 최적화 이득이 상쇄됩니다.

    제가 실제로 더 신뢰하는 건 최고 기록이 아니라 세 번 돌렸을 때 비슷하게 나오는지입니다. 단일 최고치만 잘 나온 벤치마크는 운영 판단 기준으로는 거의 쓸모가 없습니다.

    3. TensorRT 최적화와 ONNX Runtime 비교를 위한 기준선 만들기

    로컬 LLM 추론 성능 벤치마크에서 제일 먼저 해야 할 일은, 화려한 최적화가 아니라 분리 측정입니다. 저는 보통 아래 네 구간으로 나눕니다.

    1. 모델 준비 구간: ONNX export, shape 정의, 동적 축 확인
    2. 초기화 구간: TensorRT 엔진 빌드 또는 ONNX Runtime 세션 생성
    3. prefill 구간: 긴 프롬프트를 한 번에 넣는 첫 추론
    4. decode 구간: 토큰을 한 개씩 이어서 생성하는 반복 추론

    이 네 구간을 섞어서 평균 latency 하나로 덮으면 실무에서는 해석이 거의 틀어집니다. TensorRT는 엔진 빌드가 무겁고, ONNX Runtime는 세션 초기화와 provider 구성 영향이 큽니다. LLM은 여기에 prefill과 decode의 성격까지 달라서, 어느 구간에서 이겼는지가 곧 선택 기준이 됩니다.

    항목 TensorRT ONNX Runtime 실무 판단 포인트
    최대 성능 잠재력 높음 중간~높음 GPU와 워크로드가 고정이면 TensorRT 투자 가치가 커집니다.
    초기 실험 속도 느린 편 빠른 편 모델 export 직후 baseline을 잡을 때는 ONNX Runtime가 훨씬 편합니다.
    입력 길이 변동 대응 shape 전략에 민감 상대적으로 유연 프롬프트 길이 편차가 크면 TensorRT 최적화 이점이 줄어들 수 있습니다.
    장애 분석 난이도 높음 낮음 팀에 추론 엔진 디버깅 경험이 없으면 운영 비용이 성능 이득을 먹어버릴 수 있습니다.
    재기동 비용 민감도 엔진 캐시 전략 필요 세션 재생성 중심 짧은 수명 컨테이너 환경에서는 캐시 설계가 성능만큼 중요합니다.
    권장 시작점 최적화 단계 기준선 단계 바로 TensorRT로 들어가기보다 ONNX Runtime로 병목 위치를 먼저 확인하는 편이 낫습니다.

    4. 실전 구현 1: TensorRT 엔진 생성과 기본 측정

    TensorRT는 <code>trtexec로 첫 감을 잡는 게 가장 빠릅니다. 다만 LLM에서는 단순히 FP16 옵션 하나만 넣고 끝내면 부족합니다. 입력 shape 범위를 명시하지 않으면 엔진이 실제 프롬프트 분포와 어긋날 수 있고, 그 결과 기대 이하의 최적화가 나올 수 있습니다.

    아래 예시는 TensorRT 10.x 계열에서 많이 쓰는 방식입니다. TensorRT 11.x부터는 일부 precision 관련 플래그가 바뀌었거나 제거됐기 때문에, 실제 사용 전에는 trtexec --help로 로컬 버전을 꼭 확인해 두는 게 좋습니다. 이거 안 보고 그대로 복붙했다가 한 번씩 막히더라고요.

    trtexec \
      --onnx=model.onnx \
      --saveEngine=model_fp16.plan \
      --fp16 \
      --minShapes=input_ids:1x16,attention_mask:1x16 \
      --optShapes=input_ids:1x512,attention_mask:1x512 \
      --maxShapes=input_ids:1x2048,attention_mask:1x2048 \
      --warmUp=200 \
      --duration=60 \
      --verbose

    이 명령에서 실무적으로 중요한 건 아래입니다.

    • --minShapes, --optShapes, --maxShapes: 동적 입력 모델이라면 사실상 핵심입니다. opt shape는 가장 자주 들어오는 프롬프트 길이대로 잡는 편이 낫습니다.
    • --warmUp: 보통 워밍업 시간 기준으로 해석합니다. 반복 횟수라고 착각하면 결과 비교가 꼬일 수 있습니다.
    • --verbose: 성능보다 먼저 봐야 할 건 변환 실패 레이어, precision 강등, 지원되지 않는 연산 흔적입니다.

    LLM에서 자주 놓치는 건 shape 전략이 사실상 성능 전략이라는 점입니다. 짧은 프롬프트 위주 서비스인데 max shape를 과하게 크게 잡으면 메모리와 최적화 효율이 함께 손해를 봅니다. 반대로 입력 길이 분산이 큰데 지나치게 좁게 잡으면 실제 요청에서 비효율이 생길 수 있습니다.

    엔진 생성과 추론을 분리해서 보고 싶다면 저장된 엔진으로 다시 측정하는 편이 낫습니다.

    trtexec \
      --loadEngine=model_fp16.plan \
      --shapes=input_ids:1x512,attention_mask:1x512 \
      --warmUp=200 \
      --duration=60

    이렇게 해야 엔진 빌드 시간이 빠진 순수 추론 구간을 보기 좋습니다. 엔진 빌드 시간을 평균 latency에 섞는 실수는 생각보다 자주 나오고, 그 순간부터 비교표는 의미가 많이 줄어듭니다.

    TensorRT 최적화와 GPU 가속 흐름을 설명하는 LLM 추론 성능 벤치마크 이미지

    ONNX 모델이 TensorRT 엔진으로 변환되고, 워밍업과 프로파일링을 거쳐 성능 지표가 수집되는 흐름을 설명하는 이미지입니다.

    5. 실전 구현 2: ONNX Runtime baseline 측정

    ONNX Runtime의 강점은 baseline을 빠르게 만들 수 있다는 점입니다. 저는 여기서 단순 평균 latency보다 provider가 제대로 붙었는지, 세션 옵션이 적절한지, 실제 생성 루프와 분리해 엔진 수준 시간을 볼 수 있는지를 먼저 확인합니다.

    import time
    import numpy as np
    import onnxruntime as ort
    
    session_options = ort.SessionOptions()
    session_options.graph_optimization_level = ort.GraphOptimizationLevel.ORT_ENABLE_ALL
    session_options.log_severity_level = 0
    session_options.log_verbosity_level = 1
    
    providers = [
        (
            "CUDAExecutionProvider",
            {
                "device_id": 0,
                "arena_extend_strategy": "kNextPowerOfTwo",
                "cudnn_conv_algo_search": "EXHAUSTIVE",
                "do_copy_in_default_stream": True,
            },
        ),
        "CPUExecutionProvider",
    ]
    
    session = ort.InferenceSession(
        "model.onnx",
        sess_options=session_options,
        providers=providers,
    )
    
    print("active providers:", session.get_providers())
    input_names = [x.name for x in session.get_inputs()]
    print("inputs:", input_names)
    
    feeds = {
        "input_ids": np.ones((1, 16), dtype=np.int64),
        "attention_mask": np.ones((1, 16), dtype=np.int64),
    }
    
    for _ in range(20):
        session.run(None, feeds)
    
    latencies_ms = []
    for _ in range(100):
        start = time.perf_counter()
        session.run(None, feeds)
        latencies_ms.append((time.perf_counter() - start) * 1000)
    
    latencies_ms.sort()
    p95 = latencies_ms[int(len(latencies_ms) * 0.95) - 1]
    print(f"avg latency: {sum(latencies_ms)/len(latencies_ms):.3f} ms")
    print(f"p95 latency: {p95:.3f} ms")

    이 코드는 baseline용입니다. 실제 LLM 생성 벤치마크로 가려면 past_key_values, position_ids, attention_mask shape, 그리고 prefill/decode 분리를 모델 구조에 맞게 넣어야 합니다. 중요한 건 엔진 호출 성능과 애플리케이션 생성 루프 성능을 따로 수집하는 습관입니다.

    ONNX Runtime 안에서 TensorRT Execution Provider를 시험해 보고 싶다면 아래처럼 provider를 분리해 보는 방법도 있습니다. 이 경우는 성능 수치보다 캐시 동작과 fallback 여부를 먼저 보는 편이 낫습니다.

    providers = [
        (
            "TensorrtExecutionProvider",
            {
                "trt_engine_cache_enable": True,
                "trt_engine_cache_path": "./trt_cache",
                "trt_fp16_enable": True,
            },
        ),
        "CUDAExecutionProvider",
        "CPUExecutionProvider",
    ]
    
    session = ort.InferenceSession("model.onnx", providers=providers)

    GPU 상태는 꼭 같이 봐야 합니다. 벤치마크 로그만 보면 빨라 보이는데 GPU util이 낮고 CPU 한 코어만 치솟는 경우가 꽤 많습니다.

    nvidia-smi dmon -s pucm -d 1

    여기서 저는 네 가지를 같이 봅니다. power는 클럭 유지 여부, util은 GPU 바쁨 정도, clock은 스로틀링 여부, memory는 컨텍스트 길이와 배치 변화의 영향을 읽는 데 도움이 됩니다.

    6. 주의사항과 트러블슈팅: 제가 자주 겪었던 문제들

    벤치마크는 숫자를 뽑는 작업이 아니라 왜 그 숫자가 나왔는지 설명하는 작업에 가깝습니다. 아래 문제들은 LLM 추론 비교에서 반복해서 나오는 실패 모드입니다. 실제로는 런타임보다 입력 경로에서 막히는 경우도 꽤 많더라고요.

    6-1. 같은 모델인데 결과가 안 맞는 경우

    • 토크나이저 옵션 차이로 입력 길이가 달라집니다. 성능 비교 전에 실제 token count부터 맞춰야 합니다.
    • padding 방향과 최대 길이 설정이 다르면 연산량이 달라집니다.
    • 배치 크기 자동 조정이나 동적 batching이 켜져 있으면 공정 비교가 깨집니다.
    • FP16과 FP32, 또는 BF16을 섞어 재면 런타임 차이보다 precision 차이가 더 크게 나옵니다.

    근본 원인은 대부분 같은 모델을 보고 있다고 착각하는 것입니다. 파일명이 같아도 export 옵션, 동적 축, 입력 schema가 달라지면 사실상 다른 워크로드입니다.

    6-2. TensorRT 엔진은 빠른데 실제 생성 속도는 애매한 경우

    이건 정말 자주 봅니다. 원인은 대체로 런타임 바깥에 있습니다.

    • 토크나이저가 CPU 병목입니다. 짧은 응답에서는 이 영향이 생각보다 큽니다.
    • Python 루프가 토큰마다 GPU 호출을 감싸면서 왕복 오버헤드를 만듭니다.
    • KV cache 레이아웃이나 메모리 복사가 비효율적입니다.
    • 입력 shape가 계속 바뀌어 TensorRT 최적화가 기대만큼 먹지 않습니다.
    • 엔진 캐시가 제대로 재사용되지 않아 재시작 후마다 준비 비용이 다시 듭니다.

    GPU util은 낮은데 TTFT와 p95가 큰 경우는 계산 문제가 아니라 상위 경로 병목일 가능성이 큽니다. 이때 GPU 커널을 더 최적화하는 건 우선순위가 아닙니다.

    6-3. ONNX Runtime가 예상보다 느린 경우

    • CUDAExecutionProvider가 실제로 활성화됐는지 먼저 확인합니다.
    • 지원되지 않는 연산이 CPU로 fallback 되는지 로그를 봅니다.
    • 세션 옵션의 그래프 최적화가 빠져 있지 않은지 확인합니다.
    • ONNX export에서 dynamic axis를 과하게 열어 둬 shape 추론과 최적화가 약해진 경우를 의심합니다.
    • 입력 텐서를 매 요청마다 새로 할당하면서 호스트 메모리 오버헤드를 키우는 경우도 꽤 있습니다.

    실무에서 제가 제일 경계하는 건 런타임이 느린 게 아니라 export 품질이 낮은 경우입니다. ONNX Runtime 성능 문제처럼 보여도, 실제로는 모델 export가 비효율적으로 된 사례가 적지 않습니다.

    ONNX Runtime 비교를 위한 CUDA Execution Provider 구성 이미지

    ONNX Runtime 세션 초기화, 그래프 최적화, CUDA Execution Provider 적용 구조를 이해하기 쉽게 풀어낸 이미지입니다.

    7. LLM 추론 성능 벤치마크 결과, 숫자보다 읽는 법이 먼저입니다

    측정이 끝났다면 이제 숫자를 읽어야 합니다. 저는 아래처럼 봅니다. 이 구간이 사실 제일 중요합니다. 숫자만 높다고 바로 정답은 아니거든요.

    1. TTFT가 길다: 엔진/세션 초기화, 긴 프롬프트 prefill, 토크나이저, 첫 decode 경로를 의심합니다.
    2. 평균 latency는 좋은데 p95가 나쁘다: 동시성 구간의 큐잉, 메모리 압박, shape 분산이 원인일 가능성이 큽니다.
    3. tokens/sec가 잘 안 오른다: decode 루프의 CPU 개입, KV cache 처리, 작은 배치가 문제일 수 있습니다.
    4. GPU util이 낮다: GPU가 한가한데 응답은 느리다면 애플리케이션 경로를 먼저 봐야 합니다.
    5. GPU memory가 높고 출렁인다: 최대 시퀀스 길이, 동시성, 정밀도 조합이 과한 신호일 수 있습니다.

    홈랩이나 PoC에서는 특히 재현성이 중요합니다. 저는 최소 3회 반복, 워밍업 제외, 첫 요청 별도 기록, prefill/decode 분리, GPU 모니터링 병행 이 다섯 가지를 기본으로 둡니다. 이렇게 해 두면 나중에 팀 내에서 숫자 해석으로 싸울 일이 확 줄어듭니다.

    관측 결과 자주 나오는 근본 원인 먼저 할 조치 TensorRT 쪽 힌트 ONNX Runtime 쪽 힌트
    첫 요청만 유독 느림 엔진 빌드, 세션 초기화, 캐시 미적용 초기화 구간을 분리 측정 엔진 캐시와 사전 빌드 여부 확인 세션 재사용과 provider 초기화 로그 확인
    긴 프롬프트에서 급격히 느려짐 prefill 비용 증가, shape 최적화 불일치 입력 길이 구간별로 분리 측정 opt shape를 실제 분포에 맞게 재설계 export dynamic axis와 입력 텐서 구성 점검
    GPU util은 낮은데 응답은 느림 토크나이저, Python 루프, CPU fallback CPU 사용률과 provider 로그 확인 엔진 바깥 호출 오버헤드 축소 fallback 연산과 메모리 할당 패턴 확인
    평균은 괜찮은데 p95가 나쁨 동시성, 큐잉, 메모리 압박 동시성 단계별로 별도 실행 shape 편차와 메모리 상한 재검토 세션 옵션, provider 설정, CPU 개입 확인

    결과 정리 시에는 숫자 순위표보다 어떤 조건에서 우세했는지를 남기는 편이 훨씬 유용합니다. TensorRT가 이긴 게 아니라, 고정 shape의 긴 decode 구간에서 TensorRT가 우세했다처럼 써야 다음 의사결정에 바로 써먹을 수 있습니다.

    LLM 추론 성능 벤치마크 결과와 GPU 사용률을 시각화한 이미지

    TTFT, tokens/sec, GPU utilization, memory usage를 한 화면에서 비교하는 대시보드 형태의 결과 이미지입니다.

    8. 실무 추천과 다음 단계

    제가 현업에서 내리는 기준은 꽤 단순합니다. 먼저 ONNX Runtime로 병목 위치를 밝히고, 그다음 TensorRT로 돈 되는 구간만 최적화하는 흐름이 가장 덜 아픕니다. 처음부터 TensorRT로 들어가면 성능은 빨리 보여도, 왜 빨라졌는지와 왜 안 빨라졌는지를 분리하기 어려운 경우가 많습니다.

    • 이럴 땐 ONNX Runtime: 모델을 자주 바꾼다, 비교 실험이 많다, 디버깅 시간을 아껴야 한다, NVIDIA 고정 배포가 아니다.
    • 이럴 땐 TensorRT: GPU가 고정돼 있다, 긴 기간 같은 워크로드를 운영한다, p95와 처리량을 끝까지 밀어야 한다, 엔진 관리까지 감당할 팀이 있다.
    • 이럴 땐 둘 다 본다: ONNX Runtime baseline은 안정적인데 비용이 아쉽고, 병목이 GPU 쪽이라는 근거가 이미 있다.

    조금 더 직설적으로 말씀드리면, PoC 단계에서 바로 TensorRT를 주력 경로로 잡는 건 대개 이릅니다. 반대로 이미 NVIDIA GPU 기반으로 워크로드가 굳어 있고, 하루 종일 같은 패턴의 요청을 받는다면 TensorRT 최적화는 충분히 투자할 만합니다. 이 경우에는 성능 향상 자체보다도 예측 가능한 지연과 재현성이 장점으로 돌아옵니다.

    1. 개발 속도, 실험 반복, 모델 교체 빈도가 중요하면 ONNX Runtime로 시작하는 편이 맞습니다.
    2. 배포 환경이 NVIDIA GPU로 고정이고, TTFT보다 지속 처리량과 p95가 더 중요하면 TensorRT 우선 검토가 맞습니다.
    3. 둘 중 하나로 바로 못 정하겠다면, 같은 ONNX 기준으로 prefill과 decode를 분리 측정한 뒤 TTFT, tokens/sec, p95, GPU memory 네 항목으로 결정하는 게 가장 안전합니다.

    다음 단계도 명확합니다. baseline이 흔들리면 런타임 최적화 전에 export와 입력 경로부터 정리하시고, baseline이 안정적인데 GPU 병목이 분명하면 그때 TensorRT로 들어가시면 됩니다. 이 순서를 지키면 삽질 시간이 확실히 줄어듭니다.

    관련해서 모델 경량화나 GPU 가속 운영 팁이 더 궁금하시면, 블로그의 다른 AI 인프라 글도 같이 읽어보시면 흐름이 훨씬 잘 잡힐 겁니다.

    TensorRT와 ONNX Runtime 선택 기준을 요약한 LLM 추론 성능 벤치마크 이미지

    어떤 상황에서 TensorRT를 고르고, 어떤 상황에서 ONNX Runtime를 고르면 되는지 한 장으로 정리한 요약 이미지입니다.

    FAQ

    Q. ONNX Runtime 안에서 TensorRT도 쓸 수 있나요?

    네, TensorRT Execution Provider로 구성할 수 있습니다. 다만 성능만 보지 말고, 엔진 캐시 재사용, fallback 경로, 디버깅 난이도를 같이 보셔야 합니다. 코드 경로는 단순해 보여도 장애 분석은 더 어려워질 수 있습니다.

    Q. LLM 추론 성능 벤치마크에서 숫자가 자꾸 달라집니다.

    워밍업, 프롬프트 길이, 출력 길이, 배치 크기, 전원/클럭 상태를 먼저 고정해 보세요. 거기에 백그라운드 프로세스와 첫 요청 분리 기록까지 넣으면 흔들림 원인을 상당히 빨리 좁힐 수 있습니다.

    Q. AI 모델 경량화가 꼭 필요할까요?

    메모리가 빠듯하거나 동시성을 올려야 한다면 우선순위가 높습니다. 다만 INT8이나 더 공격적인 최적화는 정확도 검증과 함께 가야 해서, baseline 없이 바로 들어가면 성능은 빨라져도 판단은 더 어려워질 수 있습니다.

  • [AI] 클라우드 AI 비용 비교: AWS SageMaker vs Google Cloud Vertex AI

    [AI] 클라우드 AI 비용 비교: AWS SageMaker vs Google Cloud Vertex AI

    [클라우드] 클라우드 AI 비용 비교: AWS SageMaker vs Google Cloud Vertex AI

    클라우드 AI 비용 비교를 하다 보면, 막상 GPU 한 대 가격보다 더 무서운 게 따로 있습니다. 바로 조용히 계속 붙는 운영비예요. 처음엔 학습 비용만 보면 될 줄 알았는데, 실제 계산표를 열어보면 스토리지, 엔드포인트, 로그, 데이터 전송까지 다 합쳐서 봐야 숫자가 맞더라고요. 그래서 이 글은 단순 단가 비교보다, 어디에서 비용이 새는지와 어떤 워크로드에서 판단이 달라지는지에 초점을 맞췄습니다.

    이번 글은 AWS SageMaker와 Google Cloud의 관리형 ML 플랫폼을 비교하되, 현재 서비스 기준으로는 Google Cloud AI Platform보다는 Vertex AI라는 이름이 더 정확합니다. 예전 AI Platform 문서와 명령어가 일부 남아 있긴 하지만, 지금 플랫폼 선택을 검토한다면 Vertex AI 기준으로 보는 편이 덜 헷갈립니다. 결론도 단순합니다. 어디가 무조건 싸다기보다, 워크로드 구조와 운영 습관에 따라 총비용이 달라진다는 쪽이 현실에 가깝습니다.

    학습, 배포, 스토리지, 모니터링, 네트워크 비용이 각각 어떻게 연결되는지 한눈에 보여주는 개요 이미지입니다.

    왜 클라우드 AI 비용 비교는 항상 예상보다 커질까요?

    클라우드 ML은 서버 한 대만 빌려서 끝나는 구조가 아닙니다. 보통 아래 4단계가 같이 움직입니다.

    • 데이터 저장: 학습 데이터셋, 체크포인트, 모델 아티팩트 보관
    • 학습 작업: CPU/GPU 인스턴스를 사용한 모델 학습
    • 배포 및 추론: 실시간 엔드포인트 또는 배치 추론
    • 운영 자동화: 파이프라인, 모니터링, 로그, 권한 관리

    문제는 비용 단위가 전부 다르다는 점입니다. 어떤 건 시간당 과금이고, 어떤 건 저장 용량 기준이고, 어떤 건 요청 수나 네트워크 사용량 기준으로 붙습니다. 그래서 클라우드 AI 비용 비교를 할 때는 GPU 시간당 가격만 보면 거의 항상 판단이 꼬입니다.

    AWS SageMaker 비용은 학습 인스턴스, 개발 환경, 엔드포인트, 스토리지, 파이프라인 실행에서 체감이 큽니다. Google Cloud AI Platform 비용이라고 많이 검색하시지만, 현재 비교 기준은 Vertex AI의 학습·예측 리소스, Cloud Storage, Cloud Logging, 네트워크까지 함께 보는 게 맞습니다. 이름은 바뀌어도 비용을 해석하는 방식 자체는 크게 다르지 않습니다.

    클라우드 AI 비용 비교 기준부터 맞춰야 숫자가 안 꼬입니다

    서로 다른 클라우드의 ML 플랫폼을 비교할 때는 기능 이름이 아니라 사용 패턴을 맞춰야 합니다. 같은 성격의 워크로드끼리 놓고 봐야 숫자가 덜 흔들립니다.

    비교 항목 AWS SageMaker Google Cloud Vertex AI 비용 해석 포인트
    실험 환경 Notebook, Studio 계열 Workbench, Notebook 계열 켜둔 시간만큼 과금되는지 확인
    학습 Managed Training Job Custom Job GPU 종류보다 실행 시간 최적화가 더 중요
    배포 Real-time Endpoint Online Prediction Endpoint 유휴 시간에도 비용이 붙는 구조인지 체크
    배치 처리 Batch Transform Batch Prediction 상시 엔드포인트보다 저렴할 수 있음
    저장소 S3 Cloud Storage 원본 데이터와 중간 산출물 누적 주의
    운영 자동화 Pipelines, Processing Pipelines, Model Monitoring 실행 횟수와 로그 누적 비용 확인

    현장에서 자주 보이는 실수는 비슷합니다. GPU 단가만 보고 결론을 내리는데, 정작 월말에 더 크게 보이는 건 유휴 엔드포인트와 안 지운 아티팩트예요. 모델은 하루 한 번만 쓰는데 엔드포인트는 24시간 떠 있고, 실험 산출물은 계속 쌓이는 식이죠.

    클라우드 AI 플랫폼 비용 효율성 분석 프레임워크

    비용 분석은 아래 5개 축으로 나눠서 보면 훨씬 깔끔합니다. 감으로 비교하지 않고 숫자로 좁혀갈 수 있거든요.

    1. 개발 빈도: 실험을 자주 하는 팀인지, 가끔 돌리는 팀인지
    2. 학습 형태: 짧고 잦은 학습인지, 길고 무거운 학습인지
    3. 추론 패턴: 실시간 요청이 많은지, 배치성 작업인지
    4. 운영 인력: MLOps를 직접 운영할 역량이 있는지
    5. 조직 표준: 이미 AWS 또는 GCP에 데이터 파이프라인이 있는지

    예를 들어 데이터 레이크가 S3 중심이고 IAM 표준도 AWS에 맞춰져 있다면, SageMaker가 겉으로 조금 비싸 보여도 운영 비용까지 합치면 더 단순해질 수 있습니다. 반대로 BigQuery와 GCP 분석 흐름이 이미 자리 잡은 조직이라면 Vertex AI 쪽이 자연스럽게 이어질 가능성이 큽니다. 이 대목이 AI 플랫폼 선택에서 꽤 중요합니다.

    클라우드 AI 비용 비교 체크리스트와 AI 플랫폼 선택 기준 이미지

    팀 규모, 학습 빈도, 실시간 추론 여부에 따라 어떤 비용 항목을 우선 봐야 하는지 정리한 체크리스트 이미지입니다.

    AWS SageMaker 비용을 볼 때 먼저 체크할 항목

    SageMaker는 기능이 넓고 서비스 간 연결도 좋아서 편합니다. 다만 편한 만큼, 아무 생각 없이 다 켜두면 비용이 퍼지기 쉽습니다. 특히 개발용 노트북과 상시 엔드포인트는 생각보다 조용히 오래 과금됩니다.

    • 노트북/개발 환경: 실험이 끝나면 자동 정지되도록 설정했는지
    • 학습 잡: 분산 학습이 정말 필요한지, 단일 노드로 충분한지
    • 실시간 엔드포인트: 상시 대기가 필요한 서비스인지
    • 배치 전환 가능성: 정기 처리라면 Batch Transform이 더 맞는지
    • S3 정리 정책: 모델 아티팩트와 로그 수명 주기 설정 여부

    AWS SageMaker 비용에서 자주 놓치는 건, 편하게 만든 운영 구조 자체도 비용이라는 점입니다. 오토스케일링이나 자동화는 분명 가치가 있지만, 사용량이 적은 초기 단계에서는 과한 구성이 될 때가 있습니다. 작은 팀일수록 이 차이가 더 크게 느껴집니다.

    Google Cloud Vertex AI 비용을 볼 때 주의할 점

    Google Cloud 쪽은 데이터 분석 흐름과 ML을 붙이기 좋다는 장점이 있습니다. 특히 BigQuery, Cloud Storage, Vertex AI를 함께 설계할 때 동선이 깔끔한 편입니다. 다만 Google Cloud AI Platform 비용을 찾고 계셨더라도, 실제 검토는 Vertex AI 기준으로 보셔야 지금 환경과 맞습니다.

    • Cloud Storage 적재 구조: 원본, 전처리본, 결과물이 중복 저장되는지
    • 온라인 예측: 요청은 적은데 엔드포인트를 계속 띄워두는지
    • 배치 예측: 야간 처리나 주기성 작업으로 대체 가능한지
    • 프로젝트 분리: 개발/운영 분리로 로그와 전송 비용이 늘어나는지

    Vertex AI도 학습 인스턴스만 보면 안 됩니다. 저장소 클래스, 로그 보관, 리전 간 네트워크 이동, 파이프라인 실행 횟수까지 같이 봐야 전체 비용이 보입니다. 결국 핵심은 기능 비교보다 조직의 기존 흐름과 얼마나 잘 붙는가입니다.

    실전 구현: 비용 추적 구조를 먼저 만들어야 합니다

    비용 효율성 분석은 콘솔 화면 몇 장으로 끝나지 않습니다. 처음부터 비용을 추적할 기준을 만들어두는 편이 훨씬 낫습니다.

    1. 리소스 태그와 라벨 기준 정의
    2. 학습, 배포, 스토리지 항목 분리
    3. 배치와 실시간 추론 비용을 따로 집계
    4. 주간 단위로 보고서 생성

    AWS 쪽은 최소한 이런 식의 태그 기준은 잡아두는 게 좋습니다.

    aws sagemaker add-tags \
      --resource-arn arn:aws:sagemaker:REGION:ACCOUNT:endpoint/my-ml-endpoint \
      --tags Key=project,Value=cost-compare Key=env,Value=prod Key=owner,Value=ml-team

    Google Cloud 쪽은 예전 AI Platform 명령어도 남아 있지만, 현재 기준으로는 Vertex AI 명령어를 쓰는 편이 정확합니다. 라벨과 Billing Export를 같이 묶어서 운영하면 추적이 편합니다.

    gcloud ai custom-jobs create \
      --region=us-central1 \
      --display-name=cost-compare-job \
      --worker-pool-spec=machine-type=n1-standard-4,replica-count=1,executor-image-uri=us-docker.pkg.dev/vertex-ai/training/tf-cpu.2-14.py310:latest,python-module=trainer.task \
      --python-package-uris=gs://my-ml-bucket/packages/trainer-0.1.tar.gz \
      --labels=project=cost-compare,env=prod,owner=ml-team \
      --args=--train_data=gs://my-ml-bucket/data/train.csv

    학습 전에 비용 기록용 CSV나 대시보드 구조를 만들어두면 비교가 한결 쉬워집니다.

    from datetime import date
    
    rows = [
        {"platform": "sagemaker", "workload": "training", "owner": "ml-team"},
        {"platform": "vertex-ai", "workload": "prediction", "owner": "ml-team"},
    ]
    
    for row in rows:
        print(date.today().isoformat(), row["platform"], row["workload"], row["owner"])

    코드 자체는 단순합니다. 중요한 건 비용 항목 이름을 기술 구조와 같은 기준으로 맞추는 것입니다. 그래야 나중에 MLOps 비용이 늘었을 때 원인을 빠르게 좁힐 수 있습니다.

    AWS SageMaker 비용과 Google Cloud AI Platform 비용 추적 설정 이미지

    태그와 라벨을 기준으로 학습 작업과 예측 엔드포인트를 분류하는 실제 운영 흐름을 표현한 이미지입니다.

    실무에서 자주 막히는 비용 함정

    비용 분석 글은 예쁘게만 쓰면 도움이 덜 됩니다. 실제로 많이 부딪히는 지점을 같이 봐야 판단이 쉬워집니다.

    1. 엔드포인트를 꺼야 하는데 아무도 안 끕니다

    실시간 추론 테스트가 끝난 뒤 엔드포인트를 그대로 두는 경우가 많습니다. 하루 이틀은 티가 안 나도, 월말 보고서에서는 꽤 선명하게 드러납니다. 개발용 엔드포인트는 TTL 정책이나 예약 종료 자동화를 꼭 붙여두는 편이 안전합니다.

    2. 전처리 결과물이 원본보다 더 많이 쌓입니다

    전처리 결과를 버전별로 계속 저장하다 보면 저장소 비용이 예상보다 빨리 커집니다. 재현성을 위해 일부 보관은 필요하지만, 모든 중간 산출물을 영구 보관할 필요는 없습니다. 수명 주기 정책을 같이 설계하는 게 좋습니다.

    3. 배치 예측이면 되는데 실시간 API로 만듭니다

    이 패턴도 정말 흔합니다. 겉으로는 실시간처럼 보여도, 실제 업무는 하루 몇 번 결과만 있으면 되는 경우가 꽤 많거든요. 그런 작업은 Batch Transform이나 Batch Prediction으로 바꾸는 편이 비용 효율이 더 좋습니다.

    4. 로그를 너무 오래 쌓아둡니다

    CloudWatch나 Cloud Logging은 운영에 꼭 필요하지만, 세부 디버그 로그를 몇 달씩 그대로 쌓아둘 이유는 많지 않습니다. 나중에 보면 정작 자주 보는 건 최근 로그뿐인 경우가 많습니다. 보관 기간과 제외 규칙을 초기에 정해두면 훨씬 편합니다.

    검증: 어떤 팀에 어떤 플랫폼이 더 비용 효율적일까요?

    정리하면 아래처럼 보는 게 실무에 가깝습니다.

    팀 상황 유리한 선택 이유
    AWS 기반 인프라가 이미 표준 AWS SageMaker 권한, 스토리지, 운영 자동화 연계가 자연스러움
    GCP 데이터 분석 흐름이 강함 Google Cloud Vertex AI 데이터와 ML 파이프라인 연결성이 좋음
    실시간 추론보다 배치 작업 비중이 큼 둘 다 가능, 배치 중심 설계 우선 플랫폼보다 운영 패턴이 비용에 더 큰 영향
    MLOps 전담 인력이 적음 기존 클라우드와 맞는 관리형 서비스 직접 운영 오버헤드 감소

    결국 “SageMaker가 무조건 비싸다”거나 “GCP가 무조건 싸다”는 식의 말은 실제 운영에서는 잘 안 맞습니다. 같은 모델이어도 데이터 위치, 호출 방식, 유휴 시간, 팀의 운영 습관에 따라 총비용이 크게 달라지거든요. 클라우드 AI 비용 비교의 핵심은 단가표보다 워크로드 설계에 있습니다.

    클라우드 AI 비용 비교 결과 대시보드와 MLOps 비용 시각화 이미지

    학습 비용, 유휴 엔드포인트 비용, 스토리지 누적 비용이 어떻게 다른지 보여주는 결과 대시보드 이미지입니다.

    클라우드 AI 비용 비교에 바로 쓰는 절감 팁 7가지

    1. 개발용 엔드포인트 자동 종료: 야간과 주말 자동 정리
    2. 배치 전환 검토: 꼭 실시간이어야 하는지 먼저 확인
    3. 아티팩트 수명 주기 정책: 체크포인트, 로그, 중간 산출물 정리
    4. 태그/라벨 강제: 프로젝트, 환경, 팀 기준으로 비용 식별
    5. 작게 시작: 분산 학습은 필요가 확인된 뒤 적용
    6. 주간 보고서 자동화: 월말에 한꺼번에 보면 늦습니다
    7. 조직 표준 존중: 기술적으로 좋아 보여도 운영 복잡도가 크면 손해

    이 주제는 MLOps 비용을 CI/CD, 데이터 파이프라인, 모델 재학습 주기와 연결해서 보면 더 선명해집니다. 비용 태깅 전략이나 배치 추론 운영 글과 함께 읽으면 판단 기준이 훨씬 또렷해집니다. 내부 링크를 넣는다면 이 지점이 연결 포인트로 가장 좋습니다.

    자주 묻는 질문

    Q1. 작은 팀이면 어떤 쪽이 더 유리한가요?

    작은 팀은 대체로 기존에 익숙한 클라우드에 붙는 편이 낫습니다. 새 플랫폼 학습비용도 결국 총비용에 들어가니까요.

    Q2. GPU 가격만 비교하면 안 되나요?

    안 됩니다. 학습 비용은 전체의 일부일 뿐입니다. 엔드포인트, 저장소, 로그, 네트워크, 파이프라인 실행 비용이 같이 붙습니다.

    Q3. 배치 예측이 항상 더 싼가요?

    유휴 시간이 많은 서비스에서는 대체로 유리한 편입니다. 다만 사용자 응답 지연을 허용할 수 있는지부터 먼저 봐야 합니다.

    마무리: 플랫폼보다 더 중요한 건 비용이 새는 구조를 보는 눈입니다

    오늘 내용을 한 줄로 줄이면 이렇습니다. AI 플랫폼 선택은 브랜드 비교가 아니라, 내 워크로드와 운영 습관을 얼마나 정확히 반영하느냐의 문제입니다. 비용은 늘 눈에 잘 안 띄는 곳에서 새기 쉽습니다. 유휴 엔드포인트, 중복 저장, 과한 로그, 불필요한 실시간 처리 같은 부분이 대표적이죠.

    그래서 클라우드 AI 비용 비교를 하실 때는 꼭 총소유비용 관점으로 보시는 게 좋습니다. 학습 한 번 가격보다, 한 달 운영했을 때 어떤 구조가 남는지가 더 중요하거든요. 결국 가장 좋은 상태는 단가가 낮을 때보다, 왜 이 비용이 나왔는지 설명할 수 있을 때에 가깝습니다.

    AWS SageMaker 비용과 Google Cloud AI Platform 비용 비교 요약 인포그래픽

    플랫폼 선택 기준, 비용 절감 포인트, 배치와 실시간 추론 선택 기준을 요약한 마무리 인포그래픽입니다.

  • [AI] RAG 시스템 구축, ChromaDB 선택 가이드 및 실제 적용 사례

    [AI] RAG 시스템 구축, ChromaDB 선택 가이드 및 실제 적용 사례

    [AI] RAG 시스템 구축, ChromaDB 선택 가이드 및 실제 적용 사례

    RAG 시스템을 처음 붙이려고 하면 제일 먼저 막히는 지점이 보통 벡터 데이터베이스(Vector Database, 임베딩 데이터를 저장하고 유사도 검색하는 저장소)예요. 저도 처음엔 LLM 애플리케이션(LLM Application, 대규모 언어 모델 기반 서비스)을 만들면서 “모델만 좋으면 되는 거 아닌가?” 했다가, 검색 품질 때문에 한참 삽질했었거든요. 특히 ChromaDB RAG 시스템 구성을 고민하시는 분들은, 빠르게 붙일 수 있는 도구가 필요한데 동시에 나중에 운영 관점도 봐야 해서 더 헷갈리실 거예요. 이번 글에서는 제가 홈랩과 사내 PoC에서 정리했던 방식으로, ChromaDB를 왜 선택했는지, 어떻게 붙였는지, 어디서 문제를 겪었는지까지 경험 위주로 풀어보겠습니다.

    처음엔 이게 뭔가 싶었는데, 실제로 써보니까 ChromaDB는 “복잡한 인프라를 먼저 깔지 않고도 RAG 구축 흐름을 빠르게 검증하기 좋은 선택지”더라고요. 다만 아무 상황에서나 만능은 아닙니다. 여기서 중요한 포인트! 작은 프로젝트와 빠른 실험에는 꽤 편하지만, 데이터 규모와 운영 요구사항이 커지면 설계 기준이 완전히 달라집니다.

    ChromaDB RAG 시스템 전체 아키텍처를 보여주는 이미지

    문서 수집부터 임베딩 생성, ChromaDB 저장, 질의 검색, LLM 응답 생성까지 이어지는 전체 흐름을 보여주는 아키텍처 이미지입니다.

    1. 왜 ChromaDB RAG 시스템을 먼저 검토했는가

    제가 여러 번 느낀 건, RAG 구축은 처음부터 거창하게 가면 오히려 실패 확률이 높다는 점이예요. 검색 파이프라인이 맞는지, 문서 청킹(Chunking, 문서를 검색 단위로 쪼개는 작업)이 적절한지, 임베딩 품질이 괜찮은지부터 봐야 하거든요. 이 단계에서 무거운 분산 시스템까지 같이 가져오면 디버깅 포인트가 너무 많아져요.

    • 빠른 시작: 파이썬(Python) 애플리케이션에 바로 붙이기 좋습니다.
    • 로컬 실험 적합: 홈랩이나 개발용 서버에서 먼저 검증하기 편해요.
    • 문서 중심 RAG에 무난: FAQ, 위키, 매뉴얼, 장애 대응 문서 검색에 잘 맞습니다.
    • 운영 전 PoC에 유리: “이 데이터로 진짜 답변이 좋아지는가?”를 빨리 볼 수 있습니다.

    실제로 써보니까, 벡터 데이터베이스를 고를 때 가장 중요한 건 기능 목록보다도 내가 지금 해결하려는 단계가 어디인가였어요. PoC 단계인지, 내부 서비스 런칭 직전인지, 아니면 이미 운영 중인 검색 계층 교체인지에 따라 선택 기준이 완전히 달라지더라고요.

    2. RAG와 벡터 데이터베이스를 쉽게 이해해보면

    쉽게 말해 RAG(Retrieval-Augmented Generation, 검색 증강 생성)는 LLM이 답변하기 전에 관련 문서를 먼저 찾아서 같이 참고하게 만드는 구조예요. 모델이 모든 걸 기억하고 있길 기대하는 대신, 우리 문서를 검색해서 근거를 붙여주는 방식이죠.

    RAG 구축의 기본 흐름

    1. 원본 문서 수집: PDF, Markdown, 위키, 운영 문서 등을 모웁니다.
    2. 문서 분할: 너무 길면 검색 정확도가 떨어져서 적당한 단위로 자릅니다.
    3. 임베딩 생성: 텍스트를 숫자 벡터로 바꿉니다.
    4. 벡터 데이터베이스 저장: 생성한 임베딩과 원문 메타데이터를 저장합니다.
    5. 질의 시 유사도 검색: 질문과 비슷한 문서를 찾습니다.
    6. LLM 프롬프트 구성: 찾은 문서를 컨텍스트로 붙입니다.
    7. 최종 응답 생성: 근거 기반 답변을 만듭니다.

    여기서 임베딩 데이터베이스(Embedding Database, 임베딩 벡터를 저장하고 유사 문서를 찾는 데이터 저장소) 역할이 매우 중요해요. 검색이 틀리면 모델이 아무리 좋아도 엉뚱한 답을 하거든요. 저도 초반엔 프롬프트만 계속 만지다가, 결국 문제는 검색 품질이었다는 걸 뒤늦게 알았습니다.

    ChromaDB는 어디에 들어가나

    ChromaDB는 위 흐름에서 임베딩 저장 + 유사도 검색을 담당합니다. 문서를 collection 단위로 관리하고, id, document, metadata를 함께 보관할 수 있어서 RAG 시스템에 필요한 기본 구조를 갖추고 있어요.

    항목 ChromaDB에서 보는 포인트 실무 체감
    저장 대상 문서, 메타데이터, 임베딩 원문 추적이 쉬워서 디버깅이 편합니다.
    검색 방식 유사도 기반 검색 질문과 비슷한 문맥을 빠르게 찾아요.
    시작 난이도 비교적 낮음 PoC 속도가 잘 나옵니다.
    적합한 상황 내부 문서 검색, 챗봇, QA 초기 RAG 구축에 특히 무난해요.

    3. ChromaDB 선택 가이드: 어떤 상황에 잘 맞는가

    혹시 이런 경험 있으신가요? 일단 서비스는 빨리 만들어야 하는데, 인프라까지 너무 무겁게 가면 일정이 바로 꼬이는 상황이요. 저는 그런 케이스에서 ChromaDB를 자주 검토했습니다.

    이럴 때 ChromaDB가 잘 맞습니다

    • 사내 문서 검색을 먼저 붙여보고 싶을 때
    • RAG 구축을 빠르게 검증해야 할 때
    • 초기엔 단일 애플리케이션 안에서 관리하고 싶을 때
    • 개발자가 검색 품질 실험에 집중해야 할 때

    이럴 때는 설계를 더 봐야 합니다

    • 문서 양이 급격히 커지고 운영팀이 따로 있는 경우
    • 고가용성(High Availability, 장애 시에도 지속 서비스) 요구가 큰 경우
    • 검색 계층과 애플리케이션 계층을 강하게 분리해야 하는 경우

    즉, ChromaDB 사용 사례로 가장 현실적인 건 “문서 기반 LLM 애플리케이션의 첫 번째 검색 계층”이예요. 처음부터 완벽한 정답을 고르려 하지 말고, 검증 속도를 우선하는 게 좋습니다. 저도 그렇게 접근했을 때 시행착오가 많이 줄었어요.

    4. 실전 구현: ChromaDB RAG 시스템 최소 구성

    이제 직접 붙여보겠습니다. 아래 예시는 로컬 디렉터리에 문서를 저장하고, ChromaDB에 임베딩을 적재한 뒤, 질의 시 관련 문서를 검색하는 가장 기본적인 구조예요. 여기서 중요한 건 코드를 화려하게 짜는 게 아니라, 데이터 흐름이 눈에 보이게 만드는 겁니다.

    구성 요소

    • 문서 소스: Markdown 또는 TXT
    • 임베딩 모델: Sentence Transformers 계열
    • 벡터 저장소: ChromaDB
    • 응답 생성기: 원하는 LLM 연결 가능

    1) 패키지 설치

    python -m venv .venv
    source .venv/bin/activate
    pip install chromadb sentence-transformers

    저는 실험 환경을 따로 분리하는 편이예요. RAG 쪽은 라이브러리 조합이 자주 바뀌어서, 전역 환경에 섞어두면 나중에 꼬이더라고요. 삽질 좀 했습니다 ㅎㅎ

    2) 예제 문서 준비

    mkdir -p data
    cat > data/runbook.txt <<'EOF'
    Kubernetes Ingress is an API object that manages external access to services.
    Ingress controller must be installed separately.
    TLS termination can be configured at the ingress layer.
    EOF
    
    cat > data/database.txt <<'EOF'
    ChrmaDB stores embeddings, documents, and metadata for similarity search.
    It is often used in RAG pipelines for document retrieval.
    EOF

    문서를 처음 넣을 때는 양보다 질이 중요해요. 중복 문서, 너무 긴 문단, 서로 다른 주제가 한 파일에 섞인 경우 검색 품질이 바로 흔들립니다.

    ChromaDB RAG 시스템의 문서 적재와 임베딩 생성 과정을 보여주는 이미지

    로컬 문서가 청킹되고 임베딩 모델을 거쳐 ChromaDB 컬렉션에 저장되는 과정을 설명하는 이미지입니다.

    3) 인덱싱 스크립트 작성

    from pathlib import Path
    import chromadb
    from chromadb.utils import embedding_functions
    
    DATA_DIR = Path("data")
    DB_DIR = "./chroma_store"
    
    embedding_fn = embedding_functions.SentenceTransformerEmbeddingFunction(
        model_name="all-MiniLM-L6-v2"
    )
    
    client = chromadb.PersistentClient(path=DB_DIR)
    collection = client.get_or_create_collection(
        name="homelab-docs",
        embedding_function=embedding_fn,
    )
    
    files = sorted(DATA_DIR.glob("*.txt"))
    ids = []
    documents = []
    metadatas = []
    
    for file_path in files:
        text = file_path.read_text(encoding="utf-8").strip()
        ids.append(file_path.stem)
        documents.append(text)
        metadatas.append({"source": str(file_path)})
    
    if ids:
        collection.upsert(ids=ids, documents=documents, metadatas=metadatas)
        print(f"indexed {len(ids)} documents")
    else:
        print("no documents found")

    여기서는 일부러 단순하게 갔어요. 실제 서비스에서는 보통 청킹 로직을 따로 두고, 문서 해시(hash, 내용 변경 감지용 값)도 저장합니다. 그래야 재적재할 때 전체를 다시 밀지 않아도 되거든요.

    4) 질의 테스트 스크립트 작성

    import chromadb
    from chromadb.utils import embedding_functions
    
    DB_DIR = "./chroma_store"
    
    embedding_fn = embedding_functions.SentenceTransformerEmbeddingFunction(
        model_name="all-MiniLM-L6-v2"
    )
    
    client = chromadb.PersistentClient(path=DB_DIR)
    collection = client.get_collection(
        name="homelab-docs",
        embedding_function=embedding_fn,
    )
    
    query = "What is ChromaDB used for in a RAG pipeline?"
    result = collection.query(query_texts=[query], n_results=2)
    
    for idx, doc in enumerate(result["documents"][0], start=1):
        source = result["metadatas"][0][idx - 1]["source"]
        print(f"[{idx}] source={source}")
        print(doc)
        print("-" * 40)

    이 단계에서 제가 꼭 확인하는 건 두 가지예요. 첫째, 질문과 관련된 문서가 정말 검색되는지. 둘째, 검색된 문서가 너무 길거나 너무 짧진 않은지. 여기서 어긋나면 이후 LLM 응답도 흔들립니다.

    5) 간단한 RAG 응답 조합

    def build_prompt(question: str, contexts: list[str]) -> str:
        joined = "\n\n".join(contexts)
        return f"""Answer the question using the context below.
    
    Context:
    {joined}
    
    Question:
    {question}
    """
    
    query = "Ingress controller role?"
    result = collection.query(query_texts=[query], n_results=2)
    contexts = result["documents"][0]
    prompt = build_prompt(query, contexts)
    print(prompt)

    LLM 호출 부분은 사용 중인 모델과 SDK에 따라 다르니, 여기서는 프롬프트 조합까지만 보여드렸어요. 핵심은 검색 결과를 그대로 던지지 말고, 출처와 함께 다듬어 넣는 것입니다.

    5. 실제 적용 사례: 문서 검색형 LLM 애플리케이션에 붙여보니

    제가 직접 해보니 ChromaDB는 특히 운영 문서 검색 쪽에서 체감이 좋았어요. 예를 들면 이런 시나리오입니다.

    1. 온콜(runbook) 문서를 TXT나 Markdown으로 정리합니다.
    2. 서비스별 태그와 출처 메타데이터를 같이 저장합니다.
    3. 장애 질문이 들어오면 관련 문서를 먼저 찾습니다.
    4. LLM은 검색된 문서 범위 안에서만 요약 답변을 생성합니다.

    이렇게 하면 “DB 장애 났을 때 어디부터 봐야 하지?” 같은 질문에, 사람이 문서를 뒤지는 시간을 꽤 줄일 수 있어요. 물론 검색 품질이 완벽하진 않습니다. 근데 여기서 중요한 포인트! 사람도 찾기 어려운 문서를 모델이 magically 다 알아서 찾아주진 않거든요. 결국 문서 구조와 메타데이터 설계가 절반 이상입니다.

    제가 초반에 잘못했던 건 파일명만 믿고 넣었던 겁니다. 실제로 써보니까 제목이 비슷한 문서가 많으면 헷갈리더라고요. 그래서 나중엔 아래처럼 메타데이터 기준을 정리했습니다.

    • 서비스명
    • 문서 유형: runbook, policy, faq
    • 환경: dev, staging, prod
    • 최종 수정일 또는 버전 문자열

    이렇게 해두면 후처리 필터링에도 유리해요. 단순히 비슷한 문서만 찾는 게 아니라, “prod 환경 runbook만 우선” 같은 정책을 붙일 수 있으니까요.

    6. ⚠️ 주의사항과 트러블슈팅: 제가 실제로 막혔던 부분

    이 섹션이 사실 제일 중요해요. 설치보다 디버깅이 더 오래 걸리거든요.

    문제 1. 검색은 되는데 답이 엉뚱한 경우

    대부분은 모델 문제가 아니라 청킹 문제였어요. 문서 한 덩어리가 너무 길면 핵심 문장이 묻힙니다.

    • 증상: 관련 없는 단락이 같이 검색됩니다.
    • 원인: 문서 단위가 너무 커요.
    • 해결: 문단 또는 섹션 기준으로 더 잘게 나눕니다.

    문제 2. 비슷한 문서만 반복해서 나오는 경우

    중복 데이터가 원인이었어요. 위키 export나 배포 문서 복사본이 많으면 이런 현상이 자주 납니다.

    • 증상: 결과 다양성이 떨어져요.
    • 원인: 유사한 문서가 여러 개 들어 있어요.
    • 해결: 적재 전 중복 제거, 해시 기반 비교를 넣습니다.

    문제 3. 검색 결과는 맞는데 LLM 답변이 과장되는 경우

    이건 검색 계층보다 프롬프트 제약이 약한 경우가 많았어요. 저도 처음엔 “찾은 문서를 바탕으로 답하라” 정도만 썼었는데, 그럼 모델이 빈칸을 상상으로 메우더라고요.

    • 해결 1: 근거가 없으면 모른다고 답하게 만들어요.
    • 해결 2: 출처를 함께 출력하게 만들어요.
    • 해결 3: 검색된 문서 밖의 지식 사용을 제한합니다.

    문제 4. 운영 문서 업데이트가 반영되지 않는 경우

    문서 갱신 프로세스가 없어서 생긴 문제였어요. ChromaDB 자체보다 파이프라인 설계 이슈였죠.

    find data -type f -name '*.txt' | sort

    저는 나중에 파일 변경 감지 후 해당 문서만 다시 upsert하는 식으로 정리했습니다. 처음부터 “재색인(re-indexing, 다시 인덱싱)” 전략을 생각해두시는 게 좋아요.

    ChromaDB RAG 시스템의 검색 품질 트러블슈팅을 설명하는 이미지

    청킹 크기, 중복 문서, 메타데이터 설계, 프롬프트 제약이 검색 품질에 어떻게 영향을 주는지 보여주는 이미지입니다.

    7. 검증과 결과 확인: 최소한 이것만은 꼭 보세요

    ChromaDB RAG 시스템을 붙였다고 끝이 아니예요. 검증 없이 넘어가면 나중에 “왜 답변이 가끔 이상하지?”가 반복됩니다. 제가 체크하는 기준은 꽤 단순해요.

    1. 질문 10개를 미리 만들어요.
    2. 각 질문에 대해 상위 3개 문서가 적절한지 봐요.
    3. 출처 문서가 실제 답변 근거가 되는지 확인합니다.
    4. 문서가 바뀌었을 때 재색인이 정상 반영되는지 봐요.
    test_queries = [
        "What is ChromaDB used for?",
        "What does an ingress controller do?",
    ]
    
    for q in test_queries:
        result = collection.query(query_texts=[q], n_results=3)
        print(f"query: {q}")
        for i, meta in enumerate(result["metadatas"][0], start=1):
            print(i, meta["source"])
        print()

    이 검증 과정을 해보면 생각보다 빨리 감이 와요. “아, 지금은 검색보다 문서 정리가 더 급하구나”, 또는 “메타데이터 필터가 필요하겠네” 같은 판단이 바로 서거든요. 🎉 드디어 됐다! 싶은 순간도 보통 여기서 옵니다. 쿼리 몇 개만 던져봐도 방향이 맞는지 보이니까요.

    ChromaDB RAG 시스템의 검색 결과 검증 화면을 표현한 이미지

    질문별 상위 검색 문서, 출처, 응답 품질을 확인하는 검증 결과 화면을 표현한 이미지입니다.

    8. 정리: ChromaDB 선택 기준과 다음 단계

    정리해보면, ChromaDB RAG 시스템은 빠르게 실험하고 구조를 검증하기에 좋은 출발점이예요. 특히 사내 문서 검색, 운영 문서 QA, PoC 수준의 LLM 애플리케이션에서는 꽤 실용적이었습니다. 반대로 대규모 운영 요구가 붙기 시작하면 저장 구조, 재색인 전략, 메타데이터 필터링, 고가용성 요구를 별도로 검토해야 해요.

    질문 권장 판단
    지금 빠른 PoC가 중요한가? ChromaDB 우선 검토
    문서 검색 품질 실험이 먼저인가? ChromaDB로 충분히 시작 가능
    운영 분리와 복잡한 확장이 당장 필요한가? 아키텍처를 더 넓게 비교
    문서가 자주 바뀌는가? 재색인 자동화 설계 필수

    제가 얻은 교훈은 명확했어요. 좋은 RAG 구축은 좋은 검색 구조에서 시작한다는 겁니다. 모델 선택보다 먼저, 문서 구조와 검색 실험부터 잡아야 하더라고요. 이거 진짜 편하더라고요. 한번 흐름만 잡히면 이후 모델 교체나 프롬프트 튜닝도 훨씬 수월해집니다.

    ChromaDB 선택 기준과 RAG 구축 체크리스트를 요약한 이미지

    PoC 적합성, 운영 고려사항, 문서 설계 포인트를 한눈에 보여주는 요약 인포그래픽 이미지입니다.

    다음 글에서는 문서 청킹 전략과 메타데이터 설계를 더 깊게 다뤄볼 예정이예요. 이전 글에서 다뤘던 홈랩 기반 AI 워크로드 분리 방식과 같이 보면 더 이해가 쉬우실 겁니다.

    자주 묻는 질문

    ChromaDB는 어떤 프로젝트에 가장 먼저 써보기 좋나요?

    내부 문서 검색, FAQ 챗봇, 운영 문서 기반 질의응답처럼 문서 중심 RAG에 잘 맞아요.

    벡터 데이터베이스만 넣으면 답변 품질이 바로 좋아지나요?

    아니예요. 문서 품질, 청킹, 메타데이터, 프롬프트 제약이 같이 맞아야 합니다.

    ChromaDB 사용 사례에서 가장 중요한 운영 포인트는 뭔가요?

    문서 변경 시 재색인 전략과 검색 결과 검증 루틴이예요. 이 둘이 없으면 초반엔 잘 되다가 점점 정확도가 흔들립니다.

    임베딩 데이터베이스를 고를 때 가장 먼저 볼 건 뭔가요?

    지금 단계가 PoC인지 운영 확장 단계인지부터 봐요. 그 기준이 서야 도구 선택도 쉬워집니다.

    한 줄 요약: ChromaDB는 빠른 RAG 구축과 검색 실험에 강하고, 성공 여부는 결국 문서 설계와 검증 루프에 달려 있어요. ✅

  • [AI] LangChain Agent SDK 활용 사례: 복잡한 워크플로우 자동화 구현기

    [AI] LangChain Agent SDK 활용 사례: 복잡한 워크플로우 자동화 구현기

    LangChain Agent로 복잡한 워크플로우 자동화를 구현하려는 분들이 요즘 정말 많아요. 저도 홈랩(Home Lab, 개인 실험 환경)에서 여러 자동화 파이프라인을 굴리다가, 단순한 스크립트 몇 개로는 더 이상 감당이 안 되는 시점이 왔거든요. 알림은 Slack으로 보내고, 장애 징후는 로그에서 뽑고, 사용자 요청은 요약하고, 필요한 경우엔 외부 API까지 호출해야 했습니다. 처음엔 Python으로 if 문 덕지덕지 붙이면 되겠지 했었는데, 금방 한계가 왔어요. 그때 정리해서 도입한 방식이 바로 LangChain Agent 기반 워크플로우 자동화였습니다.

    이 글에서는 Agent SDK 활용 관점에서, 실제로 LangChain의 에이전트 구성 요소와 Tool(에이전트가 호출하는 기능 단위)을 조합해 어떻게 복잡한 흐름을 관리했는지 풀어보겠습니다. 거창한 데모보다, 제가 직접 해보면서 부딪힌 포인트를 중심으로 썼어요. 혹시 자동화가 점점 커지면서 스크립트가 엉키기 시작했다면 꽤 공감되실 겁니다.

    왜 LangChain Agent가 워크플로우 자동화에 잘 맞을까

    쉽게 말해 LangChain Agent는 LLM 에이전트(대형 언어 모델 기반 작업 판단기)가 상황을 읽고, 필요한 Tool을 골라서 순서대로 실행하게 만드는 구조입니다. 예전엔 제가 직접 분기 로직을 다 짰어요. 예를 들면 “에러 로그가 있으면 요약하고, 장애 패턴이면 티켓 만들고, 아니면 보고서만 저장” 같은 흐름이었죠. 이걸 전부 코드로 박아두면 처음엔 단순한데, 조건이 늘어날수록 유지보수가 지옥이 됩니다.

    근데 LangChain Agent를 붙이면 판단 레이어를 어느 정도 유연하게 분리할 수 있어요. 물론 모든 걸 LLM에게 맡기면 안 됩니다. 여기서 중요한 포인트! 결정은 에이전트가 하되, 실행은 검증된 Tool이 하도록 분리해야 합니다. 저는 이 구조를 쓰고 나서 자동화가 훨씬 읽기 쉬워졌고, 장애 원인 추적도 편해졌더라고요.

    LangChain Agent 기반 워크플로우 자동화 전체 아키텍처 이미지

    LangChain Agent가 요청을 받아 분석하고, 여러 Tool과 검증 단계를 거쳐 결과를 반환하는 전체 흐름을 보여주는 이미지입니다.

    LangChain 사례로 보는 기본 구조

    제가 실제로 많이 쓴 패턴은 아래 4단계였습니다.

    1. 입력 수집: 사용자 요청, 로그, 이벤트, 티켓 내용을 받습니다.
    2. 의도 분류: 요약인지, 분석인지, 외부 시스템 호출이 필요한지 구분합니다.
    3. Tool 실행: 검색, 저장, 알림, 티켓 생성 같은 실제 작업을 수행합니다.
    4. 결과 검증: 응답 포맷과 필수 필드가 맞는지 확인합니다.

    이 구조가 좋은 이유는 명확해요. LLM은 텍스트 해석과 판단에 강하고, 실제 시스템 변경은 함수나 API가 담당하니까요. 다시 말해 자유도는 높이고, 위험도는 낮추는 방식입니다. 저도 처음엔 “에이전트가 너무 똑똑한 척하다가 이상한 Tool 고르면 어쩌지?” 싶었는데, Tool 설계를 보수적으로 하면 꽤 안정적으로 돌아가더라고요.

    구성 요소 역할 실무 포인트
    LLM 질문 해석, 다음 행동 판단 자유 서술은 허용하되 출력 형식은 제한
    Tool 실제 API 호출, 파일 저장, 알림 전송 입력값 검증을 꼭 넣기
    Prompt 행동 기준과 제약 정의 하면 안 되는 작업도 명시
    Executor 에이전트 실행 흐름 관리 타임아웃, 재시도, 로깅 필요
    Validator 결과 검증 JSON 스키마나 필수 필드 검사 추천

    실전 구현 1: 워크플로우 자동화 시나리오 정의

    제가 예제로 자주 설명하는 시나리오는 이렇습니다. 운영 중인 서비스에서 장애 의심 이벤트가 들어오면, 에이전트가 로그를 요약하고, 중요도를 분류하고, 필요한 경우 운영 채널에 알림을 보내고, 마지막으로 리포트를 저장하는 거예요. 말로 하면 쉬운데, 이걸 사람이 수동으로 하려면 은근 반복 작업이 많거든요.

    저는 먼저 Tool 목록부터 아주 보수적으로 잘랐습니다. 이게 진짜 중요합니다.

    • search_logs: 최근 로그 검색
    • classify_severity: 중요도 분류
    • notify_slack: Slack 알림 전송
    • save_report: 결과 저장

    처음엔 Tool을 이것저것 많이 붙였는데 오히려 에이전트가 헷갈리더라고요. 실제로 써보니까 Tool 수를 줄이고, 각 Tool 책임을 명확히 나누는 것이 훨씬 낫습니다.

    환경 준비

    python -m venv .venv
    source .venv/bin/activate
    pip install langchain langchain-openai

    여기서는 가장 단순한 형태로만 가져갑니다. 패키지 버전은 시점에 따라 바뀌기 때문에, 프로젝트에서는 lock file로 고정하는 걸 추천드립니다. 저도 처음엔 로컬에선 되는데 서버에선 안 되는 문제를 몇 번 겪었습니다 ㅎㅎ

    기본 Tool 정의

    from typing import Literal
    from langchain.tools import tool
    
    @tool
    def search_logs(query: str) -> str:
        """Search recent logs by keyword and return a short summary."""
        sample = [
            "api-gateway timeout after 30s",
            "db connection pool exhausted",
            "retry succeeded for payment worker"
        ]
        matched = [line for line in sample if query.lower() in line.lower()]
        return "\n".join(matched) if matched else "no relevant logs"
    
    @tool
    def classify_severity(log_summary: str) -> Literal["low", "medium", "high"]:
        """Classify operational severity from log summary."""
        text = log_summary.lower()
        if "pool exhausted" in text or "timeout" in text:
            return "high"
        if "retry" in text:
            return "medium"
        return "low"
    
    @tool
    def notify_slack(message: str) -> str:
        """Send a message to an operations channel."""
        return f"sent to slack: {message}"
    
    @tool
    def save_report(content: str) -> str:
        """Save an incident report."""
        return "report saved"

    실무에서는 당연히 실제 로그 시스템이나 메시징 API를 붙이겠죠. 다만 구조는 크게 다르지 않습니다. LLM은 실행 주체가 아니라 오케스트레이터(Orchestrator, 작업 조율자)라고 생각하시면 이해가 쉽습니다.

    LangChain Agent 툴 호출 흐름과 설정 구성을 설명하는 이미지

    에이전트가 어떤 기준으로 Tool을 고르고, 각 Tool이 어떤 입력과 출력을 갖는지 보여주는 구성 이미지입니다.

    실전 구현 2: LangChain Agent 연결

    이제 Tool을 에이전트에 연결해보겠습니다. 제가 처음 이 부분에서 좀 헤맸던 이유가, 프롬프트에 역할과 제약을 충분히 안 적어서였습니다. 에이전트는 생각보다 지시를 문자 그대로 받아들이거든요.

    from langchain.agents import AgentExecutor, create_openai_functions_agent
    from langchain_core.prompts import ChatPromptTemplate, MessagesPlaceholder
    from langchain_openai import ChatOpenAI
    
    llm = ChatOpenAI(model="gpt-4o-mini", temperature=0)
    tools = [search_logs, classify_severity, notify_slack, save_report]
    
    prompt = ChatPromptTemplate.from_messages([
        ("system", """
    You are an operations automation agent.
    Use tools to investigate incidents.
    If severity is high, notify slack.
    Always save a final report.
    Do not invent log data.
    Return a concise final summary.
    """),
        ("human", "{input}"),
        MessagesPlaceholder(variable_name="agent_scratchpad")
    ])
    
    agent = create_openai_functions_agent(llm, tools, prompt)
    executor = AgentExecutor(agent=agent, tools=tools, verbose=True)
    
    result = executor.invoke({
        "input": "Investigate database timeout symptoms and create an incident summary."
    })
    
    print(result["output"])

    여기서 핵심은 세 가지예요.

    1. Do not invent log data처럼 금지 조건을 명시합니다.
    2. Always save a final report처럼 필수 행동을 적습니다.
    3. 최종 응답은 사람이 읽기 쉬운 형태로 짧게 제한합니다.

    이렇게 해두면 LLM 에이전트가 지나치게 산으로 가는 걸 많이 줄일 수 있어요. 저도 처음엔 프롬프트를 너무 추상적으로 써서 Tool 호출 순서가 들쭉날쭉했는데, 운영 기준을 문장으로 박아두니까 꽤 안정됐습니다.

    실전 구현 3: 다단계 워크플로우 자동화로 확장하기

    한 단계 더 나가면 조건부 분기와 검증 로직을 붙일 수 있습니다. 예를 들어 중요도가 high일 때만 Slack 알림을 보내고, 결과는 반드시 JSON으로 저장하도록 강제하는 식이죠. 저는 운영 자동화에서 이 검증 단계를 빼먹었다가 나중에 리포트 형식이 제각각이라 한참 정리했던 적이 있습니다. 삽질 좀 했습니다 ㅎㅎ

    import json
    from pydantic import BaseModel, ValidationError
    
    class Report(BaseModel):
        summary: str
        severity: str
        action_taken: str
    
    
    def validate_report(payload: str) -> str:
        data = json.loads(payload)
        report = Report(**data)
        return report.model_dump_json(ensure_ascii=False)
    
    final_payload = json.dumps({
        "summary": "Database timeout patterns detected from recent logs.",
        "severity": "high",
        "action_taken": "Slack notification sent and report saved."
    }, ensure_ascii=False)
    
    print(validate_report(final_payload))

    이건 에이전트 바깥에서 검증하는 예시입니다. 제 경험상 에이전트 결과를 바로 믿지 말고, 마지막엔 애플리케이션 레벨에서 검증하는 게 안전합니다. 특히 워크플로우 자동화가 외부 시스템을 건드릴수록 더 그렇습니다.

    ⚠️ 트러블슈팅: 제가 실제로 겪었던 문제들

    여기부터가 진짜 실전입니다. 데모는 잘 돌아가는데 운영에 붙이면 꼭 이상한 부분이 생기거든요.

    1. Tool 설명이 모호하면 엉뚱한 함수가 호출됩니다

    예전에 notify와 save 관련 Tool 설명을 둘 다 “store result” 비슷하게 써둔 적이 있었는데, 에이전트가 자꾸 저장만 하고 알림은 안 보내더라고요. 그 뒤로는 Tool docstring을 아주 구체적으로 씁니다.

    • notify_slack: 운영 채널에 즉시 알림을 보냄
    • save_report: 최종 리포트를 파일 또는 저장소에 기록

    설명이 겹치면 안 됩니다. 정말 사소해 보이는데 체감 차이가 커요.

    2. 프롬프트만으로 제어하려고 하면 흔들립니다

    처음엔 “high면 알림 보내”를 프롬프트에만 적어뒀습니다. 그런데 상황에 따라 누락되는 경우가 있더라고요. 이후에는 애플리케이션 쪽에도 한 번 더 조건문을 넣었습니다. 즉, 프롬프트 제약 + 코드 제약 이중으로 묶는 방식입니다.

    3. 로그 요약이 길어지면 판단 품질이 떨어집니다

    이건 꽤 자주 겪습니다. 입력 컨텍스트가 너무 길면 핵심 장애 패턴이 묻혀버리거든요. 그래서 저는 최근 로그를 전부 넣지 않고, 사전 필터링을 거친 뒤 요약본만 넣습니다. 쉽게 말해 검색(Search)과 추출(Extraction)을 먼저 하고, 에이전트 판단은 그 다음입니다.

    4. 실패 경로를 안 만들면 운영에서 곤란합니다

    API 호출 실패, 응답 지연, 빈 결과 같은 케이스를 빼먹기 쉽습니다. 근데 실제 운영은 정상보다 예외가 더 기억에 남습니다. 그래서 아래처럼 실패 응답도 표준화해두는 걸 추천드립니다.

    workflow:
      on_error:
        notify: true
        save_fallback_report: true
        retry_policy:
          enabled: true
          max_attempts: 3

    이거 해두면 밤에 훨씬 편합니다. 진짜로요.

    LangChain Agent를 활용한 장애 대응 자동화 예외 처리 흐름 이미지

    Tool 실패, 재시도, 대체 보고서 저장 같은 예외 처리 경로를 시각적으로 설명하는 이미지입니다.

    검증과 결과: 자동화가 실제로 편해졌는지 확인하는 방법

    자동화는 “돌아간다”보다 “믿고 맡길 수 있다”가 중요합니다. 저는 보통 아래 항목으로 검증합니다.

    1. 같은 입력에 대해 비슷한 결과가 나오는가
    2. high severity에서 알림 누락이 없는가
    3. 결과 저장 포맷이 항상 일정한가
    4. 실패 시 fallback 경로가 작동하는가

    간단한 테스트 스크립트도 붙여봅니다.

    test_inputs = [
        "database timeout",
        "retry succeeded",
        "unknown warning"
    ]
    
    for item in test_inputs:
        output = executor.invoke({"input": f"Investigate: {item}"})
        print(item)
        print(output["output"])
        print("-" * 40)

    이 단계에서 중요한 건 벤치마크 숫자를 화려하게 만드는 게 아닙니다. 오히려 재현성(reproducibility, 같은 조건에서 비슷한 결과가 나오는 성질)과 예측 가능성이 더 중요합니다. 제가 직접 해보니, 사람 손을 완전히 없애는 자동화보다 “1차 분석과 정리까지 맡기는 자동화”가 훨씬 현실적이고 만족도도 높았습니다.

    검증 항목 자동화 전 자동화 후
    로그 확인 사람이 수동 검색 Tool로 일관되게 검색
    중요도 판단 담당자마다 기준 차이 프롬프트와 규칙으로 통일
    알림 발송 가끔 누락 조건 기반 자동 전송
    리포트 저장 형식 제각각 검증 후 동일 포맷 저장

    자동화 실행 결과, 중요도 분류, 알림 여부, 리포트 저장 상태를 한눈에 보여주는 대시보드 이미지입니다.

    LangChain Agent 도입 전 체크리스트

    무조건 Agent부터 붙이기보다, 아래를 먼저 확인하시면 시행착오를 많이 줄일 수 있습니다.

    • Tool이 충분히 분리돼 있는가
    • 실패했을 때 사람이 이어받을 수 있는가
    • 출력 검증 로직이 있는가
    • LLM에게 맡길 판단과 코드로 고정할 규칙이 구분돼 있는가
    • 로그와 실행 기록을 남기고 있는가

    특히 마지막은 꼭 챙기세요. 나중에 “왜 이런 판단을 했지?”를 보려면 실행 흔적이 있어야 합니다. 이전 글에서 다뤘던 운영 로그 정리 방식이 있다면 그 구조를 그대로 재활용해도 좋습니다. 다음 글에서는 이런 흐름을 더 확장해서 멀티스텝 승인(approval) 자동화까지 다뤄볼 예정입니다.

    자주 묻는 질문

    Q1. LangChain Agent는 모든 자동화에 필요한가요?

    아닙니다. 분기가 거의 없고 입력과 출력이 고정돼 있다면 일반 스크립트가 더 단순하고 좋습니다. 에이전트는 판단이 필요한 자동화에서 빛이 납니다.

    Q2. LLM 에이전트가 실수하면 위험하지 않나요?

    맞습니다. 그래서 실제 시스템 변경은 제한된 Tool만 허용하고, 검증 단계를 별도로 둬야 합니다. 저는 읽기와 분류는 넓게, 쓰기와 변경은 좁게 가져갑니다.

    Q3. Agent SDK 활용 포인트를 한 줄로 정리하면요?

    판단은 유연하게, 실행은 보수적으로입니다. 이 원칙 하나만 지켜도 워크플로우 자동화 품질이 꽤 달라집니다.

    LangChain Agent 도입 전후 비교와 핵심 원칙 요약 이미지

    도입 전후 차이, Tool 설계 원칙, 검증 전략을 요약한 마무리 인포그래픽 이미지입니다.

    마무리: 복잡한 워크플로우 자동화, 결국 설계가 반입니다

    LangChain Agent를 써보면 처음엔 되게 마법처럼 느껴져요. 자연어로 시키면 알아서 Tool을 고르니까요. 근데 실제로 오래 굴려보면, 잘 되는 이유는 모델이 똑똑해서라기보다 Tool 경계, 프롬프트 제약, 검증 로직을 얼마나 잘 설계했느냐에 달려 있더라고요. 저도 처음엔 이게 뭔가 싶었는데, 구조를 한 번 제대로 잡고 나니 워크플로우 자동화가 한결 차분해졌습니다.

    정리하면 이렇습니다. LangChain Agent는 복잡한 워크플로우 자동화에 꽤 강력한 도구예요. 하지만 무턱대고 붙이기보다, 에이전트가 판단할 영역과 코드가 통제할 영역을 분리해야 진짜 실무형으로 살아남습니다. 혹시 지금 자동화 스크립트가 점점 괴물이 되어가고 있다면, 작은 Tool 몇 개부터 분리해서 LLM 에이전트로 묶어보세요. 생각보다 빨리 “아, 이래서 쓰는구나” 하는 순간이 옵니다. 드디어 됐다! 싶은 지점이 분명히 생기거든요.